


Agent Platform Memory Bank te permite generar de forma dinámica memorias a largo plazo basadas en las conversaciones entre el usuario y tu agente. Estas memorias son información personalizada que persiste en varias sesiones, lo que permite que tu agente adapte y personalice las respuestas para brindar contexto y continuidad.
Funciones
Memory Bank te ayuda a administrar las memorias para que puedas personalizar cómo interactúa tu agente con los usuarios y administrar la ventana de contexto. Para cada alcance, Memory Bank mantiene una colección aislada de memorias. Cada memoria es un fragmento de información independiente y autónomo que se puede usar para expandir el contexto disponible para tu agente. Por ejemplo:
{
  "name": "projects/.../locations/.../reasoningEngines/.../memories/...",
  "scope": {
    "agent_name": "My agent",
    "user": "my user ID"
  },
  "fact": "I use Memory Bank to manage my memories."
}
El Banco de memoria incluye las siguientes funciones:
Generación de recuerdos: Crea, define mejor y administra recuerdos con un modelo de lenguaje grande (LLM).
Extracción de memoria: Extrae solo la información más significativa de los datos de origen para conservarla como recuerdos.
Consolidación de la memoria: Consolida la información recién extraída con los recuerdos existentes, lo que permite que los recuerdos evolucionen a medida que se incorpora información nueva. También puedes consolidar recuerdos preextraídos (como la información que tu agente o una persona con intervención humana consideran significativa) con los recuerdos existentes.
Generación asíncrona: Genera recuerdos en segundo plano para que tu agente no tenga que esperar a que se complete la generación de recuerdos.
Transferencia continua de eventos: Transmite y administra eventos de conversación con la transferencia de eventos, que activa automáticamente la generación de memoria según las reglas de procesamiento por lotes que configures.
Extracción personalizable: Configura qué información considera significativa Memory Bank proporcionando temas específicos y ejemplos de aprendizaje con algunos ejemplos.
Comprensión multimodal: Procesa información multimodal para generar y conservar estadísticas textuales.
Almacenamiento y recuperación administrados: Benefíciate de un almacén de memoria completamente administrado, persistente y accesible.
Aislamiento de datos entre identidades: La consolidación y la recuperación de la memoria se aíslan a una identidad específica.
Almacenamiento persistente y accesible: Almacena recuerdos a los que se puede acceder desde varios entornos, incluidos Agent Runtime, tu entorno local o cualquier otra opción de implementación.
Búsqueda de similitud: Recupera memorias con la búsqueda de similitud que se limita a una identidad específica.
Vencimiento automático: Establece un tiempo de actividad (TTL) en las memorias para garantizar que la información inactiva se borre automáticamente. Configura tu instancia de Memory Bank para que se aplique automáticamente un TTL a las memorias insertadas o generadas.
Revisiones de memoria: Crea y mantén automáticamente revisiones de memoria que te permitan inspeccionar cómo se transforman las memorias a medida que se transfiere información nueva.
Permisos restrictivos: Usa las condiciones de IAM para restringir qué principales pueden leer o escribir las memorias de alcances específicos.
Integración de agentes: Conecta Memory Bank a tu agente para que pueda organizar llamadas para generar y recuperar recuerdos.
Integración del Kit de desarrollo de agentes (ADK): Organiza llamadas desde tu agente basado en el ADK con las herramientas integradas del ADK y el
VertexAiMemoryBankServicepara leer y escribir en Memory Bank.Otros frameworks: Une tu código de Memory Bank en herramientas y devoluciones de llamada para organizar la generación y recuperación de memoria.
Casos de uso
Puedes usar Memory Bank para transformar las interacciones de los agentes sin estado en experiencias contextuales con estado en las que el agente recuerda, aprende y se adapta con el tiempo. Memory Bank es ideal para aplicaciones que requieren lo siguiente:
Personalización a largo plazo: Crea experiencias adaptadas a usuarios individuales. Memory Bank limita las memorias a una identidad específica, lo que permite que un agente recuerde las preferencias, el historial y los detalles clave de un usuario en varias sesiones.
- Ejemplo: Un agente de servicio al cliente que recuerda información clave de los tickets de asistencia anteriores y las preferencias de productos de un usuario sin necesidad de volver a preguntar.
Extracción de conocimiento impulsada por LLM: Úsala cuando necesites identificar y conservar automáticamente la información más importante de las conversaciones o el contenido multimodal sin intervención manual.
- Ejemplo: Un agente de investigación que lee una serie de artículos técnicos y crea una memoria consolidada de los hallazgos, las metodologías y las conclusiones clave.
Contexto dinámico y en evolución: Usa Memory Bank cuando necesites una fuente de conocimiento que no sea estática. Memory Bank está diseñado para integrar de forma continua información nueva de tu agente, lo que permite definir mejor y actualizar las memorias almacenadas a medida que haya nuevos datos disponibles. Esto garantiza que el contexto en el que se basa tu agente siempre esté actualizado y sea preciso. Mientras que la RAG tiene una base de conocimiento externa y estática, Memory Bank puede evolucionar según el contexto que proporcione el agente.
Ejemplo de uso
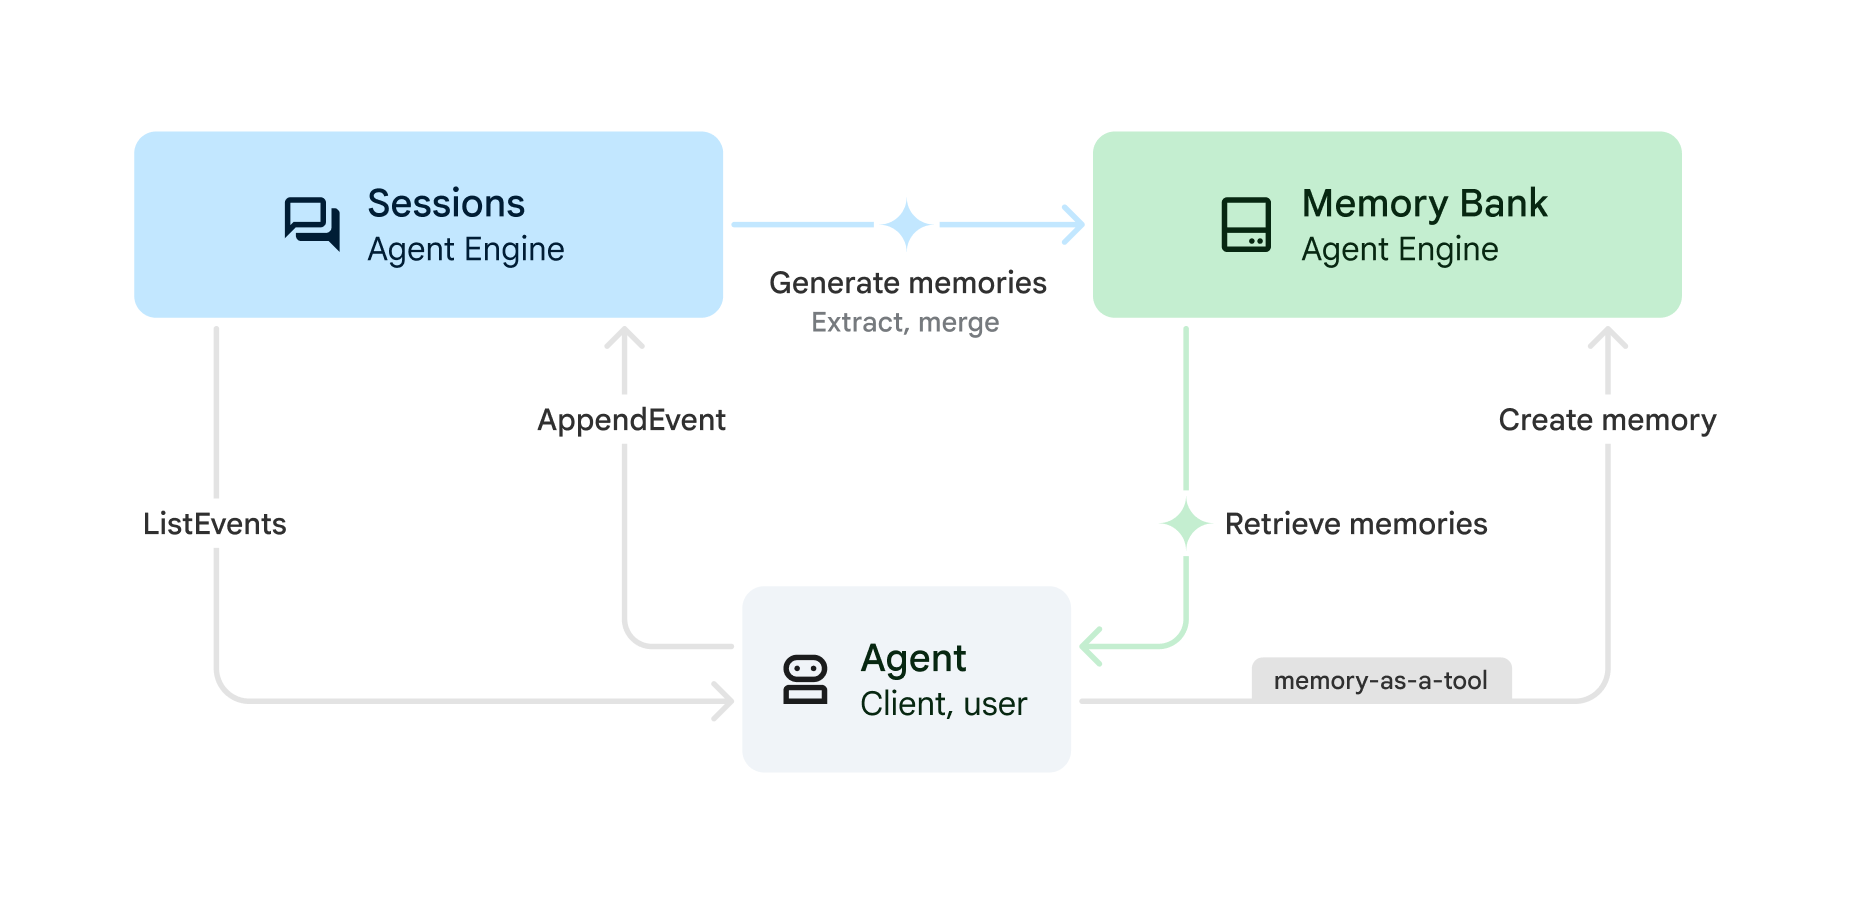
Puedes usar Memory Bank con Agent Platform Sessions para generar memorias a partir de sesiones almacenadas con el siguiente proceso:
(Sesiones)
CreateSession: Al comienzo de cada conversación, crea una sesión nueva. El historial de conversaciones que usa el agente se limita a esta sesión. Una sesión contiene la secuencia cronológica de mensajes y acciones (SessionEvents) para una interacción entre un usuario y tu agente. Todas las sesiones deben tener un ID de usuario. Los recuerdos extraídos (consultaGenerateMemories) de esta sesión se asignan a este usuario.(Sesiones)
AppendEvent: A medida que el usuario interactúa con el agente, los eventos (como los mensajes del usuario, las respuestas del agente y las acciones de las herramientas) se suben a Sesiones. Los eventos conservan el historial de conversaciones y crean un registro de la conversación que se puede usar para generar recuerdos.(Sesiones)
ListEvents: A medida que el usuario interactúa con el agente, este recupera el historial de conversaciones.(Banco de memoria) Genera o crea recuerdos:
GenerateMemories: En un intervalo especificado (como el final de cada sesión o el final de cada turno), el agente puede activar la generación de recuerdos con el historial de conversaciones. Los datos sobre el usuario se extraen automáticamente del historial de conversaciones para que estén disponibles para las sesiones actuales o futuras.CreateMemory: Tu agente puede escribir recuerdos directamente en Memory Bank. Por ejemplo, el agente puede decidir cuándo se debe escribir una memoria y qué información se debe guardar (memoria como herramienta). UsaCreateMemorycuando quieras que tu agente tenga más control sobre qué hechos se extraen.
(Memory Bank)
RetrieveMemories: A medida que el usuario interactúa con tu agente, este puede recuperar las memorias guardadas sobre ese usuario. Puedes recuperar todas las memorias (recuperación simple) o solo las más relevantes para la conversación actual (recuperación de búsqueda de similitudes). Luego, puedes insertar las memorias recuperadas en tu instrucción.
Guías de inicio rápido
Comienza a usar Memory Bank con las siguientes guías de inicio rápido:
Guía de inicio rápido con la API de REST: Sigue la guía de inicio rápido de la API de REST para realizar llamadas a la API directamente a Sessions y Memory Bank.
Guía de inicio rápido con el ADK: Sigue la guía de inicio rápido del ADK si quieres que tu agente del ADK organice las llamadas a las sesiones y a Memory Bank por ti.
Gobernanza de Memory Bank
En esta sección, se describen las consideraciones de administración de datos cuando se usa Memory Bank, como las responsabilidades de seguridad y la residencia de los datos.
Riesgos de seguridad de la inyección de instrucciones
Además de las responsabilidades de seguridad descritas en la responsabilidad compartida de Agent Platform, considera el riesgo de inyección de instrucciones y contaminación de memoria que pueden afectar a tu agente cuando usa memorias a largo plazo. La contaminación de memoria ocurre cuando se almacena información falsa en el Memory Bank. Luego, el agente puede operar con esta información falsa o maliciosa en sesiones futuras.
Para mitigar el riesgo de contaminación de memoria, puedes hacer lo siguiente:
Model Armor: Usa Model Armor para inspeccionar las instrucciones que se envían al banco de memoria o desde tu agente.
Pruebas adversarias: Prueba de forma proactiva tu aplicación de LLM para detectar vulnerabilidades de inserción de instrucciones simulando ataques. Esto se conoce como "red teaming".
Ejecución de la zona de pruebas: Si el agente tiene la capacidad de ejecutar o interactuar con sistemas externos o críticos, estas acciones se deben realizar en un entorno de zona de pruebas con un control de acceso estricto y una revisión humana.
Para obtener más información, consulta Enfoque de Google para agentes de IA seguros.
Residencia de los datos
Para cumplir con los marcos regulatorios, como el Reglamento General de Protección de Datos (RGPD) y los requisitos regionales de soberanía de los datos, debes asegurarte de que los recuerdos generados y almacenados en Memory Bank cumplan con los límites estrictos de residencia de datos y segregación.
Si bien Memory Bank proporciona aislamiento de datos basado en el alcance entre identidades dentro de una instancia, debes aplicar políticas de control de acceso basado en roles (RBAC) y de Identity and Access Management para aplicar límites regionales y evitar la contaminación de la memoria transfronteriza entre distintas instancias regionales.
Implementación de instancias regionales y residencia de datos
Cuando crees una instancia de Memory Bank, elige una ubicación regional o
multirregional (como eu para la Unión Europea o us para
Estados Unidos) para asegurarte de que los datos en reposo permanezcan dentro de ese límite geográfico
específico.
La ubicación del procesamiento de aprendizaje automático (AA) depende de la disponibilidad regional del modelo subyacente. Si no hay un extremo regional disponible para el modelo o la ubicación que seleccionaste (por ejemplo, los modelos de Gemini 3 o las regiones únicas de Asia), se usan los extremos globales de Gemini para el procesamiento de AA. Para obtener más información, consulta Residencia de datos y Extremos multirregionales y globales.
Cómo evitar la contaminación de la memoria transfronteriza
La contaminación transfronteriza se produce cuando un Agent Runtime, una Agent Identity, una cuenta de servicio o una aplicación que opera en una jurisdicción (por ejemplo, EE.UU.) escribe o recupera recuerdos de una instancia de Memory Bank ubicada en otra jurisdicción (por ejemplo, la UE).
Para evitar la contaminación transfronteriza y mantener el cumplimiento de reglamentaciones, puedes configurar los siguientes controles de IAM:
Identidades de agentes o cuentas de servicio regionales dedicadas: Crea identidades de agentes o cuentas de servicio independientes y específicas de la región para cada jurisdicción (como
agent-us@PROJECT_ID.iam.gserviceaccount.compara las cargas de trabajo de EE.UU. yagent-eu@PROJECT_ID.iam.gserviceaccount.compara las cargas de trabajo de la UE). Asegúrate de que a las identidades de agentes y las cuentas de servicio regionales solo se les otorguen roles de IAM en las instancias de Memory Bank que residen en la misma jurisdicción geográfica, lo que evita que los entornos de ejecución regionales accedan a instancias transfronterizas.- Roles especializados con privilegio mínimo: Otorga a las principales solo los roles de Memory Bank específicos que se requieren para su carga de trabajo (como
roles/aiplatform.memoryViewerpara la recuperación de solo lectura oroles/aiplatform.memoryEditorpara el acceso de escritura y generación) vinculados al recurso regional adecuado. Para obtener detalles sobre los roles disponibles, consulta Roles de IAM de Specialized Memory Bank.
- Roles especializados con privilegio mínimo: Otorga a las principales solo los roles de Memory Bank específicos que se requieren para su carga de trabajo (como
Políticas de la organización: Aplica restricciones de ubicación a nivel de la organización, la carpeta o el proyecto con la restricción de la política de la organización
gcp.resourceLocations. Esto restringe la creación y el uso de recursos de Memory Bank a las regiones que cumplen con las normativas aprobadas y evita el uso no autorizado de extremos globales.
Para obtener más información sobre cómo implementar políticas de acceso condicional, consulta Controla el acceso al banco de memoria de Agent Platform con condiciones de IAM.
¿Qué sigue?
Guía de inicio rápido de la API de Memory Bank
Comienza a usar la API de Memory Bank para administrar memorias a largo plazo.
Guía de inicio rápido con el Kit de desarrollo de agentes
Comienza a usar el Kit de desarrollo de agentes (ADK).