


本文提供高階架構,說明如何實作使用 AI 代理的跨雲端分析工作流程。本文適用對象為雲端架構師、資料工程師和資料科學家,他們希望使用代理式 AI,在多雲端資料湖泊、結構化資料倉儲和非結構化資料儲存庫中執行分析工作流程。本文假設您已具備代理式 AI 概念、資料分析和雲端架構的基本知識。
本文件的「部署」一節提供程式碼實驗室,可讓您瞭解如何建構代理式數據分析解決方案。
架構
下圖顯示代理式數據分析解決方案的架構,可從分散在多個資料儲存庫和雲端服務供應商的結構化和非結構化資料中,衍生出業務洞察資訊。
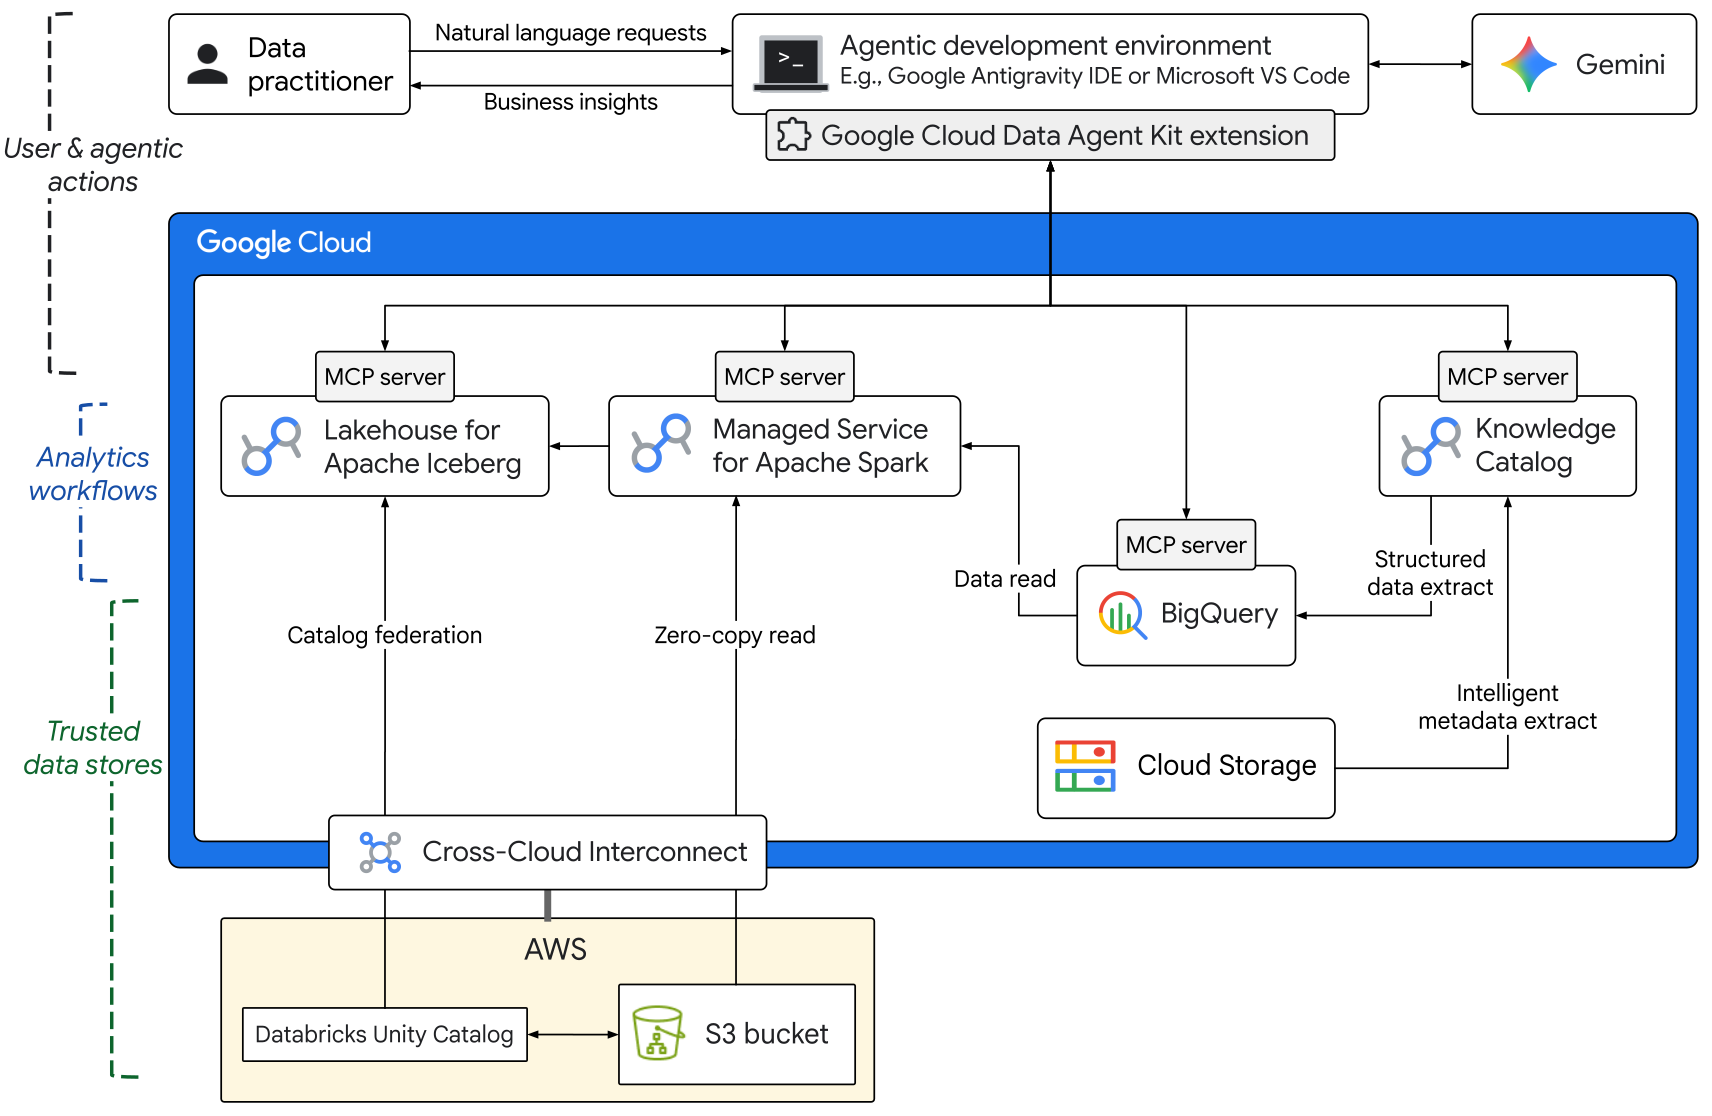
這個架構中的元件分為下列層級:
使用者和代理動作
- 代理開發環境:資料工程師和資料科學家等 Data Practitioner,可透過下列任一方法提交自然語言要求:
- 代理開發環境,例如 Google Antigravity IDE 或 Microsoft Visual Studio Code。
- CLI 代理,例如 Antigravity CLI、Claude Code 或 Codex。
- Google Cloud Data Agent Kit:Data Agent Kit 可載入適當技能,並連線至 Google Cloud 服務的遠端 MCP 伺服器,讓代理存取Google Cloud 中的可信資料。
- 基礎模型:為了從可靠的情境和資料生成業務洞察,代理開發環境會使用基礎模型,例如 Gemini 系列模型。模型會使用 Data Agent Kit 的適當技能,並運用必要的 MCP 伺服器工具,實作複雜的數據分析工作流程。
- 代理開發環境:資料工程師和資料科學家等 Data Practitioner,可透過下列任一方法提交自然語言要求:
數據分析工作流程
- 無邊界湖倉:Lakehouse 提供高效能的統合中繼資料目錄,將 Apache Iceberg 開放式資料表格式與 Google Cloud中的企業級儲存空間整合。Lakehouse 具備跨雲端資料存取功能,可讓您建立 Databricks Unity Catalog 等外部目錄的聯盟關係,不必移動或複製資料。
- Managed Service for Apache Spark:這是架構中的核心資料處理元件。Managed Service for Apache Spark 的 Lightning Engine 功能支援高效能、無伺服器的批次和互動模式資料處理。Spark 資料處理工作會使用 Lakehouse 中 Iceberg 目錄的中繼資料,從 BigQuery 讀取結構化資料,並從 Amazon S3 等外部來源執行零複製讀取。
- Knowledge Catalog:代理會使用 Knowledge Catalog,對 Cloud Storage 中的非結構化資料執行智慧掃描、擷取語意中繼資料,並建構情境圖。
可信任的資料儲存庫
- Google Cloud 中的資料:BigQuery 是結構化資料的中央倉儲,包括從 Cloud Storage 非結構化資料中擷取的結構化資料。
- 外部來源資料:架構顯示外部資料來源,例如 Amazon S3 bucket 中的資料,以及 Databricks Unity Catalog 中的中繼資料。Cross-Cloud Interconnect 可在 Google Cloud與其他雲端服務供應商之間,建立高頻寬的專屬連線。
使用的產品
此架構使用下列 Google Cloud 產品和工具:
- Google Cloud Data Agent Kit:代理擴充功能,可讓資料科學家、資料工程師和資料應用程式開發人員,在偏好的代理開發環境中管理整個資料生命週期。
- BigQuery:企業資料倉儲,內建機器學習、地理空間分析和商業智慧等功能,可協助您管理及分析資料。
- Managed Service for Apache Spark:這項代管服務可在代管運算基礎架構上,執行 Apache Spark 批次工作負載。
- Lakehouse:高效能儲存引擎,可讓您建構開放式資料湖倉,並提供進階數據分析和 AI 的統一介面。
- Knowledge Catalog:這項 AI 輔助服務提供統一的資料資產目錄,具備智慧型中繼資料和治理功能。
- Gemini:Google 開發的多模態 AI 模型系列。
- Cloud Storage:適用於多種資料類型的物件儲存庫,成本低廉且沒有限制。資料在 Google Cloud內外都能存取,且會複製到多個位置,以便提供備援機制。
- Cross-Cloud Interconnect:這項服務可在 Google Cloud 與其他雲端服務供應商之間,提供高頻寬、低延遲的專屬連線。
- Google Cloud MCP 伺服器:Google 代管的遠端服務,可實作 Model Context Protocol (MCP),讓 AI 應用程式存取 Google 和 Google Cloud 產品與服務。
用途
本文說明的架構適用於下列用途:
- 多雲端資料分析:有效率地查詢及分析分散在 Google Cloud 和其他雲端服務供應商的資料,不需移動檔案或建構複雜的擷取、轉換、載入 (ETL) 管道。舉例來說,全球零售商的行銷經理可以將 Amazon S3 中的客戶忠誠度資料,與 BigQuery 中的行銷營運資料彙整,分析行銷廣告活動的成效。
- 智慧資料探索:使用自然語言提示和 AI 代理,探索、查詢及處理多個環境中的聯合資料集。舉例來說,採購專員可以根據供應鏈管理 (SCM) 系統中的結構化資料,結合非結構化電子郵件通訊和損害評估報告中的洞察,判斷供應鏈中斷的常見原因。
- 從非結構化來源擷取結構化資料:掃描大量非結構化資料、衍生語意中繼資料,並將結構化資料擷取內容儲存在 BigQuery,用於下游分析。舉例來說,營運主管可以從數千張以非結構化格式 (例如 PDF 檔案) 儲存的發票中擷取結構化資料,有效率地分析費用。
安全性考量
為因應 AI 代理特有的安全風險,Google 建議採取做法,結合確定性安全控管機制與動態、以推論為基礎的防禦措施:
- 人工監督:在業務關鍵系統中加入人工介入迴路流程,讓人工監督員審查輸出內容,並核准、覆寫或暫停代理動作。
- Agent Identity:為每個代理指派與工作負載繫結的身分,強制執行最小權限存取控管,並集中管理外部工具的憑證。
- Agent Gateway:強制執行輸入和輸出流量管理、預設拒絕存取政策,以及使用 Model Armor 進行內嵌提示和工具檢查。
- Agent Registry:確認代理只會連線至核准的子代理和 MCP 工具。
本節的指引僅列出部分範例。如要進一步瞭解設計因素和最佳做法,以及建構和部署多代理式 AI 系統的建議,請參閱「 Google Cloud中的多代理式 AI 系統」。
如需 AI 和機器學習工作負載專屬的安全原則和建議,請參閱 Well-Architected Framework 中的「AI 和機器學習觀點:安全性」。
部署作業
如要瞭解如何使用 Data Agent Kit 建構代理數據分析解決方案,請參閱程式碼實驗室「Raw data to forecasting in seconds with AI agents」(使用 AI 代理,在幾秒內將原始資料轉換為預測結果)。本程式碼實驗室會說明如何使用 Data Agent Kit,在偏好的代理開發環境中有效率地分析資料。程式碼實驗室使用的所有樣本資料都儲存在Google Cloud中。
後續步驟
- 瞭解如何使用 Data Agent Kit 透過筆記本轉換及分析資料。
- 探索 Knowledge Catalog 的應用實例。
- 進一步瞭解如何透過 Lakehouse 跨雲端存取資料。
- 瞭解如何使用 Lightning Engine 加快 Apache Spark 工作負載。
- 瞭解如何將 Knowledge Catalog 做為 BigQuery 的管理和代理層。
- 如要查看更多參考架構、圖表和最佳做法,請瀏覽 Cloud Architecture Center。
貢獻者
作者:Kumar Dhanagopal | 跨產品解決方案開發人員
其他貢獻者:
- Abirami Sukumaran | 開發人員服務代表
- Arti Prasad | 技術文件撰稿者
- Brad Miro | 資深開發人員服務代表
- Matthew Rahmann | 資深產品經理
- Ranadip Chatterjee | 解決方案工程師
- Remigiusz Samborski | 開發人員關係工程師主管