


Neste documento, apresentamos uma arquitetura de alto nível para implementar fluxos de trabalho de análise entre nuvens que usam agentes de IA. O documento é destinado a arquitetos de nuvem, engenheiros de dados e cientistas de dados que querem usar a IA agêntica para fluxos de trabalho de análise em data lakes multicloud, data warehouses estruturados e repositórios de dados não estruturados. No documento, pressupomos que você tenha uma compreensão básica dos conceitos de IA agêntica, análise de dados e arquitetura de nuvem.
A seção Implantação deste documento fornece um codelab que você pode usar para aprender a criar uma solução de análise de agentes.
Arquitetura
O diagrama a seguir mostra uma arquitetura para uma solução de análise de agentes que gera insights de negócios com base em dados estruturados e não estruturados distribuídos em vários repositórios de dados e provedores de serviços de nuvem.
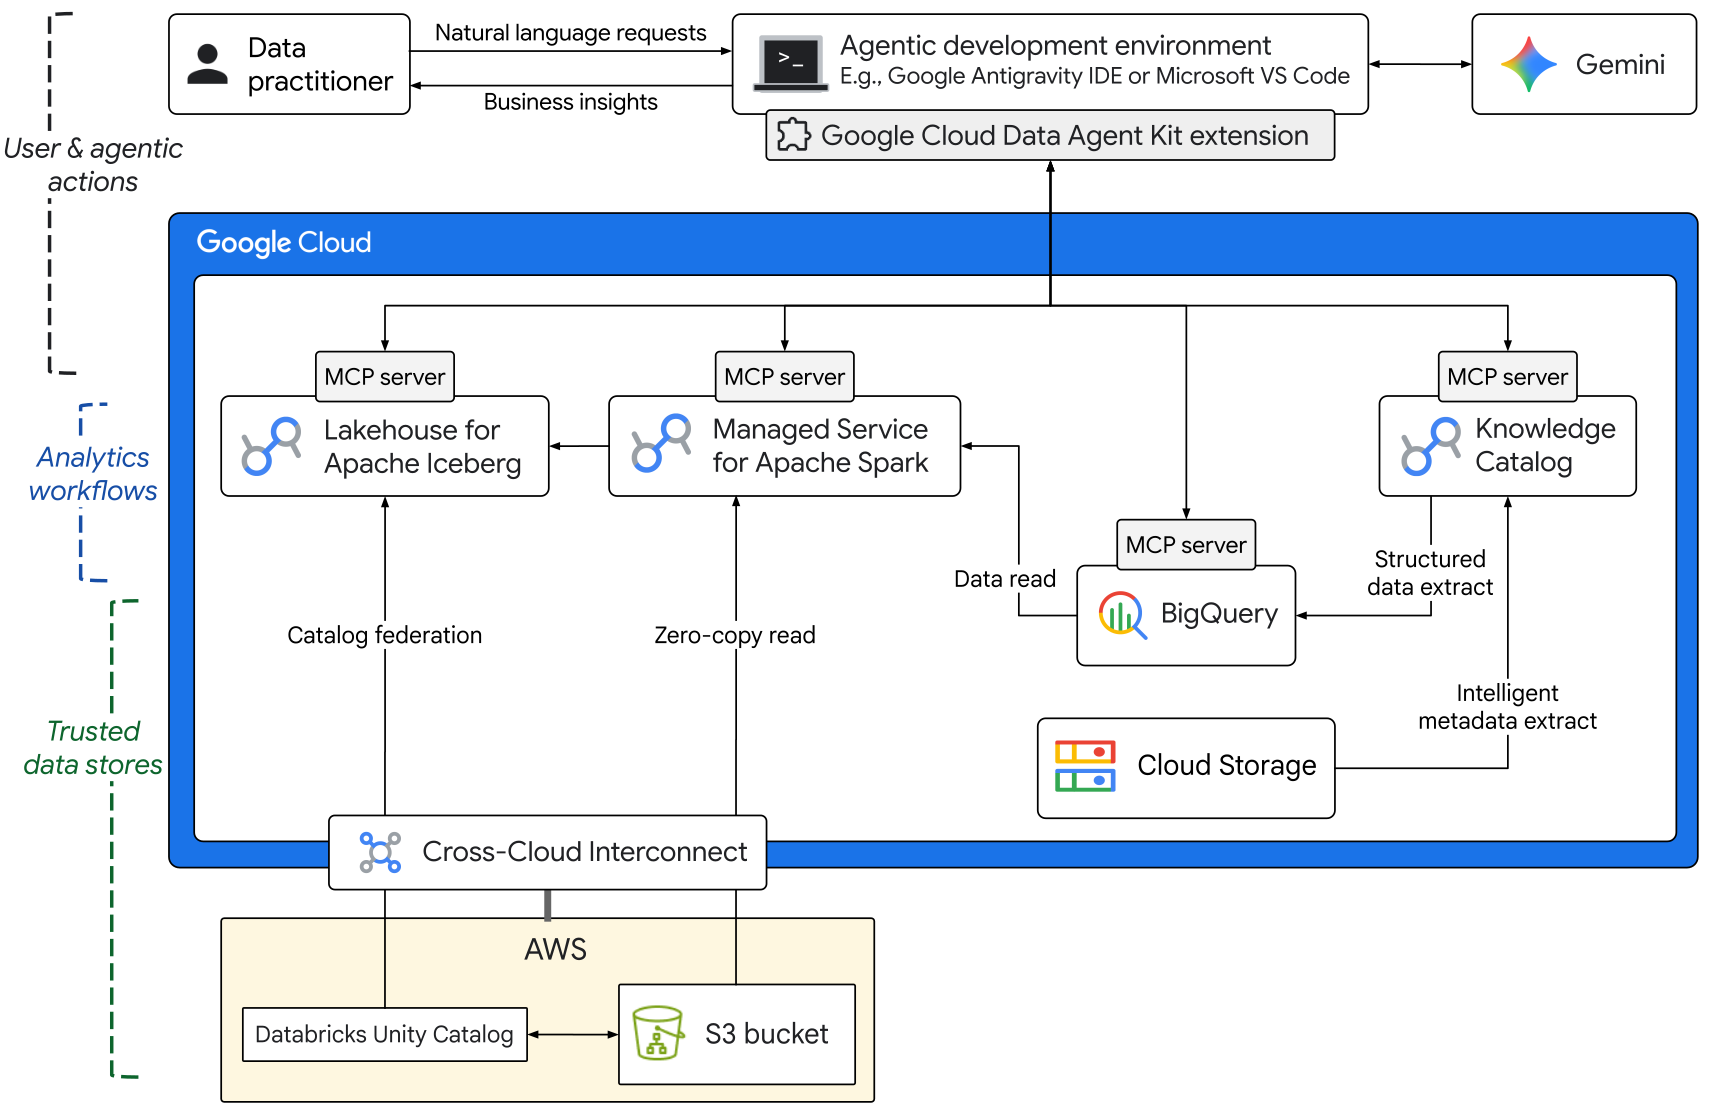
Os componentes dessa arquitetura são organizados nas seguintes camadas:
Ações do usuário e do agente
- Ambiente de desenvolvimento agêntico: Data Practitioners, como engenheiros e cientistas de dados, enviam solicitações em linguagem natural usando um dos seguintes métodos:
- Um ambiente de desenvolvimento de agentes, como o IDE do Google Antigravity ou o Microsoft Visual Studio Code.
- Um agente de CLI, como a CLI do Antigravity, o Claude Code ou o Codex.
- Google Cloud Data Agent Kit: o Data Agent Kit permite que os agentes acessem dados confiáveis no Google Cloud carregando as habilidades adequadas e se conectando a servidores MCP remotos para serviços do Google Cloud .
- Modelo de fundação: para gerar insights de negócios com base em contexto e dados confiáveis, o ambiente de desenvolvimento de agentes usa um modelo de fundação, como um modelo da família Gemini. O modelo usa as habilidades adequadas do Data Agent Kit e as ferramentas necessárias do servidor MCP para implementar fluxos de trabalho de análise complexos.
- Ambiente de desenvolvimento agêntico: Data Practitioners, como engenheiros e cientistas de dados, enviam solicitações em linguagem natural usando um dos seguintes métodos:
Fluxos de trabalho de análise
- Lakehouse sem fronteiras: o Lakehouse oferece um catálogo de metadados unificado e de alto desempenho que integra o formato de tabela aberta do Apache Iceberg ao armazenamento de nível empresarial no Google Cloud. Com o acesso a dados entre nuvens, o Lakehouse permite federar catálogos externos, como o Databricks Unity Catalog, sem mover ou copiar dados.
- Serviço Gerenciado para Apache Spark: é o principal componente de tratamento de dados na arquitetura. O recurso Lightning Engine do Serviço Gerenciado para Apache Spark oferece suporte ao tratamento de dados sem servidor de alto desempenho nos modos em lote e interativo. Os jobs de processamento de dados do Spark usam metadados do catálogo do Iceberg no Lakehouse, leem dados estruturados do BigQuery e realizam leituras sem cópia de fontes externas, como o Amazon S3.
- Knowledge Catalog: o agente usa o Knowledge Catalog para realizar verificações inteligentes de dados não estruturados no Cloud Storage, extrai metadados semânticos e cria um gráfico de contexto.
Repositórios de dados confiáveis
- Dados no Google Cloud: o BigQuery serve como o data warehouse central para dados estruturados, incluindo extrações estruturadas de dados não estruturados no Cloud Storage.
- Dados de fontes externas: a arquitetura mostra fontes de dados externas, como dados em buckets do Amazon S3 e metadados no Databricks Unity Catalog. O Cross-Cloud Interconnect oferece conectividade dedicada de alta largura de banda entre o Google Cloud e outros provedores de serviços de nuvem.
Produtos usados
A arquitetura usa os seguintes produtos e ferramentas do Google Cloud :
- Google Cloud Data Agent Kit: extensões de agente para que cientistas de dados, engenheiros de dados e desenvolvedores de apps de dados gerenciem todo o ciclo de vida dos dados nos ambientes de desenvolvimento agêntico de preferência.
- BigQuery: um data warehouse corporativo que ajuda a gerenciar e analisar seus dados com recursos integrados, como análise geoespacial de machine learning e Business Intelligence.
- Serviço Gerenciado para Apache Spark: um serviço gerenciado que executa cargas de trabalho em lote do Apache Spark em uma infraestrutura de computação gerenciada.
- Lakehouse: um mecanismo de armazenamento de alto desempenho que permite criar data lakehouses abertos e oferece uma interface unificada para análises avançadas e IA.
- Knowledge Catalog: um serviço com tecnologia de IA que oferece um catálogo unificado de recursos de dados com metadados inteligentes e recursos de governança.
- Gemini: uma família de modelos de IA multimodal desenvolvida pelo Google.
- Cloud Storage: um repositório de objetos de baixo custo e sem limite para diversos tipos de dados. Os dados podem ser acessados de dentro e fora do Google Cloude são replicados entre locais para redundância.
- Cross-Cloud Interconnect: um serviço que fornece conectividade dedicada de alta largura de banda e baixa latência entre o Google Cloud e outros provedores de serviços de nuvem.
- Servidores MCP do Google Cloud: serviços remotos gerenciados pelo Google que implementam o Protocolo de Contexto de Modelo (MCP) para fornecer aos aplicativos de IA acesso aos produtos e serviços do Google e do Google Cloud .
Casos de uso
A arquitetura descrita neste documento é adequada para os seguintes casos de uso:
- Análise de dados multicloud: consulte e analise com eficiência os dados distribuídos no Google Cloud e em outros provedores de serviços de nuvem sem mover arquivos ou criar pipelines complexos de extração, transformação e carregamento (ETL). Por exemplo, um gerente de marketing de um varejista global pode analisar a eficácia das campanhas de marketing unindo dados de fidelidade do cliente no Amazon S3 com dados de operações de marketing no BigQuery.
- Descoberta inteligente de dados: use comandos de linguagem natural e agentes de IA para descobrir, consultar e processar conjuntos de dados federados em vários ambientes. Por exemplo, um especialista em compras pode determinar causas comuns de interrupções na cadeia de suprimentos com base em dados estruturados em um sistema de gerenciamento da cadeia de suprimentos (SCM, na sigla em inglês) combinados com insights de comunicações por e-mail não estruturadas e relatórios de avaliação de danos.
- Extração de dados estruturados de fontes não estruturadas: verifique grandes volumes de dados não estruturados, derive metadados semânticos e armazene extrações de dados estruturados no BigQuery para análise downstream. Por exemplo, um controlador de operações pode analisar despesas de maneira eficiente extraindo dados estruturados de milhares de faturas armazenadas em um formato não estruturado, como arquivos PDF.
Considerações sobre segurança
Para ajudar a lidar com os riscos de segurança exclusivos dos agentes de IA, o Google recomenda uma abordagem que combina controles de segurança determinísticos com defesas dinâmicas baseadas em raciocínio:
- Supervisão humana: incorpore um fluxo de human-in-the-loop em sistemas essenciais para os negócios, de modo que os supervisores humanos possam analisar as saídas e aprovar, substituir ou pausar as ações do agente.
- Identidade do agente: atribua a cada agente uma identidade vinculada à carga de trabalho para aplicar o controle de acesso com privilégio mínimo e gerenciar centralmente as credenciais de ferramentas externas.
- Gateway de Agente: aplique a governança de tráfego de entrada e saída, políticas de acesso de negação padrão e inspeção de comandos e ferramentas inline com o Model Armor.
- Agent Registry: verifique se os agentes se conectam apenas a subagentes e ferramentas MCP aprovados.
As orientações desta seção não são completas. Para mais informações sobre fatores de design e práticas recomendadas, além de recomendações sobre como criar e implantar um sistema de IA multiagente, consulte Sistema de IA multiagente no Google Cloud.
Para princípios e recomendações de segurança específicos para cargas de trabalho de IA e ML, consulte Perspectiva de IA e ML: segurança no Well-Architected Framework.
Implantação
Para saber como criar uma solução de análise agêntica usando o Data Agent Kit, consulte o codelab Dados brutos para previsão em segundos com agentes de IA. O codelab mostra como o Data Agent Kit permite analisar dados de forma eficiente no seu ambiente de desenvolvimento agêntico preferido. Todos os dados de amostra usados pelo codelab são armazenados em Google Cloud.
A seguir
- Saiba como o Data Agent Kit permite usar notebooks para transformação e análise de dados.
- Conheça os casos de uso do Knowledge Catalog.
- Saiba mais sobre o acesso a dados entre nuvens com o Lakehouse.
- Saiba como acelerar as cargas de trabalho do Apache Spark usando o Lightning Engine.
- Saiba como usar o Knowledge Catalog como uma camada de governança e agente para o BigQuery.
- Para mais arquiteturas de referência, diagramas e práticas recomendadas, confira a Central de arquitetura do Cloud.
Colaboradores
Autor: Kumar Dhanagopal | Desenvolvedor de soluções de vários produtos
Outros colaboradores:
- Abirami Sukumaran | Mediadora de desenvolvedores sênior
- Arti Prasad | Redatora técnica
- Brad Miro | Mediador de desenvolvedores sênior
- Matthew Rahmann | Gerente de produtos sênior
- Ranadip Chatterjee | Engenheiro de soluções
- Remigiusz Samborski | Engenheiro líder de relações com desenvolvedores