


En este documento, se proporciona una arquitectura de alto nivel para implementar flujos de trabajo de análisis multinube que usan agentes de IA. Este documento está dirigido a arquitectos de la nube, ingenieros de datos y científicos de datos que quieran usar la IA de agentes para los flujos de trabajo de análisis en data lakes de múltiples nubes, almacenes de datos estructurados y almacenes de datos no estructurados. En el documento, se da por sentado que tienes conocimientos básicos de los conceptos de IA de agentes, análisis de datos y arquitectura de la nube.
En la sección Implementación de este documento, se proporciona un codelab que puedes usar para aprender a compilar una solución de análisis de agentes.
Arquitectura
En el siguiente diagrama, se muestra una arquitectura para una solución de análisis de agentes que obtiene estadísticas empresariales a partir de datos estructurados y no estructurados que se distribuyen en varios almacenes de datos y proveedores de servicios en la nube.
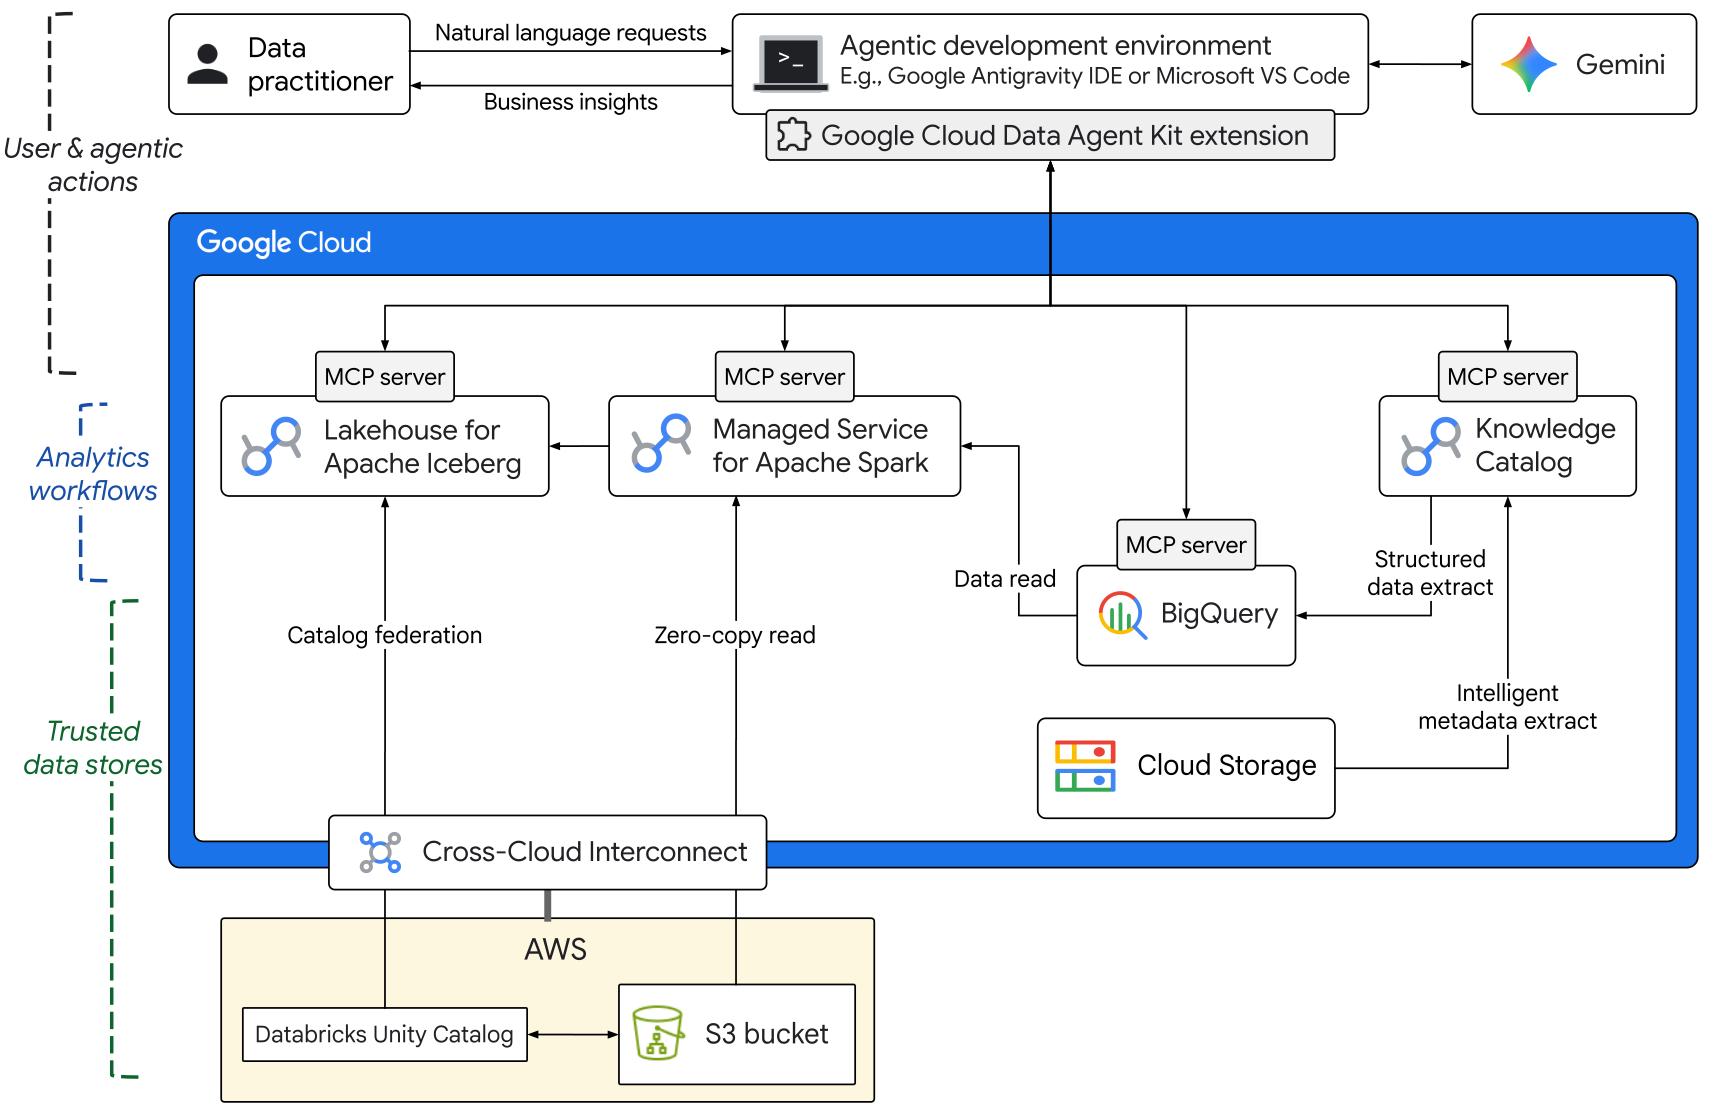
Los componentes de esta arquitectura se organizan en las siguientes capas:
Acciones del usuario y de los agentes
- Entorno de desarrollo de agentes: Los Data Practitioners, como los ingenieros de datos
y los científicos de datos, envían solicitudes en lenguaje natural con uno de los
siguientes métodos:
- Un entorno de desarrollo de agentes, como el IDE de Google Antigravity o Microsoft Visual Studio Code.
- Un agente de CLI, como CLI de Antigravity, Claude Code o Codex
- Google Cloud Data Agent Kit: Data Agent Kit permite que los agentes accedan a datos de confianza en Google Cloud cargando las habilidades adecuadas y conectándose a servidores de MCP remotos para los servicios de Google Cloud .
- Modelo de base: Para generar estadísticas empresariales a partir de datos y contexto confiables, el entorno de desarrollo de agentes usa un modelo de base, como un modelo de la familia Gemini. El modelo usa las habilidades adecuadas del Data Agent Kit y las herramientas necesarias del servidor de MCP para implementar flujos de trabajo de análisis complejos.
- Entorno de desarrollo de agentes: Los Data Practitioners, como los ingenieros de datos
y los científicos de datos, envían solicitudes en lenguaje natural con uno de los
siguientes métodos:
Flujos de trabajo de Analytics
- Lakehouse sin límites: Lakehouse proporciona un catálogo de metadatos unificado y de alto rendimiento que integra el formato de tabla abierta de Apache Iceberg con el almacenamiento de nivel empresarial en Google Cloud. Con el acceso a datos multinube, Lakehouse te permite federar catálogos externos, como Databricks Unity Catalog, sin mover ni copiar datos.
- Managed Service para Apache Spark: Este es el componente principal de procesamiento de datos de la arquitectura. La función Lightning Engine de Managed Service para Apache Spark admite el procesamiento de datos sin servidores y de alto rendimiento en modos interactivo y por lotes. Los trabajos de procesamiento de datos de Spark usan metadatos del catálogo de Iceberg en Lakehouse, leen datos estructurados de BigQuery y realizan lecturas sin copia de fuentes externas, como Amazon S3.
- Knowledge Catalog: El agente usa Knowledge Catalog para realizar análisis inteligentes de datos no estructurados en Cloud Storage, extrae metadatos semánticos y compila un gráfico de contexto.
Almacenes de datos de confianza
- Datos en Google Cloud: BigQuery funciona como el almacén central para los datos estructurados, incluidos los extractos estructurados de datos no estructurados en Cloud Storage.
- Datos de fuentes externas: En la arquitectura, se muestran fuentes de datos externas, como datos en buckets de Amazon S3 y metadatos en Databricks Unity Catalog. Cross-Cloud Interconnect proporciona conectividad dedicada de gran ancho de banda entre Google Cloud y otros proveedores de servicios en la nube.
Productos usados
La arquitectura usa los siguientes productos y herramientas de Google Cloud :
- Google Cloud Data Agent Kit: Son extensiones de agentes que permiten que los científicos de datos, los ingenieros de datos y los desarrolladores de apps de datos administren todo el ciclo de vida de los datos desde sus entornos de desarrollo de agentes preferidos.
- BigQuery: Un almacén de datos empresarial que te ayuda a administrar y analizar tus datos con funciones integradas, como el aprendizaje automático, el análisis geoespacial y la inteligencia empresarial.
- Managed Service para Apache Spark: Es un servicio administrado que ejecuta cargas de trabajo por lotes de Apache Spark en una infraestructura de procesamiento administrada.
- Lakehouse: Es un motor de almacenamiento de alto rendimiento que te permite crear data lakehouses de datos abiertos y proporciona una interfaz unificada para análisis avanzados y la IA.
- Knowledge Catalog: Es un servicio potenciado por IA que proporciona un catálogo unificado de recursos de datos con metadatos inteligentes y capacidades de administración.
- Gemini: Es una familia de modelos de IA multimodales desarrollados por Google.
- Cloud Storage: Es un almacén de objetos de bajo costo y sin límites para varios tipos de datos. Se puede acceder a los datos desde y hacia Google Cloud, y estos se replican en las ubicaciones para aumentar la redundancia.
- Cross-Cloud Interconnect: Es un servicio que proporciona conectividad dedicada de gran ancho de banda y baja latencia entre Google Cloud y otros proveedores de servicios en la nube.
- Servidores de MCP de Google Cloud: Son servicios remotos administrados por Google que implementan el Protocolo de contexto del modelo (MCP) para proporcionar a las aplicaciones de IA acceso a los productos y servicios de Google y Google Cloud .
Casos de uso
La arquitectura que se describe en este documento es adecuada para los siguientes casos de uso:
- Análisis de datos de múltiples nubes: Consulta y analiza de forma eficiente los datos que se distribuyen en Google Cloud y otros proveedores de servicios en la nube sin mover archivos ni compilar canalizaciones complejas de extracción, transformación y carga (ETL). Por ejemplo, un gerente de marketing de un comercio minorista global puede analizar la eficacia de las campañas de marketing uniendo los datos de lealtad de los clientes en Amazon S3 con los datos de las operaciones de marketing en BigQuery.
- Descubrimiento inteligente de datos: Usa instrucciones en lenguaje natural y agentes de IA para descubrir, consultar y procesar conjuntos de datos federados en varios entornos. Por ejemplo, un especialista en adquisiciones puede determinar las causas comunes de las interrupciones en la cadena de suministro en función de los datos estructurados de un sistema de administración de la cadena de suministro (SCM) combinados con las estadísticas de las comunicaciones por correo electrónico no estructuradas y los informes de evaluación de daños.
- Extracción de datos estructurados de fuentes no estructuradas: Analiza grandes volúmenes de datos no estructurados, deriva metadatos semánticos y almacena extractos de datos estructurados en BigQuery para su análisis posterior. Por ejemplo, un controlador de operaciones puede analizar los gastos de manera eficiente extrayendo datos estructurados de miles de facturas que se almacenan en un formato no estructurado, como archivos PDF.
Consideraciones de seguridad
Para ayudar a abordar los riesgos de seguridad únicos de los agentes de IA, Google recomienda un enfoque que combina controles de seguridad determinísticos con defensas dinámicas basadas en el razonamiento:
- Supervisión humana: Incorpora un flujo con intervención humana en los sistemas críticos para la empresa, de modo que los supervisores humanos puedan revisar los resultados y aprobar, anular o pausar las acciones de los agentes.
- Identidad del agente: Asigna a cada agente una identidad vinculada a la carga de trabajo para aplicar el control de acceso con privilegios mínimos y administrar de forma centralizada las credenciales de las herramientas externas.
- Agent Gateway: Aplica la administración del tráfico de entrada y salida, las políticas de acceso de denegación predeterminada y la inspección de instrucciones y herramientas intercaladas con Model Armor.
- Agent Registry: Verifica que los agentes solo se conecten a subagentes y herramientas de MCP aprobados.
La guía de esta sección no está completa. Para obtener más información sobre los factores de diseño y las prácticas recomendadas, y para obtener recomendaciones sobre cómo compilar e implementar un sistema de IA de agentes múltiples, consulta Sistema de IA de agentes múltiples en Google Cloud.
Para conocer los principios y las recomendaciones de seguridad específicos de las cargas de trabajo de IA y AA, consulta Perspectiva de IA y AA: Seguridad en el Well-Architected Framework.
Implementación
Para aprender a compilar una solución de análisis de agentes con Data Agent Kit, consulta el codelab De datos sin procesar a previsiones en segundos con agentes de IA. En el codelab, se muestra cómo Data Agent Kit te permite analizar datos de forma eficiente desde tu entorno de desarrollo de agentes preferido. Todos los datos de muestra que usa el codelab se almacenan en Google Cloud.
¿Qué sigue?
- Obtén información sobre cómo Data Agent Kit te permite usar notebooks para la transformación y el análisis de datos.
- Explora los casos de uso de Knowledge Catalog.
- Obtén más información sobre el acceso a los datos multinube con Lakehouse.
- Aprende a acelerar las cargas de trabajo de Apache Spark con Lightning Engine.
- Obtén información sobre cómo puedes usar Knowledge Catalog como una capa de administración y de agentes para BigQuery.
- Para obtener más información sobre las arquitecturas de referencia, los diagramas y las prácticas recomendadas, explora Cloud Architecture Center.
Colaboradores
Autor: Kumar Dhanagopal | Desarrollador de soluciones entre productos
Otros colaboradores:
- Abirami Sukumaran | Developers Advocate de personal
- Arti Prasad | Escritora técnica
- Brad Miro | Senior Developer Advocate
- Matthew Rahmann | Gerente de producto sénior
- Ranadip Chatterjee | Ingeniero de soluciones
- Remigiusz Samborski | Ingeniero principal de relaciones con desarrolladores