


Questo documento fornisce un'architettura di alto livello per creare un data lakehouse aperto senza confini che stabilisce una pipeline sicura e altamente gestita da silos non elaborati senza confini direttamente ad azioni basate sull'AI. Mostra come unificare i dati aziendali frammentati tra Google Cloud, altri cloud provider e database operativi live senza fare affidamento su pipeline di estrazione, trasformazione e caricamento (ETL) fragili che possono duplicare i dati.
Il pubblico di destinazione di questo documento include data engineer, data architect e sviluppatori AI che devono progettare sistemi federati ad alte prestazioni che utilizzano standard aperti. Il pubblico di destinazione potrebbe anche dover gestire vincoli aziendali, come il routing di rete senza confini e un isolamento rigoroso della gestione di identità e accessi.
La sezione Deployment di questo documento fornisce un esempio di codice che ti aiuta a creare ed eseguire il deployment dell'architettura descritta in questo documento.
Architettura
Il seguente diagramma mostra un'architettura senza confini con un lakehouse centrale in Google Cloud.
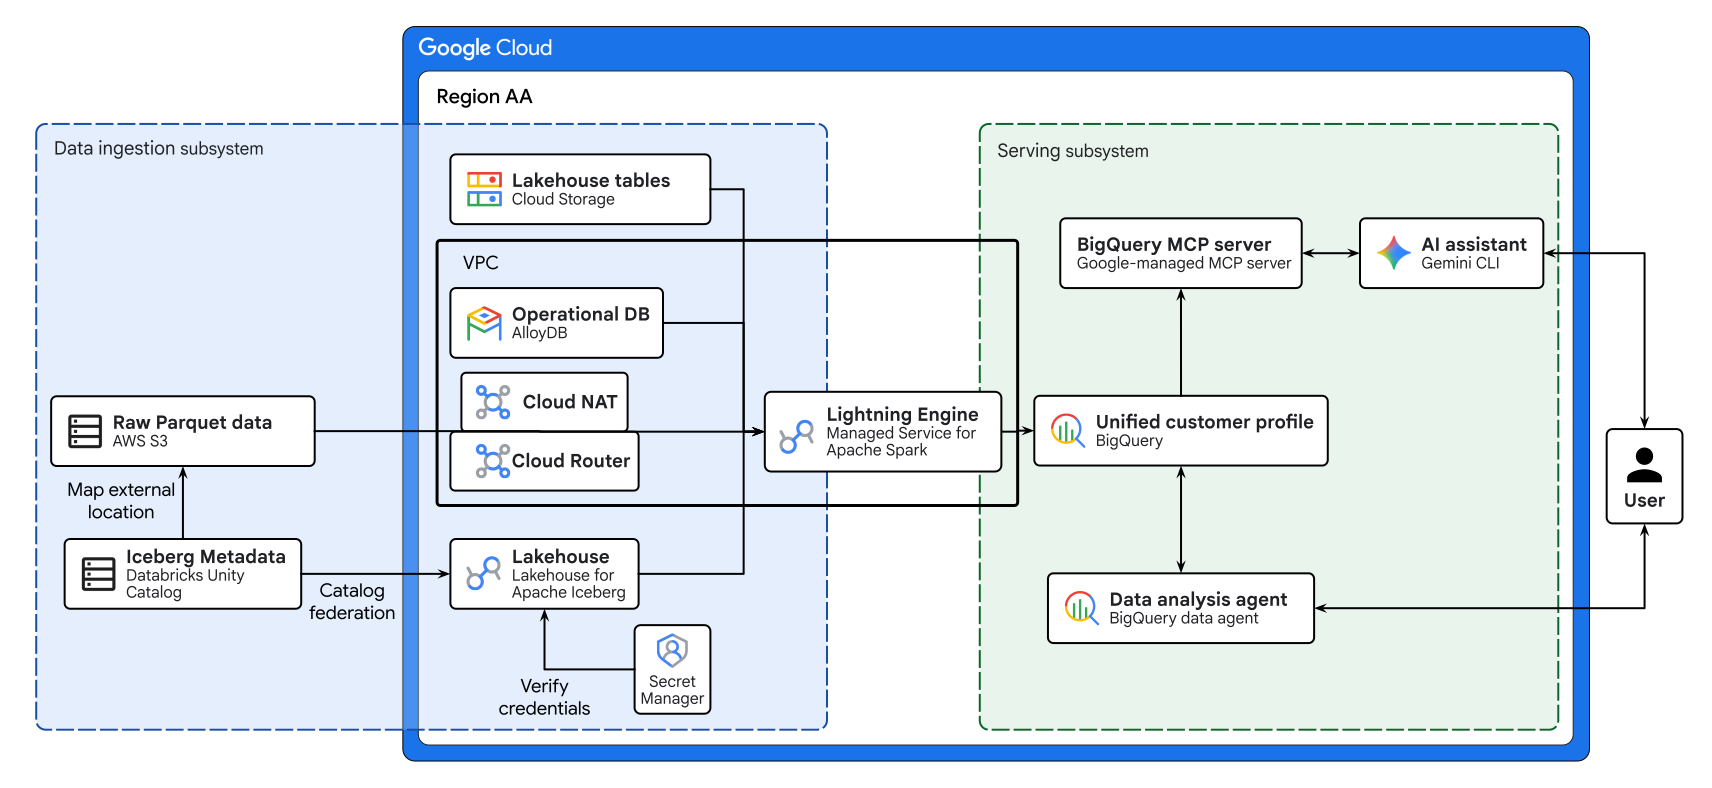
L'architettura nel diagramma precedente è composta da due sottosistemi: acquisizione dei dati e distribuzione.
- Il sottosistema di acquisizione dei dati acquisisce i dati da origini esterne. Utilizza un lakehouse centrale per unificare ed elaborare database frammentati in un profilo cliente unificato in Google Cloud.
- Il sottosistema di gestione consente agli utenti di eseguire query su un assistente AI e su un agente di analisi dei dati per analizzare i dati consolidati.
Le sezioni seguenti descrivono i componenti dei sottosistemi.
Sottosistema di acquisizione dei dati
Il sottosistema di importazione dati contiene i seguenti componenti:
- Managed Service for Apache Spark con Lightning Engine
-
Un servizio che fornisce un motore di elaborazione distribuito che gestisce workload analitici complessi, come unioni dei dati su larga scala e senza confini e trasformazioni. Per massimizzare l'efficienza di calcolo, Managed Service for Apache Spark utilizza Lightning Engine per gestire i join multidirezionali di grandi dimensioni, il windowing complesso e le aggregazioni comportamentali necessarie per combinare le origini dati senza confini.
Managed Service for Apache Spark utilizza Lightning Engine per eseguire il join distribuito importando i dati dai seguenti percorsi:
- File Parquet da Amazon S3.
- Log eventi di Cloud Storage.
- Dati transazionali in tempo reale da AlloyDB per PostgreSQL tramite connessioni BigQuery .
- Origini dati esterne
-
Gli asset di dati aziendali che risiedono in altri ambienti cloud. Nell'architettura descritta in questo documento, le origini dati esterne sono le seguenti:
- Databricks Unity Catalog: un catalogo esterno che gestisce i metadati per le tabelle Apache Iceberg in formato aperto.
- Amazon S3: un servizio di archiviazione di oggetti esterno che archivia i file di dati non elaborati per le tabelle Iceberg in formato Apache Parquet.
La connessione a origini dati esterne ti consente di analizzare i dati in loco ed evita la necessità di una migrazione dei dati costosa e dispendiosa in termini di tempo. Sebbene questa architettura di esempio utilizzi Databricks Unity Catalog e bucket Amazon S3, puoi utilizzare questo pattern di architettura con altri servizi di catalogo Iceberg esterni e provider di spazio di archiviazione sul cloud.
- AlloyDB
- Un database ad alte prestazioni per l'elaborazione transazionale e analitica ibrida (HTAP), ad esempio quando gestisci l'inventario in tempo reale o i profili dei clienti in tempo reale. La federazione di BigQuery AlloyDB consente ai motori di analisi di inviare una query da BigQuery direttamente ai dati transazionali in tempo reale archiviati in AlloyDB. Questo approccio consente di evitare la latenza e l'overhead associati alle pipeline di Change Data Capture (CDC).
- Cloud Storage
- Un servizio di archiviazione di oggetti scalabile per dati con throughput elevato, come gli eventi clickstream. Per garantire che i dati siano accessibili da una varietà di motori di elaborazione, utilizza Cloud Storage per disaccoppiare i dati da servizi di computing specifici e archiviali nel formato aperto Apache Iceberg, come Apache Parquet.
- Lakehouse senza confini
-
Il sistema centrale di metadati e governance che consente una federazione unificata senza confini. Per stabilire la connessione ai metadati del lakehouse, Lakehouse esegue le seguenti azioni:
- Connettiti a Databricks Unity Catalog per risolvere le informazioni sullo schema e sul routing per i dati senza confini.
- Invia una richiesta a Secret Manager per verificare le credenziali:
- Se le credenziali vengono approvate, stabilisci una connessione diretta ai metadati della lakehouse.
- Se le credenziali vengono rifiutate, restituisci un messaggio di errore e interrompi l'operazione.
- Cloud NAT e Router Cloud
- Servizi gestiti che consentono alle risorse all'interno della rete Google Cloud di accedere in modo sicuro ai dati da origini cloud esterne senza esporre queste risorse alla rete internet pubblica.
- Virtual Private Cloud (VPC)
- Un servizio che fornisce una rete privata, sicura e isolata per tutte le risorse Google Cloud di cui viene eseguito il deployment nell'ambito di questa architettura.
- Secret Manager
- Un servizio che archivia in modo sicuro le credenziali dell'entità di servizio Databricks, come l'ID client e il secret, per l'autenticazione senza confini.
Sottosistema di pubblicazione
Il sottosistema di pubblicazione contiene i seguenti componenti:
- Profilo cliente unificato
- Un database BigQuery che consolida l'output dei job Spark distribuiti. La tabella BigQuery trasforma le metriche frammentate senza confini in tipi di dati denormalizzati complessi e funge da datastore centrale e gestito per l'analisi.
- Agente di dati BigQuery
- Un agente di analisi conversazionale che consente agli utenti di eseguire query sui dati direttamente in BigQuery e genera insight aziendali. L'agente applica le misure di protezione della sicurezza e della governance alle query.
- Server MCP BigQuery
- Un server Model Context Protocol (MCP) gestito da Google che fornisce l'accesso ai dati BigQuery. Il server MCP BigQuery espone in modo sicuro il contesto del lakehouse gestito ai modelli di AI locali o esterni, come Gemini CLI. Consente workflow agentici end-to-end senza richiedere agli ingegneri AI di creare e gestire middleware API REST personalizzati.
- Gemini CLI
- Un assistente AI da riga di comando che consente agli utenti di interagire con il profilo cliente unificato per generare contenuti personalizzati basati sui dati, come campagne di marketing personalizzate. La Gemini CLI funge da client per il server MCP BigQuery per accedere ai dati archiviati nel profilo cliente unificato.
Prodotti utilizzati
Questa architettura di esempio utilizza i seguenti prodotti e strumenti Google Cloud :
- Lakehouse: un motore di archiviazione ad alte prestazioni che consente di creare data lakehouse aperti e fornisce un'interfaccia unificata per l'analisi avanzata e l'AI.
- BigQuery: un data warehouse aziendale che ti aiuta a gestire e analizzare i tuoi dati con funzionalità integrate come machine learning, analisi geospaziale e business intelligence.
- AlloyDB per PostgreSQL: un servizio di database completamente gestito e compatibile con PostgreSQL, progettato per i carichi di lavoro più impegnativi, tra cui l'elaborazione analitica e transazionale ibrida.
- Managed Service for Apache Spark: un servizio gestito che esegue workload batch Apache Spark su un'infrastruttura di computing gestita.
- Cloud Storage: un archivio di oggetti a basso costo e senza limiti per diversi tipi di dati. I dati sono accessibili dall'interno e dall'esterno di Google Cloude vengono replicati in più località per la ridondanza.
- Gemini: una famiglia di modelli di AI multimodali sviluppati da Google.
- Server MCP di Google Cloud: servizi remoti gestiti da Google che implementano il Model Context Protocol (MCP) per fornire alle applicazioni AI l'accesso ai prodotti e ai servizi Google e Google Cloud .
- Cloud NAT: un servizio che fornisce Network Address Translation ad alte prestazioni gestita da Google Cloud.
- router Cloud: un'offerta distribuita e completamente gestita che fornisce funzionalità di speaker e responder del protocollo BGP (Border Gateway Protocol). Router Cloud funziona con Cloud Interconnect, Cloud VPN e le appliance router per creare route dinamiche nelle reti VPC in base alle route apprese personalizzate e ricevute tramite BGP.
- Virtual Private Cloud (VPC): un sistema virtuale che fornisce funzionalità di networking globali e scalabili per i tuoi workload Google Cloud . VPC include il peering di rete VPC, Private Service Connect, l'accesso privato ai servizi e il VPC condiviso.
Questa architettura di esempio utilizza i seguenti prodotti di terze parti:
- Databricks Unity Catalog: un catalogo unificato di governance e metadati per gli asset di dati e AI sulla piattaforma Databricks.
- Amazon S3: un servizio di archiviazione di Amazon Web Services (AWS) che archivia e gestisce i dati come oggetti.
Casi d'uso
Questa architettura di riferimento è progettata per le organizzazioni che devono unificare i dati in silos provenienti da più ambienti cloud e sistemi on-premise per promuovere iniziative di analisi e AI. Questa architettura offre i seguenti vantaggi:
- Un profilo unificato senza confini: una singola visione olistica delle organizzazioni aziendali che consente ad analisti e decision maker di ottenere insight completi. Questa visualizzazione unificata migliora l'accuratezza dell'analisi e contribuisce a garantire che i dati siano coerenti e aggiornati, indipendentemente da dove sono archiviati.
- Riduzione della complessità operativa e del costo totale di proprietà (TCO): Lakehouse aiuta a evitare la necessità di creare e gestire pipeline di dati fragili. Questo approccio ti consente di eseguire query sui dati direttamente nella posizione in cui si trovano su diversi cloud. Evita l'overhead operativo, i costi di archiviazione e la latenza associati allo spostamento fisico dei dati.
- Workflow di AI agentica: gli agenti AI consentono agli analisti di dati di tradurre aggregazioni comportamentali complesse direttamente in strategie aziendali attuabili. Gli agenti consentono agli analisti di accedere in modo sicuro ai dati strutturati e governati del lakehouse tramite protocolli standard.
Di seguito sono riportati alcuni esempi di casi d'uso per l'architettura descritta in questo documento:
- Analisi della vendita al dettaglio in tempo reale: un'azienda di vendita al dettaglio deve prendere decisioni immediate in base alle vendite e all'inventario. Questa architettura consente loro di combinare i dati statici del catalogo dei prodotti, gestiti in AWS, con i dati delle transazioni di vendita in tempo reale del database operativo AlloyDB su Google Cloud. Gli analisti e gli store manager possono eseguire query su questa visualizzazione unificata a intervalli di batch predefiniti per monitorare il rendimento di una vendita, identificare gli articoli più venduti per il riassortimento o analizzare i modelli di acquisto regionali man mano che emergono.
- Personalizzazione dei clienti: una società di servizi finanziari vuole fornire ai propri relationship manager una visualizzazione unificata completa dei clienti. L'azienda può utilizzare questa architettura per unificare i dati storici sul coinvolgimento di marketing provenienti da un data lake su AWS con le informazioni in tempo reale sugli account dei clienti provenienti da AlloyDB. Un relationship manager può quindi utilizzare l'assistente AI per porre domande, ad esempio "Riassumi le ultime tre transazioni per questo cliente e scrivi una bozza di email personalizzata che suggerisca un nuovo conto di risparmio ad alto rendimento".
Considerazioni sulla progettazione
Questa sezione descrive i fattori di progettazione, le best practice e i suggerimenti da considerare quando utilizzi questa architettura di riferimento per sviluppare una topologia che soddisfi i tuoi requisiti specifici di sicurezza e costi.
Le indicazioni riportate in questa sezione non sono esaustive. Per saperne di più sui fattori di progettazione e sulle best practice, nonché per i consigli sulla creazione e sul deployment di un sistema di AI multi-agente, consulta Sistema di AI multi-agente in Google Cloud.
Sicurezza, privacy e conformità
Per applicare il principio del privilegio minimo, gestisci l'accesso tramite identità gestite dal sistema. Prendi in considerazione i seguenti consigli:
- Per creare e gestire le autorizzazioni per le risorse Google Cloud , utilizza il servizio Identity and Access Management (IAM) di Google.
- Per accedere in modo sicuro ai dati non elaborati in Cloud Storage, utilizza le connessioni alle risorse Cloud di BigQuery.
- Per autenticare in modo sicuro le connessioni Databricks cross-cloud, utilizza la federazione dei cataloghi Lakehouse con Secret Manager.
Sicurezza e governance degli agenti
Per contribuire ad affrontare i rischi di sicurezza unici degli agenti AI, Google consiglia un approccio che combina controlli di sicurezza deterministici con difese dinamiche basate sul ragionamento:
- Supervisione umana: incorpora un flusso human-in-the-loop nei sistemi aziendali critici in modo che i supervisori umani possano esaminare gli output e approvare, ignorare o mettere in pausa le azioni degli agenti.
- Agent Identity: assegna a ogni agente un'identità associata al workload per applicare controllo dell'accesso con privilegio minimo e gestire centralmente le credenziali per gli strumenti esterni.
- Agent Gateway: applica la governance del traffico in entrata e in uscita, le policy di accesso con rifiuto predefinito e l'ispezione dei prompt e degli strumenti in linea con Model Armor.
- Agent Registry: verifica che gli agenti si connettano solo a subagenti e strumenti MCP approvati.
Ottimizzazione di costi e prestazioni
Per assicurarti che le configurazioni degli agenti soddisfino i requisiti di costo e prestazioni, tieni presente i seguenti suggerimenti:
- Selezione del computing: per ottimizzare prestazioni e costi, seleziona un servizio di computing più adatto a ogni parte del tuo workload. Un lakehouse di dati moderno non si basa su un servizio di computing monolitico. Per applicare filtri di corrispondenza esatta ai database operativi, utilizza le query federate di BigQuery. Per l'offload di manipolazioni di dati complesse e con un utilizzo intensivo della memoria, come i join vettorizzati senza confini, utilizza Managed Service for Apache Spark con Lightning Engine.
- Grounding del modello di AI: per mitigare le allucinazioni del modello di AI, esegui il grounding del modello sul profilo cliente unificato per applicare le definizioni aziendali e la convalida statistica. Quando esponi il modello di AI a dati non aggregati, non elaborati e senza confini su miliardi di righe, ciò può portare a un consumo eccessivo di token e a tassi di allucinazione elevati.
- Topologia di rete e strategia di traffico in uscita: per garantire prestazioni affidabili e ridurre al minimo i costi di trasferimento dei dati su reti senza confini, utilizza Cross-Cloud Interconnect per stabilire una connessione privata tra Google Cloud e AWS. In caso contrario, le query sui dati su internet pubblico da Google Cloud ad AWS possono comportare tariffe di uscita elevate e latenza imprevedibile.
Deployment
Per eseguire il deployment di questa architettura, consulta il codelab Creazione di un open data lakehouse senza confini. Questa implementazione di esempio ti aiuta a eseguire il provisioning dell'infrastruttura di rete specifica, a eseguire i flussi di lavoro PySpark C++ e a configurare gli agenti AI per interagire in sicurezza con il tuo lakehouse.
Passaggi successivi
- Scopri come utilizzare il catalogo di runtime di Lakehouse con le tabelle in BigQuery.
- Scopri come accelerare Spark con Lightning Engine.
- Scopri come analizzare i dati con le conversazioni.
- Per una panoramica dei principi e dei suggerimenti di architettura specifici per i workload di AI e ML in Google Cloud, consulta la prospettiva di AI e ML nel Well-Architected Framework.
- Per ulteriori architetture di riferimento, diagrammi e best practice, esplora Cloud Architecture Center.
Collaboratori
Autore: Hyunuk Lim | Consulente per gli sviluppatori
Altri collaboratori:
- Brad Miro | Senior Developer Advocate
- Samantha He | Technical Writer