


Dokumen ini menyediakan arsitektur tingkat tinggi untuk membangun data lakehouse terbuka tanpa batas yang membuat pipeline yang sangat diatur dan aman dari silo tanpa batas mentah langsung ke tindakan berbasis AI. Solusi ini menunjukkan cara menyatukan data perusahaan yang terfragmentasi di seluruh Google Cloud, penyedia cloud lain, dan database operasional live tanpa mengandalkan pipeline ekstrak, transformasi, dan pemuatan (ETL) yang rentan dan dapat menduplikasi data.
Audiens yang dituju untuk dokumen ini mencakup data engineer, arsitek data, dan developer AI yang perlu mendesain sistem gabungan berperforma tinggi yang menggunakan standar terbuka. Audiens yang dituju mungkin juga menghadapi batasan perusahaan, seperti pemilihan rute jaringan tanpa batas serta isolasi pengelolaan akses dan identitas yang ketat.
Bagian deployment dalam dokumen ini menyediakan contoh kode yang membantu Anda membangun dan men-deploy arsitektur yang dijelaskan dalam dokumen ini.
Arsitektur
Diagram berikut menunjukkan arsitektur tanpa batas dengan lakehouse pusat di Google Cloud.
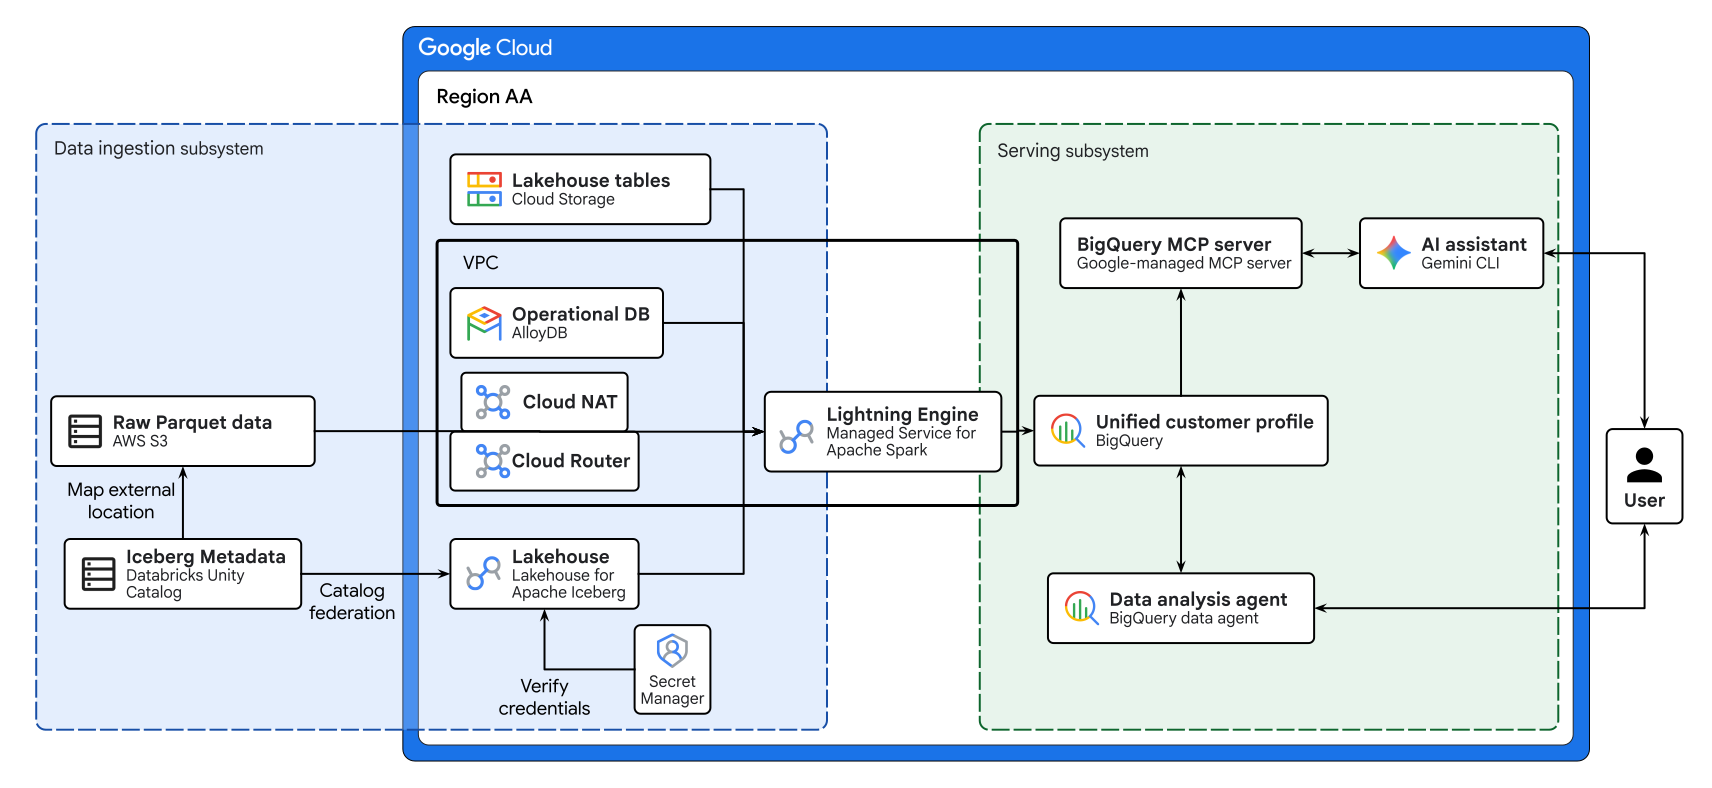
Arsitektur dalam diagram sebelumnya terdiri dari dua subsistem: penyerapan data dan penyajian.
- Subsistem penyerapan data menyerap data dari sumber eksternal. Solusi ini menggunakan lakehouse pusat untuk menyatukan dan memproses database yang terfragmentasi menjadi profil pelanggan terpadu di Google Cloud.
- Subsistem inferensi memungkinkan pengguna mengkueri asisten AI dan agen analisis data untuk menganalisis data gabungan.
Bagian berikut menjelaskan komponen di seluruh subsistem.
Subsistem penyerapan data
Subsistem penyerapan data berisi komponen berikut:
- Managed Service untuk Apache Spark dengan Lightning Engine
-
Layanan yang menyediakan mesin pemrosesan terdistribusi yang menangani workload analisis yang kompleks, seperti penggabungan dan transformasi data tanpa batas berskala besar. Untuk memaksimalkan efisiensi komputasi, Managed Service untuk Apache Spark menggunakan Lightning Engine untuk menangani penggabungan multi-arah yang masif, windowing yang kompleks, dan agregasi perilaku yang diperlukan untuk menggabungkan sumber data tanpa batas.
Managed Service untuk Apache Spark menggunakan Lightning Engine untuk menjalankan penggabungan terdistribusi dengan menyerap data dari jalur berikut:
- File Parquet dari Amazon S3.
- Log peristiwa Cloud Storage.
- Data transaksional langsung dari AlloyDB untuk PostgreSQL melalui koneksi BigQuery.
- Sumber data eksternal
-
Aset data perusahaan yang berada di lingkungan cloud lain. Dalam arsitektur yang dijelaskan dokumen ini, sumber data eksternalnya adalah sebagai berikut:
- Databricks Unity Catalog: Katalog eksternal yang mengelola metadata untuk tabel Apache Iceberg berformat terbuka.
- Amazon S3: Layanan penyimpanan objek eksternal yang menyimpan file data mentah untuk tabel Iceberg dalam format Apache Parquet.
Dengan terhubung ke sumber data eksternal, Anda dapat menganalisis data di tempat dan menghindari migrasi data yang mahal dan memakan waktu. Meskipun arsitektur contoh ini menggunakan Databricks Unity Catalog dan bucket Amazon S3, Anda dapat menggunakan pola arsitektur ini dengan layanan katalog Iceberg eksternal dan penyedia penyimpanan cloud lainnya.
- AlloyDB
- Database berperforma tinggi untuk pemrosesan transaksional dan analisis hybrid (HTAP), seperti saat Anda mengelola inventaris real-time atau profil pelanggan langsung. Federasi BigQuery AlloyDB memungkinkan mesin analisis mengirim kueri dari BigQuery langsung ke data transaksional live yang disimpan di AlloyDB. Pendekatan ini membantu menghindari latensi dan overhead yang terkait dengan pipeline change data capture (CDC).
- Cloud Storage
- Layanan penyimpanan objek yang skalabel untuk data dengan throughput tinggi, seperti peristiwa clickstream. Untuk membantu memastikan bahwa data dapat diakses oleh berbagai mesin pemrosesan, gunakan Cloud Storage untuk memisahkan data dari layanan komputasi tertentu dan menyimpan data dalam format Apache Iceberg terbuka, seperti Apache Parquet.
- Lakehouse Tanpa Batas
-
Sistem metadata dan tata kelola pusat yang memungkinkan penggabungan terpadu tanpa batas. Untuk membuat koneksi ke metadata lakehouse, Lakehouse melakukan tindakan berikut:
- Hubungkan ke Databricks Unity Catalog untuk menyelesaikan skema dan informasi perutean untuk data tanpa batas.
- Kirim permintaan ke Secret Manager untuk memverifikasi kredensial:
- Jika kredensial disetujui, buat koneksi langsung ke metadata lakehouse.
- Jika kredensial ditolak, tampilkan pesan error dan batalkan operasi.
- Cloud NAT dan Cloud Router
- Layanan terkelola yang memungkinkan resource dalam jaringan Google Cloud mengakses data dari sumber cloud eksternal dengan aman tanpa mengekspos resource tersebut ke internet publik.
- Virtual Private Cloud (VPC)
- Layanan yang menyediakan jaringan pribadi, aman, dan terisolasi untuk semua resource Google Cloud yang di-deploy sebagai bagian dari arsitektur ini.
- Secret Manager
- Layanan yang menyimpan kredensial akun utama layanan Databricks dengan aman, seperti client ID dan rahasia, untuk autentikasi tanpa batas.
Subsistem inferensi
Subsistem inferensi berisi komponen berikut:
- Profil pelanggan terpadu
- Database BigQuery yang menggabungkan output tugas Spark terdistribusi. Tabel BigQuery mengubah metrik tanpa batas yang terfragmentasi menjadi jenis data denormalisasi yang kompleks dan berfungsi sebagai datastore pusat yang diatur untuk analisis.
- Agen data BigQuery
- Agen analisis percakapan yang memungkinkan pengguna mengkueri data langsung di BigQuery dan menghasilkan insight perusahaan. Agen menerapkan pagar pembatas keamanan dan tata kelola pada kueri.
- Server MCP BigQuery
- Server Model Context Protocol (MCP) yang dikelola Google yang menyediakan akses ke data BigQuery. Server MCP BigQuery mengekspos konteks lakehouse yang diatur dengan aman ke model AI lokal atau eksternal, seperti Gemini CLI. Alat ini memungkinkan Agentic Workflows end-to-end tanpa mengharuskan engineer AI membangun dan memelihara middleware REST API kustom.
- Gemini CLI
- Asisten AI command line yang memungkinkan pengguna berinteraksi dengan profil pelanggan terpadu untuk membuat konten yang dipersonalisasi dan berbasis data, seperti kampanye pemasaran yang dipersonalisasi. Gemini CLI bertindak sebagai klien untuk server MCP BigQuery guna mengakses data yang disimpan di profil pelanggan terpadu.
Produk yang digunakan
Contoh arsitektur ini menggunakan produk dan alat Google Cloud berikut:
- Lakehouse: Mesin penyimpanan berperforma tinggi yang memungkinkan Anda membangun data lakehouse terbuka dan menyediakan antarmuka terpadu untuk analisis lanjutan dan AI.
- BigQuery: Data warehouse perusahaan yang membantu Anda mengelola dan menganalisis data dengan fitur bawaan seperti machine learning, analisis geospasial, dan business intelligence.
- AlloyDB untuk PostgreSQL: Layanan database yang kompatibel dengan PostgreSQL dan terkelola sepenuhnya, yang didesain untuk workload dengan tuntutan tinggi, termasuk pemrosesan transaksional dan analisis hybrid.
- Managed Service untuk Apache Spark: Layanan terkelola yang menjalankan workload batch Apache Spark di infrastruktur komputasi terkelola.
- Cloud Storage: Penyimpanan objek berbiaya rendah dan tanpa batas untuk beragam jenis data. Data dapat diakses dari dalam dan luar Google Cloud, serta direplikasi di berbagai lokasi untuk redundansi.
- Gemini: Rangkaian model AI multimodal yang dikembangkan oleh Google.
- Server MCP Google Cloud: Layanan jarak jauh yang dikelola Google yang mengimplementasikan Model Context Protocol (MCP) untuk memberikan akses ke produk dan layanan Google dan Google Cloud kepada aplikasi AI.
- Cloud NAT: Layanan yang menyediakan penafsiran alamat jaringan berperforma tinggi yang dikelola Google Cloud.
- Cloud Router: Penawaran terdistribusi dan terkelola sepenuhnya yang menyediakan kemampuan speaker dan responder Border Gateway Protocol (BGP). Cloud Router berfungsi dengan Cloud Interconnect, Cloud VPN, dan Router appliance untuk membuat rute dinamis di jaringan VPC berdasarkan rute yang diterima BGP dan rute kustom yang dipelajari.
- Virtual Private Cloud (VPC): Sistem virtual yang menyediakan fungsionalitas jaringan global yang skalabel untuk workload Google Cloud Anda. VPC mencakup Peering Jaringan VPC, Private Service Connect, akses layanan pribadi, dan VPC Bersama.
Contoh arsitektur ini menggunakan produk pihak ketiga berikut:
- Databricks Unity Catalog: Katalog metadata dan tata kelola terpadu untuk aset data dan AI di platform Databricks.
- Amazon S3: Layanan penyimpanan dari Amazon Web Services (AWS) yang menyimpan dan mengelola data sebagai objek.
Kasus penggunaan
Arsitektur referensi ini dirancang untuk organisasi yang perlu menyatukan data yang tersekat-sekat dari beberapa lingkungan cloud dan sistem lokal untuk mendorong inisiatif analisis dan AI. Arsitektur ini memberikan manfaat berikut:
- Profil terpadu tanpa batas: Satu tampilan entitas bisnis yang menyeluruh, sehingga analis dan pengambil keputusan dapat memperoleh insight yang komprehensif. Tampilan terpadu ini meningkatkan akurasi analisis dan membantu memastikan bahwa data konsisten dan terbaru, di mana pun data disimpan.
- Mengurangi kompleksitas operasional dan total biaya kepemilikan (TCO): Lakehouse membantu menghindari kebutuhan untuk membangun dan memelihara pipeline data yang rentan. Dengan pendekatan ini, Anda dapat mengkueri data secara langsung di tempat data tersebut berada di berbagai cloud. Hal ini menghindari overhead operasional, biaya penyimpanan, dan latensi yang terkait dengan pemindahan data fisik.
- Alur kerja AI agentic: Agen AI memberdayakan analis data untuk menerjemahkan agregasi perilaku yang kompleks secara langsung menjadi strategi bisnis yang dapat ditindaklanjuti. Agen memungkinkan analis mengakses data lakehouse yang terstruktur dan diatur dengan aman melalui protokol standar.
Berikut adalah contoh kasus penggunaan untuk arsitektur yang dijelaskan dalam dokumen ini:
- Analisis retail real-time: Perusahaan retail perlu membuat keputusan segera berdasarkan penjualan dan inventaris. Arsitektur ini memungkinkan mereka menggabungkan data katalog produk statis, yang dikelola di AWS, dengan data transaksi penjualan langsung dari database AlloyDB operasional mereka di Google Cloud. Analis dan pengelola toko dapat mengkueri tampilan terpadu ini pada interval batch yang telah ditentukan untuk memantau performa penjualan, mengidentifikasi item yang cepat terjual untuk diisi ulang, atau menganalisis pola pembelian regional saat muncul.
- Personalisasi pelanggan: Perusahaan jasa keuangan ingin memberikan tampilan yang lengkap dan terpadu tentang klien kepada manajer hubungannya. Perusahaan dapat menggunakan arsitektur ini untuk menyatukan data engagement pemasaran historis dari data lake di AWS dengan informasi akun pelanggan langsung dari AlloyDB. Kemudian, manajer hubungan dapat menggunakan asisten AI untuk mengajukan pertanyaan, seperti "ringkas tiga transaksi terakhir untuk klien ini dan buat draf email yang dipersonalisasi yang menyarankan rekening tabungan berimbal hasil tinggi yang baru".
Pertimbangan desain
Bagian ini menjelaskan faktor desain, praktik terbaik, dan rekomendasi yang perlu dipertimbangkan saat Anda menggunakan arsitektur referensi ini untuk mengembangkan topologi yang memenuhi persyaratan spesifik Anda terkait keamanan dan biaya.
Panduan di bagian ini tidak lengkap. Untuk mengetahui informasi selengkapnya tentang faktor desain dan praktik terbaik, serta rekomendasi tentang cara membangun dan men-deploy sistem AI multi-agen, lihat Sistem AI multi-agen di Google Cloud.
Keamanan, privasi, dan kepatuhan
Untuk membantu menerapkan prinsip hak istimewa terendah, kelola akses melalui identitas yang dikelola sistem. Pertimbangkan rekomendasi berikut:
- Untuk membuat dan mengelola izin resource Google Cloud , gunakan layanan Identity and Access Management (IAM) Google.
- Untuk mengakses data mentah di Cloud Storage dengan aman, gunakan koneksi resource Cloud BigQuery.
- Untuk mengautentikasi koneksi Databricks lintas cloud dengan aman, gunakan federasi katalog Lakehouse dengan Secret Manager.
Keamanan dan tata kelola agen
Untuk membantu mengatasi risiko keamanan unik agen AI, Google merekomendasikan pendekatan yang menggabungkan kontrol keamanan deterministik dengan pertahanan dinamis berbasis penalaran:
- Pengawasan manusia: Gabungkan alur human-in-the-loop dalam sistem yang penting bagi bisnis sehingga pengawas manusia dapat meninjau output dan menyetujui, mengganti, atau menjeda tindakan agen.
- Agent Identity: Menetapkan identitas yang terikat workload untuk setiap agen guna menerapkan kontrol akses dengan hak istimewa terendah dan mengelola kredensial untuk alat eksternal secara terpusat.
- Agent Gateway: Terapkan tata kelola traffic ingress dan egress, kebijakan akses tolak secara default, serta pemeriksaan perintah dan alat inline dengan Model Armor.
- Agent Registry: Memastikan agen hanya terhubung ke sub-agen dan alat MCP yang disetujui.
Pengoptimalan biaya dan performa
Untuk membantu memastikan konfigurasi agen Anda memenuhi persyaratan biaya dan performa, pertimbangkan rekomendasi berikut:
- Pemilihan komputasi: Untuk mengoptimalkan performa dan biaya, pilih layanan komputasi yang paling sesuai untuk setiap bagian workload Anda. Data lakehouse modern tidak mengandalkan layanan komputasi monolitik. Untuk melakukan filter pencocokan persis ke database operasional, gunakan kueri gabungan BigQuery. Untuk memindahkan manipulasi data yang kompleks dan menggunakan banyak memori, seperti penggabungan tanpa batas yang di-vektorisasi, gunakan Managed Service untuk Apache Spark dengan Lightning Engine.
- Grounding model AI: Untuk mengurangi halusinasi model AI, lakukan grounding pada model Anda menggunakan profil pelanggan terpadu untuk menerapkan definisi bisnis dan validasi statistik. Jika Anda mengekspos model AI ke data mentah tanpa batas yang tidak diagregasi di miliaran baris, hal ini dapat menyebabkan konsumsi token yang berlebihan dan tingkat halusinasi yang tinggi.
- Topologi jaringan dan strategi egress: Untuk membantu memastikan performa yang andal dan meminimalkan biaya transfer data melalui jaringan tanpa batas, gunakan Cross-Cloud Interconnect untuk membuat koneksi pribadi antara Google Cloud dan AWS. Jika tidak, kueri data melalui internet publik dari Google Cloud ke AWS dapat menimbulkan biaya egress yang tinggi dan latensi yang tidak dapat diprediksi.
Deployment
Untuk men-deploy arsitektur ini, lihat Codelab Membangun data lakehouse terbuka tanpa batas. Implementasi contoh ini membantu Anda menyediakan infrastruktur jaringan tertentu, menjalankan alur kerja PySpark C++, dan mengonfigurasi agen AI untuk berinteraksi dengan aman dengan lakehouse Anda.
Langkah berikutnya
- Pelajari cara menggunakan katalog runtime Lakehouse dengan tabel di BigQuery.
- Pelajari cara mempercepat Spark dengan Lightning Engine.
- Pelajari cara menganalisis data dengan percakapan.
- Untuk ringkasan prinsip dan rekomendasi arsitektur yang khusus untuk workload AI dan ML di Google Cloud, lihat Perspektif AI dan ML dalam Well-Architected Framework.
- Untuk mengetahui lebih banyak tentang arsitektur referensi, diagram, dan praktik terbaik lainnya, jelajahi Pusat Arsitektur Cloud.
Kontributor
Penulis: Hyunuk Lim | Advokat Developer
Kontributor lainnya:
- Brad Miro | Senior Developer Advocate
- Samantha He | Technical Writer