


Dieses Dokument bietet eine allgemeine Architektur zum Erstellen eines grenzenlosen offenen Data Lakehouse, das eine hochgradig verwaltete, sichere Pipeline von Rohdaten-Silos direkt zu KI-gesteuerten Aktionen einrichtet. Es wird gezeigt, wie Sie fragmentierte Unternehmensdaten in Google Cloud, anderen Cloud-Anbietern und Live-Betriebsdatenbanken vereinheitlichen können, ohne auf fehleranfällige ETL-Pipelines (Extrahieren, Transformieren und Laden) angewiesen zu sein, die Daten duplizieren können.
Die Zielgruppe für dieses Dokument umfasst Data Engineers, Data Architects und KI-Entwickler, die leistungsstarke föderierte Systeme mit offenen Standards entwerfen müssen. Die Zielgruppe muss möglicherweise auch mit Einschränkungen im Unternehmen umgehen, z. B. mit grenzenlosem Netzwerkrouting und strikter Isolation der Identitäts- und Zugriffsverwaltung.
Der Abschnitt Bereitstellung dieses Dokuments enthält ein Codebeispiel, mit dem Sie die in diesem Dokument beschriebene Architektur erstellen und bereitstellen können.
Architektur
Das folgende Diagramm zeigt eine grenzenlose Architektur mit einem zentralen Lakehouse in Google Cloud.
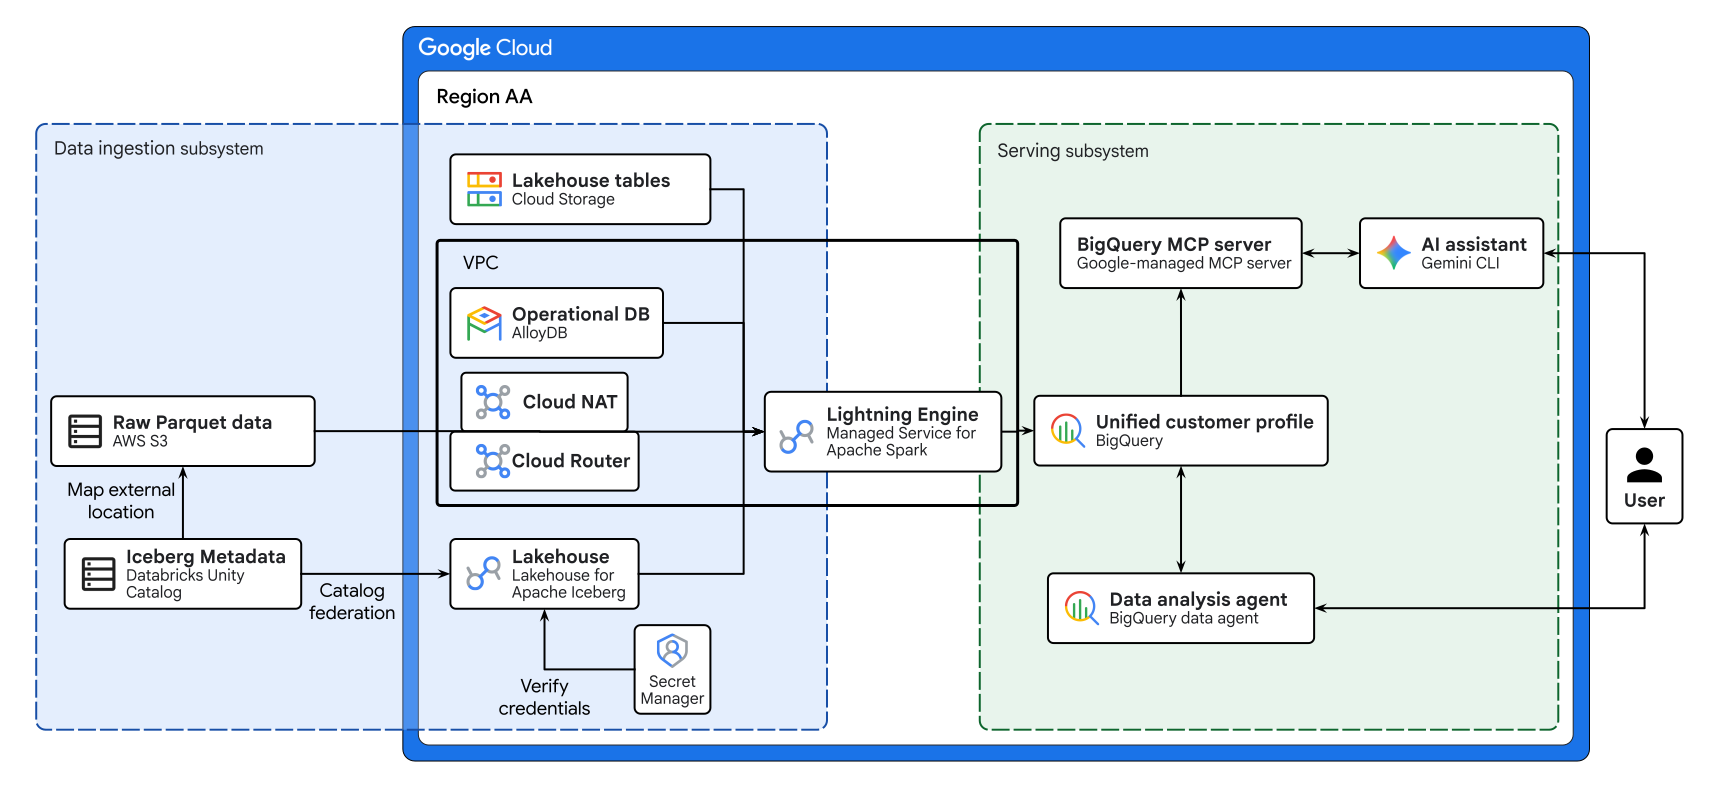
Die Architektur im vorherigen Diagramm besteht aus zwei Subsystemen: Datenaufnahme und Bereitstellung.
- Das Subsystem für die Datenaufnahme nimmt Daten aus externen Quellen auf. Es verwendet ein zentrales Lakehouse, um fragmentierte Datenbanken in einem einheitlichen Kundenprofil in Google Cloudzu vereinheitlichen und zu verarbeiten.
- Über das Subsystem für die Bereitstellung können Nutzer einen KI-Assistenten und einen Datenanalyse-Agenten abfragen, um die konsolidierten Daten zu analysieren.
In den folgenden Abschnitten werden die Komponenten der Subsysteme beschrieben.
Subsystem für die Datenaufnahme
Das Subsystem für die Datenaufnahme enthält die folgenden Komponenten:
- Managed Service for Apache Spark mit Lightning Engine
-
Ein Dienst, der eine verteilte Verarbeitungs-Engine für komplexe analytische Arbeitslasten bereitstellt, z. B. für umfangreiche, grenzenlose Datenzusammenführungen und -transformationen. Um die Recheneffizienz zu maximieren, verwendet Managed Service for Apache Spark die Lightning Engine, um die umfangreichen Multi-Way-Joins, komplexen Fensterfunktionen und Verhaltensaggregationen zu verarbeiten, die für die Kombination der grenzenlosen Datenquellen erforderlich sind.
Managed Service for Apache Spark verwendet die Lightning Engine, um den verteilten Join auszuführen, indem Daten aus den folgenden Pfaden aufgenommen werden:
- Parquet-Dateien aus Amazon S3.
- Cloud Storage-Ereignisprotokolle.
- Live-Transaktionsdaten aus AlloyDB for PostgreSQL über BigQuery-Verbindungen.
- Externe Datenquellen
-
Die Unternehmensdaten-Assets, die sich in anderen Cloud-Umgebungen befinden. In der in diesem Dokument beschriebenen Architektur sind die externen Datenquellen die folgenden:
- Databricks Unity Catalog: Ein externer Katalog, der Metadaten für Apache Iceberg-Tabellen im offenen Format verwaltet.
- Amazon S3: Ein externer Objektspeicherdienst, der die Rohdatendateien für die Iceberg-Tabellen im Apache Parquet-Format speichert.
Durch die Verbindung zu externen Datenquellen können Sie Daten direkt analysieren und müssen keine kostspielige und zeitaufwendige Datenmigration durchführen. In dieser Beispielarchitektur werden zwar Databricks Unity Catalog und Amazon S3-Buckets verwendet, Sie können dieses Architekturmuster aber auch mit anderen externen Iceberg-Katalogdiensten und Cloud-Speicheranbietern verwenden.
- AlloyDB
- Eine leistungsstarke Datenbank für die hybride transaktionsorientierte und analytische Verarbeitung (HTAP), z. B. für die Verwaltung von Echtzeitinventar oder Live-Kundenprofilen. Mit der BigQuery-AlloyDB-Föderation können Analyse-Engines eine Abfrage von BigQuery direkt an die in AlloyDB gespeicherten Live-Transaktionsdaten senden. So lassen sich die Latenz und der Aufwand vermeiden, die mit Change Data Capture-Pipelines (CDC) verbunden sind.
- Cloud Storage
- Ein skalierbarer Objektspeicherdienst für Daten mit hohem Durchsatz, z. B. Clickstream-Ereignisse. Damit die Daten von verschiedenen Verarbeitungs-Engines abgerufen werden können, verwenden Sie Cloud Storage, um die Daten von bestimmten Computing-Diensten zu entkoppeln und im offenen Apache Iceberg-Format wie Apache Parquet zu speichern.
- Grenzenloses Lakehouse
-
Das zentrale Metadaten- und Governance-System, das eine einheitliche, grenzenlose Föderation ermöglicht. Um eine Verbindung zu den Lakehouse-Metadaten herzustellen, führt Lakehouse die folgenden Aktionen aus:
- Stellen Sie eine Verbindung zu Databricks Unity Catalog her, um die Schema- und Routinginformationen für grenzenlose Daten aufzulösen.
- Senden Sie eine Anfrage an Secret Manager, um die Anmeldedaten zu prüfen:
- Wenn die Anmeldedaten genehmigt werden, wird eine direkte Verbindung zu den Lakehouse-Metadaten hergestellt.
- Wenn die Anmeldedaten abgelehnt werden, wird eine Fehlermeldung zurückgegeben und der Vorgang abgebrochen.
- Cloud NAT und Cloud Router
- Verwaltete Dienste, mit denen Ressourcen im Netzwerk von Google Cloudsicher auf die Daten aus externen Cloud-Quellen zugreifen können, ohne diese Ressourcen dem öffentlichen Internet zugänglich zu machen.
- Virtual Private Cloud (VPC)
- Ein Dienst, der ein privates, sicheres und isoliertes Netzwerk für alle Google Cloud -Ressourcen bereitstellt, die im Rahmen dieser Architektur bereitgestellt werden.
- Secret Manager
- Ein Dienst, der die Anmeldedaten des Databricks-Diensthauptkontos, z. B. Client-ID und Secret, für die grenzenlose Authentifizierung sicher speichert.
Subsystem für die Bereitstellung
Das Bereitstellungssubsystem enthält die folgenden Komponenten:
- Einheitliches Kundenprofil
- Eine BigQuery-Datenbank, in der die Ausgabe verteilter Spark-Jobs konsolidiert wird. Die BigQuery-Tabelle wandelt fragmentierte, grenzenlose Messwerte in komplexe denormalisierte Datentypen um und dient als zentraler, verwalteter Datenspeicher für Analysen.
- BigQuery-Daten-Agent
- Ein konversationeller Analyse-Agent, mit dem Nutzer Daten direkt in BigQuery abfragen und Unternehmensstatistiken generieren können. Der Agent setzt Sicherheits- und Governance-Schutzmaßnahmen für die Abfragen durch.
- BigQuery-MCP-Server
- Ein von Google verwalteter MCP-Server (Model Context Protocol), der Zugriff auf BigQuery-Daten bietet. Der BigQuery-MCP-Server stellt den verwalteten Lakehouse-Kontext lokalen oder externen KI-Modellen wie der Gemini CLI sicher zur Verfügung. Sie ermöglicht End-to-End-Agenten-Workflows, ohne dass KI-Entwickler benutzerdefinierte REST API-Middleware erstellen und verwalten müssen.
- Gemini CLI
- Ein KI-Assistent für die Befehlszeile, mit dem Nutzer mit dem einheitlichen Kundenprofil interagieren können, um personalisierte, datengestützte Inhalte wie personalisierte Marketingkampagnen zu generieren. Die Gemini-Befehlszeile fungiert als Client für den BigQuery-MCP-Server, um auf die Daten zuzugreifen, die im einheitlichen Kundenprofil gespeichert sind.
Verwendete Produkte
In dieser Beispielarchitektur werden die folgenden Produkte und Tools von Google Cloud verwendet:
- Lakehouse: Eine leistungsstarke Speicher-Engine, mit der Sie Open-Data-Lakehouses erstellen können und die eine einheitliche Schnittstelle für erweiterte Analysen und KI bietet.
- BigQuery: Ein Data Warehouse für Unternehmen, mit dem Sie Ihre Daten mit integrierten Features wie raumbezogenen Analysen für maschinelles Lernen und Business Intelligence verwalten und analysieren können.
- AlloyDB for PostgreSQL: Ein vollständig verwalteter, PostgreSQL-kompatibler Datenbankdienst, der für Ihre anspruchsvollsten Arbeitslasten entwickelt wurde, einschließlich hybrider transaktionsorientierter und analytischer Verarbeitung.
- Managed Service for Apache Spark: Ein verwalteter Dienst, der Apache Spark-Batcharbeitslasten auf einer verwalteten Compute-Infrastruktur ausführt.
- Cloud Storage: Ein kostengünstiger, unbegrenzter Objektspeicher für verschiedene Datentypen. Auf Daten kann von innerhalb und außerhalb von Google Cloudzugegriffen werden. Sie werden zu Redundanzzwecken über Standorte hinweg repliziert.
- Gemini: Eine Familie von multimodalen KI-Modellen, die von Google entwickelt wurden.
- Google Cloud-MCP-Server: Von Google verwaltete Remote-Dienste, die das Model Context Protocol (MCP) implementieren, um KI-Anwendungen Zugriff auf Produkte und Dienste von Google und Google Cloud zu gewähren.
- Cloud NAT: Ein Dienst, der eine von Google Cloudverwaltete, leistungsstarke Netzwerkadressübersetzung bietet.
- Cloud Router: Ein verteiltes und vollständig verwaltetes Angebot, das Border Gateway Protocol (BGP)-Speaker- und Responder-Funktionen bietet. Cloud Router arbeitet mit Cloud Interconnect, Cloud VPN und Router-Appliances zusammen, um dynamische Routen in VPC-Netzwerken basierend auf über BGP empfangenen und benutzerdefinierten gelernten Routen zu erstellen.
- Virtual Private Cloud (VPC): Ein virtuelles System, das globale, skalierbare Netzwerkfunktionen für Ihre Google Cloud -Arbeitslasten bietet. VPC umfasst VPC-Netzwerk-Peering, Private Service Connect, Zugriff auf private Dienste und freigegebene VPC.
In dieser Beispielarchitektur werden die folgenden Drittanbieterprodukte verwendet:
- Databricks Unity Catalog: Ein einheitlicher Governance- und Metadatenkatalog für Daten- und KI-Assets auf der Databricks-Plattform.
- Amazon S3: Ein Speicherdienst von Amazon Web Services (AWS), der Daten als Objekte speichert und verwaltet.
Anwendungsfälle
Diese Referenzarchitektur ist für Organisationen gedacht, die isolierte Daten aus mehreren Cloud-Umgebungen und lokalen Systemen zusammenführen müssen, um Analyse- und KI-Initiativen voranzutreiben. Diese Architektur bietet folgende Vorteile:
- Ein grenzenloses, einheitliches Profil: Eine einzige, ganzheitliche Ansicht von Geschäftseinheiten, die Analysten und Entscheidungsträgern umfassende Einblicke ermöglicht. Diese einheitliche Ansicht verbessert die Genauigkeit von Analysen und sorgt dafür, dass die Daten unabhängig von ihrem Speicherort konsistent und aktuell sind.
- Geringere operative Komplexität und niedrigere Gesamtbetriebskosten (TCO): Mit Lakehouse müssen Sie keine fehleranfälligen Datenpipelines erstellen und verwalten. Mit diesem Ansatz können Sie Daten direkt dort abfragen, wo sie sich befinden, und zwar über verschiedene Clouds hinweg. So werden der Betriebsaufwand, die Speicherkosten und die Latenz vermieden, die mit der physischen Datenverschiebung verbunden sind.
- Agentische KI-Workflows: KI-Agenten ermöglichen es Datenanalysten, komplexe Verhaltensaggregationen direkt in umsetzbare Geschäftsstrategien zu übersetzen. Mit KI-Agenten können Analysten über Standardprotokolle sicher auf die strukturierten, verwalteten Lakehouse-Daten zugreifen.
Im Folgenden finden Sie Beispiele für Anwendungsfälle für die in diesem Dokument beschriebene Architektur:
- Einzelhandelsanalysen in Echtzeit: Ein Einzelhandelsunternehmen muss sofortige Entscheidungen auf der Grundlage von Verkäufen und Inventar treffen. Mit dieser Architektur können sie ihre statischen Produktkatalogdaten, die in AWS verwaltet werden, mit Live-Verkaufstransaktionsdaten aus ihrer operativen AlloyDB-Datenbank in Google Cloudkombinieren. Analysten und Filialleiter können diese einheitliche Ansicht in vordefinierten Batchintervallen abfragen, um die Leistung eines Verkaufs zu überwachen, schnell verkaufte Artikel für die Nachbestellung zu identifizieren oder regionale Kaufmuster zu analysieren, sobald sie auftreten.
- Kundenpersonalisierung: Ein Finanzdienstleistungsunternehmen möchte seinen Kundenbetreuern einen vollständigen und einheitlichen Überblick über ihre Kunden bieten. Das Unternehmen kann diese Architektur verwenden, um historische Marketing-Interaktionsdaten aus einem Data Lake in AWS mit Live-Kundenkontoinformationen aus AlloyDB zu vereinheitlichen. Ein Relationship Manager kann dann den KI-Assistenten verwenden, um Fragen zu stellen, z. B. „Fasse die letzten drei Transaktionen für diesen Kunden zusammen und entwirf eine personalisierte E-Mail, in der ein neues Sparkonto mit hoher Rendite vorgeschlagen wird.“
Designaspekte
In diesem Abschnitt werden Designfaktoren, Best Practices und Empfehlungen beschrieben, die Sie berücksichtigen sollten, wenn Sie diese Referenzarchitektur verwenden, um eine Topologie zu entwickeln, die Ihren spezifischen Anforderungen an Sicherheit und Kosten entspricht.
Die Anleitung in diesem Abschnitt ist nicht vollständig. Weitere Informationen zu Designfaktoren und Best Practices sowie Empfehlungen zum Erstellen und Bereitstellen eines Multi-Agenten-KI-Systems finden Sie unter Multi-Agenten-KI-System in Google Cloud.
Sicherheit, Datenschutz und Compliance
Um das Prinzip der geringsten Berechtigung durchzusetzen, sollten Sie den Zugriff über systemverwaltete Identitäten verwalten. Beachten Sie die folgenden Empfehlungen:
- Verwenden Sie den Identity and Access Management (IAM)-Dienst von Google, um Berechtigungen für Google Cloud -Ressourcen zu erstellen und zu verwalten.
- Verwenden Sie BigQuery-Cloud-Ressourcenverbindungen, um sicher auf Rohdaten in Cloud Storage zuzugreifen.
- Verwenden Sie die Lakehouse-Katalogföderation mit Secret Manager, um cloudübergreifende Databricks-Verbindungen sicher zu authentifizieren.
Sicherheit und Governance von KI-Agenten
Um die besonderen Sicherheitsrisiken von KI-Agenten zu minimieren, empfiehlt Google einen Ansatz, der deterministische Sicherheitskontrollen mit dynamischen, logikbasierten Abwehrmechanismen kombiniert:
- Menschliche Kontrolle: Integrieren Sie einen Human-in-the-Loop-Ablauf in geschäftskritische Systeme, damit menschliche Prüfer die Ausgaben überprüfen und die Aktionen des KI-Agenten genehmigen, überschreiben oder pausieren können.
- Agent Identity: Weisen Sie jedem KI-Agenten eine arbeitslastgebundene Identität zu, um die Zugriffssteuerung nach dem Prinzip der geringsten Berechtigung durchzusetzen und Anmeldedaten für externe Tools zentral zu verwalten.
- Agent Gateway: Erzwingen Sie die Governance für eingehenden und ausgehenden Traffic, Standardzugriffsrichtlinien zum Ablehnen und die Inline-Prüfung von Prompts und Tools mit Model Armor.
- Agent Registry: Prüfen Sie, ob Agenten nur eine Verbindung zu genehmigten Subagenten und MCP-Tools herstellen.
Kosten- und Leistungsoptimierung
Damit Ihre Agent-Konfigurationen Ihren Kosten- und Leistungsanforderungen entsprechen, sollten Sie die folgenden Empfehlungen beachten:
- Computing-Auswahl: Wählen Sie zur Optimierung von Leistung und Kosten einen Computing-Dienst aus, der für jeden Teil Ihrer Arbeitslast am besten geeignet ist. Ein modernes Data Lakehouse ist nicht auf einen monolithischen Computing-Dienst angewiesen. Wenn Sie Filter für genaue Übereinstimmungen auf operative Datenbanken anwenden möchten, verwenden Sie föderierte Abfragen in BigQuery. Wenn Sie speicherintensive und komplexe Datenmanipulationen wie vektorisierte grenzenlose Joins auslagern möchten, verwenden Sie Managed Service for Apache Spark mit Lightning Engine.
- KI-Modellfundierung: Um Halluzinationen von KI-Modellen zu minimieren, fundieren Sie Ihr Modell auf dem einheitlichen Kundenprofil, um Geschäftsdefinitionen und statistische Validierung zu erzwingen. Wenn Sie das KI-Modell mit unaggregierten, grenzenlosen Rohdaten mit Milliarden von Zeilen füttern, kann dies zu einem übermäßigen Tokenverbrauch und hohen Halluzinationsraten führen.
- Netzwerktopologie und Strategie für ausgehenden Traffic: Um eine zuverlässige Leistung zu gewährleisten und die Kosten für die Datenübertragung über grenzenlose Netzwerke zu minimieren, verwenden Sie Cross-Cloud Interconnect, um eine private Verbindung zwischen Google Cloud und AWS herzustellen. Andernfalls können bei Datenabfragen über das öffentliche Internet von Google Cloud zu AWS hohe Gebühren für ausgehenden Traffic und unvorhersehbare Latenzen anfallen.
Bereitstellung
Informationen zum Bereitstellen dieser Architektur finden Sie im Codelab Grenzenloses offenes Data Lakehouse erstellen. Mit dieser Beispielimplementierung können Sie die spezifische Netzwerkinfrastruktur bereitstellen, C++-PySpark-Workflows ausführen und KI-Agenten für die sichere Interaktion mit Ihrem Lakehouse konfigurieren.
Nächste Schritte
- Lakehouse-Laufzeitkatalog mit Tabellen in BigQuery verwenden
- Spark mit Lightning Engine beschleunigen
- Weitere Informationen zum Analysieren von Daten mit Chats
- Eine Übersicht über Architekturprinzipien und Empfehlungen, die speziell für KI- und ML-Arbeitslasten in Google Cloudgelten, finden Sie im Well-Architected Framework unter KI- und ML-Perspektive.
- Weitere Referenzarchitekturen, Diagramme und Best Practices finden Sie im Cloud-Architekturcenter.
Beitragende
Autor: Hyunuk Lim | Developer Advocate
Weitere Beitragende:
- Brad Miro | Senior Developer Advocate
- Samantha He | Technical Writer