


Este documento fornece uma arquitetura de alto nível para um sistema de IA multiagente bidirecional em tempo real, em Google Cloud. O sistema ajuda os usuários a concluir tarefas técnicas, como montar componentes complexos, diagnosticar mau funcionamento de equipamentos ou navegar por procedimentos de reparo complexos. O sistema de IA agêntica fornece orientação técnica fundamentada e monitoramento de segurança automatizado por meio de um fluxo contínuo e bidirecional de dados multimodais.
O público-alvo deste documento inclui arquitetos, desenvolvedores e administradores que criam e gerenciam infraestrutura e aplicativos de IA na nuvem. Este documento pressupõe que você tenha uma compreensão básica de agentes e modelos de IA. O documento não fornece orientações específicas para projetar e codificar agentes de IA.
A seção de implantação deste documento lista exemplos de código que podem ser usados para aprender a criar e implantar sistemas de IA multiagente.
Arquitetura
O diagrama a seguir mostra uma visão geral de uma arquitetura que usa um sistema de IA multiagente para ativar o streaming de dados multimodais bidirecional em tempo real:
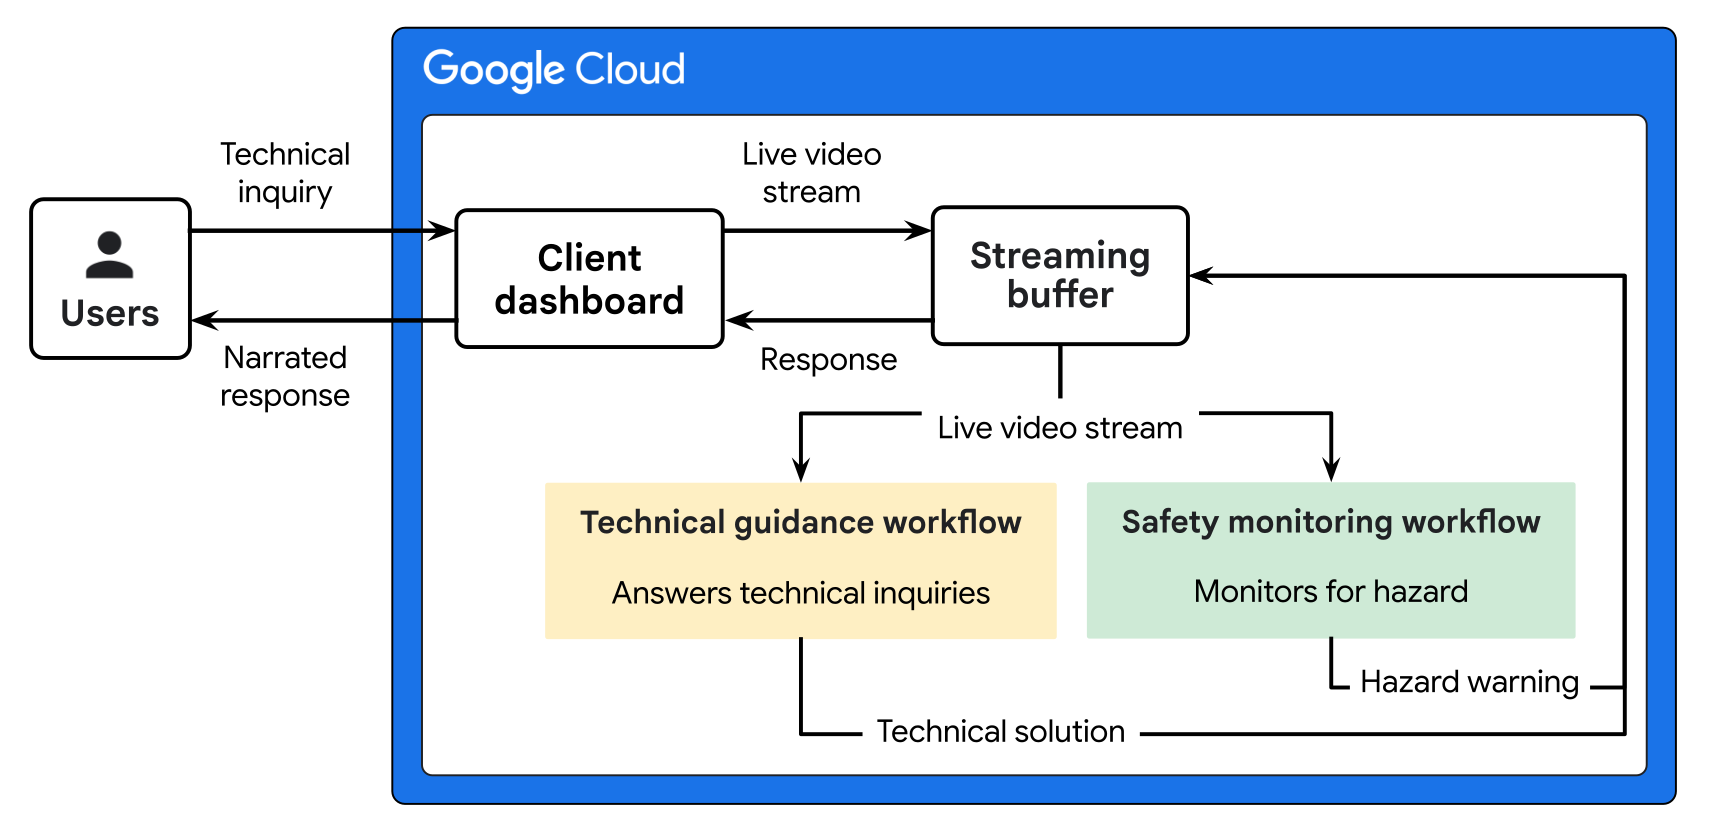
A arquitetura no diagrama anterior tem dois fluxos de trabalho: orientação técnica e monitoramento de segurança.
- O fluxo de trabalho de orientação técnica permite que os usuários recebam soluções narradas em tempo real para consultas técnicas complexas. Esse fluxo de trabalho usa o modelo Gemini Live para processar fluxos multimodais e coordenar com um subagente para recuperar informações fundamentadas do produto no banco de dados de conhecimento.
- O fluxo de trabalho de monitoramento de segurança fornece detecção automatizada de perigos para garantir a segurança do usuário durante procedimentos técnicos. Esse fluxo de trabalho usa Gemini para analisar segmentos de vídeo ao vivo , identificar possíveis riscos e acionar avisos imediatos pelo painel do cliente.
As guias a seguir fornecem diagramas de arquitetura que mostram os fluxos de trabalho de orientação técnica e monitoramento de segurança:
Fluxo de trabalho de orientação técnica
O diagrama a seguir mostra uma arquitetura detalhada para um fluxo de trabalho de orientação técnica.
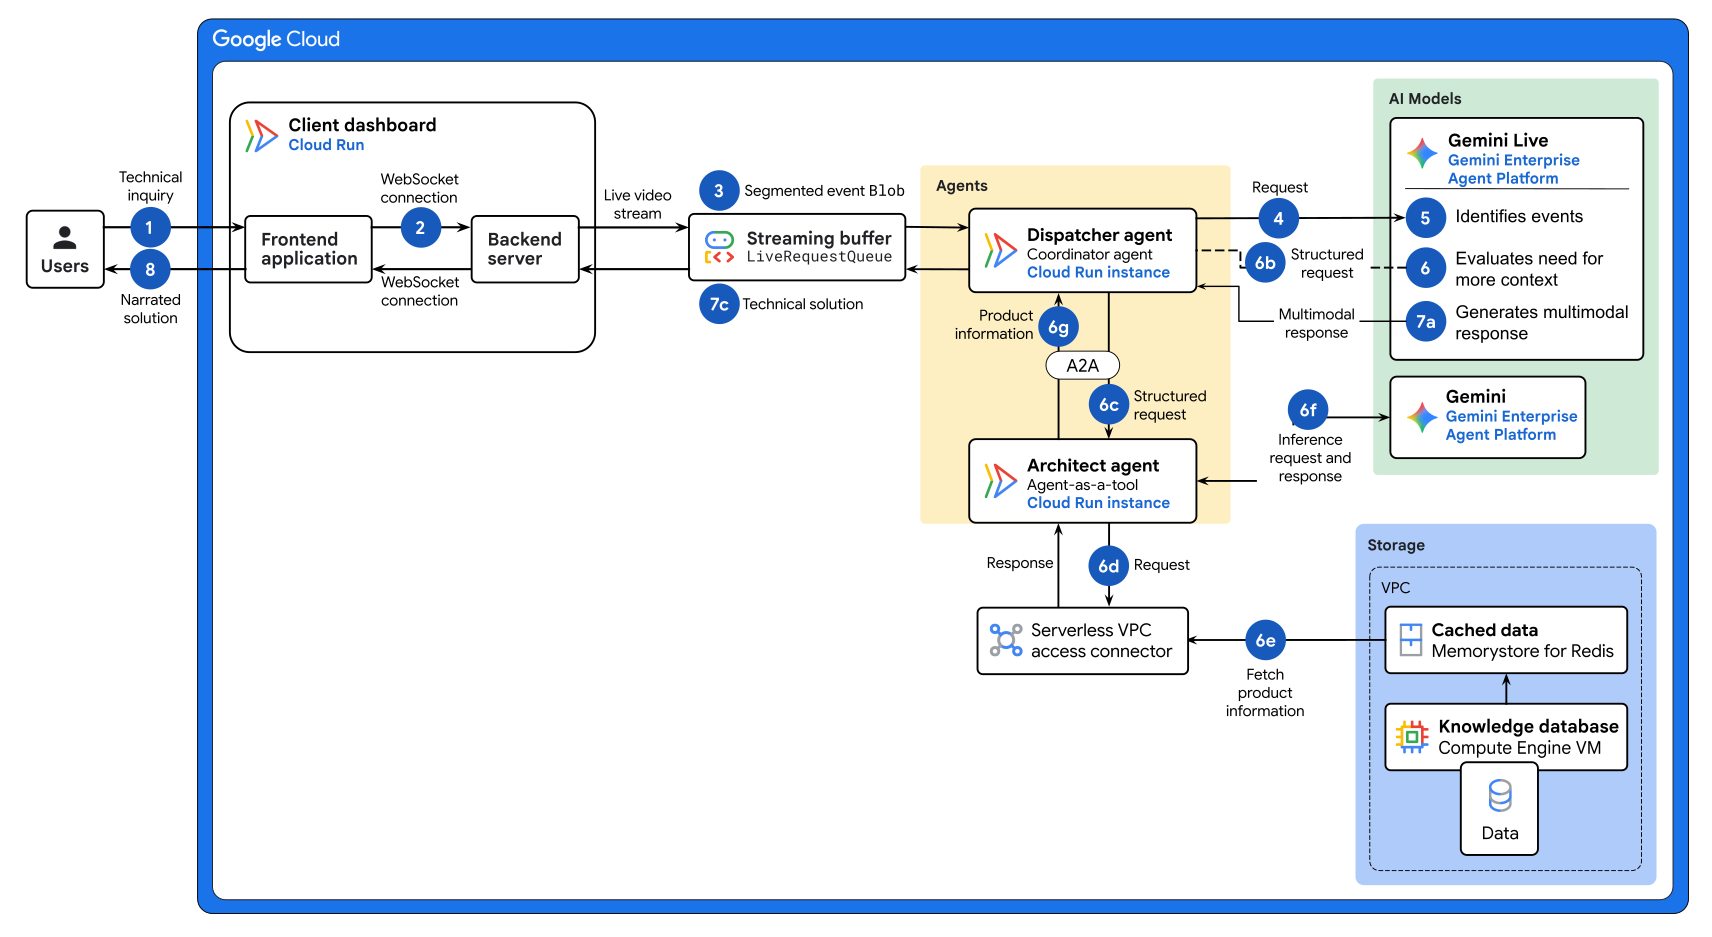
O diagrama anterior mostra o seguinte fluxo de dados:
-
Um usuário inicia uma sessão fazendo uma consulta técnica falada pelo painel do cliente. Por exemplo, um técnico pode apontar a câmera para um painel de controle e perguntar: "Ajuda, o que significa essa luz vermelha piscando?"
-
O painel do cliente estabelece uma conexão WebSocket persistente entre o front-end e o servidor de back-end.
-
As mensagens WebSocket empacotam os dados multimídia brutos em objetos
Blob. O componente do Kit de Desenvolvimento de Agente (ADK)LiveRequestQueuetransmite continuamente os dados de entrada para o agente de dispatcher. -
O agente de dispatcher detecta comandos de áudio ou visuais que exigem orientação técnica e envia o fluxo de entrada para o modelo Gemini Live.
-
O modelo Gemini Live pesquisa os dados brutos para identificar eventos. Os eventos são palavras-chave de áudio, como "montar" ou "ajuda", ou pistas visuais, como gestos com as mãos.
O Gemini avalia cada evento para determinar se ele é relevante para a consulta do usuário. Por exemplo, um gesto com a mão ou palavras de preenchimento podem não ser relevantes. Portanto, o Gemini não processa esses eventos.
-
Para cada evento relevante, o Gemini ativa a chamada de função para avaliar se ele precisa de mais contexto. Dependendo se o contexto adicional é necessário, o Gemini ou um agente de arquiteto envia uma resposta de volta ao agente de dispatcher.
-
Se precisar de mais contexto, o Gemini vai procurar o card do agente de arquiteto agent card para entender como estruturar a solicitação.
-
O Gemini envia uma solicitação estruturada para o agente de dispatcher. A solicitação contém detalhes do evento, como tipo de produto, número do modelo, tipo de evento e atributos.
-
O agente de dispatcher usa o protocolo Agent2Agent (A2A) para enviar a solicitação estruturada ao agente de arquiteto.
-
O agente de arquiteto envia a consulta por um conector de acesso VPC sem servidor . O conector permite que o agente acesse com segurança os recursos na rede de nuvem privada virtual (VPC, na sigla em inglês) usada para os recursos de armazenamento nessa arquitetura.
-
O conector de acesso VPC sem servidor interage com os dados armazenados em cache no Memorystore for Redis Cluster. Se os dados não estiverem disponíveis na camada armazenada em cache, o agente de arquiteto vai interagir com as instâncias do Compute Engine que hospedam o banco de dados de conhecimento.
-
O agente de arquiteto recebe as informações do produto do cache de dados ou do banco de dados de conhecimento. O agente de arquiteto envia as informações do produto para o Gemini gerar uma resposta. Por exemplo, "Código de erro 3B: mau funcionamento do ventilador. Ação recomendada: verifique se há obstruções".
O agente de arquiteto envia as informações do produto de volta ao agente de dispatcher.
Se não precisar de mais contexto, o Gemini vai gerar uma resposta diretamente para a solicitação do usuário.
-
-
O agente de dispatcher recebe a resposta do Gemini ou do agente de arquitetura e gera uma resposta multimodal:
-
Usa o modelo Gemini Live e a
run_livefunção do ADK para gerar uma resposta multimodal que contém a solução técnica. -
Armazena a resposta como um objeto
Blob. -
Envia a solução técnica pelo buffer de streaming e pela conexão WebSocket persistente para entregar a solução técnica ao painel do cliente.
-
-
O painel do cliente extrai os dados
Blobda solução técnica para fornecer orientação narrada imediata e atualiza a UI com transcrições relevantes. O loop de solicitação é concluído enquanto o fluxo bidirecional ativo é mantido.
Fluxo de trabalho de monitoramento de segurança
O diagrama a seguir mostra uma arquitetura detalhada para um fluxo de trabalho de monitoramento de segurança.
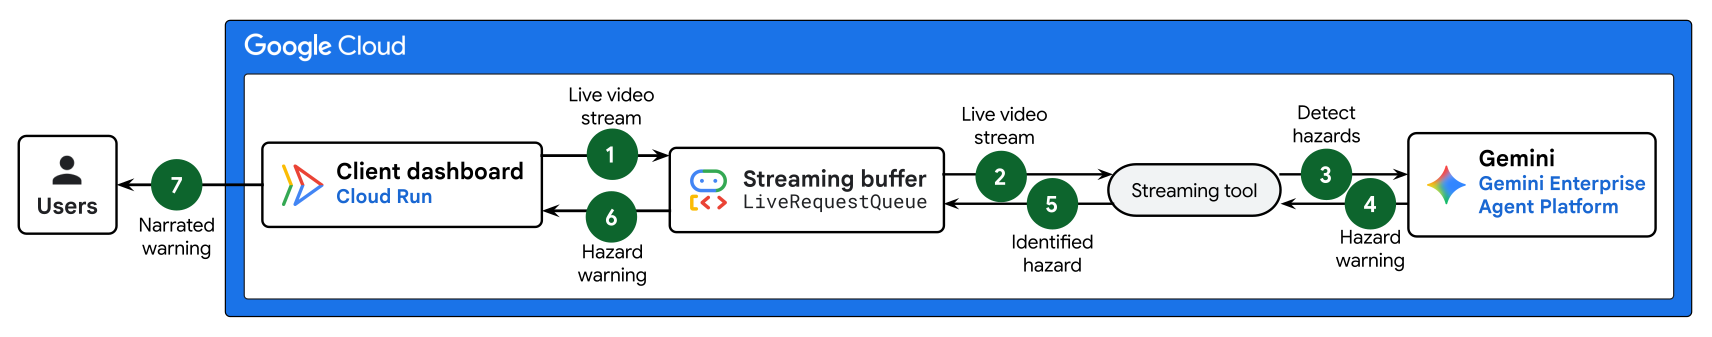
O diagrama anterior mostra o seguinte fluxo de dados:
- O painel do cliente estabelece uma conexão
WebSocket persistente
entre o front-end e o servidor de back-end para observar o fluxo de vídeo
ao vivo. A mensagem WebSocket empacota esses dados multimídia brutos em
Blobobjetos e os envia continuamente para o buffer de streaming, usando o componenteLiveRequestQueuedo ADK. - O buffer de streaming direciona o fluxo de entrada para uma ferramenta de streaming que é executada em um loop de segundo plano contínuo para detectar perigos no frame de vídeo.
- A ferramenta de streaming envia o frame de vídeo mais recente do buffer de streaming para o Gemini.
- O Gemini observa os frames de vídeo
em busca de perigos, como uma luz brilhante ou vapor.
- Se nenhum perigo for detectado, nada vai acontecer.
- Se um perigo for detectado,
Gemini vai gerar uma
resposta multimodal contendo o tipo de perigo, os atributos e o
local, e vai armazená-lo como um objeto
Blob. O Gemini envia a resposta de aviso de perigo de volta para a ferramenta de streaming.
- A ferramenta de streaming encaminha a resposta de aviso de perigo para o buffer de streaming.
- O buffer de streaming usa a conexão WebSocket persistente para entregar a solução técnica ao painel do cliente.
- O painel do cliente extrai os dados
Blobda solução técnica para fornecer orientação narrada imediata e atualiza a UI com transcrições relevantes. Isso conclui o loop de solicitação, mantendo o fluxo bidirecional ativo.
Produtos usados
Esta arquitetura de referência usa os seguintes Google Cloud produtos e ferramentas:
- Cloud Run: uma plataforma de computação sem servidor que permite executar contêineres diretamente na infraestrutura escalonável do Google.
- Gemini: uma família de modelos de IA multimodais desenvolvida pelo Google.
- Gemini Enterprise Agent Platform: uma plataforma abrangente que permite criar, escalonar, governar e otimizar agentes de IA de nível empresarial.
- Kit de Desenvolvimento de Agente (ADK): um conjunto de ferramentas e bibliotecas para desenvolver, testar e implantar agentes de IA.
- Protocolo Agent2Agent (A2A): um protocolo aberto que permite a comunicação e a interoperabilidade entre agentes, independentemente da linguagem de programação e do ambiente de execução.
- Acesso VPC sem servidor: um serviço que permite que seus ambientes sem servidor se conectem a recursos em uma rede de nuvem privada virtual.
- Nuvem privada virtual (VPC): um sistema virtual que oferece funcionalidade de rede global e escalonável para suas cargas de trabalho. Google Cloud A VPC inclui peering de rede VPC, Private Service Connect, acesso a serviços particulares e VPC compartilhada.
- Memorystore for Redis Cluster: um serviço de repositório de dados na memória totalmente gerenciado para o Redis.
- Compute Engine: um serviço de computação seguro e personalizável que permite criar e executar VMs na infraestrutura do Google.
Para informações sobre como selecionar componentes alternativos para seu sistema de IA agêntica incluindo framework, ambiente de execução do agente, ferramentas, memória e padrões de design, consulte Escolher os componentes da arquitetura de IA agêntica.
Caso de uso
Essa arquitetura de referência foi projetada para casos de uso que exigem a síntese em tempo real de fluxos de dados multimodais contínuos e bidirecionais. A seguir, apresentamos exemplos de casos de uso para a arquitetura descrita neste documento:
- Manufatura industrial e manutenção de campo: permita o reparo sem usar as mãos de máquinas complexas, fornecendo aos técnicos um assistente de IA que processa áudio e vídeo ao vivo de óculos inteligentes. O técnico conversa com o assistente de IA para buscar esquemas de máquinas. O assistente de IA usa um agente de banco de dados interno que acessa a documentação do produto para garantir instruções de reparo e montagem fundamentadas. Uma ferramenta de visão de segundo plano simultânea monitora o fluxo bidirecional para alertar proativamente o técnico sobre perigos mecânicos ou etapas de montagem incorretas.
- Suporte técnico remoto: melhore os resultados da solução de problemas do cliente, permitindo que os usuários compartilhem um feed de câmera de smartphone ao vivo com um sistema de IA agêntica multimodal. A arquitetura de streaming bidirecional oferece suporte a uma conversa dinâmica em que o sistema observa o hardware em tempo real. Se um processo de visão de segundo plano identificar uma conexão com falha, como um cabo na porta errada, o sistema vai usar o fluxo de baixa latência para interromper imediatamente o usuário com orientação corretiva.
Considerações sobre o design
As seções a seguir fornecem recomendações gerais para projetar os agentes de IA e implementar essa arquitetura para produção.
Design do agente de IA
Para melhorar o custo e o desempenho dos seus agentes, considere as seguintes recomendações:
- Scripts de loop de controle: escreva comandos do sistema para agentes bidirecionais ao vivo como loops de comportamento de máquina de estado estritos, em vez de apenas diretrizes de personalidade. O comando do sistema precisa instruir explicitamente o agente a ficar em silêncio até ser acionado. Ele precisa aplicar respostas breves e orientadas por ações para que a interação por voz seja concisa e natural.
- Separação de preocupações: use uma ferramenta de streaming de segundo plano dedicada para monitorar feeds de vídeo independentemente do agente principal. O agente raiz na arquitetura é bidirecional e pode interromper instantaneamente a própria fala para transmitir esses avisos de segurança críticos ao usuário. Além disso, se você pedir a um único agente para monitorar constantemente um feed de vídeo, isso poderá levar à sobrecarga cognitiva e alucinações.
- Comandos econômicos: o comprimento dos comandos (entrada) e das respostas geradas (saída) afeta diretamente o desempenho e o custo. Escreva comandos curtos, diretos e que forneçam contexto suficiente. Projete seus comandos para receber respostas concisas do modelo. Por exemplo, inclua frases como "resumir em duas frases" ou "listar três pontos principais". Para mais informações, consulte as práticas recomendadas para o design de comandos.
Design Production
Para implementar essa arquitetura para produção, considere as seguintes recomendações:
- Segurança de entrada: para controlar o acesso ao aplicativo,
desative o
run.appURL padrão do serviço Cloud Run de front-end e configure um balanceador de carga de aplicativo externo regional. Além de balancear o tráfego de entrada para o aplicativo, o balanceador de carga processa o gerenciamento de certificados SSL. Para maior proteção, você pode usar as políticas de segurança do Google Cloud Armor para fornecer filtragem de solicitações, proteção contra DDoS e limitação de taxa para o serviço. - Controle de acesso: ao configurar permissões para os recursos na sua topologia, siga o princípio de privilégio mínimo.
- Buffer assíncrono: para separar pacotes de áudio e vídeo recebidos do mecanismo de inferência do modelo, use um buffer assíncrono thread-safe FIFO (First-In-First-Out). Esse buffer atua como um multiplexador que garante que o sistema permaneça responsivo a interrupções do usuário sem congelar a interface durante a computação pesada.
- Custos de ingestão de dados: para reduzir os custos de token e evitar o esgotamento da janela de contexto, use uma amostragem de frame de baixa frequência, como dois frames por segundo , e compacte todos os dados em arquivos JPEG Base64.
- Armazenamento em cache na memória: para alcançar velocidades de leitura de submilisegundos, use um banco de dados do cluster do Memorystore para Redis na memória para o cofre esquemático do agente de arquiteto. Essa implementação minimiza a latência, evita silêncios durante interações de voz em tempo real e fornece uma única fonte de verdade escalonável.
- Segurança do WebSocket: proteja dados multimodais sensíveis, como impressões de voz e vídeo, aplicando a criptografia TLS para todas as conexões WebSocket bidirecionais.
- Comunicação A2A segura:
- Use cards de agente estendidos autenticados para proteger a comunicação A2A.
- Anexe tokens de identidade do OpenID Connect (OIDC) às solicitações. Os tokens de identidade do OIDC permitem usar o gerenciamento de identidade e acesso (IAM) para validar que apenas agentes autorizados acessem os dados.
- Alocação de recursos: dependendo dos requisitos de desempenho, configure os limites de memória e os limites de CPU a serem alocados ao serviço do Cloud Run.
Para mais informações sobre fatores de design, práticas recomendadas e recomendações para criar e implantar um sistema de IA multiagente, consulte Sistema de IA multiagente em Google Cloud.
Implantação
Para implantar uma implementação de exemplo dessa arquitetura, tente os seguintes codelabs:
- Codelab de criação de um agente de streaming bidirecional do ADK: crie um sistema de IA de agente único que processa um stream de vídeo ao vivo para reconhecer gestos específicos do usuário.
- Codelab do sistema multiagente bidirecional ao vivo: crie um sistema de IA multiagente que usa streaming bidirecional para interação de voz e vídeo em tempo real. O sistema inclui uma ferramenta de streaming proativa para monitoramento contínuo de segurança.
A seguir
- Aprenda a iniciar e gerenciar sessões ao vivo.
- Confira a introdução ao kit de ferramentas da API Gemini Live do ADK.
- Aprenda a hospedar agentes de IA no Cloud Run.
- Saiba como escolher os componentes da arquitetura de IA agêntica.
- Confira os recursos de aprendizado para criar e implantar agentes de nível empresarial com o Gemini Enterprise Agent Ready (GEAR).
- Descoberta avançada guias de arquitetura de IA agêntica.
- Para uma visão geral dos princípios e recomendações arquitetônicas específicos para cargas de trabalho de IA e ML em Google Cloud, consulte a perspectiva de IA e ML no Well-Architected Framework.
- Para mais arquiteturas de referência, diagramas e práticas recomendadas, confira a Central de arquitetura do Cloud.
Colaboradores
Autores:
- Christina Lin | Gerente de engenharia de relações com desenvolvedores
- Samantha He | Redatora técnica
Outros colaboradores:
- Kumar Dhanagopal | Desenvolvedor de soluções para vários produtos
- Olivier Bourgeois | Engenheiro de relações com desenvolvedores