


במסמך הזה מתוארת הארכיטקטורה הכוללת של מערכת למידת מכונה (ML) באמצעות ספריות TensorFlow Extended (TFX). בנוסף, מוסבר איך להגדיר אינטגרציה רציפה (CI), פיתוח רציף (CD) ואימון רציף (CT) למערכת ה-ML באמצעות Cloud Build ו-Gemini Enterprise Agent Platform Pipelines.
במסמך הזה, המונחים מערכת ML ופייפליין ML מתייחסים לפייפליינים של אימון מודלים של ML, ולא לפייפליינים של ניקוד או חיזוי של מודלים.
המסמך הזה מיועד למדעני נתונים ולמהנדסי למידת מכונה שרוצים להתאים את שיטות ה-CI/CD שלהם כדי להעביר פתרונות ML לסביבת הייצור ב- Google Cloud, ורוצים להבטיח את האיכות, יכולת התחזוקה וההתאמה של פייפליינים ללמידת מכונה.
כאן מוסבר על הנושאים הבאים:
- הסבר על CI/CD ואוטומציה ב-ML.
- תכנון פייפליין משולב של ML באמצעות TFX.
- תזמור ואוטומציה של פייפליין ML באמצעות Agent Platform Pipelines.
- הגדרת מערכת CI/CD לפייפליין של ML באמצעות Cloud Build.
MLOps
כדי לשלב מערכת ML בסביבת ייצור, צריך לתזמר את השלבים בפייפליין של ML. בנוסף, צריך להפוך את ההפעלה של צינור עיבוד הנתונים לאוטומטית כדי לאמן את המודלים באופן רציף. כדי להתנסות ברעיונות ובתכונות חדשים, צריך לאמץ שיטות CI/CD בהטמעות החדשות של צינורות עיבוד הנתונים. בקטעים הבאים מופיעה סקירה כללית ברמה גבוהה של CI/CD ו-CT ב-ML.
אוטומציה של פייפליין ML
במקרים מסוימים, התהליך הידני של אימון, אימות ופריסה של מודלים של למידת מכונה יכול להספיק. הגישה הידנית הזו מתאימה אם הצוות שלכם מנהל רק כמה מודלים של למידת מכונה שלא עוברים אימון מחדש או לא משתנים לעיתים קרובות. אבל בפועל, מודלים רבים נכשלים כשהם נפרסים בעולם האמיתי, כי הם לא מצליחים להסתגל לשינויים בדינמיקה של הסביבות או בנתונים שמתארים את הדינמיקה הזו.
כדי שמערכת ה-ML תסתגל לשינויים כאלה, צריך להשתמש בשיטות הבאות של MLOps:
- להפוך את ההרצה של פייפליין ה-ML לאוטומטית, כדי לאמן מחדש מודלים חדשים על נתונים חדשים ולזהות דפוסים חדשים. הנושא של CT מופיע בהמשך המסמך, בקטע ML באמצעות Agent Platform Pipelines.
- הגדירו מערכת פיתוח רציף (continuous delivery) כדי לפרוס לעיתים קרובות הטמעות חדשות של כל פייפליין ה-ML. בהמשך המאמר, בקטע הגדרת CI/CD ל-ML ב- Google Cloud, נדון ב-CI/CD.
אתם יכולים להפוך את פייפליינים של ML בסביבת הייצור לאוטומטיים, כדי לאמן מחדש את המודלים באמצעות נתונים חדשים. אפשר להפעיל את צינור עיבוד הנתונים לפי דרישה, לפי לוח זמנים, לפי הזמינות של נתונים חדשים, לפי ירידה בביצועי המודל, לפי שינויים משמעותיים במאפיינים הסטטיסטיים של הנתונים או לפי תנאים אחרים.
השוואה בין צינור עיבוד נתונים של CI/CD לבין צינור עיבוד נתונים של CT
אחד מהטריגרים לאימון מחדש של מודל ML הוא הזמינות של נתונים חדשים. הזמינות של הטמעה חדשה של פייפליין ה-ML (כולל ארכיטקטורת מודל חדשה, הנדסת פיצ'רים והיפר-פרמטרים) היא טריגר חשוב נוסף להפעלה מחדש של פייפליין ה-ML. ההטמעה החדשה של פייפליין ה-ML משמשת כגרסה חדשה של שירות החיזוי של המודל, למשל, מיקרו-שירות עם API בארכיטקטורת REST למילוי בקשות באופן מיידי. ההבדל בין שני המקרים:
- כדי לאמן מודל ML חדש עם נתונים חדשים, מפעילים את צינור ה-CT שנפרס קודם לכן. לא פורסים צינורות עיבוד נתונים או רכיבים חדשים, אלא רק שירות חיזוי חדש או מודל שאומן מחדש בסוף צינור עיבוד הנתונים.
- כדי לאמן מודל ML חדש עם הטמעה חדשה, פורסים פייפליין חדש באמצעות פייפליין של CI/CD.
כדי לפרוס במהירות פייפליינים חדשים של ML, צריך להגדיר פייפליין של CI/CD. הפייפליין הזה אחראי לפריסה אוטומטית של פייפליינים ורכיבים חדשים של ML, כשיש הטמעות חדשות שזמינות ומאושרות לסביבות שונות (כמו פיתוח, בדיקה, Staging, טרום-ייצור וייצור).
בתרשים הבא מוצג הקשר בין צינור עיבוד הנתונים של CI/CD לבין צינור עיבוד הנתונים של ML CT.
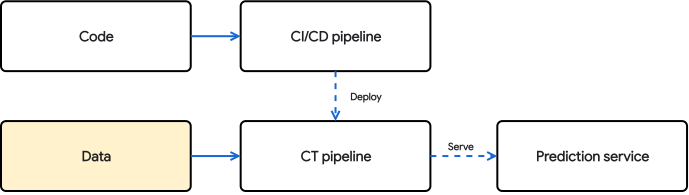
איור 1. צינורות עיבוד נתונים של CI/CD ו-ML CT.
הפלט של הצינורות האלה הוא:
- אם מוגדרת הטמעה חדשה, פייפליין תקין של CI/CD פורס פייפליין חדש של CT ל-ML.
- אם מספקים נתונים חדשים, צינור עיבוד נתונים מוצלח של CT מאמן מודל חדש ופורס אותו כשירות חיזוי.
תכנון מערכת למידת מכונה שמבוססת על TFX
בקטעים הבאים נסביר איך לתכנן מערכת ML משולבת באמצעות TensorFlow Extended (TFX) כדי להגדיר צינור עיבוד נתונים של CI/CD למערכת ה-ML. יש כמה מסגרות לפיתוח מודלים של ML, אבל TFX היא פלטפורמת ML משולבת לפיתוח ולפריסה של מערכות ML בסביבת ייצור. פייפליין של TFX הוא רצף של רכיבים שמטמיעים מערכת ML. צינור עיבוד הנתונים הזה של TFX מיועד למשימות למידת מכונה (ML) שניתנות להתאמה לעומס (scalable) ובעלות ביצועים גבוהים. המשימות האלה כוללות בניית מודלים, אימון, אימות, הצגת הסקות וניהול פריסות. אלה הספריות העיקריות של TFX:
- TensorFlow Data Validation (TFDV): משמש לזיהוי חריגות בנתונים.
- TensorFlow Transform (TFT): משמש לעיבוד מראש של נתונים ולהנדסת פיצ'רים.
- TensorFlow Estimators ו-Keras: משמשים לבנייה ולאימון של מודלים ל-ML.
- TensorFlow Model Analysis (TFMA): משמש להערכה ולניתוח של מודלים של למידת מכונה.
- TensorFlow Serving (TFServing): משמש להכניס לשימוש בסביבת הייצור מודלים של ML כממשקי API ל-REST ול-gRPC.
סקירה כללית על מערכת TFX ML
בתרשים הבא מוצג איך הספריות השונות של TFX משולבות כדי ליצור מערכת למידת מכונה.
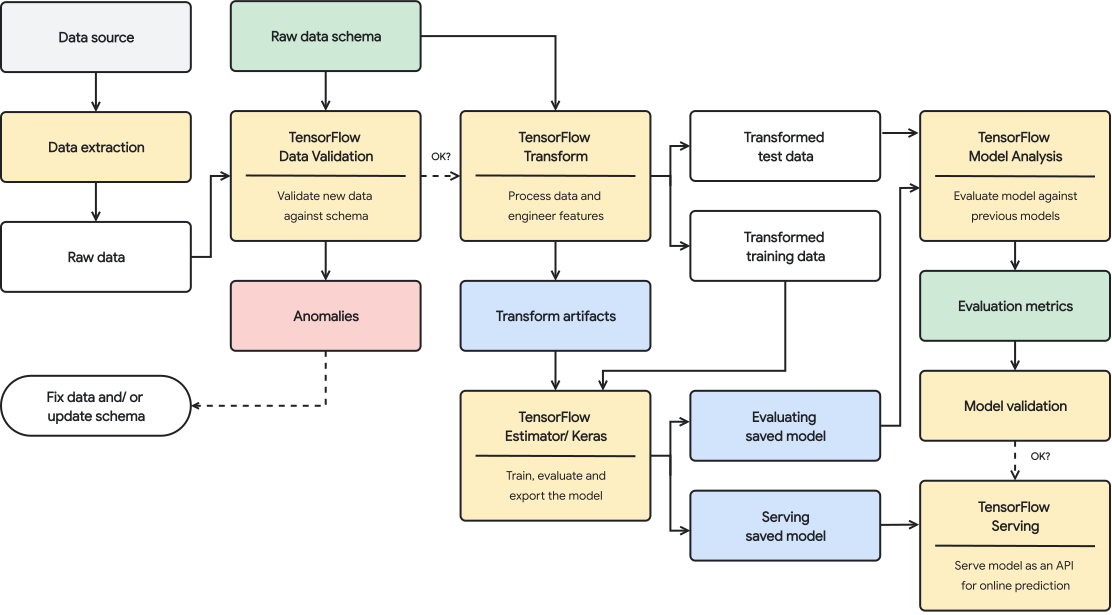
איור 2. מערכת ML טיפוסית שמבוססת על TFX.
באיור 2 מוצגת מערכת ML טיפוסית שמבוססת על TFX. את השלבים הבאים אפשר לבצע באופן ידני או באמצעות צינור עיבוד נתונים אוטומטי:
- חילוץ נתונים: השלב הראשון הוא לחלץ את נתוני האימון החדשים ממקורות הנתונים שלהם. התוצרים של השלב הזה הם קובצי נתונים שמשמשים לאימון המודל ולהערכה שלו.
- אימות נתונים: TFDV מאמת את הנתונים מול סכימת הנתונים (הגולמיים) הצפויה. סכימת הנתונים נוצרת ומתוקנת בשלב הפיתוח, לפני פריסת המערכת. שלבי אימות הנתונים מזהים חריגות שקשורות גם להפצת הנתונים וגם להטיות בסכימה. הפלט של השלב הזה הוא החריגות (אם יש כאלה) והחלטה אם לבצע את השלבים הבאים או לא.
- טרנספורמציית נתונים: אחרי שמאמתים את הנתונים, הם מפוצלים ומוכנים למשימת למידת המכונה על ידי ביצוע טרנספורמציות נתונים ופעולות הנדסת מאפיינים באמצעות TFT. הפלט של השלב הזה הוא קובצי נתונים לאימון ולהערכה של המודל, בדרך כלל בפורמט
TFRecords. בנוסף, פריטי המידע שנוצרים בתהליך הטרנספורמציה עוזרים לבנות את הקלט של המודל ולהטמיע את תהליך הטרנספורמציה במודל השמור שיוצא אחרי האימון. - אימון וכוונון של המודל: כדי להטמיע ולאמן את מודל ה-ML, משתמשים ב-API של
tf.Kerasעם הנתונים שעברו טרנספורמציה בשלב הקודם. כדי לבחור את הגדרות הפרמטרים שיובילו למודל הטוב ביותר, אתם יכולים להשתמש ב-Keras tuner, ספריית כוונון היפר-פרמטרים ל-Keras. לחלופין, אתם יכולים להשתמש בשירותים אחרים כמו Katib, Vertex AI Vizier או בכלי לכוונון היפר-פרמטרים מ-Gemini Enterprise Agent Platform. הפלט של השלב הזה הוא מודל שמור שמשמש להערכה, ומודל שמור נוסף שמשמש למילוי בקשות אונליין של המודל לחיזוי. - הערכה ואימות של המודל: כשמייצאים את המודל אחרי שלב האימון, הוא מוערך בקבוצת נתונים לבדיקה כדי להעריך את איכות המודל באמצעות TFMA. TFMA מעריך את איכות המודל בכללותו, ומזהה איזה חלק במודל הנתונים לא פועל. ההערכה הזו עוזרת להבטיח שהמודל יקודם להצגה רק אם הוא עומד בקריטריונים של האיכות. הקריטריונים יכולים לכלול ביצועים הוגנים בקבוצות משנה שונות של נתונים (לדוגמה, דמוגרפיה ומיקומים) וביצועים משופרים בהשוואה למודלים קודמים או למודל להשוואה. הפלט של השלב הזה הוא קבוצה של מדדי ביצועים והחלטה אם לקדם את המודל לסביבת הייצור.
- פרסום המודל לחיזוי: אחרי שהמודל החדש שאומן מאומת, הוא נפרס כמיקרו-שירות (microservice) כדי להציג חיזויים אונליין באמצעות TensorFlow Serving. הפלט של השלב הזה הוא שירות חיזוי פרוס של מודל ה-ML שאומן. במקום השלב הזה, אתם יכולים לאחסן את המודל שאומן במרשם המודלים. לאחר מכן, מופעל תהליך CI/CD נפרד של פרסום המודל.
במדריך הרשמי של רכיב TFX Keras מוסבר איך משתמשים בספריות TFX.
מערכת למידת המכונה של TFX ב- Google Cloud
בסביבת ייצור, הרכיבים של המערכת צריכים לפעול בקנה מידה נרחב בפלטפורמה אמינה. בתרשים הבא מוצג איך כל שלב בצינור עיבוד הנתונים של TFX ML פועל באמצעות שירות מנוהל ב- Google Cloud, שמבטיח גמישות, אמינות וביצועים בקנה מידה גדול.
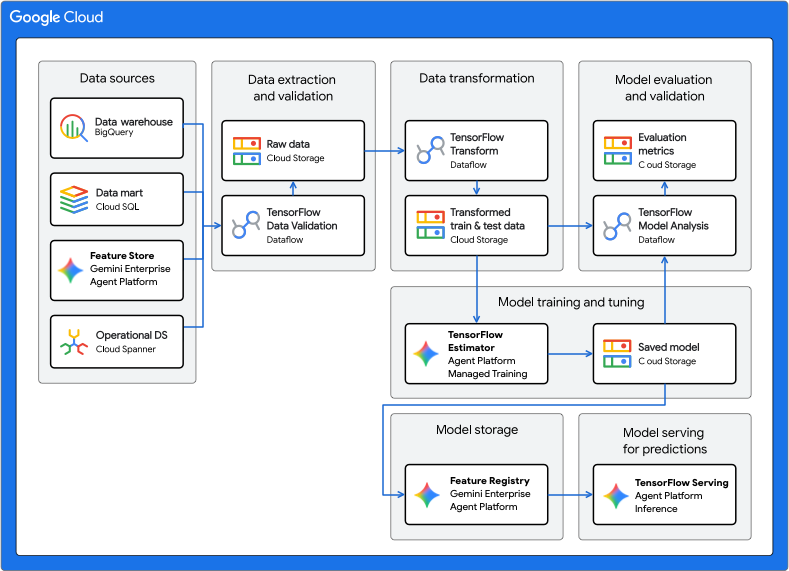
איור 3. מערכת למידת מכונה מבוססת-TFX ב- Google Cloud.
בטבלה הבאה מתוארים שירותי המפתח שלGoogle Cloud שמוצגים באיור 3:
| שלב | ספריית TFX | שירותGoogle Cloud |
|---|---|---|
| חילוץ ואימות נתונים | TensorFlow Data Validation | Dataflow |
| טרנספורמציית נתונים | TensorFlow Transform | Dataflow |
| אימון וכוונון של מודלים | TensorFlow | הדרכה מנוהלת על פלטפורמת הסוכנים של Gemini Enterprise |
| הערכה ואימות של המודל | TensorFlow Model Analysis | Dataflow |
| פרסום המודל לחיזויים | TensorFlow Serving | הסקה בפלטפורמת הסוכנים של Gemini Enterprise |
| אחסון מודלים | לא רלוונטי | מרשם המודלים ב-Gemini Enterprise Agent Platform |
- Dataflow הוא שירות מנוהל, אמין ובלי שרת (serverless) להרצת צינורות עיבוד נתונים של Apache Beam בקנה מידה רחב ב- Google Cloud. Dataflow משמש להרחבת התהליכים הבאים:
- המערכת מחשבת את הנתונים הסטטיסטיים כדי לאמת את הנתונים הנכנסים.
- הכנה וטרנספורמציה של נתונים.
- הערכת המודל על קבוצת נתונים גדולה.
- חישוב מדדים בהיבטים שונים של מערך הנתונים להערכה.
- Cloud Storage הוא שירות אחסון עמיד וזמין מאוד לאובייקטים בינאריים גדולים (BLOB).
ב-Cloud Storage מתארחים פריטי מידע שנוצרו במהלך ההפעלה של צינור עיבוד הנתונים של למידת המכונה, כולל:
- חריגות בנתונים (אם יש)
- נתונים ופריטי מידע שעברו טרנספורמציה
- מודל מיוצא (מאומן)
- מדדים להערכת מודלים
- Gemini Enterprise Agent Platform Managed Training הוא שירות מנוהל לאימון מודלים של למידת מכונה (ML) בקנה מידה נרחב. אתם יכולים להריץ משימות לאימון מודלים באמצעות קונטיינרים מובְנים ל-TensorFlow, ל-Scikit learn, ל-XGBoost ול-PyTorch. אתם יכולים גם להריץ כל מסגרת באמצעות קונטיינרים בהתאמה אישית. בתשתית האימון אפשר להשתמש במאיצים ובכמה צמתים לאימון מבוזר. בנוסף, יש שירות מבוסס-אופטימיזציה בייסיאנית שניתן להתאמה לעומס, לכוונון של היפר-פרמטר.
- Gemini Enterprise Agent Platform Inference הוא שירות מנוהל שמאפשר להריץ הסקות באצווה באמצעות המודלים שאומנו, והסקות אונליין על ידי פריסת המודלים כמיקרו-שירות (microservice) עם API בארכיטקטורת REST. השירות משתלב גם עם Vertex AI ניתן להסברה ועם מעקב אחרי מודלים ב-Gemini Enterprise Agent Platform, כדי להבין את המודלים ולקבל התראות כשיש הטיה ושינוי במאפיינים או בשיוך המאפיינים.
- מרשם המודלים ב-Gemini Enterprise Agent Platform מאפשר לכם לנהל את מחזור החיים של מודלי ה-ML. אתם יכולים ליצור גרסאות של המודלים המיובאים ולראות את מדדי הביצועים שלהם. אחרי שהמודל מוכן, אפשר להשתמש בו לחיזויים באצווה או לפרוס אותו למילוי בקשות באופן מיידי באמצעות Gemini Enterprise Agent Platform Inference.
תזמור מערכת ML באמצעות Agent Platform Pipelines
במאמר הזה הסברנו איך לתכנן מערכת למידת מכונה שמבוססת על TFX, ואיך להריץ כל רכיב של המערכת בקנה מידה נרחב ב- Google Cloud. עם זאת, צריך כלי תזמור כדי לחבר את הרכיבים השונים של המערכת. התזמור מריץ את צינור עיבוד הנתונים ברצף, ועובר אוטומטית משלב אחד לשלב הבא על סמך התנאים שהוגדרו. לדוגמה, תנאי מוגדר יכול להיות הפעלת שלב פרסום המודל אחרי שלב הערכת המודל, אם מדדי ההערכה עומדים בסף שהוגדר מראש. אפשר גם להריץ שלבים במקביל כדי לחסוך זמן, למשל לאמת את תשתית הפריסה ולהעריך את המודל. תזמור פייפליין ML שימושי גם בשלב הפיתוח וגם בשלב הייצור:
- בשלב הפיתוח, התזמור עוזר למדעני הנתונים להריץ את הניסוי של למידת המכונה, במקום לבצע כל שלב באופן ידני.
- בשלב הייצור, התזמור עוזר להפוך את ההפעלה של פייפליין ML לאוטומטית, על סמך תזמון או תנאים מסוימים להפעלה.
ML עם Agent Platform Pipelines
Agent Platform Pipelines הוא שירות מנוהל של Google Cloud שמאפשר לתזמר ולהפעיל באופן אוטומטי פייפליינים של ML, שבהם כל רכיב של הפייפליין יכול לפעול בקונטיינר ב-Google Cloud או בפלטפורמות ענן אחרות. הפרמטרים והפריטים שנוצרים בצינור עיבוד הנתונים נשמרים באופן אוטומטי ב-Vertex ML Metadata, וכך אפשר לעקוב אחרי השושלת וההפעלה. שירות Agent Platform Pipelines כולל את הרכיבים הבאים:
- ממשק משתמש לניהול ולמעקב אחרי ניסויים, משימות והרצות.
- מנוע לתזמון תהליכי עבודה של ML עם כמה שלבים.
- Python SDK להגדרה ולניהול של צינורות עיבוד נתונים ורכיבים.
- שילוב עם Vertex ML Metadata כדי לשמור מידע על הפעלות, מודלים, מערכי נתונים ופריטי מידע נוספים שנוצרו בתהליך הפיתוח (artifacts).
הפעולות הבאות נחשבות לצינור עיבוד נתונים שמופעל ב-Agent Platform Pipelines:
- קבוצה של משימות למידת מכונה בקונטיינרים, או רכיבים. רכיב צינור עיבוד נתונים הוא קוד עצמאי שנארז כקובץ אימג' של Docker. רכיב מבצע שלב אחד בצינור עיבוד הנתונים. הוא מקבל ארגומנטים של קלט ומפיק פריטי מידע שנוצרו בתהליך הפיתוח (Artifacts).
- מפרט של רצף משימות למידת המכונה, שמוגדר באמצעות שפה ספציפית לדומיין (DSL) של Python. הטופולוגיה של תהליך העבודה מוגדרת באופן משתמע על ידי חיבור הפלט של שלב קודם לקלט של שלב עוקב. שלב בהגדרה של צינור עיבוד הנתונים מפעיל רכיב בצינור עיבוד הנתונים. בצינור עיבוד נתונים מורכב, רכיבים יכולים לפעול כמה פעמים בלולאות או לפעול באופן מותנה.
- קבוצה של פרמטרים לקלט של צינור עיבוד הנתונים, שהערכים שלהם מועברים לרכיבים של צינור עיבוד הנתונים, כולל הקריטריונים לסינון הנתונים והמיקום שבו יאוחסנו פריטי המידע שנוצרו על ידי צינור עיבוד הנתונים.
בתרשים הבא מוצג גרף לדוגמה של צינורות עיבוד נתונים ב-Agent Platform.
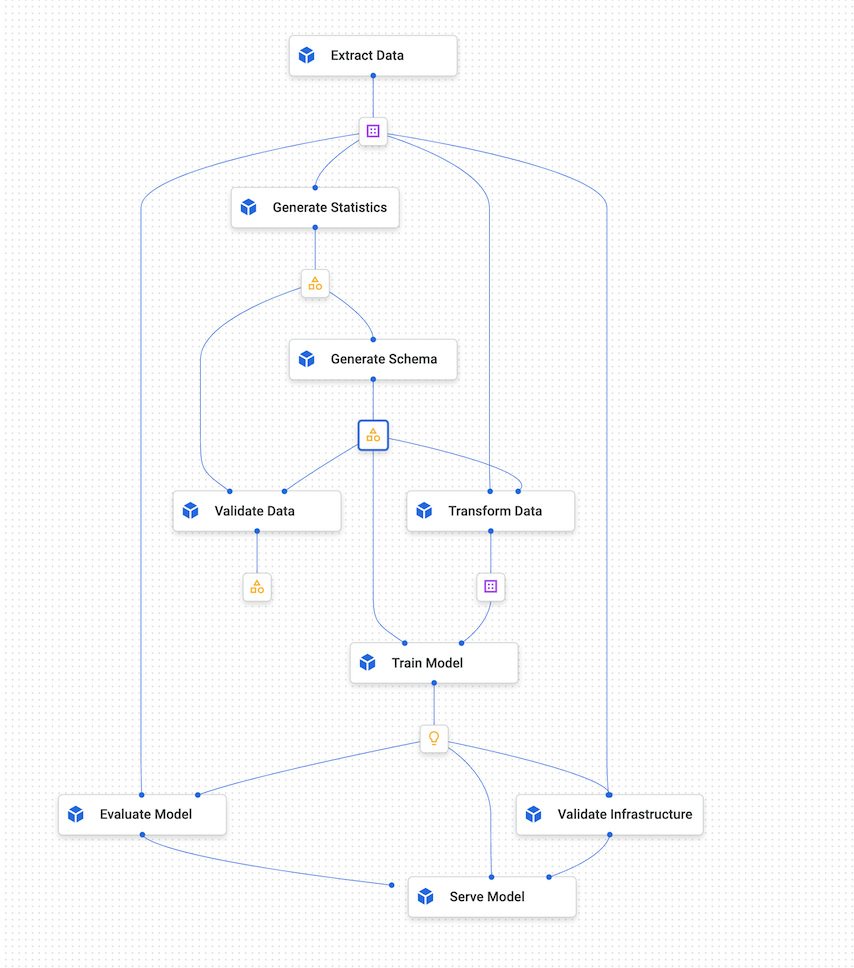
איור 4. תרשים לדוגמה של צינורות עיבוד נתונים ב-Agent Platform.
Kubeflow Pipelines SDK
Kubeflow Pipelines SDK מאפשר ליצור רכיבים, להגדיר את התזמור שלהם ולהריץ אותם כצינור עיבוד נתונים. למידע נוסף על רכיבי Kubeflow Pipelines, קראו את המאמר יצירת רכיבים במסמכי התיעוד של Kubeflow.
אפשר גם להשתמש ב-TFX Pipeline DSL וברכיבי TFX. רכיב TFX כולל יכולות של מטא-נתונים. הדרייבר מספק מטא-נתונים ל-executor באמצעות שליחת שאילתה למאגר המטא-נתונים. בעל האפליקציה מאשר את תוצאות ה-executor ושומר אותן במטא-נתונים. אתם יכולים גם להטמיע רכיב בהתאמה אישית, שיש לו את אותו שילוב עם המטא-נתונים. במאמר בניית צינור עיבוד נתונים מוסבר איך מגדירים צינור עיבוד נתונים של TFX ב-Agent Platform Pipelines.
בתרשים הבא מוצג איך ב-Agent Platform Pipelines, משימה בקונטיינר יכולה להפעיל שירותים אחרים כמו משימות BigQuery, משימות אימון של Agent Platform (מבוזרות) ומשימות Dataflow.
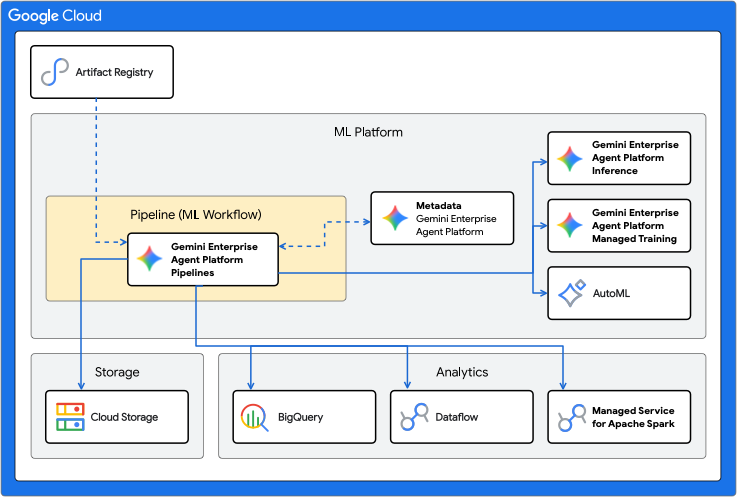
איור 5. Agent Platform Pipelines שמפעילים שירותים מנוהלים שלGoogle Cloud .
בעזרת Agent Platform Pipelines אתם יכולים לתזמר ולהפוך לאוטומטי צינור עיבוד נתונים של למידת מכונה בסביבת הייצור, על ידי הפעלת שירותי Google Cloud הנדרשים. באיור 5, Vertex ML Metadata משמש כמאגר המטא-נתונים של למידת המכונה בשביל Agent Platform Pipelines.
רכיבי צינור עיבוד הנתונים לא מוגבלים להפעלת שירותים שקשורים ל-TFX ב-Google Cloud. הרכיבים האלה יכולים להריץ כל שירות שקשור לנתונים ולמחשוב, כולל Managed Service for Apache Spark למשימות SparkML, AutoML ועומסי עבודה אחרים של מחשוב.
אלה היתרונות של הפיכת משימות לקונטיינרים ב-Agent Platform Pipelines:
- הפרדה בין סביבת ההרצה לבין סביבת זמן הריצה של הקוד.
- מאפשרת לשחזר את הקוד בין סביבת הפיתוח לסביבת הייצור, כי הדברים שאתם בודקים זהים בסביבת הייצור.
- מבודד כל רכיב בצינור עיבוד הנתונים. לכל רכיב יכולה להיות גרסה משלו של סביבת זמן הריצה, שפות שונות וספריות שונות.
- עוזר ליצור צינורות עיבוד נתונים מורכבים.
- שילוב עם Vertex ML Metadata לצורך מעקב ושחזור של הרצות ופריטי מידע שנוצרו בתהליך (artifacts) של צינורות עיבוד נתונים.
כדי לקבל מבוא מקיף ל-Agent Platform Pipelines, עיינו ברשימה של דוגמאות ל-Notebooks.
הפעלה ותזמון של צינורות עיבוד נתונים ב-Agent Platform
כשפורסים פייפליין בסביבת הייצור, צריך להפוך את ההרצות שלו לאוטומטיות, בהתאם לתרחישים שמתוארים בקטע אוטומציה של פייפליין של ML.
Agent Platform SDK מאפשר להפעיל את צינור עיבוד הנתונים באופן פרוגרמטי. הכיתה google.cloud.aiplatform.PipelineJob כוללת ממשקי API ליצירת ניסויים, ולפריסה והרצה של צינורות עיבוד נתונים. לכן, באמצעות ה-SDK אתם יכולים להפעיל את Agent Platform Pipelines משירות אחר כדי להשיג טריגרים שמבוססים על מתזמן או על אירועים.
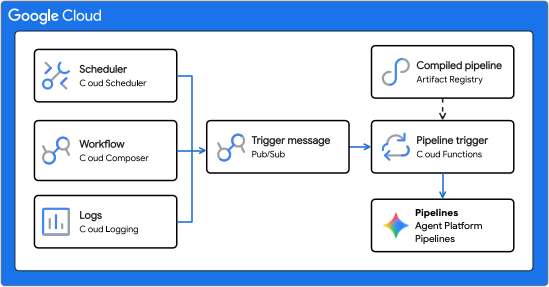
איור 6. תרשים זרימה שמדגים כמה טריגרים ל-Agent Platform Pipelines באמצעות Pub/Sub ופונקציות Cloud Run.
באיור 6 אפשר לראות דוגמה להפעלה של שירות Agent Platform Pipelines כדי להריץ צינור עיבוד נתונים. הצינור מופעל באמצעות Agent Platform SDK מפונקציית Cloud Run. פונקציית Cloud Run עצמה היא מנוי ל-Pub/Sub, והיא מופעלת על סמך הודעות חדשות. כל שירות שרוצה להפעיל את צינור עיבוד הנתונים יכול לפרסם בנושא Pub/Sub המתאים. בדוגמה שלמעלה יש שלושה שירותי פרסום:
- Cloud Scheduler מפרסם הודעות לפי לוח זמנים, וכך מפעיל את צינור עיבוד הנתונים.
- Managed Service for Apache Airflow מפרסם הודעות כחלק מתהליך עבודה גדול יותר, כמו תהליך הטמעת נתונים שמפעיל את צינור עיבוד הנתונים לאימון אחרי ש-BigQuery מטמיע נתונים חדשים.
- Cloud Logging מפרסם הודעה על סמך יומנים שעומדים בקריטריונים מסוימים של סינון. אתם יכולים להגדיר את המסננים כך שיזהו הגעה של נתונים חדשים, או אפילו התראות על הטיה ושינוי שנוצרו על ידי השירות Model Monitoring ב-Gemini Enterprise Agent Platform.
הגדרת CI/CD ל-ML ב- Google Cloud
בעזרת Agent Platform Pipelines אתם יכולים לתזמר מערכות ML שכוללות כמה שלבים, כולל עיבוד מוקדם של נתונים, אימון והערכה של מודלים ופריסת מודלים. בשלב המחקר של מדעי הנתונים, הצינורות של Agent Platform עוזרים לבצע ניסויים מהירים בכל המערכת. בשלב הייצור, אפשר להשתמש ב-Agent Platform Pipelines כדי להפוך את הפעלת צינור עיבוד הנתונים לאוטומטית על סמך נתונים חדשים, כדי לאמן או לאמן מחדש את מודל ה-ML.
ארכיטקטורת CI/CD
בתרשים הבא מוצגת סקירה כללית ברמה גבוהה של CI/CD ל-ML עם Agent Platform Pipelines.
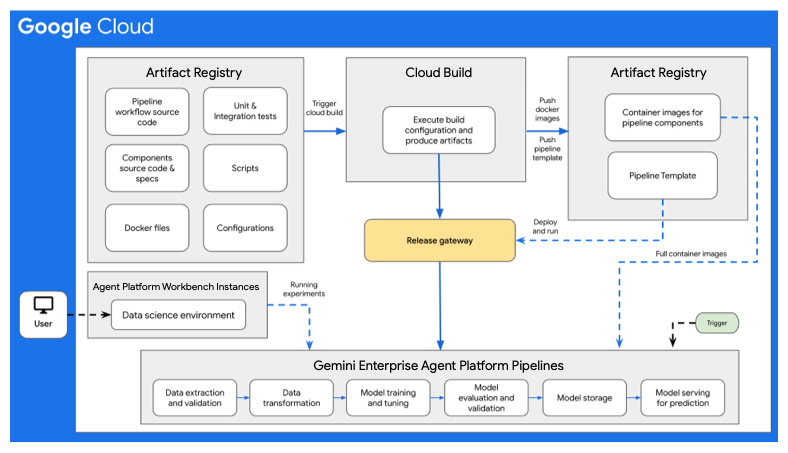
איור 7: סקירה כללית ברמה גבוהה של CI/CD עם צינורות עיבוד נתונים של Agent Platform.
הליבה של הארכיטקטורה הזו היא Cloud Build. בעזרת Cloud Build תוכלו לייבא קוד מקור מ-Artifact Registry, מ-GitHub או מ-Bitbucket, להפעיל גרסאות build במפרטים שלכם וליצור ארטיפקטים – כמו קונטיינרים של Docker או קובצי tar של Python.
Cloud Build מריץ את ה-build כסדרה של שלבי build, שמוגדרים בקובץ תצורה של build (cloudbuild.yaml). כל שלב build פועל בקונטיינר של Docker. אתם יכולים להשתמש בשלבי ה-build הנתמכים ש-Cloud Build מספק, או לכתוב שלבי build משלכם.
תהליך Cloud Build, שמבצע את ה-CI/CD הנדרש למערכת ה-ML, יכול להתבצע ידנית או באמצעות טריגרים אוטומטיים לפיתוח גרסת Build. הטריגרים מפעילים את שלבי ה-build שהגדרתם בכל פעם ששינויים נשלחים למקור ה-build. אפשר להגדיר טריגר לפיתוח גרסת Build כדי להריץ את שגרת הפיתוח כשמבצעים שינויים במאגר המקור, או להריץ את שגרת הפיתוח רק כשהשינויים עומדים בקריטריונים מסוימים.
בנוסף, אתם יכולים להגדיר שגרות build (קובצי תצורה של Cloud Build) שמופעלות בתגובה לטריגרים שונים. לדוגמה, אפשר ליצור שגרות build שמופעלות כשמבצעים commit לענף הפיתוח או לענף הראשי.
אתם יכולים להשתמש בהחלפות של משתני הגדרות כדי להגדיר את משתני הסביבה בזמן ה-build. ההחלפות האלה מתועדות מ-builds שהופעלו. המשתנים האלה כוללים את $COMMIT_SHA, $REPO_NAME, $BRANCH_NAME, $TAG_NAME ו-$REVISION_ID. משתנים אחרים שלא מבוססים על טריגרים הם $PROJECT_ID ו-$BUILD_ID. החלפות הן שימושיות למשתנים שהערך שלהם לא ידוע עד לזמן ה-build, או לשימוש חוזר בבקשת build קיימת עם ערכי משתנים שונים.
תרחיש לדוגמה של תהליך עבודה ב-CI/CD
מאגר המקורות של הקוד כולל בדרך כלל את הפריטים הבאים:
- קוד המקור של תהליך העבודה של צינורות עיבוד הנתונים ב-Python, שבו מוגדר תהליך העבודה של צינור עיבוד הנתונים
- קוד המקור של רכיבי צינור עיבוד הנתונים ב-Python וקובצי המפרט של הרכיבים המתאימים לרכיבים השונים של צינור עיבוד הנתונים, כמו אימות נתונים, טרנספורמציה של נתונים, אימון מודלים, הערכת מודלים ופרסום המודל.
- קובצי Docker שנדרשים כדי ליצור קובצי אימג' של קונטיינרים ב-Docker, אחד לכל רכיב בצינור עיבוד הנתונים.
- בדיקות יחידה ושילוב של Python כדי לבדוק את השיטות שהוטמעו ברכיב ובצינור עיבוד הנתונים הכולל.
- סקריפטים אחרים, כולל הקובץ
cloudbuild.yaml, בודקים טריגרים ופריסות של צינורות עיבוד נתונים. - קובצי תצורה (לדוגמה, הקובץ
settings.yaml), כולל הגדרות לפרמטרים של הקלט בצינור עיבוד הנתונים. - Notebooks שמשמשים לניתוח נתונים, לניתוח מודלים ולניסויים אינטראקטיביים במודלים.
בדוגמה הבאה, שגרת build מופעלת כשמפתח מעביר קוד מקור לסביבת הפיתוח מסביבת מדעי הנתונים שלו.
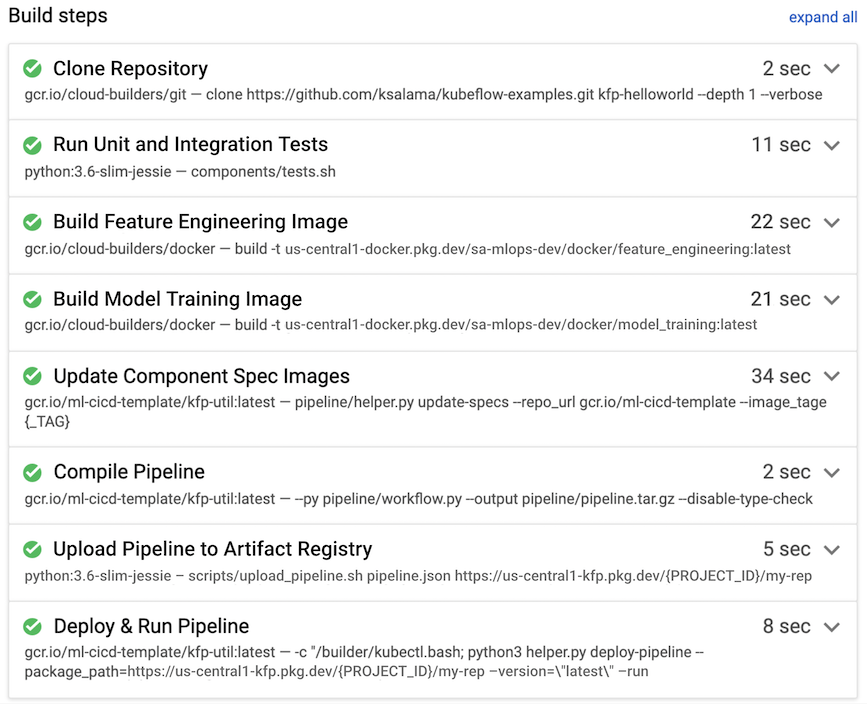
איור 8. דוגמה לשלבי build שמבוצעים על ידי Cloud Build.
בדרך כלל, Cloud Build מבצע את שלבי ה-build הבאים, שמוצגים גם באיור 7:
- מאגר המקורות של הקוד מועתק לסביבת זמן הריצה של Cloud Build, בספרייה
/workspace. - להריץ בדיקות יחידה ובדיקות שילוב.
- אופציונלי: מריצים ניתוח קוד סטטי באמצעות מנתח כמו Pylint.
- אם הבדיקות עוברות, נוצרים קובצי אימג' של קונטיינר Docker, אחד לכל רכיב בצינור עיבוד הנתונים. התמונות מתויגות באמצעות הפרמטר
$COMMIT_SHA. - קובצי האימג' של קונטיינר Docker מועלים ל-Artifact Registry (כפי שמוצג באיור 7).
- כתובת ה-URL של התמונה מתעדכנת בכל אחד מ-
component.yamlהקבצים עם קובצי האימג' של קונטיינר Docker שנוצרו ותויגו. - תהליך העבודה של צינור עיבוד הנתונים עובר הידור כדי ליצור את הקובץ
pipeline.json. - הקובץ
pipeline.jsonמועלה ל-Artifact Registry. - אופציונלי: מריצים את צינור עיבוד הנתונים עם ערכי הפרמטרים כחלק מבדיקת שילוב או מהרצה בסביבת הייצור. צינור עיבוד הנתונים שהופעל יוצר מודל חדש, ויכול גם לפרוס את המודל כ-API ב-Gemini Enterprise Agent Platform Inference.
במאמר דוגמאות מקצה לקצה של Vertex Pipelines ב-GitHub תוכלו לקרוא דוגמה ל-MLOps מקצה לקצה שמוכן לייצור, כולל CI/CD באמצעות Cloud Build.
שיקולים נוספים
כשמגדירים את ארכיטקטורת ה-CI/CD של למידת המכונה ב- Google Cloud, כדאי להביא בחשבון את הדברים הבאים:
- בסביבת מדעי הנתונים, אתם יכולים להשתמש במכונה מקומית או ב-Gemini Enterprise Agent Platform Workbench.
- אתם יכולים להגדיר את צינור עיבוד הנתונים האוטומטי של Cloud Build כך שידלג על טריגרים, למשל אם נערכים רק קובצי תיעוד או אם משתנים קובצי ה-notebook של הניסויים.
- אפשר להריץ את צינור עיבוד הנתונים לבדיקות אינטגרציה ורגרסיה כבדיקת build. לפני שפורסים את הצינור בסביבת היעד, אפשר להשתמש ב-method
wait()כדי להמתין עד שהרצת הצינור שהוגשה תסתיים. - במקום Cloud Build, אתם יכולים להשתמש במערכות build אחרות כמו Jenkins. פריסה מוכנה לשימוש של Jenkins זמינה ב-Google Cloud Marketplace.
- אפשר להגדיר את צינור עיבוד הנתונים כך שיתפרס באופן אוטומטי בסביבות שונות, כולל פיתוח, בדיקה ו-staging, על סמך טריגרים שונים. בנוסף, אתם יכולים לפרוס לסביבות מסוימות באופן ידני, כמו טרום-ייצור או ייצור, בדרך כלל אחרי קבלת אישור לגרסה. אפשר להגדיר כמה שגרות build לטריגרים שונים או לסביבות יעד שונות.
- אתם יכולים להשתמש ב-Apache Airflow, מסגרת פופולרית לתזמור ולתזמון, לתהליכי עבודה למטרות כלליות, שאותם אפשר להריץ באמצעות השירות המנוהל Managed Service for Apache Airflow.
- כשפורסים גרסה חדשה של המודל בסביבת הייצור, כדאי לפרוס אותה כגרסה איטרטיבית לקהל מצומצם (canary release) כדי לקבל מושג לגבי הביצועים שלה (שימוש במעבד, בזיכרון ובדיסק). לפני שמגדירים את המודל החדש לשרת את כל התנועה בזמן אמת, אפשר גם לבצע בדיקת A/B. מגדירים את המודל החדש כך שישרת 10% עד 20% מהתנועה בזמן אמת. אם המודל החדש מניב ביצועים טובים יותר מהמודל הנוכחי, אתם יכולים להגדיר את המודל החדש כך שישרת את כל התנועה. אחרת, מערכת ההצגה חוזרת למודל הנוכחי.
המאמרים הבאים
- מידע נוסף על פיתוח רציף (continuous delivery) בסגנון GitOps באמצעות Cloud Build
- במאמר נקודת המבט של AI ו-ML ב-Well-Architected Framework מפורטים עקרונות והמלצות לארכיטקטורה שספציפיים לעומסי עבודה של AI ו-ML ב- Google Cloud.
- לדוגמאות נוספות של ארכיטקטורות, תרשימים ושיטות מומלצות, עיינו במאמר Cloud Architecture Center.
שותפים ביצירת התוכן
מחברים:
- רוס תומסון | ארכיטקט פתרונות ענן
- חאליד סלאמה | מהנדס תוכנה בכיר, למידת מכונה
משתתף נוסף: Wyatt Gorman | מנהל מוצר יוצא של HPC