


探索查询跟踪器和探索性能面板可提供探索查询的分步性能数据。这些数据有助于确定关键切入点,以便排查和解决查询性能问题,并提供改进建议。
探索查询跟踪器
“探索”查询跟踪器会在查询运行期间显示“探索”查询在查询的三个阶段中的进度。

如果查询执行时间过长,查询跟踪器可以指示查询的哪个阶段导致了性能问题。这有助于确定可能出现性能问题的位置,以及哪些位置的优化工作最有效。
只要探索可视化图表面板或探索数据面板处于打开状态,系统就会在探索运行时显示查询跟踪器。
探索性能面板
如需查看“探索”性能面板,请点击查看性能详情链接,该链接可在任何已运行的“探索”查询中找到。
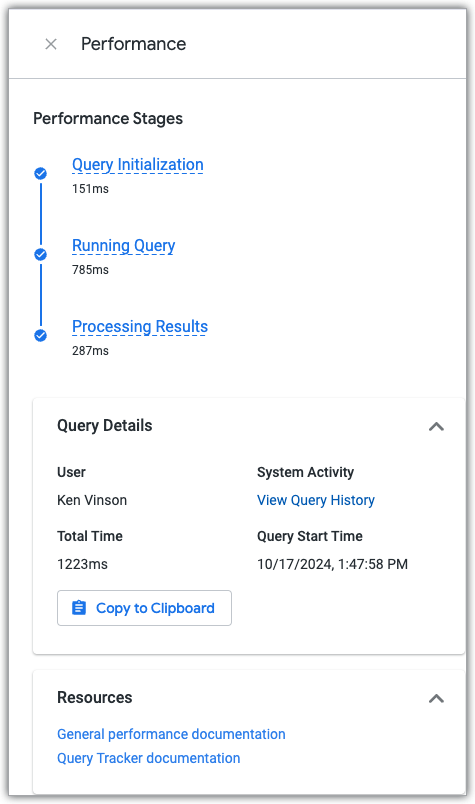
性能面板会显示查询在三个查询阶段中每个阶段所花费的时间,并包含指向性能文档和查询历史记录系统活动信息中心的链接,该信息中心会显示查询以及用于创建查询的探索的当前和历史效果数据。
查询阶段
当 Looker 探索运行数据库查询时,查询会分三个阶段执行,如下所示:
查询初始化阶段
在查询初始化阶段,Looker 会执行在将查询发送到数据库之前需要完成的所有任务。查询初始化阶段包括以下任务:
- 编译 LookML 模型
- 检查是否需要构建任何永久性派生表 (PDT)
- 生成查询 SQL
- 获取数据库连接
了解查询性能指标文档页面介绍了如何使用系统活动中的查询性能指标探索来查看查询的详细细分。查询跟踪器的查询初始化阶段包括查询效果指标探索的异步工作器阶段、初始化阶段和连接处理阶段中描述的事件。
如果您在查询初始化阶段遇到性能问题或查询耗时过长,请执行以下步骤:
- 错峰安排定时递送:如果许多定时 Look 或信息中心同时触发(尤其是在整点),突发的并发查询请求可能会使实例资源不堪重负,并导致连接池饱和。这种并发瓶颈会导致查询在初始化期间无限期等待或旋转。请将内容安排在不同的时间段(例如
:15、:30或:45),间隔 15 或 30 分钟,而不是全部安排在:00。如需了解详情,请参阅优化 Looker 服务器性能。 - 使用数据组进行计划:尽可能使用与 ETL 周期一致的数据组触发计划交付,而不是使用基于时间的触发器。使用数据组可以分散查询执行,并防止对未刷新的数据运行冗余查询。
- 批量处理和限制 API 调用:如果自动化脚本或外部工具通过 Looker API 触发查询或报告,请批量处理请求或引入延迟,以避免查询初始化队列过载。
- 清除卡住的进程:如果并发量突然激增导致查询卡住且实例无响应,请重启实例以清除正在进行的任务并重置内部队列。
运行查询阶段
在运行查询阶段,Looker 会连接并查询您的数据库,以便返回查询结果。此阶段的性能问题可能表明外部数据库存在问题,例如 PDT 需要很长时间才能重新构建,可能需要优化,或者外部数据库表可能需要优化。正在运行查询阶段包括以下任务:
- 在数据库中构建探索查询所需的任何 PDT
- 正在对数据库运行请求的查询
了解查询性能指标文档页面介绍了如何使用系统活动中的查询性能指标探索来查看查询的详细细分。查询跟踪器的正在运行查询阶段包含查询性能指标探索的主查询阶段中所述的事件。
如果您在此阶段遇到性能问题,可以采取以下措施:
- 尽可能使用
many_to_one联接构建探索。将视图从最精细的级别联接到最高细节级别 (many_to_one),通常可提供最佳查询性能。 - 尽可能最大程度利用缓存,并尽可能使其与您的 ETL 政策保持同步,以减少数据库查询流量。默认情况下,Looker 会将查询缓存一小时。您可以使用
persist_with参数在探索中应用数据组,从而控制缓存政策,并使 Looker 数据刷新与您的 ETL 流程同步。最大限度地利用缓存,可让 Looker 与后端数据流水线更紧密地集成,从而最大程度利用缓存,同时避免分析过时数据的风险。命名缓存政策可以应用于整个模型,也可以应用于单个探索和永久性派生表 (PDT)。 - 使用 Looker 的汇总感知功能创建汇总表或摘要表,以便 Looker 尽可能使用它们来执行查询,尤其是针对大型数据库的常见查询。您还可以使用汇总感知功能来大幅提升整个信息中心的性能。如需了解详情,请参阅汇总感知教程。
- 使用 PDT 可加快查询速度。将具有许多复杂或低效联接的探索,或具有子查询或子选择的维度转换为 PDT,以便在运行时之前预先联接并准备好视图。
- 如果您的数据库方言支持增量 PDT,请配置增量 PDT,以减少 Looker 重建 PDT 表所花费的时间。
- 避免在 Looker 中定义的串联主键上将视图联接到探索中。而是应该联接视图中构成串联主键的基本字段。或者,将视图重新创建为 PDT,并在表的 SQL 定义(而非视图的 LookML)中预定义串联主键。
- 使用“在 SQL Runner 中说明”工具进行基准测试。
EXPLAIN会针对给定的 SQL 查询生成数据库查询执行计划的概览,让您能够检测可以优化的查询组件。如需了解详情,请参阅如何使用EXPLAIN优化 SQL 社区帖子。 - 声明索引。您可以直接在 Looker 中通过 SQL 运行程序查看每个表的索引,方法是点击表中的齿轮图标,然后选择显示索引。
最常受益于索引的列是重要日期和外键。为这些列添加索引可提升几乎所有查询的性能。这也适用于 PDT。LookML 参数(例如
indexes、sort keys和distribution)可以适当应用。
“正在处理结果”阶段
在处理结果阶段,Looker 会处理和呈现查询结果。处理结果阶段包括以下任务:
- 将查询结果流式传输到缓存
- 解析表计算
- 设置 Liquid 模板语言的结果格式
- 合并查询
- 计算总计和小计
了解查询性能指标文档页面介绍了如何使用系统活动中的查询性能指标探索来查看查询的详细细分。查询跟踪器的处理结果阶段包含查询效果指标探索的查询后阶段中所述的事件。
如果您在此阶段遇到性能问题,可以采取以下措施:
- 尽量少用合并结果、自定义字段和表计算等功能。这些功能旨在用作概念验证,以帮助设计模型。 最佳实践是在 LookML 中对任何常用的计算和函数进行硬编码,这将生成要在数据库中处理的 SQL。过多的计算可能会争用 Looker 实例上的 Java 内存,导致 Looker 实例响应速度变慢。
- 如果存在大量视图文件,请限制模型中包含的视图数量。在单个模型中包含所有视图可能会降低性能。如果项目中存在大量视图,请考虑仅在每个模型中包含所需的视图文件。考虑对视图文件名使用策略性命名规范,以便在模型中包含视图组。
includes参数文档中概述了一个示例。 - 避免在信息中心图块和 Look 中默认返回大量数据点。返回数千个数据点的查询会消耗更多内存。确保尽可能限制数据,方法是向信息中心、Look 和探索应用前端
过滤条件,并在 LookML 级别使用
required filters、conditionally_filter和sql_always_where参数。 - 请谨慎使用所有结果选项下载或传送查询,因为某些查询可能非常大,在处理时会使 Looker 服务器不堪重负。