


Ce guide fournit une procédure détaillée pour déployer une pile PostgreSQL à disponibilité élevée sur trois zones dans un environnement isolé de Google Distributed Cloud (GDC). Vous apprendrez à préparer les artefacts logiciels nécessaires, à amorcer les VM cibles et à utiliser Autobase pour automatiser l'ensemble du processus de provisionnement. Dans ce guide, Patroni est utilisé comme couche de gestion principale pour orchestrer le cycle de vie de PostgreSQL et gérer les basculements automatiques.
Architecture
L'architecture se compose d'un environnement à trois VM réparties sur trois zones de disponibilité.
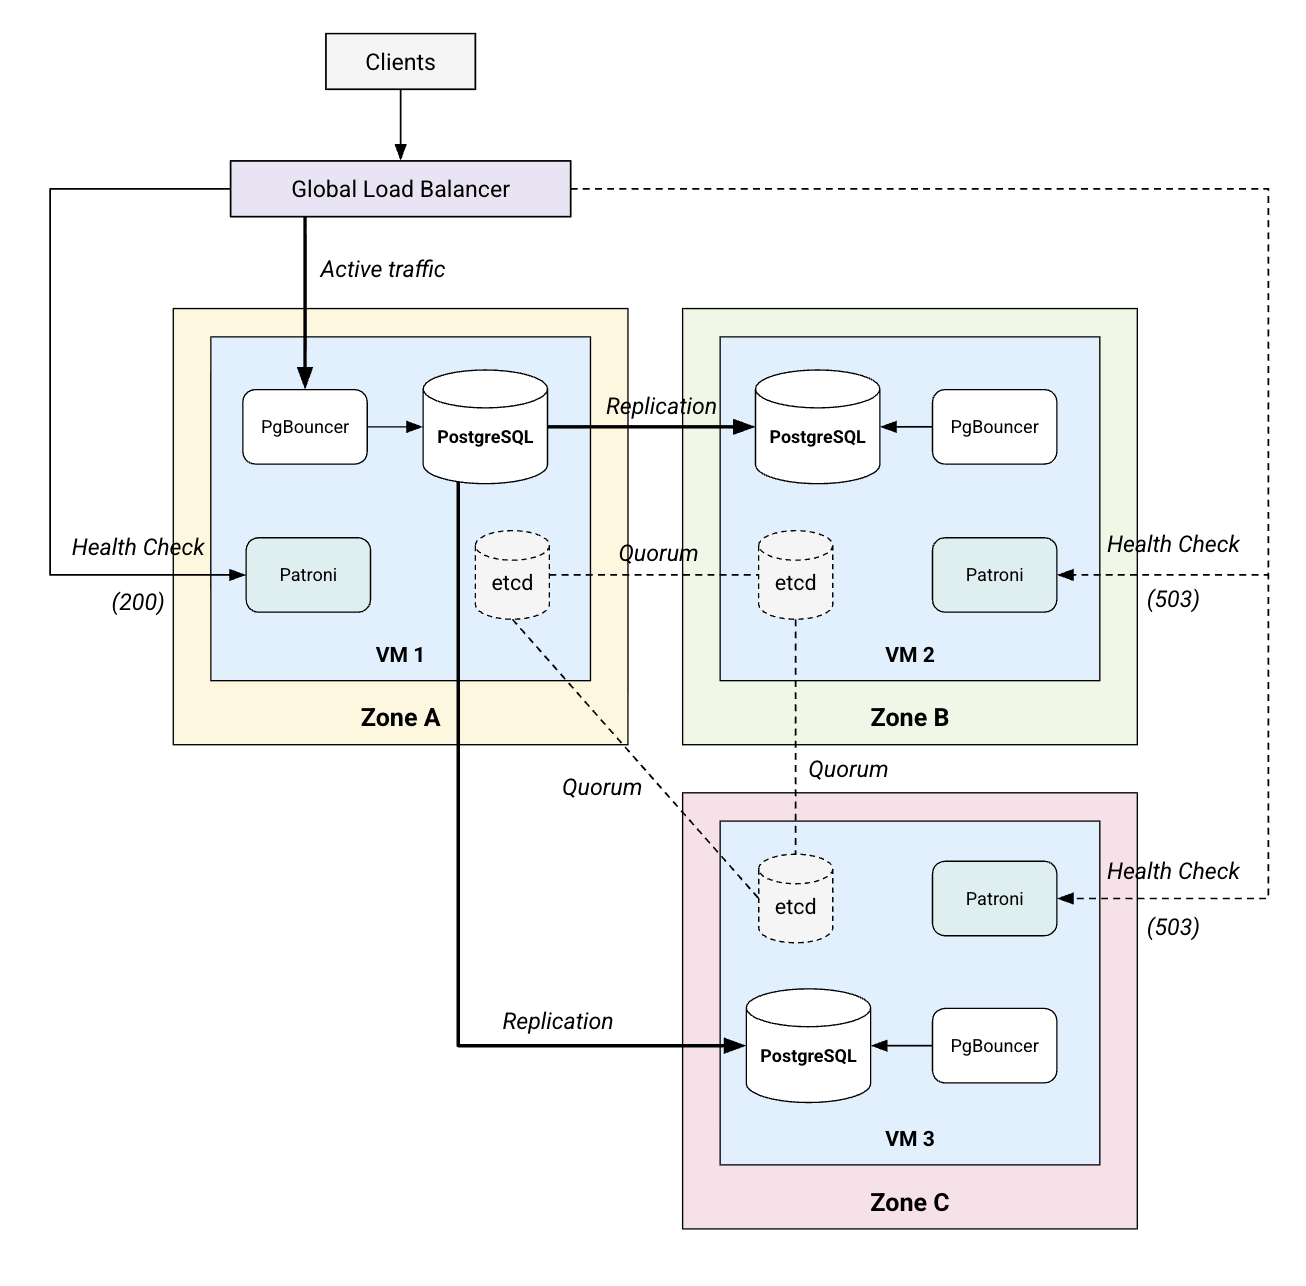
Chaque VM est identique et exécute une pile de services colocalisée :
- PostgreSQL 17 : moteur de base de données relationnelle principal.
- Patroni : gestionnaire de haute disponibilité. Il gère le cycle de vie du processus PostgreSQL et effectue des basculements automatiques. Il expose une API REST HTTPS sur le port
8008(point de terminaison/primary) utilisée par l'équilibreur de charge pour identifier le leader actuel. - etcd : magasin de configurations distribuées (DCS). Il fournit la couche de consensus pour l'élection du leader et stocke la configuration de Patroni.
- PgBouncer : regroupement de connexions situé devant PostgreSQL pour stabiliser la surcharge de connexion. Il fournit le point d'entrée recommandé pour le trafic applicatif sur le port
6432.
La pile inclut également un équilibreur de charge L4 global GDC sous air gap, qui est un service géré par la plate-forme fournissant une adresse IP virtuelle stable. Les applications se connectent à l'adresse IP virtuelle stable sur le port 6432, que l'équilibreur de charge achemine vers PgBouncer sur la VM leader actuelle. PgBouncer proxy ensuite la requête vers l'instance PostgreSQL locale. Pour gérer le flux de trafic, l'équilibreur de charge interroge en permanence les points de terminaison HTTPS de Patroni en tant que vérification de l'état.
La vérification de l'état sur la VM leader renvoie HTTP 200 OK pour indiquer que la VM est prête à recevoir du trafic, tandis que les vérifications d'état sur les VM dupliquées renvoient HTTP 503 Service Unavailable pour indiquer à l'équilibreur de charge de les ignorer. En cas de défaillance du leader, un nouveau leader est élu et son instance Patroni commence à renvoyer HTTP 200 OK, ce qui entraîne la redirection automatique du trafic par l'équilibreur de charge vers le port PgBouncer de la nouvelle VM.
Pour garantir une haute disponibilité et éviter la perte de données, la pile repose sur le concept de quorum. Avec trois VM, le système nécessite qu'une majorité d'au moins deux membres soient opérationnels et communiquent pour élire un leader et rester opérationnel. Ce consensus basé sur la majorité, géré par etcd et Patroni, permet à la pile de tolérer automatiquement la défaillance totale d'une VM ou d'une zone.
Considérations sur les performances
Lorsque vous planifiez votre déploiement, tenez compte des facteurs concrets suivants pour optimiser les performances et la fiabilité :
- Dimensionnement du matériel : bien que les exigences varient en fonction de la charge de travail, utilisez ces profils standards comme point de départ pour chaque VM :
- Développement/preuve de concept : 2 processeurs virtuels, 8 Go de RAM (minimum pour un fonctionnement stable).
- Petite production : 4 processeurs virtuels, 16 Go de RAM. Convient aux outils internes avec une simultanéité modérée.
- Production standard : 8 processeurs virtuels, 32 Go de RAM. La référence recommandée pour les applications critiques.
- Débit élevé : 16 processeurs virtuels ou plus, 64 Go de RAM ou plus. Pour les charges de travail nécessitant une mise en cache étendue des données en mémoire (tampons partagés PostgreSQL).
- Performances de stockage : un stockage hautes performances est essentiel. Les disques SSD sont fortement recommandés pour la stabilité d'etcd. etcd est extrêmement sensible à la latence d'écriture sur disque . Les consignes officielles concernant le matériel etcd recommandent une latence fdatasync WAL de disque p99 inférieure à 10 ms.
- Latence réseau : la latence entre les VM a un impact direct sur les performances de réplication :
- Quorum etcd : le délai aller-retour moyen (DAR) doit être inférieur à 50 ms (idéalement inférieur à 10 ms) pour éviter les délais d'expiration de l'élection et l'instabilité du cluster.
- Réplication synchrone : si elle est configurée, chaque transaction d'écriture doit attendre l'accusé de réception d'une instance dupliquée. La latence interzone dans GDC sous air gap est généralement inférieure à 1 ms, ce qui est excellent pour réduire au minimum la surcharge d'écriture (généralement de 10 à 30%).
- Rôle de PgBouncer : PostgreSQL crée un processus de système d'exploitation pour chaque connexion, ce qui consomme environ 10 Mo de RAM et entraîne des coûts de commutation de contexte du processeur. PgBouncer réduit cette surcharge en conservant un pool de connexions persistantes, ce qui permet à la base de données de gérer des milliers de connexions d'application avec beaucoup moins de processus de backend.
- Composants side-car : Patroni et etcd sont légers, mais nécessitent une disponibilité constante du processeur. Dans les scénarios de charge élevée, assurez-vous que les VM ne sont pas sursouscrites au niveau de l'hyperviseur pour éviter de "voler" les cycles de processeur requis pour les pulsations et la maintenance du leader.
- Réglage du noyau : l'automatisation Autobase applique automatiquement des optimisations
bénéfiques pour PostgreSQL, telles que la configuration
sysctl
des paramètres (par exemple,
vm.swappiness,net.core.somaxconn) et la désactivation des pages énormes transparentes (THP). Ces modifications réduisent la surcharge de gestion de la mémoire et améliorent le débit réseau pour les instances de base de données à fort trafic.
Avant de commencer
Avant de commencer le déploiement, vous devez vous assurer que votre environnement répond aux exigences suivantes.
Examiner les exigences des VM
Pour les besoins de ce tutoriel, vous devez créer trois VM dans votre projet GDC sous air gap. Vous devez tenir compte des points et exigences suivants pour les VM :
- Distribution des zones : pour que ce déploiement soit réellement résilient en cas de défaillance de zone, vous devez répartir les VM sur trois zones de disponibilité différentes. Toutefois, le déploiement reste identique si les VM sont situées dans deux zones, voire dans une seule. Le plus important est que toutes les VM puissent communiquer entre elles sur le réseau avec leurs adresses IP internes.
- Système d'exploitation : ce tutoriel suppose que vous utilisez des images Ubuntu 22.04. Les étapes suivantes de ce guide peuvent différer si vous utilisez une autre distribution.
- Ressources : pour ce tutoriel, vous devez provisionner au moins deux processeurs et 8 Go de mémoire par VM. En production, vous devez provisionner des ressources adaptées à vos charges de travail spécifiques (voir Considérations sur les performances).
- Adresses IP réseau : vous devez prendre note des adresses IP internes et externes de chaque VM. Dans ce guide, vous utilisez des adresses IP externes pour le contrôle Ansible, car vous exécutez des commandes à partir d'une station de travail externe. Les adresses IP internes sont utilisées pour la communication et la liaison interservices. Si vous avez provisionné une VM bootstrapper dans le réseau, vous n'aurez besoin que des adresses IP internes.
- Accès : un accès sudo sans mot de passe pour l'utilisateur de déploiement est requis, car l'automatisation Ansible doit effectuer des tâches administratives (installation de packages, modification des configurations système) sans être bloquée par des invites de mot de passe.
- SSH : l'authentification basée sur des clés doit être activée pour permettre à Ansible de se connecter aux VM cibles de manière sécurisée et non interactive.
Préparer le logiciel de la station de travail locale
Pour gérer le déploiement et préparer les artefacts sous air gap, vous aurez besoin d'un ensemble d'outils d'automatisation et de conteneurisation installés sur votre station de travail locale.
- Ansible 2.17.0 ou version ultérieure : moteur d'automatisation qui exécute les playbooks et les rôles de déploiement.
- Docker : utilisé pour extraire et empaqueter les dépendances du système d'exploitation dans un environnement identique aux VM cibles (Ubuntu 22.04).
- Client PostgreSQL (
psql) : requis pour exécuter les requêtes de test et vérifier la réplication des données à partir de votre poste de travail local. Dépôt Autobase :
- Clonez le dépôt pour accéder aux playbooks et aux rôles d'automatisation : https://github.com/vitabaks/autobase
Extrayez une version spécifique (ce guide utilise la version 2.5.2) :
git checkout 2.5.2Les étapes suivantes de ce guide peuvent différer si vous utilisez une autre distribution.
Pour exécuter les playbooks de ce guide, vous devez installer le code source
autobaselocal en tant que collection Ansible afin que les préfixes de rôle puissent être résolus :cd autobase/automation ansible-galaxy collection install . --force
Créer des variables d'environnement
Dans ce guide, vous utiliserez les variables d'environnement suivantes pour simplifier les commandes. Ces variables stockent des paramètres critiques tels que l'ID de votre projet, les zones de disponibilité de vos VM, leurs noms d'hôte et les libellés utilisés par l'équilibreur de charge pour identifier votre cluster. Définissez-les dans votre session shell actuelle avec les valeurs réelles de votre environnement (assurez-vous que les zones sont séparées par des espaces).
Notez que même si vous pouvez définir les noms de votre choix pour vos VM, ce guide utilise postgres-vm-1, postgres-vm-2 et postgres-vm-3 comme exemples de noms arbitraires pour les nœuds de cluster :
export PROJECT_ID="your-project-id"
export ZONES="zone1 zone2 zone3"
export VM1_NAME="postgres-vm-1"
export VM2_NAME="postgres-vm-2"
export VM3_NAME="postgres-vm-3"
export VM_LABEL="app=my-postgres-cluster"
export CLUSTER_NAME="my-postgres-cluster"
Configurer Ansible
Définissez votre environnement de VM dans le fichier inventory.ini à l'aide du modèle suivant :
[master]
postgres-vm-1 ansible_host=XX.XX.XX.XX hostname=postgres-vm-1 bind_address=XX.XX.XX.XX

[replica]
postgres-vm-2 ansible_host=XX.XX.XX.XX hostname=postgres-vm-2 bind_address=XX.XX.XX.XX
postgres-vm-3 ansible_host=XX.XX.XX.XX hostname=postgres-vm-3 bind_address=XX.XX.XX.XX

[postgres_cluster:children]
master
replica

[etcd_cluster]
postgres-vm-1
postgres-vm-2
postgres-vm-3

[all:vars]
ansible_user=...
ansible_ssh_private_key_file=~/.ssh/...
postgresql_version=17
with_haproxy_load_balancing=false
patroni_superuser_password=...
etcd_package_repo="file:///tmp/packages/etcd-v3.5.25-linux-amd64.tar.gz"
installation_method="packages"
install_postgresql_repo=false
install_timescale_repo=false
install_citus_repo=false
apt_repository=[]
yum_repository=[]
install_system_packages=false
patroni_installation_method=deb
Comprendre la configuration :
[master]et[replica]: définit les VM de base de données principale et secondaire. Assurez-vous d'utiliser les noms de VM réels définis dans les variables d'environnementVM1_NAME,VM2_NAMEetVM3_NAME.[postgres_cluster:children]: groupe qui agrège les nœuds maître et dupliqué, ce qui permet à Ansible de cibler l'ensemble du cluster de base de données avec une seule commande.[etcd_cluster]: définit les nœuds qui participeront au cluster de consensus etcd. Cela inclut les trois nœuds de base de données pour garantir une haute disponibilité.ansible_host: (pour chaque VM) adresse IP d'entrée externe de la VM utilisée par Ansible pour se connecter à cette VM. RemplacezXX.XX.XX.XXpar l'adresse IP externe réelle.bind_address: (pour chaque VM) adresse IP interne de la VM. RemplacezXX.XX.XX.XXpar l'adresse IP interne réelle.ansible_user: utilisateur distant qu'Ansible utilise pour se connecter aux VM cibles avec SSH. Remplacez...par le nom d'utilisateur réel.ansible_ssh_private_key_file: chemin d'accès local à la clé SSH privée utilisée pour l'authentification auprès des VM cibles. Remplacez~/.ssh/...par le chemin d'accès réel.patroni_superuser_password: mot de passe de l'utilisateurpostgres. Assurez-vous d'utiliser un mot de passe sécurisé et complexe.with_haproxy_load_balancing=false: désactive HAProxy local, car vous utilisez l'équilibreur de charge L4 natif de la plate-forme.etcd_package_repo: pointe vers le chemin d'accès local du binaire etcd dans le répertoire d'amorçage de la VM.installation_method="packages": indique à l'automatisation d'installer les composants avec des packages de système d'exploitation plutôt que de compiler à partir de la source ou d'utiliser Python pip.install_..._repo=falseet_repository=[]: ces remplacements empêchent Ansible d'essayer d'accéder à Internet pour ajouter des dépôts externes ou mettre à jour des listes de packages.install_system_packages=false: empêche l'automatisation d'essayer de télécharger et d'installer des packages que vous avez déjà provisionnés lors de la phase d'initialisation ou d'amorçage.patroni_installation_method=deb: indique spécifiquement au rôle d'utiliser le package.debque vous avez installé.
Initialiser les VM
La pile de base de données nécessite plusieurs packages et bibliothèques de système d'exploitation qui peuvent ne pas être inclus dans votre image Ubuntu de base. Comme les VM se trouvent dans un environnement isolé sans accès à Internet, elles ne peuvent pas télécharger ces dépendances elles-mêmes.
Pour résoudre ce problème, procédez comme suit :
Utilisez un conteneur Docker sur votre poste de travail local pour télécharger tous les fichiers nécessaires. La commande suivante utilise
apt-rdependspour identifier de manière récursive chaque bibliothèque partagée et chaque dépendance requises par les applications cibles. Elle configure le dépôt PostgreSQL officiel dans le conteneur pour extraire les artefacts de la version 17, puis parcourt la liste des dépendances pour télécharger des fichiers.debindividuels tout en filtrant les bibliothèques système de base (telles quelibc6ouhostname) afin d'éviter les conflits de version sur les VM cibles. Enfin, elle extrait le binaire etcd autonome directement depuis GitHub.Tout d'abord, créez un répertoire pour contenir les packages :
mkdir -p ./packagesEnsuite, exécutez la commande Docker pour télécharger tous les packages requis et le binaire etcd :
docker run --rm --platform linux/amd64 -v "$(pwd)/packages:/packages" \
  ubuntu:22.04 bash -c "
  set -e
  apt-get update
  apt-get install -y ca-certificates curl gnupg apt-rdepends

  # Add PostgreSQL Repository
  curl -fsSL https://www.postgresql.org/media/keys/ACCC4CF8.asc | \
    gpg --dearmor -o /etc/apt/trusted.gpg.d/postgresql.gpg
  echo 'deb http://apt.postgresql.org/pub/repos/apt jammy-pgdg main' > \
    /etc/apt/sources.list.d/pgdg.list
  apt-get update

  # Define Application Targets + Explicit dependencies needed for air-gap
  TARGETS='unzip tar pgbouncer patroni netdata postgresql-17 \
    postgresql-client-17 postgresql-contrib-17 \
    postgresql-server-dev-17 postgresql-17-dbgsym \
    python3-psycopg2 python3-click python3-yaml python3-prettytable \
    python3-urllib3 python3-tz python3-pip python3-setuptools \
    python3-cryptography moreutils vim jq acl zstd libjq1 \
    libpython3.10-stdlib libexpat1-dev zlib1g-dev libipc-run-perl \
    libtime-duration-perl libjson-perl libpython3-dev \
    libjs-sphinxdoc python3-wheel'

  # Resolve all recursive dependencies
  ALL_DEPS=\$(apt-cache depends --recurse --no-recommends --no-suggests \
    --no-conflicts --no-breaks --no-replaces --no-enhances \$TARGETS | \
    grep '^\w' | sort -u)

  cd /packages
  for pkg in \$ALL_DEPS; do
    if apt-cache show \"\$pkg\" > /dev/null 2>&1; then
      # Filter system core to avoid VM conflicts/breaks
      # We exclude core OS libraries (libc, systemd, etc.) because these
      # often cause version conflicts if the VM's patch level differs
      # from the online container.
      FILTER='base-files|debianutils|coreutils|findutils|diffutils|sed'
      FILTER+='|grep|gzip|hostname|ncurses|perl-base|libc6|binutils'
      FILTER+='|linux-libc|libc-bin|libc-dev-bin|systemd|dpkg|init'
      if [[ ! \"\$pkg\" =~ \$FILTER ]]; then
        apt-get download \"\$pkg\" || echo \"Failed \$pkg\"
      fi
    fi
  done

  # Download etcd binary
  if [ ! -f etcd-v3.5.25-linux-amd64.tar.gz ]; then
    curl -L https://github.com/etcd-io/etcd/releases/download/v3.5.25/\
etcd-v3.5.25-linux-amd64.tar.gz -o etcd-v3.5.25-linux-amd64.tar.gz
  fi
"
Utilisez Ansible pour importer l'archive sur les trois VM cibles simultanément :
ansible all -i inventory.ini -m copy -a "src=packages.tar.gz dest=/tmp/" -bEffacez toutes les données de package existantes sur les VM et extrayez le nouveau fichier tar :
ansible all -i inventory.ini -m shell -a "rm -rf /tmp/packages && \
  mkdir -p /tmp/packages && tar -xzf /tmp/packages.tar.gz -C /tmp/packages" -b
Effectuez une installation non interactive de tous les packages
.debtéléchargés. Pour éviter les problèmes liés à des pré-dépendances spécifiques dans un environnement isolé, utilisez l'option--force-dependssuivie deapt-get install -fypour résoudre l'arborescence des dépendances localement :ansible all -i inventory.ini -m shell -a "DEBIAN_FRONTEND=noninteractive \ NEEDRESTART_MODE=a dpkg -i --force-depends /tmp/packages/*.deb" -b ansible all -i inventory.ini -m shell -a "DEBIAN_FRONTEND=noninteractive \ NEEDRESTART_MODE=a apt-get install -fy" -bArrêtez immédiatement tous les services pour les empêcher de démarrer avec des états par défaut non configurés avant que l'automatisation ne soit prête :
ansible all -i inventory.ini -m shell -a \
  "systemctl stop patroni etcd pgbouncer postgresql || true" -b
Enfin, supprimez les clusters PostgreSQL par défaut et toutes les données etcd existantes pour permettre une initialisation propre :
ansible all -i inventory.ini -m shell -a \
  "pg_dropcluster 17 main --stop || true" -b
ansible all -i inventory.ini -m shell -a \
  "rm -rf /var/lib/postgresql/17/main/* /var/lib/etcd/default.etcd/*" -b
Provisionner l'infrastructure de base de données
Une fois les VM amorcées et l'inventaire configuré, vous pouvez utiliser les playbooks d'automatisation Autobase avec Ansible pour déployer la pile PostgreSQL disponibilité élevée.
Tout d'abord, exécutez les vérifications préliminaires pour vous assurer que l'environnement est prêt :
ansible-playbook vitabaks.autobase.deploy_pgcluster -i inventory.ini \
  --tags pre_checks
Si les vérifications sont réussies, passez au déploiement complet :
ansible-playbook vitabaks.autobase.deploy_pgcluster -i inventory.ini
Résultat attendu : le playbook doit se terminer par un "PLAY RECAP" indiquant que toutes les VM cibles ont été atteintes et mises à jour :
PLAY RECAP ********************************************************************
localhost                  : ok=1    changed=0    unreachable=0    failed=0    skipped=254  rescued=0    ignored=0
postgres-vm-1              : ok=160  changed=53   unreachable=0    failed=0    skipped=514  rescued=0    ignored=2
postgres-vm-2              : ok=116  changed=40   unreachable=0    failed=0    skipped=505  rescued=0    ignored=2
postgres-vm-3              : ok=116  changed=40   unreachable=0    failed=0    skipped=505  rescued=0    ignored=2
Vérifier le déploiement
Une fois le déploiement terminé, vous devez effectuer plusieurs vérifications pour vous assurer que tous les composants fonctionnent correctement.
Vérifier l'état de la haute disponibilité
Vérifiez l'état du gestionnaire de haute disponibilité pour voir les rôles attribués à chaque VM :
ansible master -i inventory.ini -m shell -a "patronictl list" -b
Exemple de résultat :
+ Cluster: postgres-cluster (7607933704953386478) ---+----+-------------+-----+------------+-----+
| Member        | Host         | Role    | State     | TL | Receive LSN | Lag | Replay LSN | Lag |
+---------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
| postgres-vm-1 | 10.253.1.254 | Leader  | running   |  1 |             |     |            |     |
| postgres-vm-2 | 10.253.1.253 | Replica | streaming |  1 |   0/6000000 |   0 |  0/6000000 |   0 |
| postgres-vm-3 | 10.253.1.252 | Replica | streaming |  1 |   0/6000000 |   0 |  0/6000000 |   0 |
+---------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
Vérifier les points de terminaison de vérification de l'état
Vérifiez que Patroni identifie correctement le leader et les instances dupliquées à l'aide de son API REST.
La vérification de l'état de la VM leader doit renvoyer 200 OK, tandis que les vérifications d'état des VM dupliquées doivent renvoyer 503 Service Unavailable :
ansible ${VM1_NAME} -i inventory.ini -m shell -a \
  "curl -ks -o /dev/null -w '%{http_code}' https://localhost:8008/primary" -b

ansible ${VM2_NAME} -i inventory.ini -m shell -a \
  "curl -ks -o /dev/null -w '%{http_code}' https://localhost:8008/primary" -b

ansible ${VM3_NAME} -i inventory.ini -m shell -a \
  "curl -ks -o /dev/null -w '%{http_code}' https://localhost:8008/primary" -b
Vérifier l'état de chaque VM
Vérifiez l'état de préparation de toutes les instances PostgreSQL :
ansible postgres_cluster -i inventory.ini -m shell -a "pg_isready -p 5432" -b
Exemple de résultat :
postgres-vm-1 | CHANGED | rc=0 >>
/var/run/postgresql:5432 - accepting connections

postgres-vm-2 | CHANGED | rc=0 >>
/var/run/postgresql:5432 - accepting connections

postgres-vm-3 | CHANGED | rc=0 >>
/var/run/postgresql:5432 - accepting connections
Vérifier l'état d'etcd
Vérifiez l'état de la couche de consensus sur toutes les VM en utilisant localhost comme point de terminaison :
ansible all -i inventory.ini -m shell -a "ETCDCTL_API=3 etcdctl \
  --endpoints=https://localhost:2379 \
  --cacert=/etc/etcd/tls/ca.crt \
  --cert=/etc/etcd/tls/server.crt \
  --key=/etc/etcd/tls/server.key \
  endpoint health" -b
Exemple de résultat :
postgres-vm-1 | CHANGED | rc=0 >>
https://localhost:2379 is healthy: successfully committed proposal: \
took = 28.78311ms

postgres-vm-2 | CHANGED | rc=0 >>
https://localhost:2379 is healthy: successfully committed proposal: \
took = 33.081265ms

postgres-vm-3 | CHANGED | rc=0 >>
https://localhost:2379 is healthy: successfully committed proposal: \
took = 24.414291ms
Configurer l'équilibreur de charge global
Pour fournir une adresse IP virtuelle stable à la pile de base de données, configurez l'équilibreur de charge L4 global natif de la plate-forme à l'aide de l'CLI gdcloud.
Prérequis :
- Assurez-vous de disposer du rôle
load-balancer-admindans votre projet. Appliquez un libellé à vos VM afin que l'équilibreur de charge puisse cibler correctement les instances qu'il doit desservir (remplacez les valeurs du paramètre
kubeconfigpar les fichierskubeconfigde l'API de gestion correspondants pour chaque zone) :kubectl --kubeconfig=ZONE_A_MANAGEMENT_API label VirtualMachine \ -n ${PROJECT_ID} \ ${VM1_NAME} \ ${VM_LABEL} kubectl --kubeconfig=ZONE_B_MANAGEMENT_API label VirtualMachine \ -n ${PROJECT_ID} \ ${VM2_NAME} \ ${VM_LABEL} kubectl --kubeconfig=ZONE_C_MANAGEMENT_API label VirtualMachine \ -n ${PROJECT_ID} \ ${VM3_NAME} \ ${VM_LABEL}
- Assurez-vous de disposer du rôle
Définissez le niveau d'accès à l'équilibrage de charge. Définissez
EXTERNALsi vous devez vous connecter depuis l'extérieur du réseau du projet, ouINTERNALsi l'accès n'est requis que depuis le VPC. Pour ce tutoriel, nous allons utiliser une configuration externe :export LB_SCHEME=EXTERNALCréez une vérification de l'état. L'équilibreur de charge utilise l'API REST de Patroni pour identifier le leader :
gdcloud compute health-checks create https ${CLUSTER_NAME}-hc \
  --project=${PROJECT_ID} \
  --port=8008 \
  --request-path="/primary" \
  --check-interval=10 \
  --timeout=5 \
  --healthy-threshold=2 \
  --unhealthy-threshold=3 \
  --global
Créez un backend zonal distinct pour chaque zone dans laquelle se trouvent vos VM :
for zone in $(echo $ZONES); do
  gdcloud compute backends create ${CLUSTER_NAME}-backend-${zone} \
    --project=${PROJECT_ID} \
    --zone=${zone} \
    --labels="${VM_LABEL}"
done
Créez un service de backend à l'échelle mondiale :
gdcloud compute backend-services create ${CLUSTER_NAME}-bes \
  --project=${PROJECT_ID} \
  --health-check="${CLUSTER_NAME}-hc" \
  --global
Ajoutez vos backends zonaux au service global :
for zone in $(echo $ZONES); do
  gdcloud compute backend-services add-backend ${CLUSTER_NAME}-bes \
    --project=${PROJECT_ID} \
    --backend=${CLUSTER_NAME}-backend-${zone} \
    --backend-zone=${zone} \
    --global
done
Créez une règle de transfert globale (adresse IP virtuelle). Cette règle expose la base de données sur le port
6432:gdcloud compute forwarding-rules create ${CLUSTER_NAME}-fr \ --project=${PROJECT_ID} \ --load-balancing-scheme=${LB_SCHEME} \ --backend-service=${CLUSTER_NAME}-bes \ --ip-protocol-port="TCP:6432" \ --globalRécupérez l'adresse IP virtuelle :
LB_IP=$(gdcloud compute forwarding-rules describe ${CLUSTER_NAME}-fr \
  --project=${PROJECT_ID} \
  --load-balancing-scheme=${LB_SCHEME} \
  --global \
  --format=json \
  | jq -r '.metadata.annotations["networking.gke.io/forwardingRuleCIDR"]'  \
  | cut -d '/' -f 1)

echo "The load balancer IP is: ${LB_IP}"
Créez une
ProjectNetworkPolicy(PNP) pour autoriser le trafic entrant vers le port PgBouncer (remplacez la valeur du paramètrekubeconfigpar le fichierkubeconfigde l'API globale correspondant à votre environnement).kubectl --kubeconfig=GLOBAL_API_KUBECONFIG apply -f - <<EOF apiVersion: networking.global.gdc.goog/v1 kind: ProjectNetworkPolicy metadata: name: allow-pgbouncer namespace: ${PROJECT_ID} spec: ingress: - ports: - port: 6432 protocol: TCP policyType: Ingress subject: subjectType: UserWorkload EOF
Vérifier la réplication des données
Pour vérifier que la pile à haute disponibilité fonctionne comme prévu, vous pouvez créer des exemples de données sur le leader et vérifier leur présence sur les instances dupliquées.
Insérer des exemples de données
L'automatisation génère un mot de passe aléatoire pour l'utilisateur postgres lors du premier déploiement si aucun mot de passe n'est fourni dans inventory.ini. Vous pouvez le récupérer à partir de n'importe quelle VM :
export PG_PASSWORD=$(ansible master -i inventory.ini -m shell -a \
  "grep -A10 'authentication:' /etc/patroni/patroni.yml | \
  grep -A3 'superuser' | grep 'password:' | awk '{ print \$2 }'" -b | \
  tail -n 1)
echo $PG_PASSWORD
Connectez-vous à l'adresse IP virtuelle de l'équilibreur de charge sur le port PgBouncer (6432) et créez un exemple de table :
PGPASSWORD="${PG_PASSWORD}" psql -h ${LB_IP} -p 6432 -U postgres -c "
  CREATE TABLE employees (first_name TEXT, last_name TEXT);
  INSERT INTO employees (first_name, last_name) VALUES ('John', 'Doe');
"
Résultat attendu :
INSERT 0 1
Vérifier l'état de la réplication
Exécutez une requête SELECT sur toutes les VM pour vous assurer que les données ont été répliquées du leader vers toutes les instances dupliquées :
ansible postgres_cluster -i inventory.ini -m shell -a "psql -U postgres -c \
  'SELECT * FROM employees;'" -b
Exemple de résultat :
postgres-vm-1 | CHANGED | rc=0 >>
 first_name | last_name
------------+-----------
 John       | Doe
(1 row)

postgres-vm-2 | CHANGED | rc=0 >>
 first_name | last_name
------------+-----------
 John       | Doe
(1 row)

postgres-vm-3 | CHANGED | rc=0 >>
 first_name | last_name
------------+-----------
 John       | Doe
(1 row)
Tester le basculement manuel
Un basculement manuel vous permet de déplacer en douceur le rôle de leader vers une VM candidate spécifique. Cette opération est généralement effectuée pour une maintenance planifiée, des mises à niveau logicielles ou pour équilibrer l'utilisation des ressources entre les zones.
Identifier le leader actuel
Vérifiez le rôle et l'état actuels des VM :
ansible master -i inventory.ini -m shell -a "patronictl list" -b
Exemple de résultat :
+ Cluster: postgres-cluster (7607933704953386478) ---+----+-------------+-----+------------+-----+
| Member        | Host         | Role    | State     | TL | Receive LSN | Lag | Replay LSN | Lag |
+---------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
| postgres-vm-1 | 10.253.1.254 | Leader  | running   |  1 |             |     |            |     |
| postgres-vm-2 | 10.253.1.253 | Replica | streaming |  1 |   0/6000000 |   0 |  0/6000000 |   0 |
| postgres-vm-3 | 10.253.1.252 | Replica | streaming |  1 |   0/6000000 |   0 |  0/6000000 |   0 |
+---------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
Effectuer le basculement
Déclenchez un basculement du leader actuel vers une autre VM (dans ce cas, respectivement de postgres-vm-1 à postgres-vm-2). La commande utilise --force pour ignorer les invites de confirmation manuelle :
ansible master -i inventory.ini -m shell -a "patronictl switchover \
  --leader ${VM1_NAME} --candidate ${VM2_NAME} --force" -b
Exemple de résultat :
Successfully switched over to "postgres-vm-2"
+ Cluster: postgres-cluster (7607933704953386478) -+----+-------------+-----+------------+-----+
| Member        | Host         | Role    | State   | TL | Receive LSN | Lag | Replay LSN | Lag |
+---------------+--------------+---------+---------+----+-------------+-----+------------+-----+
| postgres-vm-1 | 10.253.1.254 | Replica | stopped |    |     unknown |     |    unknown |     |
| postgres-vm-2 | 10.253.1.253 | Leader  | running |  1 |             |     |            |     |
| postgres-vm-3 | 10.253.1.252 | Replica | running |  1 |   0/70000A0 |   0 |  0/70000A0 |   0 |
+---------------+--------------+---------+---------+----+-------------+-----+------------+-----+
Vérifier le changement de vérification de l'état
Après le basculement, vérifiez que l'état de la vérification de l'état est passé au nouveau leader :
ansible ${VM1_NAME} -i inventory.ini -m shell -a \
  "curl -ks -o /dev/null -w '%{http_code}' https://localhost:8008/primary" -b

ansible ${VM2_NAME} -i inventory.ini -m shell -a \
  "curl -ks -o /dev/null -w '%{http_code}' https://localhost:8008/primary" -b
L'ancien leader (postgres-vm-1) doit renvoyer 503, tandis que le nouveau leader (postgres-vm-2) doit renvoyer 200.
Tester le basculement automatique
Contrairement à un basculement manuel, un basculement automatique se produit lorsque la VM leader n'est plus disponible. Ce test confirme que Patroni élit un nouveau leader et que l'équilibreur de charge redirige le trafic sans intervention manuelle. Supposons que postgres-vm-2 soit le leader actuel après le basculement manuel effectué précédemment.
Identifier le leader actuel
Vérifiez le rôle et l'état actuels des VM :
ansible master -i inventory.ini -m shell -a "patronictl list" -b
Exemple de résultat :
+ Cluster: postgres-cluster (7607933704953386478) ---+----+-------------+-----+------------+-----+
| Member        | Host         | Role    | State     | TL | Receive LSN | Lag | Replay LSN | Lag |
+---------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
| postgres-vm-1 | 10.253.1.254 | Replica | streaming |  2 |   0/8000000 |   0 |  0/8000000 |   0 |
| postgres-vm-2 | 10.253.1.253 | Leader  | running   |  2 |             |     |            |     |
| postgres-vm-3 | 10.253.1.252 | Replica | streaming |  2 |   0/8000000 |   0 |  0/8000000 |   0 |
+---------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
Simuler une défaillance de VM
Arrêtez le service patroni sur la VM leader pour simuler un plantage ou une défaillance matérielle :
ansible master -i inventory.ini -m shell -a "systemctl stop patroni" -b
Observer la nouvelle élection
Attendez 10 à 20 secondes et vérifiez l'état d'une autre VM pour voir la promotion d'un nouveau leader :
ansible replica -i inventory.ini -m shell -a "patronictl list" -b
Exemple de résultat :
postgres-vm-3 | CHANGED | rc=0 >>
+ Cluster: postgres-cluster (7607933704953386478) ---+----+-------------+-----+------------+-----+
| Member        | Host         | Role    | State     | TL | Receive LSN | Lag | Replay LSN | Lag |
+---------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
| postgres-vm-1 | 10.253.1.254 | Leader  | running   |  3 |             |     |            |     |
| postgres-vm-2 | 10.253.1.253 | Replica | stopped   |    |     unknown |     |    unknown |     |
| postgres-vm-3 | 10.253.1.252 | Replica | streaming |  3 |   0/90003F8 |   0 |  0/90003F8 |   0 |
+---------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
Vous devriez voir que l'une des autres VM (postgres-vm-1 ou postgres-vm-3) est devenue le leader et que l'ancien leader (postgres-vm-2) est marqué comme arrêté.
Vérifier le changement de vérification de l'état
Vérifiez que les vérifications d'état de l'équilibreur de charge identifient désormais correctement le leader nouvellement élu :
ansible ${VM1_NAME} -i inventory.ini -m shell -a \
  "curl -ks -o /dev/null -w '%{http_code}' https://localhost:8008/primary" -b
Le nouveau leader doit renvoyer 200 OK.
Récupérer la VM défaillante
Redémarrez le service patroni sur la VM d'origine pour lui permettre de rejoindre la pile en tant qu'instance dupliquée et de rattraper les données manquantes :
ansible ${VM2_NAME} -i inventory.ini -m shell -a \
  "systemctl start patroni" -b