


Questo documento fornisce un'architettura di riferimento per il deployment di database Microsoft SQL Server ad alta affidabilità (HA) in Google Cloud utilizzando un gruppo di disponibilità Always On. Il documento include anche considerazioni di progettazione per l'alta disponibilità e il ripristino di emergenza (RE), opzioni di deployment, consigli per l'automazione e indicazioni per le operazioni di Backup e RE. Questo documento è destinato ai professionisti tecnici che stanno valutando Google Cloud come piattaforma per eseguire database SQL Server. Presuppone che tu abbia conoscenze di base di Compute Engine e SQL Server.
Google Cloud fornisce soluzioni convenienti, affidabili, sicure e ad alte prestazioni per l'esecuzione di database SQL Server. Per una panoramica delle soluzioni SQL Server supportate in Google Cloud, consulta SQL Server su Google Cloud.
Per utilizzare un deployment non di sviluppo di SQL Server in Google Cloud, utilizza una delle seguenti opzioni di licenza:
Bring Your Own License (BYOL): porta le tue licenze Microsoft SQL Server esistenti su Google Cloud. Devi utilizzare nodi single-tenant o Software Assurance con mobilità delle licenze.
Utilizza licenze on demand: utilizza immagini SQL Server predefinite in Google Cloud e paga una tariffa che include il costo di calcolo e il costo della licenza Microsoft. Google gestisce i contratti di licenza e la fatturazione di Microsoft.
La sezione Deployment di questo documento fornisce risorse per aiutarti a eseguire il deployment di questa architettura di riferimento.
Architettura
Il seguente diagramma mostra un'architettura di riferimento per un deployment di SQL Server configurato per l'alta disponibilità in Google Cloud:
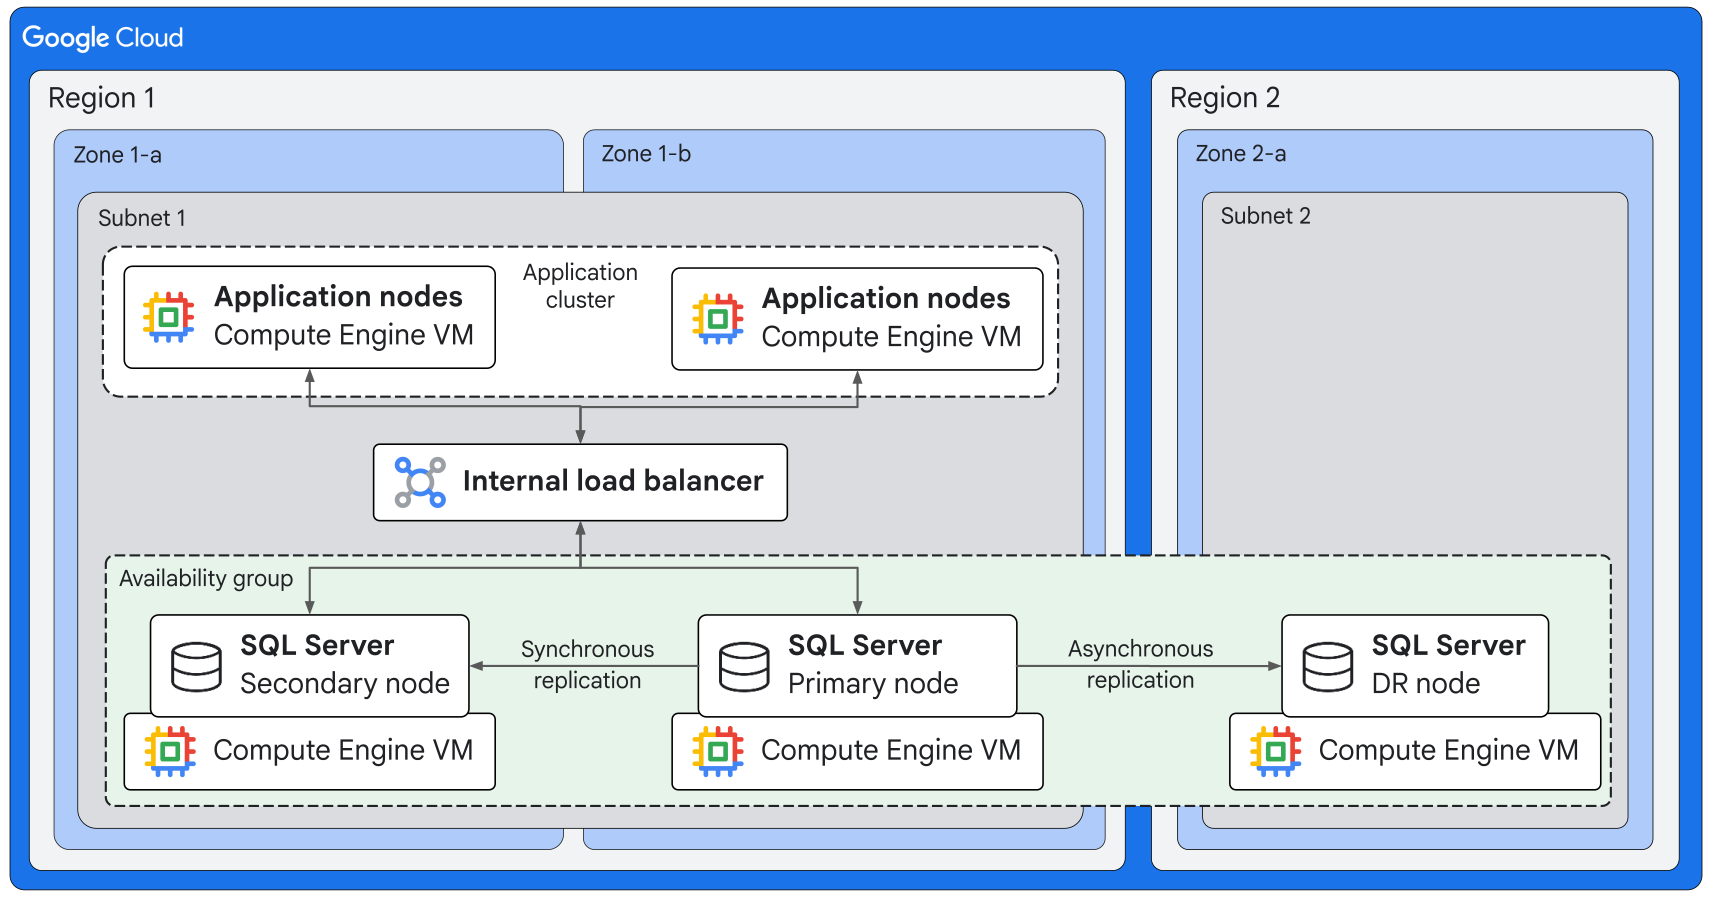
L'architettura precedente mostra un gruppo di disponibilità Always On con tre nodi in un cluster di failover di Windows Server (WSFC). Ogni nodo è una VM Compute Engine che esegue SQL Server.
Un gruppo di disponibilità Always On è un pattern di deployment standard del settore per raggiungere gli obiettivi di affidabilità per i database SQL Server mission-critical. I gruppi di disponibilità Always On forniscono alta affidabilità locale (failover all'interno di una regione) e failover tra regioni per RE. Questo pattern di deployment è un'alternativa di livello aziendale al mirroring del database. Un gruppo di disponibilità Always On offre i seguenti vantaggi:
- Nessuna necessità di componenti dell'infrastruttura specializzati: SQL Server gestisce la replica in tutte le repliche del database configurate.
- Configurazione SLA più elevata per SQL Server: Recovery Time Objective (RTO) inferiore a un minuto e Recovery Point Objective (RPO) quasi pari a zero.
- Possibilità di eseguire l'offload dei carichi di lavoro di sola lettura alle repliche secondarie: ridimensiona in modo efficiente la tua implementazione per l'analisi e altri casi d'uso comuni.
- Nodi in regioni aggiuntive per il DR: esegui il deployment di una replica primaria e fino a otto repliche secondarie.
- Implementabile su Windows e Linux: puoi utilizzare uno strumento di terze parti come Pacemaker come gestore del cluster per le implementazioni Linux.
Nell'architettura precedente, i nodi SQL Server primario e secondario si trovano in zone separate all'interno di una regione. Il nodo di ripristino di emergenza si trova in una regione geografica remota. I dati del nodo primario vengono replicati in modo sincrono nel nodo secondario e in modo asincrono nel nodo di RE.
Per distribuire il traffico dal livello applicazione ai nodi di database primari e secondari all'interno di una regione, puoi utilizzare uno dei seguenti approcci:
- Un bilanciatore del carico interno, come mostrato nel diagramma dell'architettura.
- Un listener del nome di rete distribuito (DNN) e un server DNS.
Prodotti utilizzati
L'architettura utilizza i seguenti prodotti e componenti Google Cloud e Microsoft.
Google Cloud prodotti
- Compute Engine: un servizio di calcolo sicuro e personalizzabile che ti consente di creare ed eseguire VM sull'infrastruttura di Google.
- Google Cloud Hyperdisk: un servizio di archiviazione di rete che puoi utilizzare per eseguire il provisioning e scalare dinamicamente i volumi di archiviazione a blocchi con prestazioni configurabili e prevedibili.
- Virtual Private Cloud (VPC): un sistema virtuale che fornisce funzionalità di rete globali e scalabili per i tuoi Google Cloud carichi di lavoro. VPC include il peering di rete VPC, Private Service Connect, l'accesso privato ai servizi e VPC condiviso.
- Cloud Load Balancing: un portafoglio di bilanciatori del carico scalabili, globali e regionali ad alte prestazioni.
Prodotti e componenti Microsoft
I seguenti componenti sono inclusi o abilitati sui nodi SQL Server:
- Windows Server (versione 2019 o successive).
- WSFC: Un gruppo di istanze SQL Server installate su più nodi del cluster Windows Server o su più subnet.
- Gruppo di disponibilità Always On: Un'alternativa di livello aziendale per l&#RE di emergenza al mirroring del database.
- Listener del gruppo di disponibilità: Un nome di rete virtuale (VNN) che i client possono utilizzare per accedere a un database in una replica primaria o secondaria di un gruppo di disponibilità Always On. I clienti non hanno bisogno di conoscere il nome dell'istanza fisica delle repliche. Poiché il listener instrada il traffico, la stringa di connessione client non deve essere modificata dopo un failover.
Per il deployment di questa architettura sono necessari i seguenti componenti aggiuntivi:
- Active Directory Domain Services: Un servizio di directory di Windows Server per la gestione di risorse comuni in un dominio, come computer, ruoli e utenti.
- DNS: Un server che risolve i nomi di dominio negli indirizzi IP corrispondenti.
- Testimone di quorum: può essere una condivisione file Server Message Block (SMB) o un disco condiviso collegato localmente.
Considerazioni sulla progettazione
Questa sezione descrive i fattori di progettazione, le best practice e i consigli di progettazione da prendere in considerazione quando utilizzi questa architettura di riferimento per sviluppare una topologia che soddisfi i tuoi requisiti di affidabilità, efficienza operativa, sicurezza, costi e prestazioni.
Affidabilità
Questa sezione descrive considerazioni e consigli di progettazione per creare e gestire un'infrastruttura affidabile per il deployment di SQL Server in Google Cloud.
Scegliere una strategia di HA e RE
Per eseguire il deployment di database SQL Server affidabili in Google Cloud, devi una strategia che combini l'infrastruttura solida di Google Cloud con le funzionalità di HA REDR di SQL Server. Questa combinazione protegge i tuoi database da errori che vanno dalle interruzioni a livello di zona ai disastri regionali.
Quando progetti la strategia di HA e RE per il deployment di SQL Server, considera i seguenti fattori:
- RPO: quanta perdita di dati è accettabile in caso di errore?
- Per ottenere un RPO basso (perdita di dati quasi nulla), utilizza un gruppo di disponibilità Always On con replica sincrona.
- Se puoi tollerare una certa perdita di dati, utilizza uno dei seguenti approcci: replica asincrona, servizio di Backup e DR, backup in un bucket Cloud Storage o log shipping.
- RTO: dopo un errore, quanto rapidamente deve tornare operativo il database?
- Per ottenere un RTO basso, utilizza un gruppo di disponibilità Always On.
- Se è accettabile un periodo di inattività, ripristina i database dai backup o utilizza la copia dei log con failover manuale.
- Budget: valuta i compromessi tra costo e affidabilità.
- Costo elevato ma affidabile: utilizza un gruppo di disponibilità Always On con replica asincrona in nodi aggiuntivi in una regione diRER. Pianifica infrastrutture e licenze ridondanti.
- Costo medio: implementa la replica asincrona dei dischi in un'altra regione o utilizza il servizio Backup e DR.
- Costo basso ma tempo di ripristino elevato: esegui il backup dei database in un bucket Cloud Storage multiregionale.
- Tipi di errori: quali tipi di errori devi gestire?
- Per gestire errori a livello di hardware, istanza e zona, puoi utilizzare i gruppi di disponibilità.
- Per il recupero da interruzioni o disastri a livello di sito, è necessaria una soluzione di RE distribuita geograficamente, come la spedizione dei log o i gruppi di disponibilità Always On con replica asincrona del database.
- Criticità aziendale: quanto è fondamentale l'applicazione per la tua attività?
- Le applicazioni mission-critical richiedono una strategia che fornisca il massimo livello di disponibilità, la minima perdita di dati e un ripristino rapido.
- Per i sistemi meno critici, valuta una strategia che preveda un tempo di inattività accettabile o una perdita di dati.
Utilizza il seguente questionario sul flusso decisionale per scegliere una strategia di affidabilità ottimale per il tuo database SQL Server. Le opzioni di strategia vanno da un gruppo di disponibilità Always On che fornisce una perdita di dati quasi nulla a un backup esterno conveniente.
- I backup esterni soddisfano i tuoi RPO e RTO?
- Sì: utilizza backup esterni o la spedizione dei log.
- No: procedi alla domanda successiva.
- Il tuo RTO o RPO è inferiore a un minuto?
- Sì (RPO quasi pari a zero): utilizza un gruppo di disponibilità Always On di SQL Server con una replica del database di RE.
- No: procedi alla domanda successiva.
- Qual è il tuo RTO?
- Meno di cinque minuti: utilizza un gruppo di disponibilità Always On di SQL Server con una replica asincrona del disco.
- Un'ora o più: procedi alla domanda successiva.
- Qual è il tuo RPO?
- Meno di due ore: utilizza un gruppo di disponibilità Always On di SQL Server con servizio di Backup e DR.
- Otto ore o più: utilizza i backup esterni o la spedizione dei log.
Scegliere le opzioni di backup appropriate
Se la tua strategia di affidabilità include i backup del database, scegli un metodo di backup che soddisfi i tuoi requisiti. Google Cloud offre le seguenti opzioni flessibili e pronte per l'uso aziendale per il backup dei database SQL Server:
- Backup diretto in un bucket Cloud Storage:
Scrivi i backup del database direttamente in Cloud Storage utilizzando il comando
BACKUP TO
URL
e il connettore S3 in SQL Server (versione 2022 o successive). Per gli ambienti di produzione, puoi utilizzare una chiave di accesso HMAC (Hash-based Message Authentication Code). Questa opzione di backup offre una protezione conveniente per database e log senza la necessità di spazio di archiviazione locale intermedio. - Snapshot istantanei di Compute Engine: acquisisci snapshot simultanei su più dischi (ad esempio su dischi Hyperdisk bilanciato) in meno di un secondo utilizzando le operazioni di blocco e sblocco di Transact-SQL (T-SQL) combinate con i gruppi di coerenza di Compute Engine. Questa opzione consente backup a livello di VM ad alte prestazioni per database multi-disco e ha un requisito di blocco della scrittura quasi nullo.
- Backup e DR: Orchestra gli snapshot coerenti con l'applicazione utilizzando provider Microsoft VSS e gruppi di coerenza. Questa opzione di backup è adatta quando hai bisogno di un recupero point-in-time (PITR) granulare e multi-database e della possibilità di utilizzare i log per ripristinare i database.
- Google Cloud NetApp Volumes: Crea snapshot istantanei e backup asincroni in vault remoti utilizzando il motore di archiviazione ONTAP. Consigliamo NetApp Volumes per le applicazioni aziendali sensibili alla latenza che richiedono una rapida mitigazione dei ransomware e cloni efficienti in termini di spazio.
Per i deployment multicloud e ibridi che richiedono criteri di protezione dei dati unificati, puoi scegliere un prodotto di backup di terze parti come Veeam, Veritas NetBackup o Cohesity.
Operazioni
Per garantire l'alta affidabilità e le prestazioni ottimali dei database SQL Server di cui è stato eseguito il deployment sulle VM di Compute Engine, configura un sistema completo di monitoraggio e avvisi utilizzando Cloud Monitoring e Cloud Logging.
- Monitora continuamente le metriche per le risorse principali, come l'utilizzo della CPU e il carico della memoria. Configura gli avvisi di base per rilevare la pressione sulle risorse prima che le query inizino a peggiorare.
- Per evitare interruzioni della scrittura del database, osserva continuamente l'utilizzo dello spazio su disco. Monitora lo stato generale del servizio e configura avvisi per ricevere notifiche quando i database si arrestano in modo imprevisto.
- Per le implementazioni ad alta disponibilità, monitora eventuali failover non pianificati e assicurati una visibilità completa durante gli eventi di disaster recovery automatizzati.
- Oltre alla telemetria a livello di sistema, Google Cloud fornisce una suite completa di metriche specifiche del database, come limiti di connessione degli utenti attivi, ritardo di replica e tassi di transazione. Monitora queste metriche per monitorare la disponibilità e le prestazioni dei tuoi database SQL Server.
- Per acquisire errori a livello di applicazione come deadlock, danneggiamento del database e errori dei job dell'agente direttamente dai log degli errori di SQL Server, configura avvisi personalizzati basati sui log in Logging.
Sicurezza
Questa sezione descrive le considerazioni e i consigli di progettazione per progettare un deployment di SQL Server in Google Cloud che soddisfi i requisiti di sicurezza del tuo workload.
Sicurezza e isolamento della rete
- Per impedire l'esposizione esterna dei database, esegui il deployment delle istanze SQL Server con indirizzi IP privati all'interno di un VPC. Utilizza l'accesso privato ai servizi per instradare il traffico internamente. Questo approccio contribuisce a garantire che il traffico del database non attraversi mai la rete internet pubblica.
- Limita ulteriormente l'accesso ai database configurando regole firewall VPC rigide che consentono il traffico solo da subnet dell'applicazione autorizzate o da blocchi CIDR specifici.
- Per proteggere i dati in transito da intercettazioni e intercettazioni, implementa la connettività criptata applicando TLS/SSL per tutte le connessioni al database.
Crittografia e controllo delle chiavi
- Per impostazione predefinita, Google Cloud utilizza chiavi AES-256 gestite da Google per criptare automaticamente tutti i dati a riposo in dischi di database, file temporanei e backup. Per rispettare gli ambienti di conformità, puoi implementare la crittografia a livello di database utilizzando la funzionalità di Transparent Data Encryption (TDE) di SQL Server.
- Per garantire la sovranità dei dati, puoi utilizzare le chiavi di crittografia gestite dal cliente (CMEK) in Cloud Key Management Service. Le chiavi CMEK ti offrono il controllo completo della crittografia. Gestisci i cicli di vita delle chiavi, imposta pianificazioni di rotazione automatica e revoca istantaneamente l'accesso al database e ai relativi backup quando necessario.
Autenticazione e autorizzazione
- Integra il tuo database con Microsoft Active Directory o centralizza la gestione delle identità nei tuoi database SQL Server e in altre risorseGoogle Cloud utilizzando Identity and Access Management (IAM).
- Una volta stabilite le identità, applica il principio del privilegio minimo in modo che gli utenti e gli account di servizio dell'applicazione dispongano solo delle autorizzazioni necessarie per svolgere le loro funzioni. Mappa le identità ai ruoli del database SQL Server granulari.
Ottimizzazione dei costi
Questa sezione fornisce indicazioni per ottimizzare il costo di configurazione e gestione di un deployment di SQL Server creato utilizzando questa architettura di riferimento. L'ottimizzazione dei costi contribuisce a garantire che il deployment soddisfi i requisiti di affidabilità e rendimento del tuo carico di lavoro entro i limiti di budget.
Prendi in considerazione i seguenti consigli:
- Disabilita il multi-threading simultaneo (SMT): disabilitando SMT, puoi ridurre del 50% il numero di core segnalato ai fini della licenza. Eseguendo il provisioning eccessivo delle CPU del 20% e disabilitando SMT, puoi ottenere risparmi sostanziali sui costi di licenza senza sacrificare le prestazioni. Per maggiori informazioni, vedi Imposta il numero di thread per core.
- Utilizza SQL Server Standard Edition: a seconda dei requisiti di HA e RE, puoi ridurre i costi di licenza utilizzando SQL Server Standard Edition anziché Enterprise Edition. Per ulteriori informazioni, consulta Versioni e funzionalità supportate di SQL Server.
- Ottimizza l'archiviazione: Hyperdisk offre diverse opzioni di disco che puoi scegliere in base alle esigenze del tuo deployment di SQL Server. Hyperdisk Balanced offre un equilibrio tra costi e rendimento. Puoi scalare la velocità effettiva e le operazioni di I/O al secondo (IOPS) in modo indipendente, in modo che la spesa per l'infrastruttura corrisponda esattamente alle esigenze del carico di lavoro. Per saperne di più, consulta la sezione Scegliere un tipo di disco di archiviazione appropriato.
Ottimizzazione delle prestazioni
Questa sezione descrive le considerazioni e i consigli di progettazione per un deployment di SQL Server che soddisfi i tuoi requisiti di rendimento.
Se esegui il deployment di SQL Server sulle VM Compute Engine, ottieni il controllo completo del database e dell'infrastruttura sottostante. Il rendimento del tuo carico di lavoro dipende dall'infrastruttura che scegli. Per bilanciare prestazioni, costi e affidabilità, devi prendere decisioni informate sulla famiglia di macchine VM e sul tipo di disco per i nodi del database.
Scegliere una famiglia di macchine VM appropriata
La famiglia di macchine che scegli per le VM di Compute Engine determina la potenza di elaborazione (vCPU) e la memoria (RAM) disponibili per i nodi SQL Server. Queste risorse influiscono sul rendimento dei tuoi database.
Scegli una famiglia di macchine VM che risolva il problema principale di prestazioni. Ad esempio, se il tuo database SQL Server è costantemente a un utilizzo elevato della CPU, scegli un tipo di macchina della famiglia di macchine ottimizzate per il calcolo. Se il tuo database SQL Server mostra letture lente dal disco, scegli un tipo di macchina ottimizzato per la memoria.
La seguente tabella confronta le famiglie di macchine VM fornite da Compute Engine, il caso d'uso principale per ciascuna famiglia di macchine e l'impatto sulle prestazioni dei database SQL Server:
| Famiglia e serie di macchine | Caso d'uso primario | Impatto sulle prestazioni di SQL Server |
|---|---|---|
| Per uso generico (serie di macchine N4) | Equilibrio tra prezzo e prestazioni | Utilizza questa famiglia di macchine come punto di partenza per la maggior parte dei workload. La serie di macchine N4 offre un equilibrio ottimale tra CPU e memoria per database a uso misto, applicazioni web e ambienti di sviluppo o test. |
| Ottimizzate per il calcolo (serie di macchine C3 o C4) | Massime prestazioni per core | Utilizza questa famiglia di macchine per i carichi di lavoro vincolati alla CPU. Per i database che eseguono query complesse, elaborano grandi volumi di dati o gestiscono un numero elevato di operazioni di elaborazione delle transazioni online (OLTP), utilizza le serie di macchine C3 e C4. I tipi di macchine di queste serie contribuiscono a ridurre in modo significativo il tempo di esecuzione delle query. |
| Ottimizzate per la memoria (serie di macchine M3 o M4) | Rapporti memoria/vCPU elevati | Questa famiglia di macchine è ideale per applicazioni che richiedono molta memoria. SQL Server memorizza nella cache i dati e i piani di esecuzione in memoria, il che offre prestazioni superiori rispetto alla lettura dai dischi. Con database o data warehouse molto grandi per l'elaborazione analitica online (OLAP), le query in genere analizzano tabelle e set di dati di grandi dimensioni. Per questi casi d'uso, una memoria più elevata contribuisce a migliorare le prestazioni. |
Per saperne di più, consulta la guida alle risorse e al confronto per le famiglie di macchine.
Scegli un tipo di disco di archiviazione appropriato
Le prestazioni del disco sono un fattore significativo per la reattività del database, che è fondamentale per le prestazioni dell'applicazione. Per i tipi di dischi offerti da Google Cloud, le funzionalità di rendimento sono indicate utilizzando le seguenti metriche:
- IOPS: il numero di richieste di lettura e scrittura che un disco può gestire al secondo. IOPS è fondamentale per i workload OLTP che comportano molte operazioni di lettura e scrittura piccole e casuali, come l'aggiornamento dei record dei clienti o l'elaborazione degli ordini.
- Velocità effettiva: la quantità totale di dati che può essere spostata sul disco o dal disco al secondo. La velocità effettiva è essenziale per i carichi di lavoro OLAP che comportano la scansione di grandi quantità di dati, ad esempio l'esecuzione di report, il data warehousing o l'esecuzione di backup.
La seguente tabella mette a confronto i tipi di disco Google Cloud tra cui puoi scegliere:
| Tipo di disco | Caratteristiche di rendimento | Idoneità del workload |
|---|---|---|
Disco permanente SSD (pd-ssd) |
Prestazioni da medie ad alte a seconda del tipo di macchina VM e delle dimensioni del disco | Workload che richiedono prestazioni scalabili in base alle dimensioni del disco e alle vCPU della VM. Per saperne di più, consulta Panoramica delle prestazioni di Persistent Disk. |
| Hyperdisk bilanciato | Prestazioni elevate con IOPS e velocità effettiva configurabili | File di dati e log di SQL Server di produzione. Hyperdisk bilanciato ti consente di configurare le IOPS e il throughput indipendentemente dalle dimensioni del disco e in base alle esigenze del workload. |
| Hyperdisk Extreme | Prestazioni molto elevate con IOPS configurabili | Workload OLTP mission-critical di fascia alta che richiedono il massimo IOPS e la latenza più bassa, come sistemi finanziari o di e-commerce su larga scala. |
| SSD locale | IOPS e velocità effettiva più elevate rispetto agli altri tipi di disco | Dati temporanei che non richiedono la durabilità dei dischi permanenti. Per
dati come il
database di sistema tempdb e il file di paging di Windows, gli SSD locali forniscono la latenza più bassa perché sono collegati fisicamente alle VM. |
Abbinare l'infrastruttura ai requisiti di prestazioni
Scegli i tipi di macchine VM e i tipi di dischi in base ai requisiti di prestazioni del tuo carico di lavoro. La tabella seguente consiglia configurazioni dell'infrastruttura per diversi scenari di workload:
| Scenario | Requisiti delle prestazioni | Tipo di macchina e configurazione del disco consigliati |
|---|---|---|
| Database e-commerce con un numero elevato di transazioni per l'elaborazione transazionale online (OLTP) | IOPS elevati per gestire migliaia di letture e scritture simultanee di piccole dimensioni |
Tipo di macchina VM: scegli un tipo di macchina ottimizzato per il calcolo (ad esempio della serie di macchine C4) per l'elaborazione efficiente delle transazioni. Dischi di dati e log: utilizza dischi Hyperdisk Balanced. Esegui il provisioning di un elevato livello di IOPS per soddisfare la domanda transazionale. Utilizza dischi separati per dati e log.
|
| Data warehouse aziendale per OLAP | Throughput elevato per analizzare e aggregare terabyte di dati per la generazione di report |
Tipo di macchina VM: scegli un tipo di macchina ottimizzato per la memoria (ad esempio della serie di macchine M4), in modo da poter memorizzare nella cache la maggior parte del set di dati di grandi dimensioni possibile. Disco di dati: utilizza dischi Hyperdisk bilanciati. Esegui il provisioning di un livello elevato di velocità effettiva per accelerare le scansioni di grandi quantità di dati. |
| Server di sviluppo o di staging | Convenienza economica anziché prestazioni di picco | Tipo di macchina VM: scegli un tipo di macchina per uso generico con una dimensione della macchina ridotta tra le serie di macchine E2 o N4. Dischi: utilizza Persistent Disk bilanciato
( |
Deployment
Per eseguire il deployment di questa architettura di riferimento, utilizza una delle seguenti risorse:
- Infrastructure as Code (IaC): utilizza una configurazione Terraform per eseguire il provisioning dei cluster SQL Server in Google Cloud. La configurazione include una configurazione dello stato desiderato (DSC) di PowerShell e script bash per configurare i componenti necessari. Puoi scaricare e modificare il codice in base alle tue esigenze di configurazione.
- Flusso di lavoro guidato: esegui il deployment di SQL Server in una configurazione a un solo nodo o in cluster utilizzando Workload Manager.
- Tutorial: segui le istruzioni passo passo per configurare i gruppi di disponibilità Always On di SQL Server con commit sincrono utilizzando un bilanciatore del carico interno.
Passaggi successivi
- Scopri di più sulle opzioni di licenza e immagine per SQL Server su Google Cloud.
- Consulta la guida alla pianificazione del disaster recovery.
- Scopri di più sul disaster recovery per Microsoft SQL Server.
- Scopri come eseguire il deployment di Microsoft SQL Server per il disaster recovery multiregionale.
- Scopri come condividere dischi tra istanze Compute Engine.
- Per ulteriori architetture di riferimento, diagrammi e best practice, esplora Cloud Architecture Center.
Collaboratori
Autori:
- Tom Niedzielak | Staff Systems Development Engineer
- Sung Baek | Software Engineer
Altro collaboratore: Kumar Dhanagopal | Cross-Product Solution Developer