


במסמך הזה מוצגת ארכיטקטורה לדוגמה של אפליקציה בכמה שכבות שפועלת במכונות וירטואליות של Compute Engine באזור אחד ב- Google Cloud. אתם יכולים להשתמש בארכיטקטורה הזו כדי להעביר (lift and shift) ביעילות אפליקציות מקומיות לענן, עם שינויים מינימליים באפליקציות. בנוסף, מתוארים במסמך הגורמים שצריך להביא בחשבון כשמתכננים ארכיטקטורה אזורית לאפליקציות בענן. המסמך הזה מיועד לאדריכלי ענן.
ארכיטקטורה
בתרשים הבא מוצגת ארכיטקטורה של אפליקציה שפועלת באזור אחד של Google Cloud . הארכיטקטורה הזו תואמת לGoogle Cloud ארכיטיפ של פריסה אזורית.
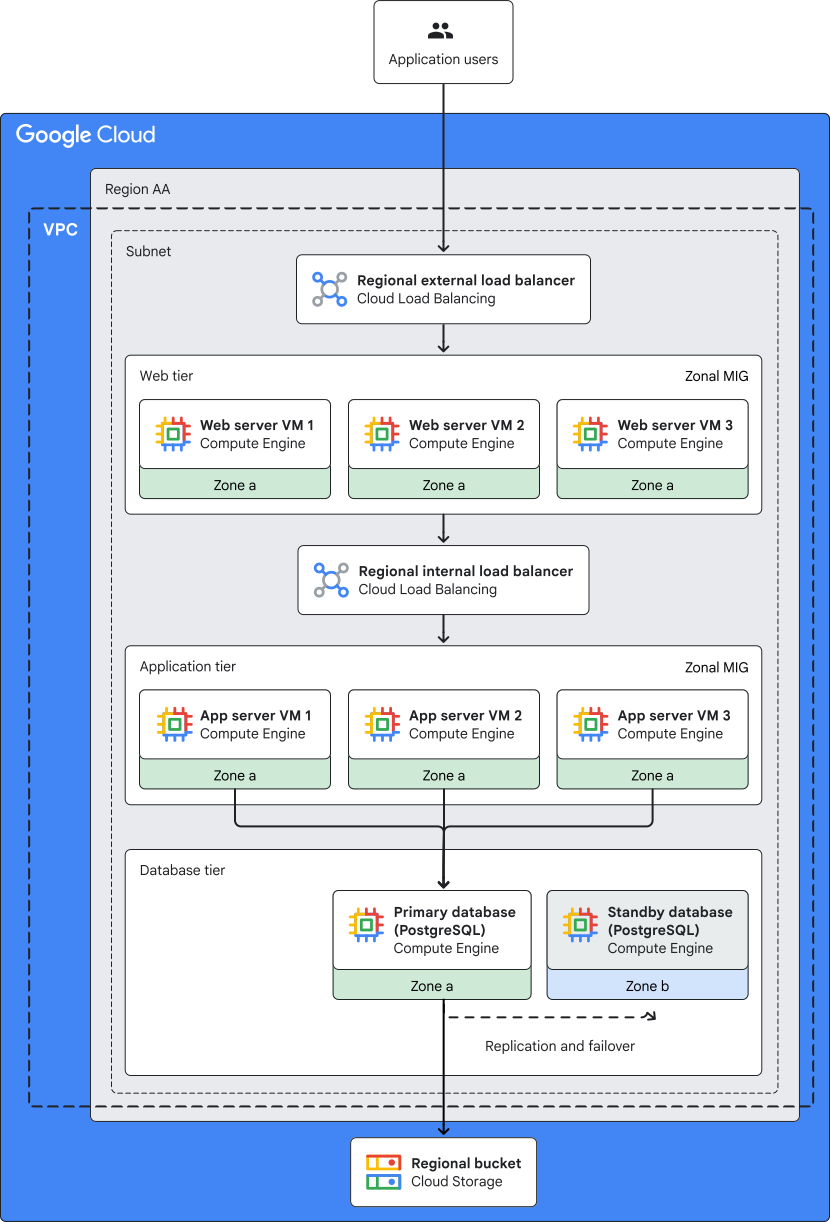
הארכיטקטורה מבוססת על מודל הענן "תשתית כשירות" (IaaS). אתם מקצים את משאבי התשתית הנדרשים (מחשוב, רשתות ואחסון) ב- Google Cloud. אתם שומרים על שליטה מלאה בתשתית, ואתם אחראים למערכת ההפעלה, לתוכנת התווך ולשכבות הגבוהות יותר של מחסנית האפליקציה. למידע נוסף על IaaS ומודלים אחרים של ענן, קראו את המאמר PaaS לעומת IaaS לעומת SaaS לעומת CaaS: מה ההבדלים?
התרשים שלמעלה כולל את הרכיבים הבאים:
| רכיב | מטרה |
|---|---|
| מאזן עומסים חיצוני אזורי |
מאזן העומסים החיצוני האזורי מקבל את בקשות המשתמשים ומפיץ אותן למכונות הווירטואליות של שכבת האינטרנט. |
| קבוצת מופעי מכונה מנוהלים (MIG) ברמת האזור לשכבת האינטרנט | שכבת האינטרנט של האפליקציה נפרסת במכונות וירטואליות של Compute Engine, שהן חלק מקבוצת MIG אזורית. ה-MIG הוא הבק-אנד של מאזן העומסים החיצוני האזורי. כל מכונה וירטואלית ב-MIG מארחת מכונה עצמאית של שכבת האינטרנט של האפליקציה. |
| מאזן עומסים פנימי אזורי |
מאזן העומסים הפנימי האזורי מחלק את התנועה מהמכונות הווירטואליות של שכבת האינטרנט למכונות הווירטואליות של שכבת האפליקציה. |
| קבוצת MIG אזורית לשכבת האפליקציה | שכבת האפליקציה פרוסה במכונות וירטואליות של Compute Engine שהן חלק מ-MIG של אזור, שהוא הקצה העורפי של מאזן העומסים הפנימי. כל מכונה וירטואלית ב-MIG מארחת מכונה עצמאית של שכבת האפליקציה. |
| מסד נתונים של צד שלישי שנפרס במכונה וירטואלית של Compute Engine |
הארכיטקטורה שמוצגת במאמר הזה כוללת מסד נתונים של צד שלישי (כמו PostgreSQL) שנפרס במכונה וירטואלית של Compute Engine. אתם יכולים לפרוס מסד נתונים במצב המתנה באזור אחר. יכולות השכפול ויתירות הכשל של מסד הנתונים תלויות במסד הנתונים שבו אתם משתמשים. התקנה וניהול של מסד נתונים של צד שלישי דורשים מאמץ נוסף ועלות תפעולית כדי להחיל עדכונים, לעקוב ולהבטיח זמינות. כדי להימנע מהתקורה של התקנה וניהול של מסד נתונים של צד שלישי, ולנצל את היתרונות של תכונות מובנות של זמינות גבוהה (HA), אתם יכולים להשתמש בשירות מנוהל של מסד נתונים כמו Cloud SQL או AlloyDB ל-PostgreSQL. למידע נוסף על אפשרויות של מסדי נתונים מנוהלים, קראו את המאמר שירותי מסדי נתונים. |
| רשת של ענן וירטואלי פרטי (VPC) ותת-רשת |
כל המשאבים של Google Cloud בארכיטקטורה משתמשים ברשת VPC אחת ובתת-רשת אחת. בהתאם לדרישות שלכם, אתם יכולים לבחור ליצור ארכיטקטורה שמשתמשת בכמה רשתות VPC או בכמה רשתות משנה. למידע נוסף, קראו את המאמר החלטה אם ליצור כמה רשתות VPC. |
| קטגוריה אזורית של Cloud Storage |
גיבויים של אפליקציות ומסדי נתונים מאוחסנים בקטגוריה אזורית של Cloud Storage. אם יש הפסקה זמנית בשירות באזור, האפליקציה והנתונים לא יאבדו. לחלופין, אתם יכולים להשתמש בשירות Backup and DR כדי ליצור, לאחסן ולנהל את הגיבויים של מסד הנתונים. |
המוצרים שהשתמשו בהם
ארכיטקטורת הייחוס הזו משתמשת במוצרי Google Cloud הבאים:
- Compute Engine: שירות מחשוב מאובטח שניתן להתאמה אישית, שמאפשר ליצור ולהריץ מכונות וירטואליות בתשתית של Google.
- Cloud Load Balancing: מגוון של מאזני עומסים גלובליים ואזוריים, עם ביצועים גבוהים ויכולת התאמה לעומס.
- Cloud Storage: מאגר אובייקטים ללא הגבלה ובעלות נמוכה, לסוגי נתונים שונים. אפשר לגשת לנתונים מתוך Google Cloudומחוץ לו, והם משוכפלים במיקומים שונים כדי ליצור יתירות.
- ענן וירטואלי פרטי (VPC): מערכת וירטואלית שמספקת פונקציונליות גלובלית וסקלאבילית של רשתות לעומסי העבודה ב- Google Cloud . רשת VPC כוללת את VPC Network Peering, Private Service Connect, גישה לשירותים פרטיים ו-VPC משותף.
תרחישים לדוגמה
בקטע הזה מתוארים תרחישים לדוגמה שבהם פריסה באזור יחיד ב-Compute Engine היא בחירה מתאימה.
- פיתוח ובדיקה בענן: אתם יכולים להשתמש בארכיטקטורת פריסה באזור יחיד כדי לבנות סביבת ענן בעלות נמוכה לפיתוח ולבדיקה.
- אפליקציות שלא זקוקות לזמינות גבוהה: ארכיטקטורה של אזור אחד עשויה להספיק לאפליקציות שיכולות לסבול זמן השבתה בגלל הפסקות בתשתית.
- רשתות בעלות נמוכה וזמן אחזור קצר בין רכיבי האפליקציה: ארכיטקטורה של אזור יחיד יכולה להתאים לאפליקציות כמו מחשוב באצווה, שדורשות חיבורי רשת עם זמן אחזור קצר ורוחב פס גבוה בין צומתי המחשוב. בפריסה באזור יחיד, אין תנועה ברשת בין אזורים שונים, ואין עלויות לתנועה בתוך האזור.
- העברה של עומסי עבודה מסחריים: ארכיטקטורת הפריסה האזורית מספקת נתיב העברה לענן של אפליקציות מסחריות מקומיות, שאין לכם שליטה על הקוד שלהן או שהן לא יכולות לתמוך בארכיטקטורות מעבר לטופולוגיה בסיסית של פעיל-סביל.
- הפעלת תוכנה עם רישיון מוגבל: ארכיטקטורה של אזור יחיד עשויה להתאים למערכות עם רישיון מוגבל, שבהן הפעלה של יותר ממכונה אחת בכל פעם היא יקרה מדי או אסורה.
שיקולים בתכנון
בקטע הזה מוסבר איך להשתמש בארכיטקטורה לדוגמה כדי לפתח ארכיטקטורה שעומדת בדרישות הספציפיות שלכם בנוגע לתכנון המערכת, לאבטחה, לאמינות, ליעילות התפעולית, לעלות ולביצועים.
כשאתם בונים את הארכיטקטורה של עומס העבודה, כדאי להביא בחשבון את השיטות המומלצות וההמלצות שמפורטות ב-Google Cloud Well-Architected Framework.
עיצוב המערכת
בקטע הזה מוסבר איך לבחור אזורים ותחומים לפריסה לפי תחום, ואיך לבחור את שירותי Google Cloudהמתאימים. Google Cloud
בחירת אזור
כשבוחרים את Google Cloud האזורים שבהם צריך לפרוס את האפליקציות, צריך להביא בחשבון את הגורמים והדרישות הבאים:
- זמינות השירותים של Google Cloud בכל אזור. בטבלה של זמינות המוצרים לפי מיקום תוכלו לקרוא מידע נוסף.
- זמינות של סוגי מכונות ב-Compute Engine בכל אזור. למידע נוסף, קראו את המאמר אזורים ותחומים.
- דרישות זמן אחזור של משתמשי קצה.
- עלות המשאבים של Google Cloud .
- עלויות העברת נתונים בין אזורים.
- דרישות רגולטוריות.
- דרישות בנושא קיימוּת.
חלק מהגורמים והדרישות האלה עשויים להיות כרוכים בפשרות. לדוגמה, יכול להיות שהאזור הכי משתלם מבחינת עלות הוא לא האזור עם טביעת הרגל הפחמנית הכי נמוכה. שיטות מומלצות לבחירת אזורים ב-Compute Engine
תשתית מחשוב
בארכיטקטורה לדוגמה שבמסמך הזה, נעשה שימוש במכונות וירטואליות של Compute Engine בשכבות מסוימות של האפליקציה. בהתאם לדרישות של האפליקציה, אתם יכולים לבחור מבין שירותי המחשוב האחרים של Google Cloud :
- קונטיינרים: אתם יכולים להריץ אפליקציות בקונטיינרים באשכולות של Google Kubernetes Engine (GKE). GKE הוא מנוע לתזמור קונטיינרים, שמאפשר לבצע אוטומציה של פריסה, התאמה לעומס וניהול של אפליקציות בקונטיינרים.
- בלי שרת (serverless): אם אתם מעדיפים להתמקד בנתונים ובאפליקציות במקום להגדיר ולהפעיל משאבי תשתית, אתם יכולים להשתמש בשירותים בלי שרת (serverless) כמו Cloud Run.
ההחלטה אם להשתמש במכונות וירטואליות, בקונטיינרים או בשירותים בלי שרת (serverless) כרוכה בפשרה בין הגמישות בהגדרה לבין מאמצי הניהול. מכונות וירטואליות ומאגרים מספקים גמישות רבה יותר בהגדרות האישיות, אבל אתם אחראים לניהול המשאבים. בארכיטקטורה בלי שרת (serverless), אתם פורסים עומסי עבודה בפלטפורמה שהוגדרה מראש ודורשת מאמץ ניהולי מינימלי. במאמר אירוח אפליקציות ב- Google Cloud מוסבר איך לבחור את שירותי המחשוב המתאימים לעומסי העבודה ב-Google Cloud.
שירותי אחסון
הארכיטקטורה שמוצגת במסמך הזה משתמשת באמצעי אחסון של Persistent Disk אזוריים לכל הרמות. כדי להשתמש באחסון מתמיד עמיד יותר, אתם יכולים להשתמש באמצעי אחסון אזוריים של Persistent Disk, שמספקים שכפול סינכרוני של נתונים בשני אזורים בתוך מחוז.
Google Cloud Hyperdisk מספק ביצועים, גמישות ויעילות טובים יותר מאשר Persistent Disk. באמצעות Google Cloud Hyperdisk Balanced, אתם יכולים להקצות פעולות קלט/פלט לשנייה (IOPS) ונפח עיבוד נתונים בנפרד ובאופן דינמי, וכך להתאים את הנפח למגוון רחב של עומסי עבודה.
כדי לאחסן בעלות נמוכה עם שכפול במספר מיקומים, אתם יכולים להשתמש בקטגוריות של Cloud Storage באזור אחד, בשני אזורים או במספר אזורים.
- הנתונים בקטגוריות אזוריות משוכפלים באופן סינכרוני בין האזורים באותו אזור.
- נתונים בקטגוריות של שני אזורים או של מספר אזורים מאוחסנים ביתירות בשני מיקומים גיאוגרפיים נפרדים לפחות. המטא-נתונים נכתבים באופן סינכרוני בין אזורים, והנתונים משוכפלים באופן אסינכרוני. בקטגוריות בשני אזורים אפשר להשתמש ברפליקציה בקצב טורבו, כדי לוודא שהאובייקטים משוכפלים בין זוגות של אזורים, עם יעד להתאוששות מאסון (RPO) של 15 דקות. למידע נוסף, ראו זמינות ועמידות של נתונים.
כדי לאחסן נתונים שמשותפים בין כמה מכונות וירטואליות באזור, כמו בכל המכונות הווירטואליות בשכבת האינטרנט או בשכבת האפליקציה, אתם יכולים להשתמש במכונה אזורית של Filestore. הנתונים שאתם מאחסנים במכונה אזורית של Filestore משוכפלים באופן סינכרוני בשלושה אזורים בתוך האזור. הרפליקציה הזו מבטיחה זמינות גבוהה ועמידות בפני הפסקות זמניות בשירות באזורים. אתם יכולים לאחסן קובצי תצורה משותפים, כלים וכלים שירות נפוצים ויומנים מרכזיים במכונה של Filestore, ולטעון את המכונה בכמה מכונות וירטואליות. כדי להגן מפני הפסקות חשמל באזור, אתם יכולים לשכפל מכונה של Filestore לאזור אחר. מידע נוסף זמין במאמר רפליקציה של מכונות.
אם מסד הנתונים שלכם הוא Microsoft SQL Server, מומלץ להשתמש ב-Cloud SQL ל-SQL Server. אם Cloud SQL לא תומך בדרישות ההגדרה שלכם, או אם אתם צריכים גישה למערכת ההפעלה, אתם יכולים לפרוס מכונה של אשכול יתירות כשל (FCI) של Microsoft SQL Server. בתרחיש הזה, אתם יכולים להשתמש ב-Google Cloud NetApp Volumes בניהול מלא כדי לספק למסד הנתונים אחסון SMB בזמינות רציפה (CA).
כשאתם מתכננים את האחסון לעומסי העבודה, כדאי להביא בחשבון את המאפיינים הפונקציונליים, את דרישות העמידות, את הציפיות לגבי הביצועים ואת יעדי העלות. מידע נוסף זמין במאמר תכנון אסטרטגיית אחסון אופטימלית לעומסי העבודה בענן.
שירותי מסדי נתונים
ארכיטקטורת העזר במסמך הזה משתמשת במסד נתונים של צד שלישי שפרוס במכונות וירטואליות של Compute Engine. התקנה וניהול של מסד נתונים של צד שלישי כרוכים במאמץ ובעלויות של פעולות כמו החלת עדכונים, מעקב והבטחת זמינות, ביצוע גיבויים והתאוששות מכשלים.
כדי לחסוך את המאמץ והעלות של התקנה וניהול של מסד נתונים של צד שלישי, אתם יכולים להשתמש בשירות מנוהל של מסד נתונים כמו Cloud SQL, AlloyDB ל-PostgreSQL, Bigtable, Spanner או Firestore. שירותי Google Cloud מסדי הנתונים האלה מספקים הסכמי רמת שירות (SLA) לזמן פעולה תקינה, והם כוללים יכולות ברירת מחדל למדרגיות וליכולת תצפית.
אם עומס העבודה שלכם צריך מסד נתונים של Oracle, אתם יכולים לפרוס את מסד הנתונים במכונה וירטואלית של Compute Engine או להשתמש ב-Oracle Database@Google Cloud. מידע נוסף זמין במאמר עומסי עבודה של Oracle ב- Google Cloud.
עיצוב הרשת
בוחרים עיצוב רשת שעונה על הדרישות העסקיות והטכניות שלכם. אפשר להשתמש ברשת VPC אחת או בכמה רשתות VPC. מידע נוסף זמין במשאבי העזרה הבאים:
אבטחה, פרטיות ותאימות
בקטע הזה מתוארים הגורמים שצריך להביא בחשבון כשמשתמשים בארכיטקטורה לדוגמה הזו כדי לתכנן ולבנות טופולוגיה אזורית ב-Google Cloud שעומדת בדרישות האבטחה והתאימות של עומסי העבודה שלכם.
הגנה מפני איומים חיצוניים
כדי להגן על האפליקציה מפני איומים כמו התקפות מניעת שירות מבוזרות (DDoS) ופרצות אבטחה XSS (cross-site scripting), אתם יכולים להשתמש בכללי מדיניות האבטחה של Google Cloud Armor. כל מדיניות היא קבוצה של כללים שמציינים תנאים מסוימים שצריך להעריך, ופעולות שצריך לבצע כשהתנאים מתקיימים. לדוגמה, כלל יכול לציין שאם כתובת ה-IP של המקור של התנועה הנכנסת תואמת לכתובת IP ספציפית או לטווח CIDR, צריך לדחות את התנועה. אפשר גם להחיל כללים מוגדרים מראש של חומת אש ליישומי אינטרנט (WAF). מידע נוסף זמין במאמר סקירה כללית של מדיניות האבטחה.
גישה חיצונית למכונות וירטואליות
בארכיטקטורה לדוגמה שמתוארת במאמר הזה, המכונות הווירטואליות של Compute Engine לא צריכות גישה נכנסת מהאינטרנט. אל תקצו כתובות IP חיצוניות למכונות הווירטואליות. Google Cloud משאבים שיש להם רק כתובת IP פנימית פרטית עדיין יכולים לגשת לממשקי API ולשירותים מסוימים של Google באמצעות Private Service Connect או גישה פרטית ל-Google. מידע נוסף זמין במאמר אפשרויות גישה פרטיות לשירותים.
כדי לאפשר חיבורים יוצאים מאובטחים ממשאבי Google Cloud שיש להם רק כתובות IP פרטיות, כמו המכונות הווירטואליות של Compute Engine בארכיטקטורה לדוגמה, אתם יכולים להשתמש ב-Secure Web Proxy או ב-Cloud NAT.
הרשאות של חשבון שירות
במכונות הווירטואליות של Compute Engine בארכיטקטורה, במקום להשתמש בחשבונות השירות שמוגדרים כברירת מחדל, מומלץ ליצור חשבונות שירות ייעודיים ולציין את המשאבים שחשבון השירות יכול לגשת אליהם. לחשבון השירות שמוגדר כברירת מחדל יש מגוון רחב של הרשאות, כולל כאלה שלא בהכרח נדרשות. אתם יכולים להתאים אישית חשבונות שירות ייעודיים כך שיהיו להם רק ההרשאות החיוניות. מידע נוסף מופיע במאמר הגבלת ההרשאות של חשבון שירות.
אבטחת SSH
כדי לשפר את האבטחה של חיבורי SSH למכונות הווירטואליות של Compute Engine בארכיטקטורה, צריך להטמיע את Identity-Aware Proxy (IAP) ואת Cloud OS Login API. באמצעות IAP אפשר לשלוט בגישה לרשת על סמך זהות המשתמש וכללי המדיניות של ניהול זהויות והרשאות גישה (IAM). באמצעות Cloud OS Login API אפשר לשלוט בגישת SSH ל-Linux על סמך זהות המשתמש ומדיניות IAM. מידע נוסף על ניהול הגישה לרשת זמין במאמר שיטות מומלצות לשליטה בגישה להתחברות באמצעות SSH.
אבטחת רשת
כדי לשלוט בתנועה ברשת בין המשאבים בארכיטקטורה, צריך להגדיר כללי מדיניות מתאימים של Cloud Next Generation Firewall (NGFW).
כל כלל של חומת אש מאפשר לכם לשלוט בתעבורת הנתונים על סמך פרמטרים כמו הפרוטוקול, כתובת ה-IP והיציאה. לדוגמה, אתם יכולים להגדיר כלל של חומת אש שמאפשר תעבורת TCP מהמכונות הווירטואליות של שרת האינטרנט ליציאה ספציפית של המכונות הווירטואליות של מסד הנתונים, וחוסם את כל שאר תעבורת הנתונים.
שיקולי אבטחה נוספים
כשאתם בונים את הארכיטקטורה של עומס העבודה, כדאי להביא בחשבון את השיטות המומלצות וההמלצות לאבטחה ברמת הפלטפורמה שמפורטות בתוכנית לניהול יסודות הארגון ובGoogle Cloud Well-Architected Framework: אבטחה, פרטיות ותאימות.
אמינות
בקטע הזה מתוארים גורמי תכנון שכדאי להביא בחשבון כשמשתמשים בארכיטקטורה לדוגמה הזו כדי לבנות ולהפעיל תשתית אמינה לפריסות אזוריות ב- Google Cloud.
עמידות בפני הפסקות בתשתית
בארכיטקטורת פריסה באזור יחיד, אם רכיב כלשהו במקבץ התשתית נכשל, האפליקציה יכולה לעבד בקשות אם כל שכבה מכילה לפחות רכיב אחד שפועל עם קיבולת מספקת. לדוגמה, אם מופע של שרת אינטרנט נכשל, מאזן העומסים מעביר את בקשות המשתמשים למופעים זמינים אחרים של שרת האינטרנט. אם מכונה וירטואלית שמארחת שרת אינטרנט או מופע של שרת אפליקציות קורסת, ה-MIG יוצר מחדש את המכונה הווירטואלית באופן אוטומטי. אם מסד הנתונים קורס, צריך להפעיל ידנית את מסד הנתונים השני ולעדכן את המכונות של שרת האפליקציה כדי להתחבר למסד הנתונים.
הפסקה זמנית בשירות בתחום או באזור משפיעה על כל המכונות הווירטואליות של Compute Engine בפריסה בתחום יחיד. הפסקת פעילות בתחום לא משפיעה על מאזן העומסים בארכיטקטורה הזו, כי הוא משאב אזורי. עם זאת, מאזן העומסים לא יכול להפיץ את התנועה כי אין שרתי בק-אנד זמינים. אם מתרחשת הפסקה זמנית בשירות באזור או בתחום, צריך להמתין עד ש-Google תפתור את הבעיה, ואז לוודא שהאפליקציה פועלת כצפוי.
כדי לצמצם את זמן ההשבתה שנגרם בגלל הפסקות זמניות בשירות באזור או במחוז, אתם יכולים להחזיק רפליקה פסיבית (יתירות כשל) של מחסנית התשתית באזור או במחוז אחר שלGoogle Cloud . אם יש הפסקה זמנית בשירות באזור הראשי, אתם יכולים להפעיל את המקבץ באזור של יתירות הכשל, ולהשתמש במדיניות ניתוב של DNS כדי לנתב את התנועה למאזן העומסים באזור של יתירות הכשל.
לאפליקציות שצריכות להיות עמידות בפני הפסקות שירות בתחום או באזור, כדאי להשתמש בארכיטקטורה אזורית או בארכיטקטורה במספר אזורים. אפשר לעיין בארכיטקטורות לדוגמה הבאות:
התאמה לעומס (autoscaling) ב-MIG
היכולת של קבוצות MIG ללא שמירת מצב לשנות את קנה המידה באופן אוטומטי מאפשרת לשמור על הזמינות והביצועים של האפליקציה ברמות צפויות.
כדי לשלוט בהתנהגות של ההתאמה האוטומטית לעומס של קבוצות MIG בלי שמירת מצב, אפשר לציין מדדי ניצול יעד, כמו ניצול ממוצע של המעבד (CPU). אפשר גם להגדיר התאמה אוטומטית לעומס לפי לוח זמנים לקבוצות MIG בלי שמירת מצב. אי אפשר לשנות את קנה המידה של קבוצות MIG עם שמירת מצב באופן אוטומטי. מידע נוסף מופיע במאמר התאמה אוטומטית לעומס (autoscaling) של קבוצות מכונות.
מגבלת הגודל של קבוצת MIG
כשמחליטים על הגודל של קבוצות ה-MIG, צריך להביא בחשבון את מגבלות ברירת המחדל והמגבלות המקסימליות על מספר המכונות הווירטואליות שאפשר ליצור בקבוצת MIG. מידע נוסף זמין במאמר הוספה והסרה של מכונות וירטואליות מ-MIG.
תיקון אוטומטי של VM
לפעמים המכונות הווירטואליות שמארחות את האפליקציה פועלות וזמינות, אבל יש בעיות באפליקציה עצמה. האפליקציה עלולה לקפוא, לקרוס או לא לקבל מספיק זיכרון. כדי לוודא שאפליקציה מגיבה כצפוי, אפשר להגדיר בדיקות תקינות שמבוססות על אפליקציות כחלק ממדיניות התיקון האוטומטי של קבוצות ה-MIG. אם האפליקציה במכונה וירטואלית מסוימת לא מגיבה, ה-MIG מתקן את המכונה הווירטואלית באופן אוטומטי. מידע נוסף על הגדרת תיקון אוטומטי זמין במאמר תיקון מכונות וירטואליות לזמינות גבוהה.
מיקום ה-VM
בארכיטקטורה שמתוארת במסמך הזה, שכבת האפליקציה ושכבת האינטרנט פועלות במכונות וירטואליות של Compute Engine באזור אחד.
כדי לשפר את העמידות של הארכיטקטורה, אתם יכולים ליצור מדיניות למיקום מרווח ולהחיל אותה על התבנית של ה-MIG. כשה-MIG יוצר מכונות וירטואליות, הוא ממקם אותן בכל אזור בשרתים פיזיים שונים (שנקראים מארחים), כך שהמכונות הווירטואליות עמידות בפני כשלים של מארחים ספציפיים. מידע נוסף זמין במאמר יצירה והחלה של מדיניות למיקום מרווח במכונות וירטואליות.
תכנון קיבולת של מכונות וירטואליות
כדי לוודא שהקיבולת של המכונות הווירטואליות ב-Compute Engine זמינה כשצריך להקצות אותן, אתם יכולים ליצור מקומות שמורים. הזמנה מספקת קיבולת מובטחת באזור ספציפי למספר מסוים של מכונות וירטואליות מסוג מכונה שאתם בוחרים. אפשר להגדיר מקום שמור לפרויקט ספציפי, או לשתף אותו בין כמה פרויקטים. למידע נוסף על הזמנות, ראו בחירת סוג הזמנה.
אחסון עם שמירת מצב (stateful)
אחת מהשיטות המומלצות בתכנון אפליקציות היא להימנע מהצורך בדיסקים מקומיים עם שמירת מצב (stateful). אבל אם יש דרישה כזו, אתם יכולים להגדיר את הדיסקים הקבועים כ-stateful כדי לוודא שהנתונים יישמרו כשהמכונות הווירטואליות יתוקנו או ייווצרו מחדש. עם זאת, מומלץ להשאיר את דיסקי האתחול בלי שמירת מצב, כדי שתוכלו לעדכן אותם לתמונות העדכניות ביותר עם גרסאות חדשות ותיקוני אבטחה. מידע נוסף זמין במאמר הגדרת דיסקים קבועים עם שמירת מצב בקבוצות MIG.
עמידות הנתונים
אתם יכולים להשתמש בשירות Backup and DR כדי ליצור, לאחסן ולנהל גיבויים של מכונות וירטואליות ב-Compute Engine. Backup and DR מאחסן את נתוני הגיבוי בפורמט המקורי שלהם, שניתן לקריאה על ידי האפליקציה. במקרה הצורך, אתם יכולים לשחזר את עומסי העבודה לסביבת הייצור באמצעות שימוש ישיר בנתונים ממאגר הגיבוי לטווח ארוך, בלי להכין או להעביר את הנתונים.
ב-Compute Engine יש כמה אפשרויות שיעזרו לכם לוודא את עמידות הנתונים שמאוחסנים בנפחים של Persistent Disk:
- אתם יכולים להשתמש בתמונות מצב כדי לתעד את המצב של דיסקים לאחסון מתמיד בנקודת זמן מסוימת. תמונות המצב מאוחסנות באופן יתיר בכמה אזורים, עם סיכומי ביקורת (checksum) אוטומטיים כדי להבטיח את תקינות הנתונים. כברירת מחדל, קובצי snapshot הם מצטברים, ולכן הם תופסים פחות מקום באחסון וחוסכים לכם כסף. תמונות המצב מאוחסנות במיקום ב-Cloud Storage שאפשר להגדיר. המלצות נוספות לשימוש בתמונות מצב ולניהול שלהן זמינות במאמר שיטות מומלצות לתמונות מצב של דיסקים ב-Compute Engine.
- כדי לוודא שהנתונים ב-Persistent Disk יהיו זמינים גם אם תהיה הפסקה זמנית בשירות באזור, אתם יכולים להשתמש ב-Regional Persistent Disk או ב-Google Cloud Hyperdisk Balanced High Availability. הנתונים בסוגי הדיסקים האלה משוכפלים באופן סינכרוני בין שני אזורים באותו מחוז. מידע נוסף זמין במאמר מידע על שכפול דיסקים סינכרוני.
זמינות מסד הנתונים
אם אתם משתמשים בשירות מנוהל של מסד נתונים כמו Cloud SQL בהגדרת HA, במקרה של כשל במסד הנתונים הראשי, Cloud SQL עובר אוטומטית למסד הנתונים במצב המתנה. אין צורך לשנות את כתובת ה-IP של נקודת הקצה של מסד הנתונים. אם אתם משתמשים במסד נתונים של צד שלישי בניהול עצמי שפרוס במכונה וירטואלית של Compute Engine, אתם צריכים להשתמש במאזן עומסים פנימי או במנגנון אחר כדי לוודא שהאפליקציה יכולה להתחבר למסד נתונים אחר אם מסד הנתונים הראשי לא זמין.
כדי להטמיע יתירות כשל בין אזורים במסד נתונים שפרוס במכונה וירטואלית ב-Compute Engine, צריך מנגנון לזיהוי כשלים במסד הנתונים הראשי ותהליך להעברת הנתונים למסד הנתונים החלופי. הפרטים הספציפיים של מנגנון יתירות הכשל תלויים במסד הנתונים שבו אתם משתמשים. אתם יכולים להגדיר מכונה של משקיף כדי לזהות כשלים במסד הנתונים הראשי ולתזמר את יתירות הכשל. כדי למנוע מצב של פיצול מוח ויתירות כשל מיותרת, צריך להגדיר את כללי יתירות הכשל בצורה מתאימה. במאמר ארכיטקטורות לזמינות גבוהה של אשכולות PostgreSQL ב-Compute Engine תוכלו למצוא דוגמאות לארכיטקטורות שבהן אפשר להשתמש כדי להטמיע יתירות כשל במסדי נתונים של PostgreSQL.
שיקולים נוספים בנושא אמינות
כשאתם בונים את ארכיטקטורת הענן לעומס העבודה, כדאי לעיין בשיטות המומלצות ובהמלצות שקשורות לאמינות, שמפורטות במסמכים הבאים:
- Google Cloud מדריך לאמינות התשתית
- תבניות לאפליקציות עמידות שניתנות להרחבה
- תכנון מערכות חסינות
- Google Cloud Well-Architected Framework: אמינות
הוזלת עלויות
בקטע הזה מוסבר איך לבצע אופטימיזציה של עלות ההגדרה וההפעלה של טופולוגיה אזורית של Google Cloud , שאתם בונים באמצעות ארכיטקטורת העזר הזו.
סוגי מכונות וירטואליות
כדי לעזור לכם לשפר את ניצול המשאבים של המכונות הווירטואליות, Compute Engine מספק המלצות לסוגי מכונות. אתם יכולים להשתמש בהמלצות כדי לבחור סוגי מכונות שמתאימים לדרישות המחשוב של עומס העבודה. אם אתם יכולים לחזות את דרישות המשאבים של עומסי העבודה, אתם יכולים להתאים אישית את סוג המכונה לצרכים שלכם ולחסוך כסף באמצעות סוגי מכונות בהתאמה אישית.
מודל הקצאת המשאבים של המכונה הווירטואלית
אם האפליקציה שלכם עמידה בפני תקלות, מכונות וירטואליות במחיר Spot יכולות לעזור לכם להפחית את העלויות של Compute Engine למכונות הווירטואליות בשכבות האפליקציה והאינטרנט. העלות של VM במודל Spot נמוכה משמעותית מזו של מכונות וירטואליות רגילות. עם זאת, יכול להיות ש-Compute Engine יפסיק או ימחק מכונות VM במודל Spot כדי לפנות קיבולת.
VM במודל Spot מתאימות למשימות באצווה שיכולות לסבול הפסקה זמנית, ואין להן דרישות גבוהות לזמינות גבוהה. VM במודל Spot מציעות את אותם סוגי מכונות, אפשרויות וביצועים כמו מכונות וירטואליות רגילות. עם זאת, כשהקיבולת של המשאבים באזור מסוים מוגבלת, יכול להיות שקבוצות ה-MIG לא יוכלו להתרחב באופן אוטומטי (כלומר, ליצור מכונות וירטואליות) לגודל היעד שצוין עד שהקיבולת הנדרשת תהיה זמינה שוב.
ניצול המשאבים של המכונה הווירטואלית
היכולת של קבוצות MIG ללא שמירת מצב להתאמה אוטומטית לעומס מאפשרת לאפליקציה להתמודד עם עליות בתעבורת נתונים בצורה חלקה, ועוזרת לכם להפחית את העלויות כשהצורך במשאבים נמוך. אי אפשר לשנות את קנה המידה של קבוצות MIG עם שמירת מצב באופן אוטומטי.
רישוי של צד שלישי
כשמעבירים עומסי עבודה של צד שלישי אל Google Cloud, יכול להיות שאפשר להוזיל את העלויות באמצעות רישיונות קיימים (BYOL). לדוגמה, כדי לפרוס מכונות וירטואליות של Microsoft Windows Server, במקום להשתמש בקובץ אימג' פרימיום שגורר עלות נוספת על הרישיון של הצד השלישי, אתם יכולים ליצור קובץ אימג' בהתאמה אישית של Windows BYOL ולהשתמש בו. אחרי זה, אתם משלמים רק על תשתית ה-VM שבה אתם משתמשים ב- Google Cloud. האסטרטגיה הזו עוזרת לכם להמשיך להפיק ערך מההשקעות הקיימות שלכם ברישיונות של צד שלישי. אם החלטתם להשתמש בגישת BYOL, ההמלצות הבאות יכולות לעזור לכם להוזיל את העלויות:
- להקצות את המספר הנדרש של ליבות מעבד (CPU) לחישוב, בלי קשר לזיכרון, באמצעות סוגי מכונות בהתאמה אישית. כך אתם מגבילים את עלות הרישוי של הצד השלישי למספר ליבות המעבד שאתם צריכים.
- להשבית את הריבוי-תהליכים בו-זמני (SMT) כדי להפחית את מספר המעבדים הווירטואליים לכל ליבה מ-2 ל-1.
אם אתם פורסים מסד נתונים של צד שלישי, כמו Microsoft SQL Server, במכונות וירטואליות של Compute Engine, אתם צריכים להביא בחשבון את עלויות הרישיון של תוכנת הצד השלישי. כשמשתמשים בשירות של מסד נתונים מנוהל כמו Cloud SQL, עלויות הרישיון של מסד הנתונים כלולות בחיובים על השירות.
שיקולי עלות נוספים
כשאתם בונים את הארכיטקטורה של עומס העבודה, כדאי גם להביא בחשבון את השיטות המומלצות הכלליות ואת ההמלצות שמפורטות במאמר Google Cloud Well-Architected Framework: הוזלת העלויות.
יעילות תפעולית
בקטע הזה מתוארים הגורמים שצריך להביא בחשבון כשמשתמשים בארכיטקטורה לדוגמה כדי לתכנן ולבנות טופולוגיה של Google Cloud באזור, שאפשר להפעיל ביעילות.
עדכונים בהגדרות של המכונה הווירטואלית
כדי לעדכן את ההגדרות של המכונות הווירטואליות בקבוצת MIG (למשל, סוג המכונה או קובץ האימג' של דיסק האתחול), יוצרים תבנית חדשה של הגדרות מכונה עם ההגדרות הנדרשות, ואז מחילים את התבנית החדשה על קבוצת ה-MIG. ה-MIG מעדכן את המכונות הווירטואליות באמצעות שיטת העדכון שבחרתם: אוטומטית או סלקטיבית. בחרו שיטה מתאימה בהתאם לדרישות שלכם לגבי זמינות ויעילות תפעולית. למידע נוסף על השיטות האלה לעדכון קבוצות MIG, קראו את המאמר החלת הגדרות חדשות של מכונות וירטואליות בקבוצת MIG.
תמונות של מכונות וירטואליות
במקום להשתמש בקובצי אימג' ציבוריים של Google למכונות הווירטואליות, מומלץ ליצור ולהשתמש בקובצי אימג' בהתאמה אישית של מערכת ההפעלה, שמכילים את ההגדרות והתוכנות שהאפליקציות שלכם צריכות. אתם יכולים לקבץ את קובצי האימג' בהתאמה אישית למשפחה של קובצי אימג' בהתאמה אישית. משפחת תמונות תמיד מפנה לתמונה העדכנית ביותר במשפחה, כך שתבניות של הגדרות מכונה וסקריפטים יכולים להשתמש בתמונה הזו בלי שתצטרכו לעדכן הפניות לגרסת תמונה ספציפית. צריך לעדכן באופן קבוע את קובצי האימג' בהתאמה אישית כדי לכלול את עדכוני האבטחה והתיקונים שמספק ספק מערכת ההפעלה.
תבניות דטרמיניסטיות של הגדרות מכונה
אם התבניות של הגדרות המכונה שבהן אתם משתמשים בקבוצות ה-MIG כוללות סקריפטים לטעינה בזמן ההפעלה כדי להתקין תוכנת צד שלישי, ודאו שהסקריפטים מציינים במפורש את הפרמטרים של התקנת התוכנה, כמו גרסת התוכנה. אחרת, כשה-MIG יוצר את המכונות הווירטואליות, יכול להיות שהתוכנה שמותקנת במכונות הווירטואליות לא תהיה עקבית. לדוגמה, אם תבנית של הגדרות מכונה כוללת סקריפט לטעינה בזמן ההפעלה להתקנת Apache HTTP Server 2.4 (החבילה apache2), צריך לוודא שהסקריפט מציין את הגרסה המדויקת של apache2 שצריך להתקין, כמו גרסה 2.4.69. מידע נוסף זמין במאמר תבניות דטרמיניסטיות של הגדרות מכונה.
שיקולים תפעוליים נוספים
כשאתם בונים את הארכיטקטורה של עומס העבודה, כדאי להביא בחשבון את השיטות המומלצות הכלליות ואת ההמלצות ליעילות תפעולית שמתוארות במאמר Google Cloud Well-Architected Framework: מצוינות תפעולית.
אופטימיזציה של הביצועים
בקטע הזה מתוארים הגורמים שצריך להביא בחשבון כשמשתמשים בארכיטקטורה לדוגמה הזו כדי לתכנן ולבנות טופולוגיה אזורית ב-Google Cloud שעומדת בדרישות הביצועים של עומסי העבודה שלכם.
ביצועי המחשוב
ב-Compute Engine יש מגוון רחב של סוגי מכונות מוגדרים מראש ובהתאמה אישית, לעומסי העבודה שאתם מריצים במכונות וירטואליות. בוחרים סוג מכונה שמתאים לדרישות הביצועים שלכם. מידע נוסף זמין במאמר מדריך השוואה ומשאבים של משפחות מכונות.
ריבוי הליכי משנה (multithreading) של VM
כל מעבד וירטואלי (vCPU) שאתם מקצים למכונה וירטואלית ב-Compute Engine מוטמע כריבוי הליכי משנה (multithread) בחומרה אחת. כברירת מחדל, שני מעבדי vCPU משתפים ליבת מעבד פיזית. באפליקציות שכוללות פעולות מקבילות מאוד או שמבצעות חישובים של נקודה צפה (כמו ניתוח רצף גנטי ומודלים של סיכון פיננסי), אפשר לשפר את הביצועים על ידי הפחתת מספר השרשורים שפועלים בכל ליבת מעבד פיזית. מידע נוסף זמין במאמר הגדרת מספר הליכי המשנה לכל ליבה.
לריבוי הליכים (multithreading) במכונות וירטואליות יכולות להיות השלכות על הרישוי של תוכנות מסוימות של צד שלישי, כמו מסדי נתונים. למידע נוסף, קראו את מסמכי התיעוד בנושא רישוי של תוכנת הצד השלישי.
Network Service Tiers
מסלולי שירות הרשת מאפשרים לכם לבצע אופטימיזציה של עלות הרשת והביצועים של עומסי העבודה. אתם יכולים לבחור בין מסלול פרימיום למסלול רגיל. במסלול הפרימיום, תעבורת הנתונים עוברת דרך התשתית הגלובלית של Google כדי להשיג אובדן מנות מינימלי וזמן אחזור קצר. במסלול הרגיל, תעבורת הנתונים מועברת באמצעות קישור בין רשתות שכנות (peering), ספקי אינטרנט (ISP) או רשתות העברה בנקודת קצה (PoP) שהכי קרובה לאזור שבו פועל עומס העבודה ב- Google Cloud . כדי לשפר את הביצועים, מומלץ להשתמש במסלול פרימיום. כדי לבצע אופטימיזציה של העלות, מומלץ להשתמש במסלול הרגיל.
ביצועי הרשת
אם יש לכם עומסי עבודה שדורשים זמן אחזור נמוך ברשת בין מכונות וירטואליות בשכבות האפליקציה והאינטרנט, אתם יכולים ליצור מדיניות מיקום קומפקטי ולהחיל אותה על התבנית של קבוצת המכונות המנוהלת שמשמשת לשכבות האלה. כשה-MIG יוצר מכונות וירטואליות, הוא ממקם אותן בשרתים פיזיים שקרובים זה לזה. מדיניות למיקום קומפקטי עוזרת לשפר את ביצועי הרשת בין המכונות הווירטואליות, אבל מדיניות למיקום מרווח יכולה לעזור לשפר את הזמינות של המכונות הווירטואליות, כמו שתיארנו קודם. כדי להשיג איזון אופטימלי בין ביצועי הרשת לבין הזמינות, כשיוצרים מדיניות למיקום קומפקטי אפשר לציין את המרחק המקסימלי בין המכונות הווירטואליות. מידע נוסף מופיע במאמר סקירה כללית על כללי מיקום.
ב-Compute Engine יש מגבלה לכל מכונה וירטואלית על רוחב הפס של הרשת לתעבורת נתונים יוצאת. המגבלה הזו תלויה בסוג המכונה של ה-VM, ובשאלה אם התנועה מנותבת דרך אותה רשת VPC כמו ה-VM המקורי. במכונות וירטואליות עם סוגי מכונות מסוימים, כדי לשפר את ביצועי הרשת, אתם יכולים להפעיל את רשת Tier_1 ולקבל רוחב פס מקסימלי גבוה יותר לתעבורת נתונים יוצאת.
שיקולים נוספים שקשורים לביצועים
כשאתם בונים את הארכיטקטורה של עומס העבודה, כדאי להביא בחשבון את השיטות המומלצות הכלליות ואת ההמלצות שמפורטות במאמר Google Cloud Well-Architected Framework: אופטימיזציה של הביצועים.
המאמרים הבאים
- Google Cloud מידע נוסף על המוצרים שמשמשים בארכיטקטורה לדוגמה:
- איך מתחילים להעביר את עומסי העבודה ל- Google Cloud.
- בחינה והערכה של ארכיטיפים של פריסה שתוכלו לבחור כדי לבנות ארכיטקטורות לעומסי העבודה שלכם בענן.
- בודקים את אפשרויות הארכיטקטורה כדי לתכנן תשתית אמינה לעומסי העבודה ב- Google Cloud.
- לדוגמאות נוספות של ארכיטקטורות, תרשימים ושיטות מומלצות, עיינו במאמר Cloud Architecture Center.
שותפים ביצירת התוכן
מחברים:
- קומאר דהנגופאל | מפתח פתרונות חוצי-מוצרים
- סמנתה הי | כותבת טכנית
תורמים אחרים:
- בן גוד | אדריכל פתרונות
- קרל פרנקלין | מנהל, ארכיטקטורת PSO Enterprise
- דניאל ליס | ארכיטקט אבטחה בענן
- Gleb Otochkin | Cloud Advocate, Databases
- מארק שלאגנהאוף | כותב טכני, רשתות
- פאבל וונדה | מנהל קבוצת מוצרים
- שון דרינגטון | מנהל קבוצת מוצרים, אחסון
- סקו פייג' | מנהל מוצר יוצא
- סיימון בנט | מנהל קבוצת מוצרים
- סטיב מקגי | מומחה לאמינות
- ויקטור מורנו | מנהל מוצר, Cloud Networking