


Neste documento, apresentamos uma arquitetura de referência que pode ser usada para projetar a infraestrutura de um aplicativo de IA generativa com geração aumentada por recuperação (RAG) usando o Gemini Enterprise e a Gemini Enterprise Agent Platform. Esta arquitetura de referência demonstra como usar serviços gerenciados e implantar um único agente de IA para facilitar um fluxo de dados de RAG de ponta a ponta. O Gemini Enterprise serve como a plataforma unificada para orquestração de agentes em toda a empresa. A Agent Platform acelera o desenvolvimento e a implantação de agentes personalizados e oferece repositórios de dados gerenciados para facilitar a recuperação eficiente para RAG.
O público-alvo deste documento inclui arquitetos, desenvolvedores e administradores de aplicativos de IA generativa. Este documento considera uma compreensão básica dos conceitos de IA, machine learning (ML) e modelo de linguagem grande (LLM). Neste documento, não fornecemos orientações sobre como projetar e desenvolver um aplicativo de IA generativa. Para saber como projetar um aplicativo, consulte Desenvolver um aplicativo de IA generativa.
Arquitetura
O diagrama a seguir mostra uma visão geral da arquitetura apresentada neste documento:

A arquitetura no diagrama anterior tem dois subsistemas: ingestão de dados e disponibilização.
- O subsistema de ingestão de dados ingere e prepara dados de fontes externas para uso na RAG. O subsistema gera embeddings para os dados ingeridos e os usa para criar e manter um índice de vetor pesquisável em um repositório de dados gerenciado.
- O subsistema de disponibilização contém os serviços de front-end e back-end do aplicativo de IA generativa.
- O serviço de front-end lida com o fluxo de consulta-resposta com os usuários do aplicativo e encaminha as consultas para o serviço de back-end.
- O serviço de back-end usa o Gemini Enterprise e a plataforma de agentes para criar e implantar seu agente de IA para orquestrar o processo de RAG. Esse processo usa os dados vetoriais indexados para gerar respostas contextualmente fundamentadas e que aderem aos filtros de segurança da IA responsável.
O diagrama a seguir mostra uma visão detalhada da arquitetura:
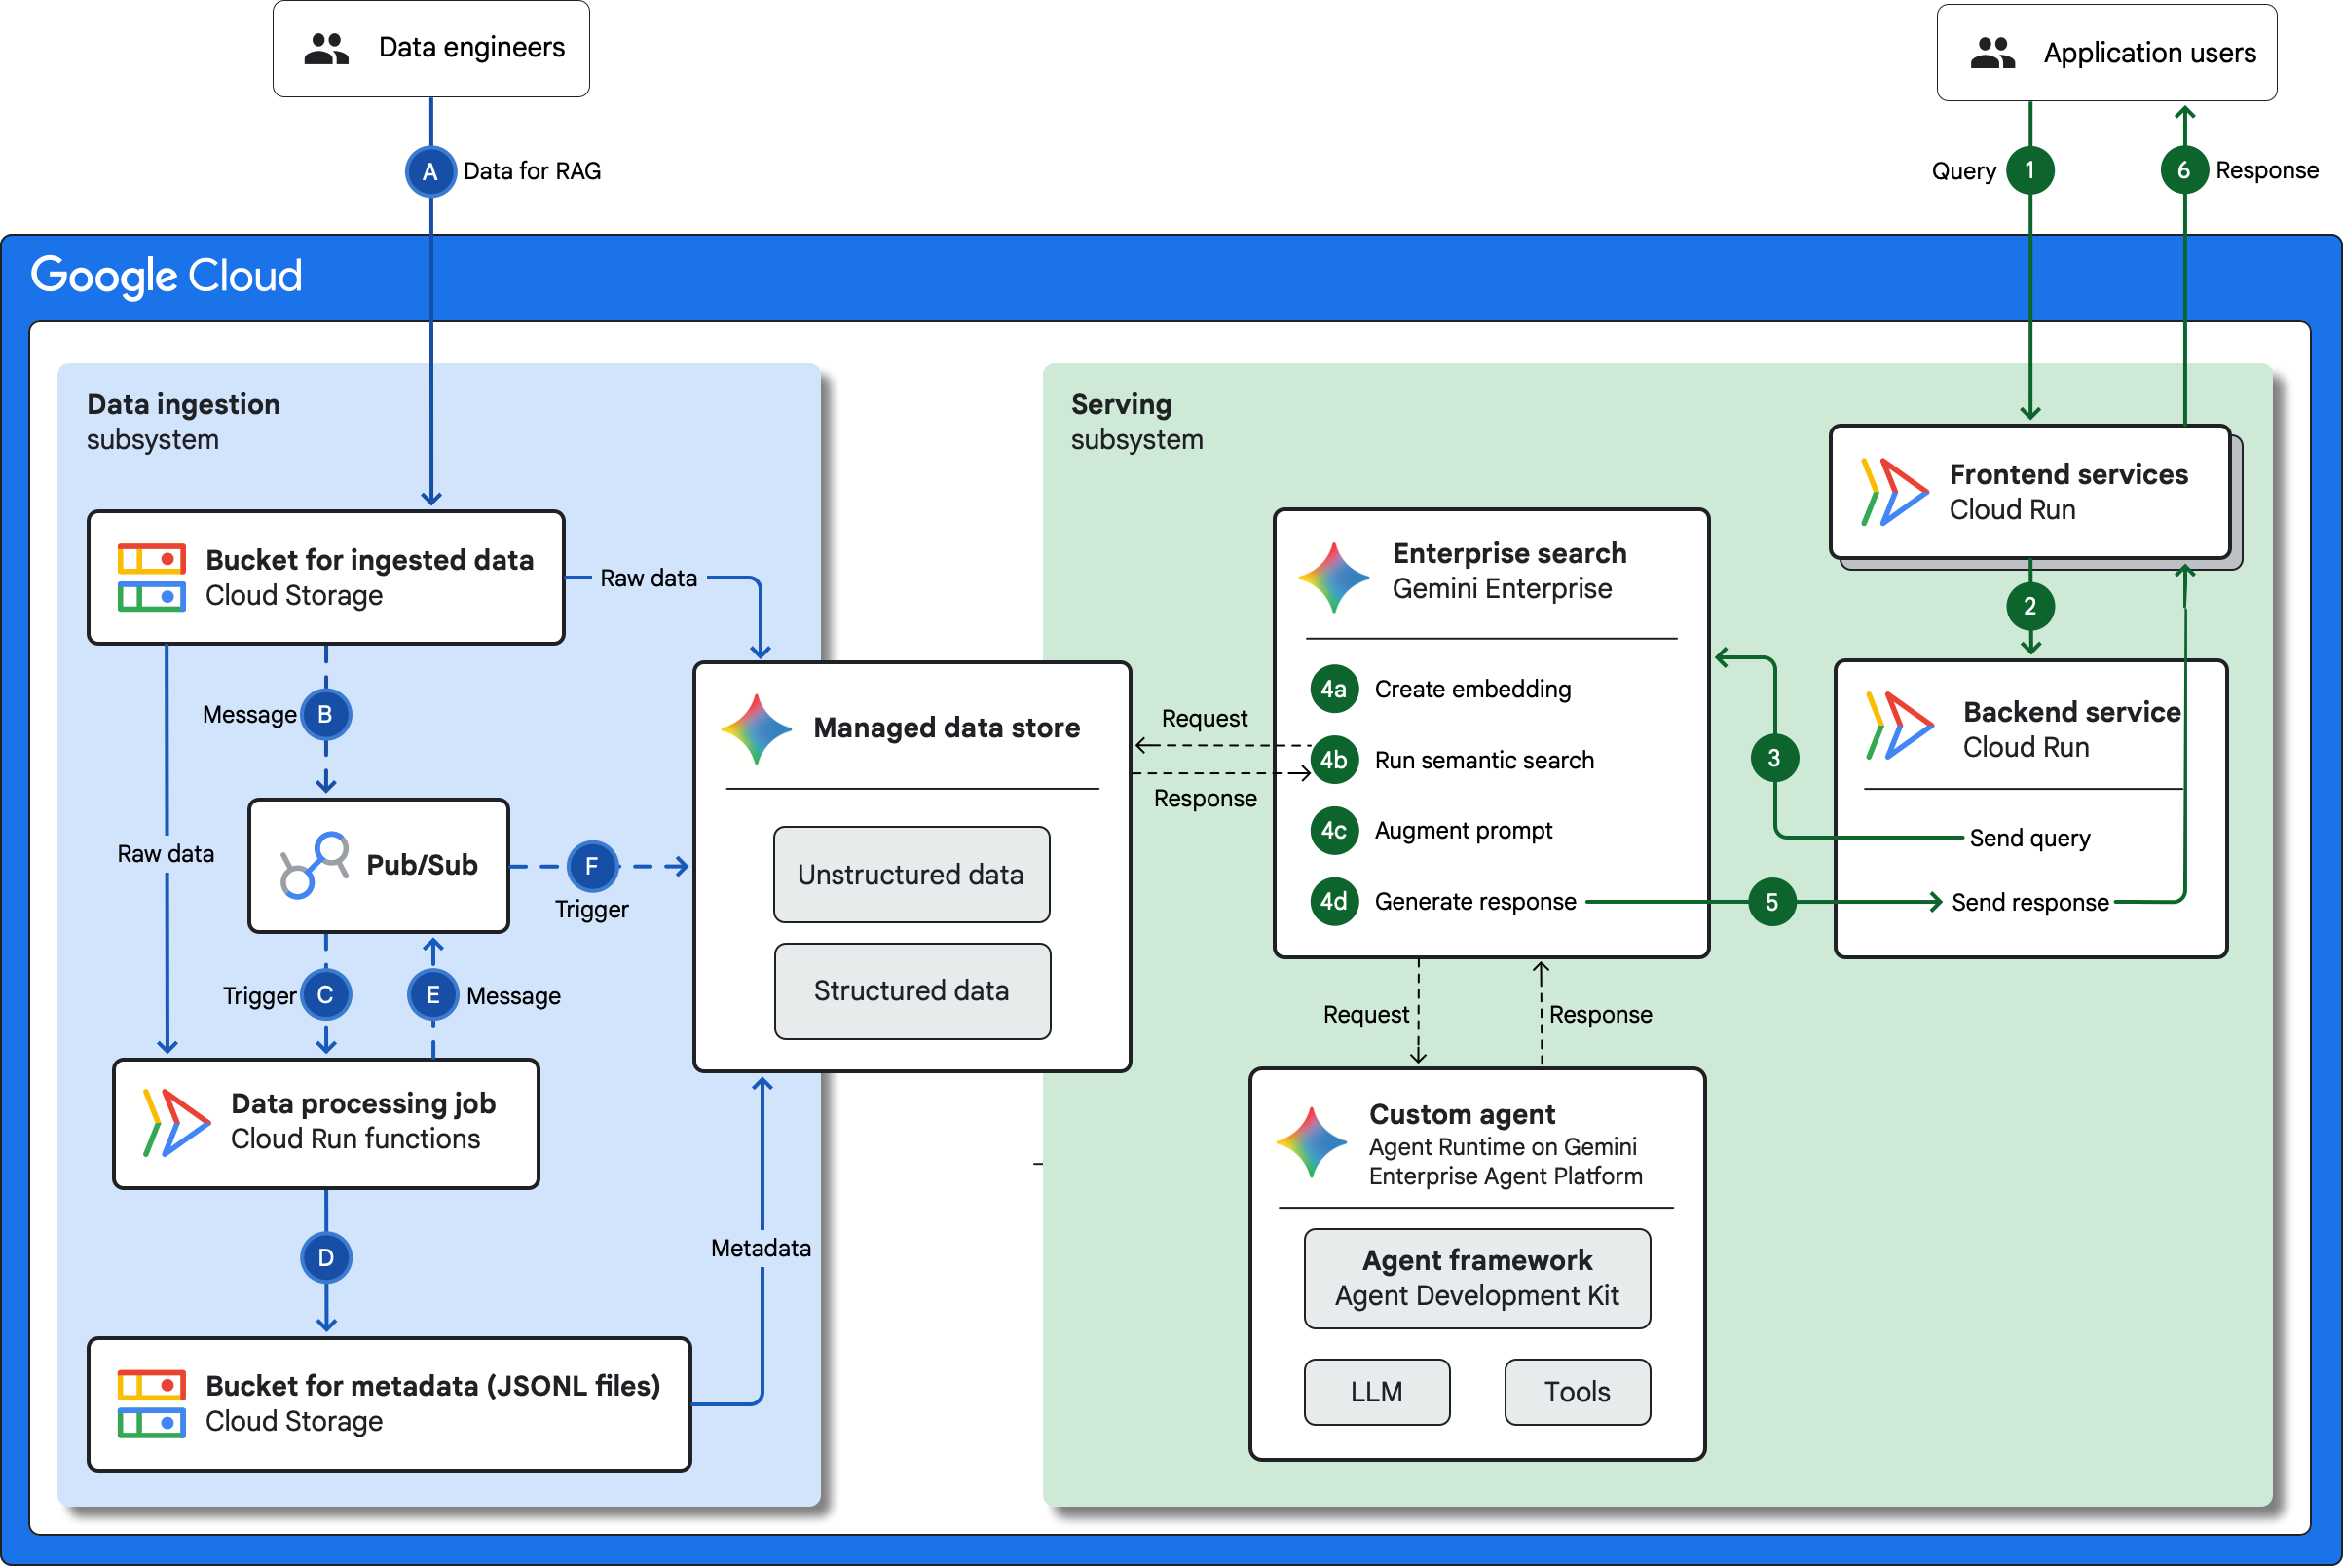
As seções a seguir descrevem o fluxo de dados em cada subsistema do diagrama de arquitetura anterior.
Subsistema de ingestão de dados
O subsistema de ingestão de dados ingere dados de fontes externas e os prepara para a RAG. Confira a seguir as etapas do fluxo de ingestão e preparação de dados:
- Os engenheiros de dados fazem upload de dados de fontes externas para um bucket do Cloud Storage. As fontes externas podem ser aplicativos, bancos de dados ou serviços de streaming.
- Ao final, o Cloud Storage publica uma mensagem em um tópico do Pub/Sub.
- O tópico do Pub/Sub aciona um job de processamento para ser executado no Cloud Run functions.
- O Cloud Run functions processa os dados brutos gerando e armazenando os metadados como arquivos JSON Lines (JSONL). Os arquivos JSONL são armazenados em um bucket separado do Cloud Storage.
- Ao final, o Cloud Run functions publica uma mensagem em um tópico do Pub/Sub.
- O tópico do Pub/Sub aciona uma função do Cloud Run downstream que chama o
método
documents.importda API Discovery Engine para iniciar um job de importação no repositório de dados gerenciado no Gemini Enterprise. O job de importação extrai os dados e metadados brutos ingeridos dos buckets do Cloud Storage e, em seguida, analisa e divide os dados para uma recuperação eficiente durante a veiculação. O Gemini Enterprise gera embeddings de vetor automaticamente, sem necessidade de configuração.
Subsistema de veiculação
O subsistema de disponibilização lida com o fluxo de consulta/resposta entre o aplicativo de IA generativa e os usuários. Confira a seguir as etapas do fluxo de disponibilização:
- Um usuário do aplicativo envia uma consulta por um dos serviços de front-end do Cloud Run. É possível personalizar esses serviços para diferentes experiências, como uma UI de chatbot, uma página de pesquisa ou um aplicativo para dispositivos móveis.
- O serviço de front-end recebe a consulta e a encaminha para um serviço de back-end centralizado do Cloud Run. Esse back-end fornece um endpoint único e unificado para oferecer suporte a todos os diferentes clientes de front-end. O serviço de back-end também realiza o pré-processamento necessário, que pode incluir a criação de filtros para a consulta de pesquisa. Essa abordagem mantém a lógica transparente para os front-ends.
- O serviço de back-end envia a solicitação preparada para o Gemini Enterprise usando o endpoint de API Gemini Enterprise para iniciar o fluxo de trabalho de RAG.
- Para processar a consulta, o Gemini Enterprise usa a pesquisa enterprise e o agente personalizado para
realizar as seguintes tarefas:
- Criar um embedding da consulta do usuário.
- Realizar uma pesquisa semântica nos dados indexados no repositório de dados gerenciado para encontrar as informações mais relevantes.
- Aumente a consulta original com os dados recuperados do repositório de dados gerenciado para criar um comando detalhado e contextual.
- Gerar uma resposta final com base no comando aumentado.
- O Gemini Enterprise envia a resposta gerada para o serviço de back-end do Cloud Run.
- O serviço de back-end retorna a resposta final ao serviço de front-end que enviou a solicitação original. O serviço de front-end apresenta a resposta ao usuário do aplicativo.
Produtos usados
Esta arquitetura de referência usa os seguintes produtos do Google Cloud :
- Gemini Enterprise: uma plataforma segura e totalmente gerenciada para implantar e gerenciar agentes de IA em uma empresa.
- Gemini Enterprise Agent Platform: uma plataforma abrangente que permite criar, escalonar, governar e otimizar agentes de IA de nível empresarial.
- Agent Runtime na Gemini Enterprise Agent Platform: uma plataforma que permite executar, gerenciar e escalonar agentes de IA em produção.
- Cloud Run: uma plataforma de computação sem servidor que permite executar contêineres diretamente na infraestrutura escalonável do Google.
- Cloud Run functions: uma plataforma de computação sem servidor que permite executar funções de finalidade única diretamente no Google Cloud.
- Pub/Sub: um serviço de mensagens assíncrono e escalonável que separa os serviços que produzem mensagens daqueles que processam essas mensagens.
- Cloud Storage: um repositório de objetos de baixo custo e sem limite para diversos tipos de dados. Os dados podem ser acessados de dentro e fora do Google Cloude são replicados entre locais para redundância.
Casos de uso
Essa arquitetura foi projetada para cenários corporativos em que o aplicativo de IA generativa precisa de acesso às informações mais recentes e de uma compreensão profunda e contextual para fornecer respostas precisas.
A arquitetura inclui um subsistema personalizado de ingestão de dados para atender a dois requisitos empresariais importantes:
- Disponibilidade de dados em tempo real: o pipeline orientado por eventos processa novos dados assim que eles ficam disponíveis na sua organização, por exemplo, um novo guia de produtos ou um relatório atualizado. O pipeline também disponibiliza as informações no seu repositório de dados gerenciado. Esse design ajuda a reduzir a desatualização das informações, porque ajuda a minimizar o atraso entre a disponibilidade e o uso dos dados.
- Pesquisa contextual enriquecida: o job de processamento personalizado permite que sua organização aplique a própria lógica de negócios para enriquecer os dados com metadados valiosos. A função do Cloud Run pode marcar cada documento com atributos específicos, como linha de produtos, autor, local ou tipo de documento. Esses metadados avançados ajudam o agente a restringir a pesquisa e fornecer respostas mais precisas e contextualizadas.
A RAG é uma técnica eficaz para melhorar a qualidade da saída gerada por um LLM. Nesta seção, apresentamos exemplos de casos de uso em que é possível usar aplicativos de IA generativa com capacidade de RAG.
Recomendações de produtos personalizada
Um site de compras on-line pode usar um chatbot com tecnologia de LLM para ajudar os clientes a encontrar produtos ou receber ajuda relacionada a compras. As perguntas de um usuário podem ser aumentadas usando dados históricos sobre os padrões de interação no site e o comportamento de compra do usuário. Os dados podem incluir avaliações e feedback de usuários armazenados em um repositório de dados não estruturados ou métricas relacionadas à pesquisa que são armazenadas em um data warehouse de análise da Web. A pergunta aumentada pode ser processada pelo LLM para gerar respostas personalizadas que o usuário pode achar mais relevantes e convincentes.
Sistemas de assistência clínica
Os médicos em hospitais precisam analisar e sintetizar as informações de saúde do paciente para tomar decisões de tratamento informadas. Um aplicativo de IA generativa que usa um modelo de fundação médico, como o MedGemma, pode ajudar os médicos a resumir notas clínicas e revisar o contexto médico. As respostas que o aplicativo gera podem ser fundamentadas por históricos dos pacientes contextualizando os comandos com dados do banco de dados dos históricos de saúde eletrônicos (EHR, na sigla em inglês) do hospital ou de uma base de conhecimento externa, como o PubMed:
Pesquisa jurídica eficiente
A pesquisa jurídica com tecnologia de IA generativa permite que advogados consultem rapidamente grandes volumes de estatutos e jurisprudência para identificar precedentes legais relevantes ou resumir conceitos jurídicos complexos. O resultado dessa pesquisa pode ser aprimorado aumentando os comandos de um advogado com dados extraídos das comunicações legais anteriores, dos registros de casos internos e do corpus reservado de contratos do escritório de advocacia. Essa abordagem de desenvolvimento ajuda a gerar respostas relevantes para o domínio jurídico em que o advogado é especializado.
Alternativas de design
Nesta seção, apresentamos abordagens de design alternativas que podem ser consideradas para seu aplicativo de IA generativa com capacidade de RAG no Google Cloud.
Alternativas de infraestrutura de IA
Para ver uma lista de guias de arquitetura para projetar e implantar aplicativos de IA generativa com RAG no Google Cloud, consulte IA generativa com RAG.
Opções de hospedagem de aplicativos
Na arquitetura mostrada neste documento, o Cloud Run é o host do aplicativo de IA generativa e do tratamento de dados. O Cloud Run é uma plataforma totalmente gerenciada e voltada para desenvolvedores. Também é possível implantar o aplicativo no Agent Runtime na Gemini Enterprise Agent Platform, em clusters do Google Kubernetes Engine (GKE) ou em VMs do Compute Engine.
Para escolher um host de aplicativo, considere as seguintes vantagens e desvantagens entre a flexibilidade de configuração e o esforço de gerenciamento:
- Com a opção sem servidor do Cloud Run, você implanta seus serviços personalizados em um ambiente gerenciado pré-configurado. Para hospedar os serviços de front-end e a lógica de back-end personalizada para o pré-processamento de solicitações, essa arquitetura requer a capacidade de implantar aplicativos personalizados.
- Com a opção Agent Runtime, você usa uma plataforma totalmente gerenciada projetada para disponibilização de agentes. O Agent Runtime reduz a sobrecarga de gerenciamento e oferece uma integração total com o Gemini Enterprise.
- Com as VMs do Compute Engine e os contêineres do GKE, você é responsável por gerenciar os recursos de computação subjacentes, mas tem mais flexibilidade e controle de configuração.
Para mais informações sobre como escolher um serviço de hospedagem de aplicativos adequado, consulte os seguintes documentos:
Outras opções de infraestrutura
Para informações sobre outras opções de infraestrutura, modelos compatíveis e técnicas de embasamento que podem ser usadas para aplicativos de IA generativa no Google Cloud, consulte Escolher modelos e infraestrutura para seu aplicativo de IA generativa.
Considerações sobre o design
Esta seção contém orientações para ajudar você a desenvolver uma arquitetura de IA generativa com capacidade de RAG no Google Cloud que atenda aos seus requisitos específicos de segurança e conformidade, confiabilidade, custo e desempenho. As orientações desta seção não são completas. Dependendo dos requisitos específicos do seu aplicativo de IA generativa e dos produtos e recursos do Google Cloud que você usa, pode ser necessário considerar outros fatores de desenvolvimento e compensações.
Para uma visão geral dos princípios e recomendações de arquitetura específicos para cargas de trabalho de IA e ML no Google Cloud, consulte a perspectiva de IA e ML no Well-Architected Framework.
segurança, privacidade e conformidade
Nesta seção, descrevemos as considerações e recomendações de design para criar uma topologia no Google Cloud que atenda aos requisitos de segurança e conformidade da sua carga de trabalho.
Para princípios e recomendações de segurança específicos para cargas de trabalho de IA e ML, consulte Perspectiva de IA e ML: segurança no Well-Architected Framework.
Plataforma de Agentes
A Agent Platform é compatível com os controles de segurança do Google Cloud que podem ser usados para atender aos seus requisitos de residência de dados, criptografia de dados, segurança de rede e transparência no acesso. Para mais informações, consulte a seguinte documentação:
- Controles de segurança para serviços de machine learning
- Controles de segurança para IA generativa
- Plataforma de Agentes e retenção de dados zero
- Ativar a Transparência no acesso para o Gemini Enterprise
- Controles de compliance e segurança do Gemini Enterprise
- Compliance do Gemini Enterprise
- Exclusão de dados no Google Cloud.
Os modelos de IA generativa podem produzir respostas nocivas, especialmente quando são explicitamente solicitados. Para aumentar a segurança e reduzir o potencial uso indevido, configure filtros de conteúdo para que atuem como barreiras contra respostas nocivas. Para mais informações, consulte Filtros de segurança e conteúdo.
Cloud Run
Por padrão, o Cloud Run criptografa os dados usando Google-owned and Google-managed encryption keys. Para proteger os contêineres usando chaves controladas por você, use chaves de criptografia gerenciadas pelo cliente (CMEKs). Para mais informações, consulte Como usar chaves de criptografia gerenciadas pelo cliente.
Para garantir que apenas imagens de contêiner autorizadas sejam implantadas no Cloud Run, use a autorização binária.
O Cloud Run ajuda você a atender aos requisitos de residência de dados. As funções do Cloud Run são executadas na região selecionada.
Cloud Storage
Por padrão, o Cloud Storage criptografa os dados que armazena usando o Google-owned and Google-managed encryption keys. Se necessário, use CMEKs ou suas próprias chaves gerenciadas utilizando um método de gerenciamento externo, como chaves de criptografia fornecidas pelo cliente (CSEKs). Para mais informações, consulte Opções de criptografia de dados.
O Cloud Storage é compatível com dois métodos para conceder aos usuários acesso aos buckets e objetos: Identity and Access Management (IAM) e listas de controle de acesso (ACLs). Na maioria dos casos, recomendamos usar o IAM, que permite conceder permissões no nível do bucket e para envolvidos no projeto. Para mais informações, consulte Visão geral do controle de acesso.
Os dados carregados no subsistema de ingestão de dados pelo Cloud Storage podem incluir dados sensíveis. Use a Proteção de Dados Sensíveis para descobrir, classificar e desidentificar dados sensíveis. Para mais informações, acesse Como usar a Proteção de Dados Sensíveis com o Cloud Storage.
O Cloud Storage ajuda você a atender aos requisitos de residência de dados. O Cloud Storage armazena ou replica dados na região que você especificar.
Pub/Sub
Por padrão, o Pub/Sub criptografa todas as mensagens, o que inclui mensagens em repouso e em trânsito, usando Google-owned and Google-managed encryption keys. O Pub/Sub pode usar CMEKs para criptografia de mensagens na camada do aplicativo. Para mais informações, consulte Configurar a criptografia de mensagens.
Se você tiver requisitos de residência de dados, para garantir que os dados das mensagens sejam armazenados em locais específicos, configure políticas de armazenamento de mensagens.
Confiabilidade
Nesta seção, descrevemos as considerações e recomendações de design para criar e operar uma infraestrutura confiável para sua implantação no Google Cloud.
Para princípios e recomendações de confiabilidade específicos para cargas de trabalho de IA e ML, consulte Perspectiva de IA e ML: confiabilidade no Well-Architected Framework.
Plataforma de Agentes
A Agent Platform é compatível com a residência de dados em repouso. A Agent Platform armazena seus dados de origem, que incluem dados para RAG no repositório de dados gerenciado, noGoogle Cloud local que você selecionou. Essa separação entre processamento e armazenamento é um aspecto fundamental de como a plataforma oferece alta confiabilidade e conformidade.
Cloud Run
O Cloud Run é um serviço regional que distribui e balanceia automaticamente a carga de instâncias de serviço sem estado em várias zonas de uma região. Se ocorrer uma interrupção do serviço na zona, os serviços do Cloud Run e as funções do Cloud Run continuarão em execução sem interrupção. Para resiliência contra falhas temporárias regionais, é possível implantar serviços do Cloud Run em várias regiões por trás de um balanceador de carga de aplicativo externo global. Para mais informações, consulte Exibir tráfego de várias regiões.
No subsistema de ingestão de dados, as funções do Cloud Run orientadas a eventos podem apresentar falhas temporárias ou receber eventos duplicados devido à entrega pelo menos uma vez. Para lidar com esses cenários de maneira confiável, considere as seguintes práticas recomendadas:
- Projete funções idempotentes para que o reprocessamento de um evento produza o mesmo resultado sem criar registros duplicados.
- Configure novas tentativas de função orientada a eventos com espera exponencial no gatilho do Pub/Sub para se recuperar de erros temporários de downstream.
- Configure um tópico de mensagens inativas do Pub/Sub para isolar mensagens que falham repetidamente no processamento para inspeção e repetição separadas.
Cloud Storage
É possível criar buckets do Cloud Storage em um destes três tipos de local: regional, birregional ou multirregional. Para dados em buckets regionais, o Cloud Storage replica de forma síncrona esses dados em várias zonas dentro de uma região. Para maior disponibilidade, use buckets birregionais ou multirregionais, em que o Cloud Storage replica dados de forma assíncrona entre regiões. Verifique se a escolha está alinhada aos requisitos de compliance.
Otimização de custos
Nesta seção, você encontra orientações para otimizar o custo de configuração e operação de uma topologia do Google Cloud criada usando essa arquitetura de referência.
Para princípios e recomendações de otimização de custos específicos para cargas de trabalho de IA e ML, consulte Perspectiva de IA e ML: otimização de custos no Well-Architected Framework.
Plataforma de Agentes
O modelo de IA que o agente invoca pode influenciar diretamente o custo de uso desse agente. Os preços são calculados com base no número de tokens de entrada e saída de cada solicitação. Para mais informações, consulte Cotas e limites do sistema da IA generativa na plataforma de agentes e a calculadora de preços doGoogle Cloud .
Para saber como minimizar a contagem de tokens para reduzir custos, consulte a Visão geral do armazenamento em cache de contexto.
Cloud Run
Para otimizar o custo dos serviços do Cloud Run e do Cloud Run functions, considere as seguintes recomendações:
- Configurações de faturamento: escolha uma configuração de faturamento adequada com base no seu padrão de tráfego. Use o faturamento com base em solicitações (padrão) para cargas de trabalho esporádicas ou com picos, como funções do Cloud Run orientadas a eventos no pipeline de ingestão de dados, para pagar pela CPU e pela memória apenas enquanto as solicitações são processadas. Para serviços do Cloud Run com tráfego estável e previsível, considere o faturamento com base em instâncias, que elimina a taxa por solicitação e cobra uma taxa de computação por segundo mais baixa.
- CPU, memória e simultaneidade: comece com as alocações padrão de CPU e memória e ajuste o limite de CPU e o limite de memória com base na utilização monitorada. Ajuste o máximo de solicitações simultâneas por instância para que menos instâncias possam processar solicitações simultâneas vinculadas a E/S (como aguardar respostas de modelo ou respostas da API).
- Limites de escalonamento de instâncias: configure o máximo de instâncias para limitar os custos de escalonamento durante picos de tráfego inesperados e equilibrar o mínimo de instâncias com os requisitos de latência de inicialização a frio.
- Descontos por compromisso de uso: se você puder prever os requisitos de computação das suas cargas de trabalho do Cloud Run, poderá reduzir os custos com descontos por compromisso de uso do Cloud Run.
Para mais informações, consulte Práticas recomendadas para serviços do Cloud Run com custo otimizado.
Cloud Storage
Para o bucket do Cloud Storage usado para carregar dados no subsistema de ingestão de dados, escolha uma classe de armazenamento apropriada com base nos requisitos de frequência de acesso e retenção de dados das cargas de trabalho. Por exemplo, é possível escolher a classe de armazenamento Standard Storage e usar o Gerenciamento do ciclo de vida de objetos para controlar os custos de armazenamento. O gerenciamento do ciclo de vida de objetos faz o downgrade automático de objetos para uma classe de armazenamento de menor custo ou exclui objetos com base nas condições que você definir.
Otimização de desempenho
Nesta seção, descrevemos as considerações e recomendações de design para criar uma topologia no Google Cloud que atenda aos requisitos de desempenho das suas cargas de trabalho.
Para princípios e recomendações de otimização de desempenho específicos para cargas de trabalho de IA e ML, consulte Perspectiva de IA e ML: otimização de desempenho no Well-Architected Framework.
Gemini Enterprise
Para reduzir a latência durante a disponibilização, transmita as respostas do modelo antes que o agente gere a saída completa. Isso permite o processamento em tempo real da saída, e você pode atualizar imediatamente sua interface do usuário e executar outras tarefas simultâneas. O streaming melhora a capacidade de resposta percebida e cria uma experiência do usuário mais interativa. Para mais informações, consulte Receber resultados da pesquisa usando o StreamAssist.
Ao criar e registrar agentes personalizados do Kit de Desenvolvimento de Agente (ADK) no Agent Runtime, minimize os saltos sequenciais entre vários agentes, as idas e voltas de ferramentas e as passagens de resumo redundantes para reduzir a latência de turno de ponta a ponta. Para mais informações, consulte Práticas recomendadas de desempenho e confiabilidade.
Cloud Run
Ajuste as alocações de CPU e alocações de memória dos serviços do Cloud Run e das funções do Cloud Run com base nos requisitos de desempenho da carga de trabalho. Para reduzir a latência de inicialização a frio ao escalonar do zero, ative a otimização da CPU de inicialização para fornecer temporariamente mais CPU durante a inicialização da instância de contêiner ou configure instâncias mínimas para manter as instâncias ativas. Para mais informações, consulte Configurar limites de CPU para serviços e Configurar limites de memória para serviços.
Cloud Storage
Para fazer upload de arquivos grandes, use um método chamado uploads compostos paralelos. Com essa estratégia, o arquivo grande é dividido em fragmentos. Você faz upload dos fragmentos para o Cloud Storage em paralelo, e o Cloud Storage remonta os dados em Google Cloud. Os uploads compostos paralelos podem ser mais rápidos do que as operações de upload regulares se você tiver largura de banda de rede e velocidade de disco suficientes. No entanto, essa estratégia tem algumas limitações e implicações de custo. Para mais informações, consulte Uploads compostos paralelos.
Implantação
Para implantar essa arquitetura de referência, use o exemplo do Terraform disponível no GitHub. Para mais informações, consulte Infraestrutura de RAG para aplicativos de IA generativa usando o Gemini Enterprise e a plataforma de agentes.
A seguir
- Saiba como o Gemini Enterprise divide documentos para RAG.
- Saiba como hospedar apps de IA e agentes no Cloud Run.
- Saiba mais sobre as práticas recomendadas de IA responsável e os filtros de segurança da plataforma de agentes.
- Aprenda mais sobre estratégias de comando para LLMs.
- Para uma visão geral dos princípios e recomendações de arquitetura específicos para cargas de trabalho de IA e ML no Google Cloud, consulte a perspectiva de IA e ML no Well-Architected Framework.
- Para mais arquiteturas de referência, diagramas e práticas recomendadas, confira a Central de arquitetura do Cloud.
Colaboradores
Autor: Samantha He | Redatora técnica
Outros colaboradores:
- Deepak Michael | Engenheiro de clientes especialista em rede
- Kumar Dhanagopal | Desenvolvedor de soluções para vários produtos
- Mark Schlagenhauf | Redator técnico, Rede
- Victor Moreno | Gerente de produtos, Cloud Networking
- Yehia Elshater | Arquiteto de soluções de campo, IA generativa, Google Cloud
- Paarth Mahajan | Especialista em rede, Google Cloud