


Neste documento, comparamos as principais opções de computação no Google Cloud para ajudar você a selecionar a melhor solução ou ferramenta para a arquitetura, o escalonamento e outros requisitos do seu aplicativo.
Para implantar cargas de trabalho no Google Cloud, escolha entre uma variedade de soluções ou ferramentas que equilibram seu controle sobre a infraestrutura com o gerenciamento automatizado do Google. A opção de computação selecionada afeta o desempenho, o custo e a manutenção diária. Para entender melhor essas opções antes de escolher uma, consulte Visão geral da computação do Google.
Escolher uma opção de computação
A melhor solução ou ferramenta de computação para sua carga de trabalho pode depender de vários fatores. Por exemplo, se você quiser migrar seu ambiente VMware para o Google Cloud, use o VMware Engine.
Para ajudar você a lidar com as vantagens e desvantagens entre o gerenciamento de infraestrutura, os contêineres e as instâncias do Compute Engine, use o fluxograma a seguir. Se você quiser comparar recursos entre as opções de computação, consulte a tabela de comparação neste documento.
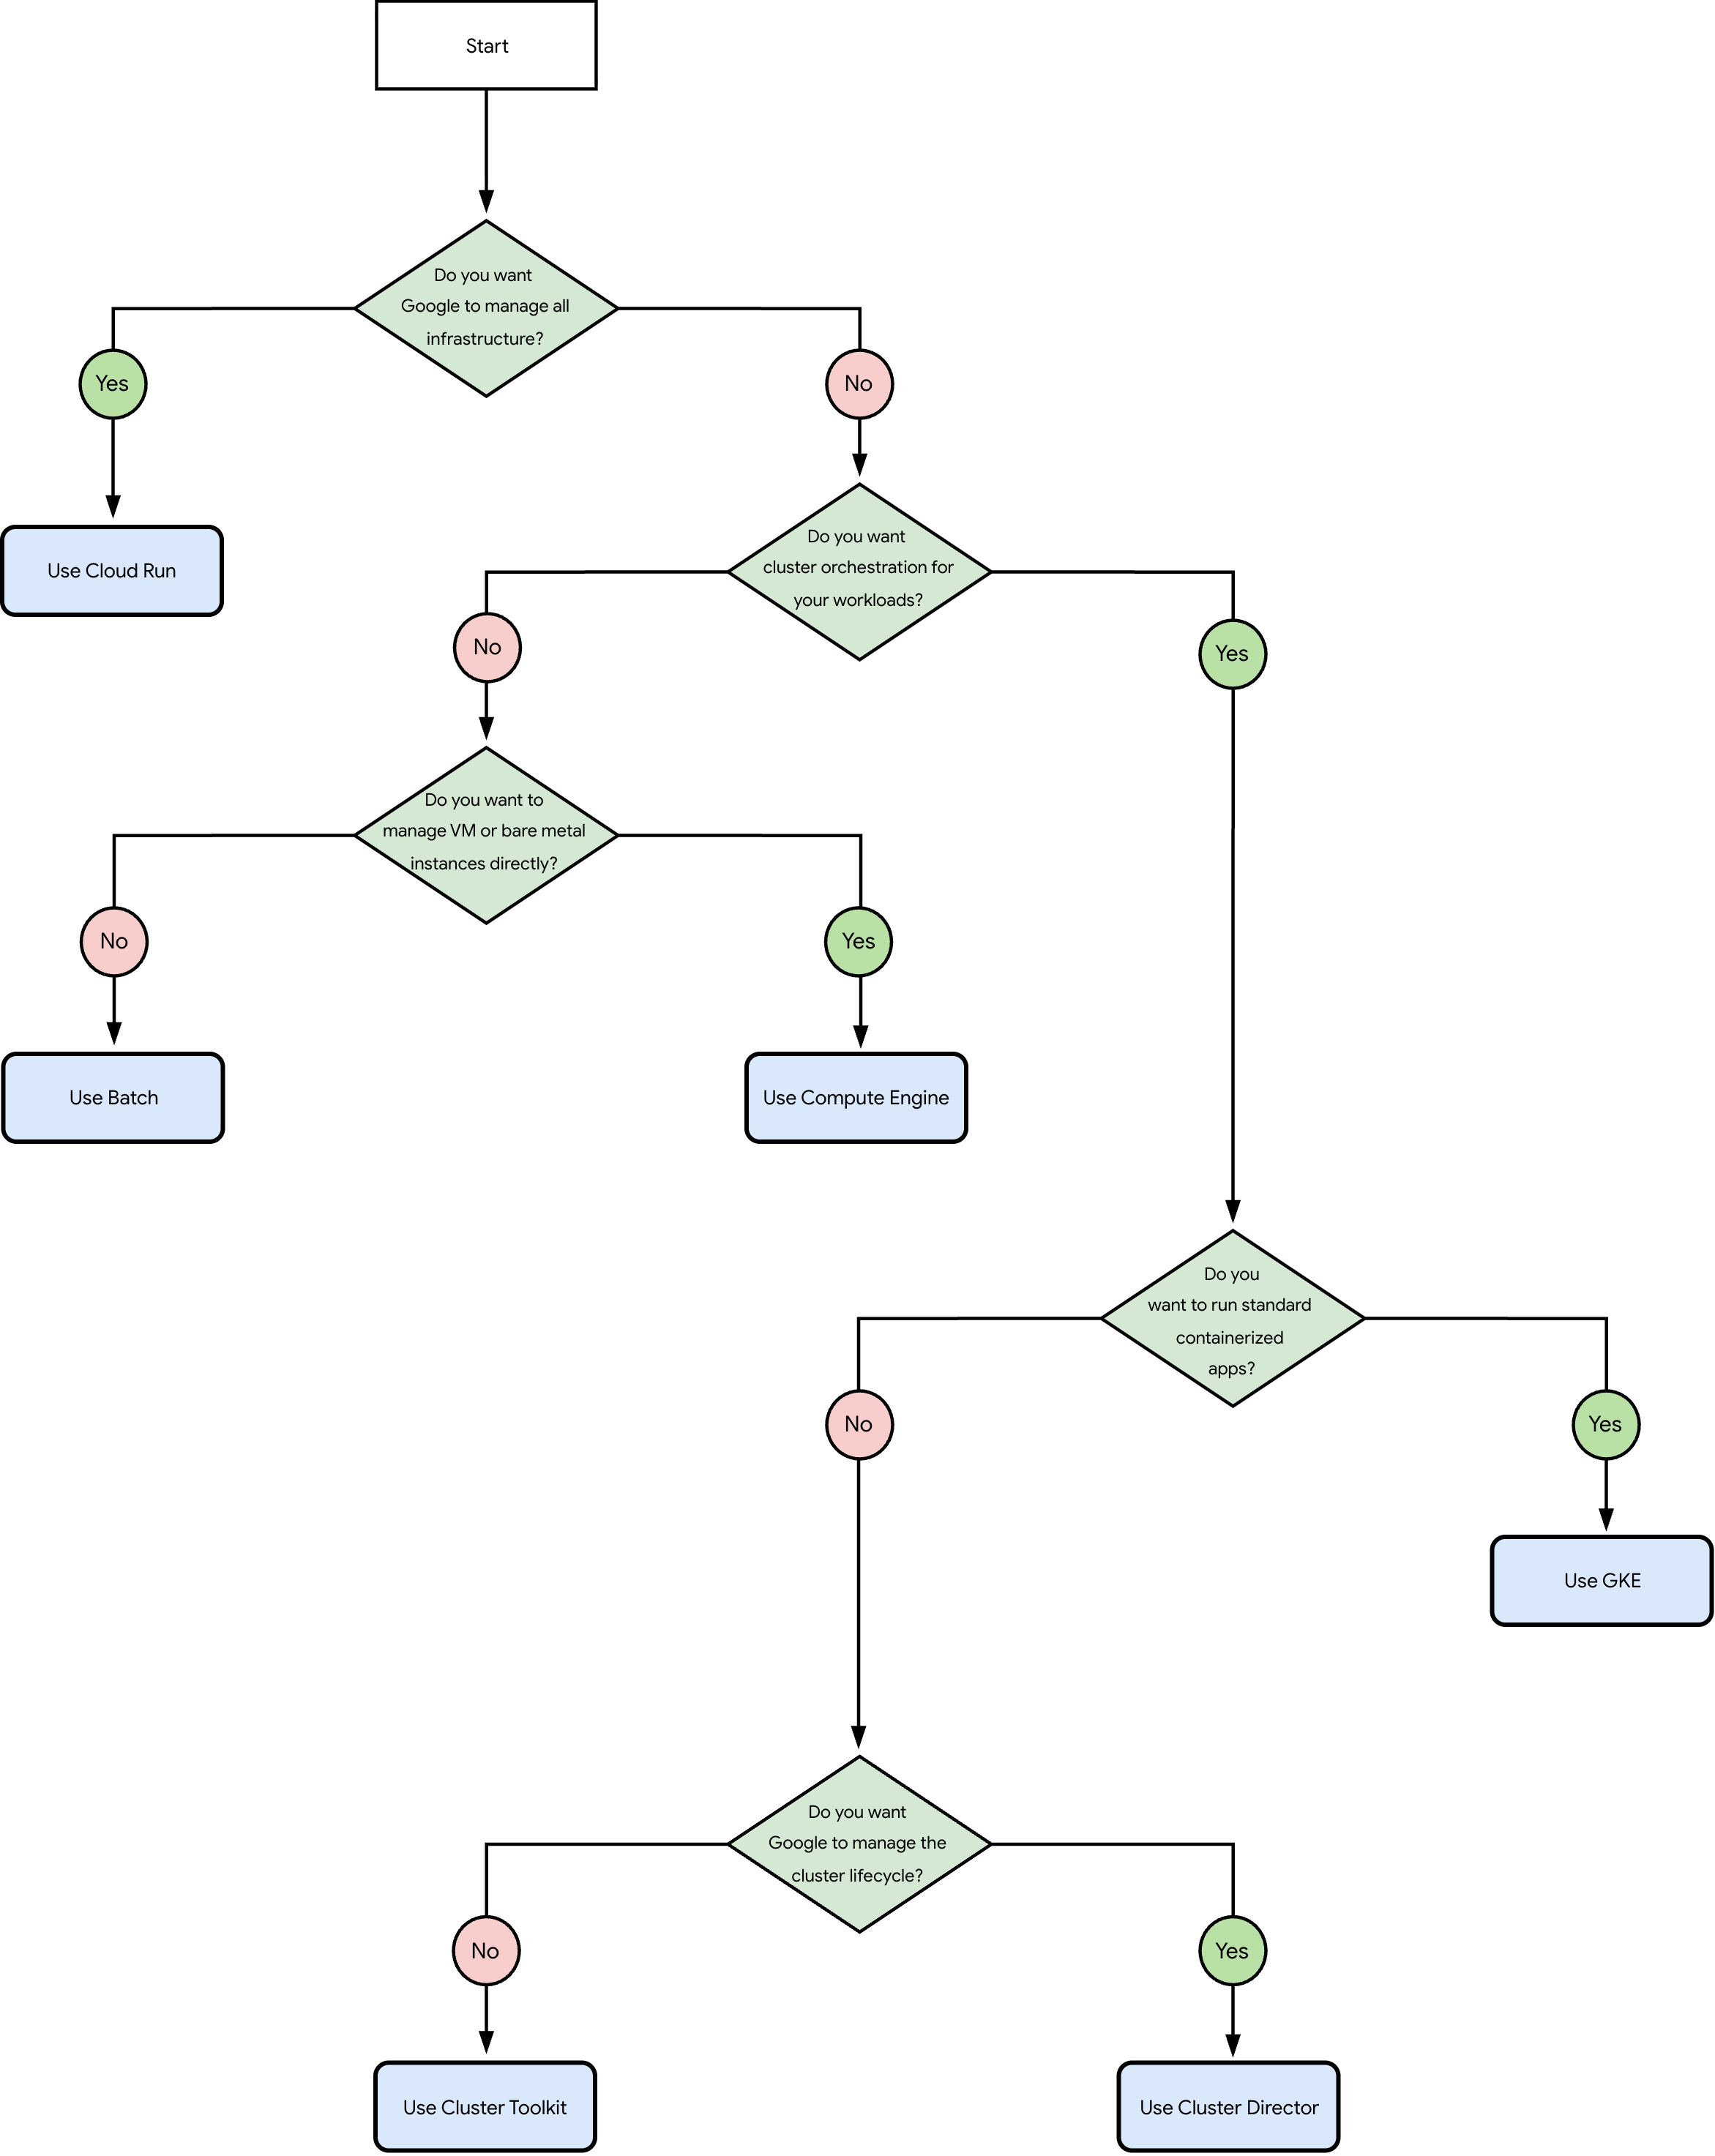
As perguntas no fluxograma anterior são as seguintes:
Você quer que o Google gerencie toda a infraestrutura?
Sim: use o Cloud Run.
Não: vá para a pergunta 2.
Você quer orquestração de cluster para suas cargas de trabalho (como Kubernetes ou Slurm)?
Sim: pule para a pergunta 4.
Não: vá para a pergunta 3.
Você quer gerenciar VMs ou instâncias bare metal por conta própria?
Sim: use o Compute Engine.
Não: use o Batch.
Você quer executar aplicativos conteinerizados padrão (como microsserviços ou APIs)?
Sim: use o GKE.
Não: vá para a pergunta 5.
Você quer que o Google gerencie o ciclo de vida do cluster?
Sim: use o Cluster Director.
Não: use o Cluster Toolkit.
Usar o Batch
Escolha o Batch para cargas de trabalho como análise de dados assíncrona, tarefas de conversão de vídeo ou simulações científicas. Com o Batch, o Google gerencia a infraestrutura para que você possa programar, colocar em fila e executar jobs de computação em lote no Google Cloud. Não é necessário implantar ou gerenciar servidores. Em vez disso, você envia scripts executáveis ou cargas de trabalho em contêineres para uma fila de jobs.
O Batch oferece os seguintes recursos:
Suporte a aceleradores: o Batch é compatível com GPUs NVIDIA até RTX PRO 6000 para cargas de trabalho de computação em lote e de alto desempenho (HPC) que exigem alta capacidade de processamento. O Batch não é compatível com as TPUs do Google.
Controle do SO e do kernel: o Google gerencia o SO e o ambiente de execução dos jobs.
Orquestração: a fila de jobs programa tarefas e as repete se ocorrer um erro. Para escalonar a capacidade, o serviço provisiona e inicia VMs com base no número de jobs em fila e interrompe as VMs quando esses jobs são concluídos.
Para mais informações, consulte Começar a usar o Batch.
Usar o Cloud Run
Para implantar aplicativos da Web ou jobs conteinerizados sem administração de servidores, escolha o Cloud Run. O Cloud Run é uma plataforma sem servidor que permite executar aplicativos conteinerizados sem gerenciamento de servidores ou clusters. O Google cuida de todo o gerenciamento da infraestrutura para você, incluindo o SO, o kernel, a configuração de rede e o gerenciamento de capacidade.
O Cloud Run oferece os seguintes recursos:
Suporte a aceleradores: o Cloud Run é compatível com as GPUs NVIDIA RTX PRO 6000 Blackwell e L4. O Cloud Run não é compatível com outros modelos de GPU ou TPUs do Google.
Controle de SO e kernel: você empacota suas cargas de trabalho como contêineres e as executa como serviços da Web, tarefas assíncronas ou jobs em lote.
Orquestração: como uma plataforma sem servidor, o Google inicia, executa e escalona as instâncias de contêiner sem intervenção manual. Para serviços da Web, o Cloud Run adiciona ou remove instâncias de contêiner com base em solicitações recebidas ou no consumo de CPU.
Para mais informações, consulte O que é o Cloud Run.
Usar o Cluster Director
Se você quiser treinar modelos de IA ou executar jobs de simulação que o Slurm programa sem configuração de rede ou SO, escolha o Cluster Director. O Cluster Director é um serviço gerenciado que automatiza a implantação e o gerenciamento do ciclo de vida de clusters de IA, ML e HPC.
O Cluster Director oferece os seguintes recursos:
Suporte a aceleradores: o Cluster Director é compatível com GPUs NVIDIA (especificamente, GB300 Ultra Superchips, GB200 Superchips, B200, H200 e H100) e TPUs do Google (pré-lançamento; especificamente, TPU7x, TPU v6e e TPU v5p) para cargas de trabalho de IA, ML e HPC.
Controle de SO e kernel: o Google gerencia o ciclo de vida do cluster e configura um SO Ubuntu personalizado projetado para ML. O serviço oferece um ambiente pronto para uso, completo com nós de login, conjuntos de nós de computação e modelos de implantação criados para cargas de trabalho de IA.
Orquestração: para escalonar a capacidade, o Slurm cria nós com base em solicitações de jobs em fila e exclui nós quando eles permanecem inativos por um período para evitar cobranças desnecessárias.
Para mais informações, consulte Visão geral do Cluster Director.
Usar o Cluster Toolkit
Se você quiser usar modelos de implantação automatizados e manter o controle administrativo sobre o SO e a pilha de software, escolha o Cluster Toolkit. O Cluster Toolkit é uma ferramenta de código aberto usada para provisionar e configurar clusters de IA, ML e HPC no Google Cloud.
O Cluster Toolkit oferece os seguintes recursos:
Suporte a aceleradores: o Cluster Toolkit é compatível com GPUs NVIDIA e TPUs do Google, que são provisionadas e configuradas com modelos de implantação chamados blueprints. Com esses arquivos de configuração automatizados, você implanta uma infraestrutura de cluster padronizada e repetível com base nos princípios de infraestrutura como código (IaC).
Controle de SO e kernel: o Cluster Toolkit implanta instâncias de computação ou recursos do GKE no seu projeto do Google Cloud. Depois de implantar esses recursos, você mantém o controle administrativo sobre o SO, as configurações de software e o ciclo de vida do cluster.
Orquestração: para escalonar a capacidade, configure grupos gerenciados de instâncias (MIGs) ou ferramentas do GKE para adicionar ou remover nós com base nas configurações do modelo.
Para mais informações, consulte Visão geral do Cluster Toolkit.
Usar o Compute Engine
Se os aplicativos exigirem configurações arquitetônicas personalizadas, configurações de kernel especializadas ou controle administrativo sobre servidores virtuais, escolha o Compute Engine. O Compute Engine é a principal plataforma de infraestrutura como serviço (IaaS) do Google Cloud, que permite criar e executar instâncias de VM e bare metal no hardware físico do Google.
O Compute Engine oferece os seguintes recursos:
Suporte a aceleradores: o Compute Engine é compatível com GPUs NVIDIA e TPUs do Google, que são anexadas às instâncias de computação.
Controle do SO e do kernel: você mantém o controle total sobre o SO, as configurações do kernel e os arquivos de inicialização, além de selecionar processadores de CPU, configurações de memória, tipos de armazenamento e SO convidado.
Orquestração: como a orquestração é manual, você configura e gerencia suas próprias instâncias de computação, regras de rede, rotas de tráfego e sistemas de backup para garantir a confiabilidade. Para escalonar a capacidade, adicione ou remova instâncias de computação conforme necessário, use ferramentas personalizadas ou configure MIGs para ajustar a capacidade do cluster.
Para mais informações, consulte a visão geral do Compute Engine.
Usar o GKE
Quando você precisar de uma plataforma de orquestração baseada em contêiner para aplicativos distribuídos ou microsserviços de uso geral, escolha o Google Kubernetes Engine (GKE). O GKE é uma plataforma gerenciada do Kubernetes padrão do setor para implantar, escalonar e orquestrar aplicativos em contêineres. O Google gerencia o plano de controle do Kubernetes para segurança e disponibilidade do sistema.
O GKE oferece os seguintes recursos:
Suporte a aceleradores: o GKE é compatível com GPUs NVIDIA e TPUs do Google para cargas de trabalho conteinerizadas.
Controle do SO e do kernel: o Google gerencia o SO nos modos Autopilot e Standard. No modo Autopilot, o Google gerencia os nós do cluster e os ajustes de capacidade sem intervenção manual. No modo Standard, você gerencia os pools de nós do cluster.
Orquestração: para ajustar a capacidade conforme a demanda muda, o GKE adiciona ou remove contêineres com escalonadores automáticos horizontais e Autoescalonador de Pods Vertical (HPA e VPA) e adiciona ou remove nós com o escalonador automático de cluster. O GKE também orquestra jobs em lote por meio do Kueue, um controlador de fila de jobs nativo do Kubernetes.
Para mais informações, consulte a visão geral do GKE.
Usar o VMware Engine
Para migrar suas cargas de trabalho locais do VMware para a infraestrutura do Google Cloud com o mínimo de mudanças operacionais, escolha o VMware Engine. O VMware Engine é um serviço gerenciado que permite executar máquinas virtuais do VMware em hardware do Google sem modificações no aplicativo.
O VMware Engine oferece os seguintes recursos:
Suporte a aceleradores: o VMware Engine não é compatível com GPUs ou TPUs.
Controle de SO e kernel: execute aplicativos VMware no Google Cloud da mesma forma que na configuração atual. O Google gerencia o hardware físico, a infraestrutura de rede e a plataforma de software da VMware, como vSphere, vCenter, vSAN e NSX-T. Você mantém o controle administrativo sobre as VMs, o SO convidado e as ferramentas de gestão da VMware.
Orquestração: para ajustar o tamanho da nuvem privada, adicione ou remova nós ESXi dedicados.
Para mais informações, consulte Visão geral do Google Cloud VMware Engine.
Comparar opções de computação
Para identificar a solução ou ferramenta de computação que se adapta à sua carga de trabalho, compare os recursos técnicos das opções de computação na tabela a seguir:
| Opção de computação | GPUs | TPUs | Controle de SO e kernel | Orquestração | Escalonamento |
|---|---|---|---|---|---|
| Batch | Até NVIDIA RTX PRO 6000 | Não | Gerenciada pelo Google | Fila de jobs | Automático com base em jobs na fila |
| Cloud Run | NVIDIA RTX PRO 6000 Blackwell e L4 | Não | Gerenciada pelo Google | Sem servidor | Automático com base em solicitações ou consumo de CPU |
| Cluster Director | Superchips NVIDIA GB300 Ultra, Superchips GB200, B200, H200 e H100 | Google TPU7x, TPU v6e e TPU v5p (pré-lançamento) | Gerenciado pelo Google (Ubuntu personalizado) | Slurm | Automático com base em solicitações de jobs na fila |
| Cluster Toolkit | Todas as GPUs NVIDIA disponíveis | Todas as TPUs do Google disponíveis | Autogerenciado | Arquivos de configuração automatizados (IaC) | Personalizável usando MIGs ou ferramentas do GKE |
| Compute Engine | Todas as GPUs NVIDIA disponíveis | Todas as TPUs do Google disponíveis | Autogerenciado | Manual | Manual ou automático usando MIGs |
| Google Kubernetes Engine (GKE) | Todas as GPUs NVIDIA disponíveis | Todas as TPUs do Google disponíveis | Gerenciado pelo Google (Autopilot) ou semigerenciado (Standard) | Kubernetes | Escalonamento automático de pods e nós |
| VMware Engine | Não | Não | Gerenciada pelo Google | Plataforma VMware | Manual usando nós ESXi |
Conheça o Hipercomputador de IA para IA e ML
O Hipercomputador de IA é uma arquitetura integrada que combina hardware criado para fins específicos, software aberto e modelos de consumo flexíveis. Essa arquitetura foi projetada para aumentar sua produtividade de ML e maximizar o goodput, a taxa de dados úteis transferidos, para cargas de trabalho de IA exigentes.
O Hipercomputador de IA oferece os seguintes recursos:
Suporte a aceleradores: o Hipercomputador de IA é compatível com todas as GPUs NVIDIA e TPUs do Google. Os aceleradores se conectam por redes de alta largura de banda para otimizar a capacidade de processamento de modelos de IA em milhares de instâncias de computação.
Controle do SO e do kernel: seu controle sobre o SO e o kernel depende da ferramenta de implantação escolhida:
Ambientes gerenciados pelo Google: se você escolher o Cluster Director, o Google vai gerenciar o ambiente e o ciclo de vida do cluster. Se você escolher o GKE no modo Autopilot, o Google vai gerenciar o ambiente de contêiner.
Ambientes autogerenciados: se você escolher o Cluster Toolkit, o Compute Engine ou o GKE no modo Standard, você vai gerenciar os recursos do cluster e o SO.
Orquestração: use o Slurm, o GKE ou orquestradores personalizados para adicionar ou remover instâncias de computação, pods ou contêineres no cluster quando a demanda de computação mudar.
Para mais informações, consulte Visão geral do Hipercomputador de IA.