


本文件提供參考架構,說明如何為多個 AI 模型建立統一的前端,這些模型可託管於地端部署環境或任何供應商,包括第三方和 Google Cloud。如果所有推論伺服器都託管於 Google Kubernetes Engine (GKE),請參閱「在 GKE 上提供 AI 推論模型的網路」。
這項架構可讓開發人員選取模型,而不必為每個模型指定個別 IP 位址。而是將包含模型名稱的 OpenAI API 要求傳送至前端端點。架構中的系統會將要求轉送至託管指定模型的後端。架構中的前端負載平衡器提供下列集中管理功能:
- 無論您如何託管模型,所有模型呼叫都使用單一前端端點。
- API 管理功能。
- AI 防護機制的檢查點。
- Service Extensions 插入點,方便日後擴充。
本文適用對象為網路管理員和生成式 AI 應用程式管理員,說明如何將新的或現有的生成式 AI 模型,置於單一推論端點後方。本文件不會說明如何設計應用程式或部署個別生成式 AI 模型。如要瞭解如何部署模型,請參閱「在企業中建構及部署生成式 AI 和機器學習模型」。這項架構適用於應用程式網路架構,例如分散式應用程式適用的 Cross-Cloud Network 和其他設計。
架構
下圖顯示的架構中,用戶網路中的端點指向區域性內部應用程式負載平衡器前端。這個負載平衡器會使用指定模型的名稱,將要求轉送至託管於地端部署或任何供應商的模型副本集。前端負載平衡器會為所有託管模型提供整合式服務。
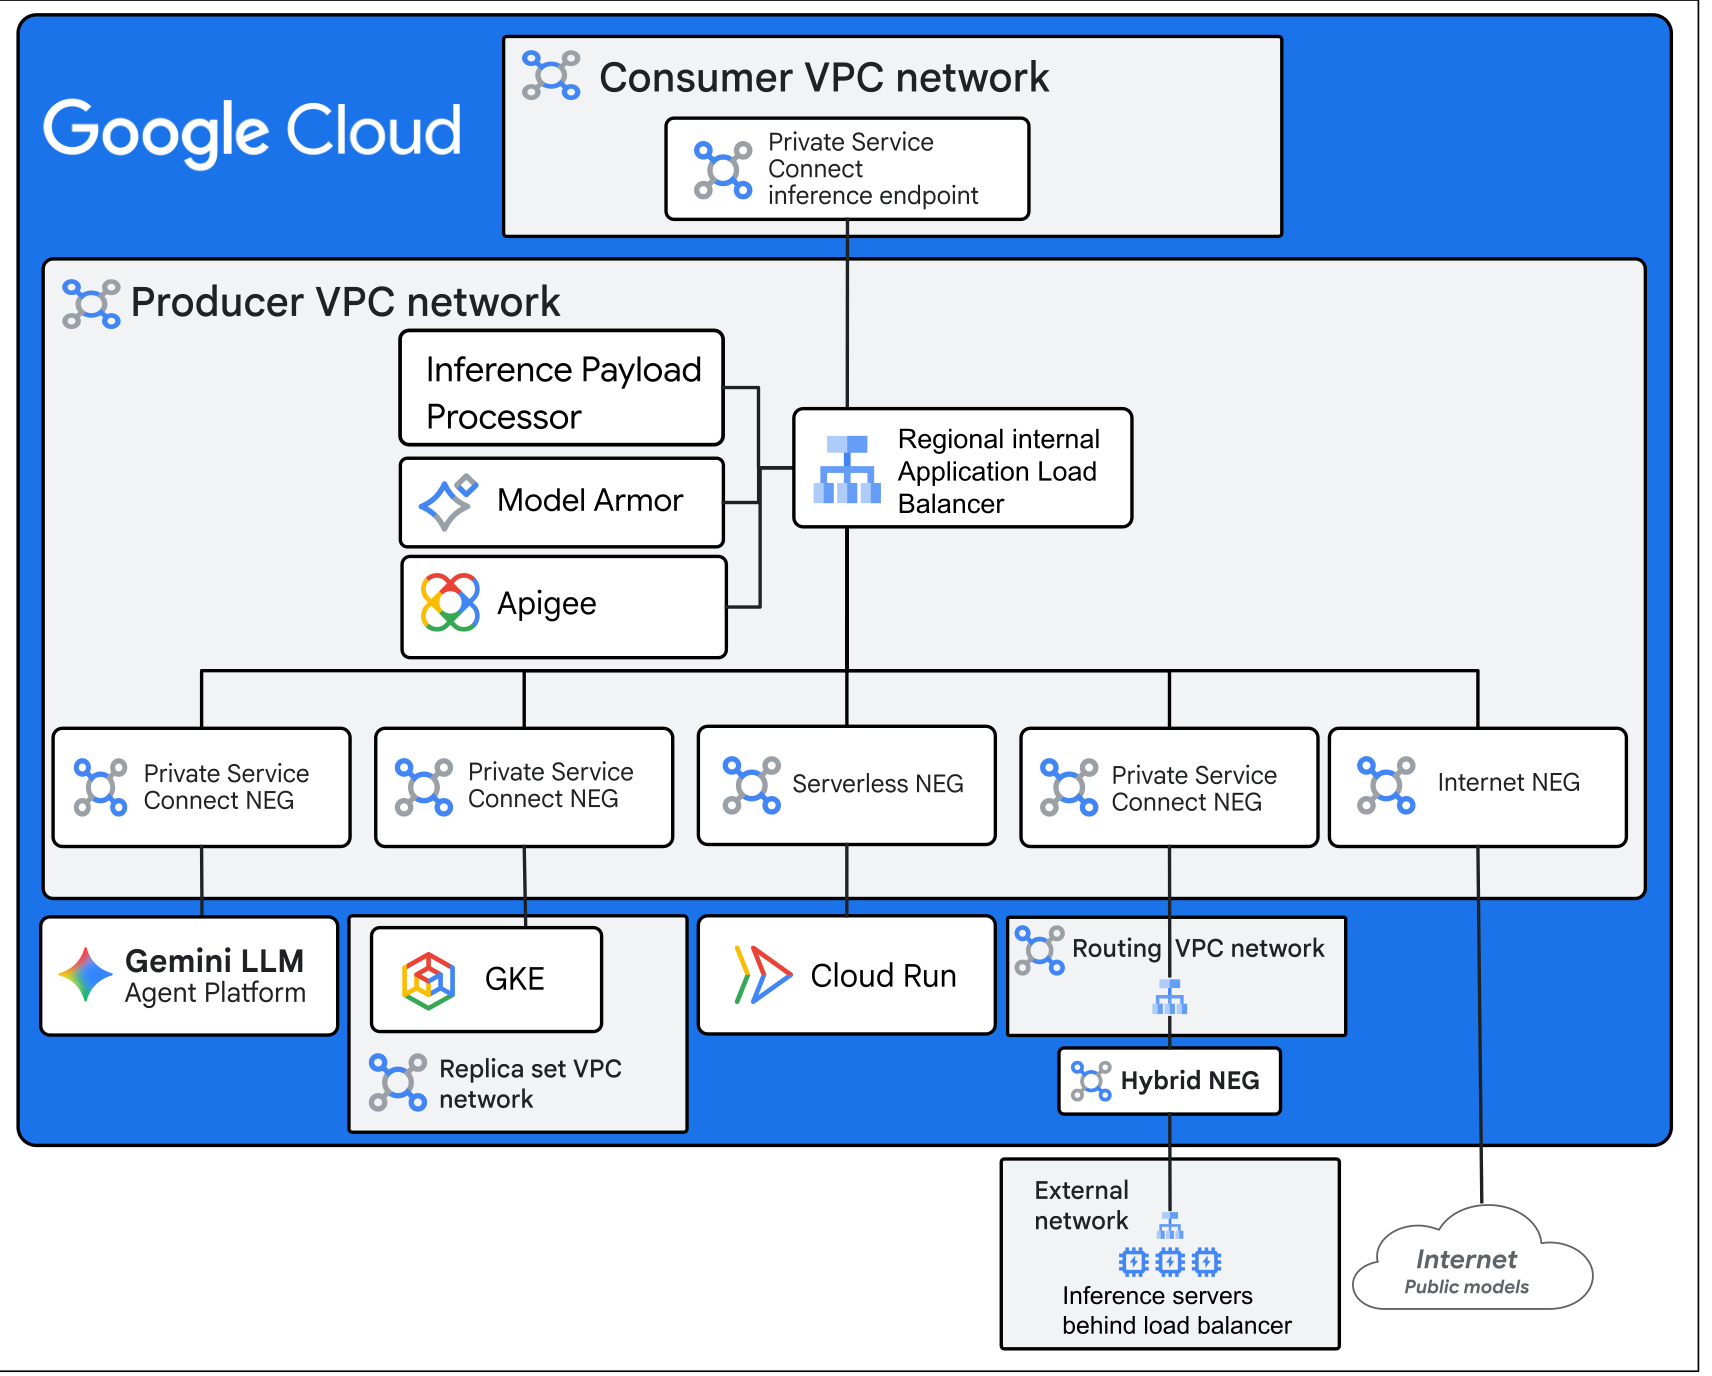
圖中的架構包含下列元件:
- Private Service Connect 推論端點:所有託管模型的統一端點。使用者會將推論要求傳送至端點 IP 位址。圖表顯示單一用戶虛擬私有雲 (VPC) 網路中的 Private Service Connect 端點。您可以在多個虛擬私有雲網路或共用服務虛擬私有雲網路中託管端點。
- 區域性內部應用程式負載平衡器:在這個架構中,前端負載平衡器是區域性內部應用程式負載平衡器。前端負載平衡器會根據要求中指定的模型名稱,將流量轉送至副本集區。在這個架構中,客戶應用程式會向負載平衡器發出 OpenAI API 呼叫。如果後端推論伺服器與 OpenAI API 相容,則可直接運作。如果推論伺服器與 OpenAI API 不相容,則必須使用服務擴充功能實作 API 轉譯器。這個參考架構不包含 API 轉譯器的實作。
- Service Extensions 呼叫:您可以使用呼叫,為應用程式負載平衡器新增額外處理作業。這項設計的架構使用下列呼叫:
- 推論酬載處理器 (先前稱為主體型路由器):推論酬載處理器部署於 Cloud Run。它會從 OpenAI API 要求的內文讀取模型名稱,並寫入標頭的
X-Gateway-Model-Name欄位。負載平衡器網址對應會使用這個欄位,將要求轉送至適當的後端服務。本參考架構提供的 Terraform 部署項目包含推論酬載處理器設定。 - Apigee:API 管理工具,提供 API 驗證、安全性、頻率限制、配額追蹤和其他 API 管理服務。這個架構使用 Apigee,但支援其他選項。如要從負載平衡器呼叫 Apigee,架構和 Terraform 部署作業會使用 Service Extensions 流量擴充功能呼叫 Apigee 擴充功能處理器。
- Model Armor:AI 防護系統,會在推論提示傳送至推論伺服器前,先進行安全檢查。接著,系統會對輸出的回覆進行安全檢查。這個架構使用 Model Armor 做為 AI 護欄,但也支援其他選項,例如 NVIDIA NeMo Guardrails。本參考架構提供的 Terraform 部署作業包含基本的 Model Armor 設定。
- 推論酬載處理器 (先前稱為主體型路由器):推論酬載處理器部署於 Cloud Run。它會從 OpenAI API 要求的內文讀取模型名稱,並寫入標頭的
- 後端服務:負載平衡器會根據要求中的模型名稱,將要求轉送至後端服務。後端服務包含網路端點群組 (NEG)。
- 模型副本集:模型副本是部署至一或多個 GPU 或 TPU 的推論伺服器副本。模型副本可以是單一節點或多節點。「副本集」是一組統一的模型副本,由負載平衡器前端。在架構中,模型副本包含在 GKE Inference Gateway 後方的 GKE 叢集、Gemini Enterprise Agent Platform、Cloud Run、地端部署或其他雲端資料中心,以及網際網路端點後方。
模型副本集設定
在這個架構中,前端負載平衡器會根據模型名稱,將流量導向特定後端服務。指定模型的推論伺服器可託管於下表所述的其中一種設定。
| Replica Set 類型 | 說明 | 副本負載平衡 |
|---|---|---|
| Agent Platform | 模型副本會在 Agent Platform 執行。您會將 Agent Platform 端點發布為 Private Service Connect 網路端點群組 (NEG)。前端負載平衡器會將 Private Service Connect NEG 做為每個不同模型的後端,每個模型則會結構化為後端服務。 | Agent Platform 會在內部調整資源配置及負載平衡。Agent Platform 會根據指標執行加權負載平衡,並依據前置字元快取進行轉送,藉此提高資源使用率並加快推論速度。詳情請參閱「將模型部署至端點」。 |
| GKE | 推論伺服器會以 Pod 的形式,在 GKE 副本集虛擬私有雲網路的 GKE 叢集中執行。GKE 中的多個模型副本會共同在 Inference Gateway 後方形成單一後端。推論閘道會發布 Private Service Connect 端點,前端負載平衡器則會使用 Private Service Connect NEG 存取該端點。 | Inference Gateway 為 GKE 叢集中的推論後端提供模型感知負載平衡。Inference Gateway 會在適用時使用前置字元快取感知轉送。否則,Inference Gateway 會根據要求佇列長度、鍵/值 (KV) 快取使用率,以及 GPU 或 TPU 使用率分配要求。這項設定支援水平自動調度 Pod 資源。 |
| Cloud Run | 推論伺服器會在 Cloud Run 中執行。Cloud Run 會發布端點,前端負載平衡器會使用無伺服器 NEG 存取該端點。 | Cloud Run 會根據流量自動調整副本數量。僅限單一節點副本。 |
| 混合式 | 推論伺服器在地端部署環境或其他雲端中執行。在路由虛擬私有雲網路中,設定區域性內部 Proxy 網路負載平衡器。這個負載平衡器會發布 Private Service Connect 端點,前端負載平衡器則會使用 Private Service Connect NEG 存取該端點。轉送虛擬私有雲網路中的內部負載平衡器,則具有混合式 NEG 後端,指向地端部署推論伺服器前端的地端部署或其他雲端負載平衡器 IP 位址。 | 外部負載平衡器的負載平衡機制是由外部設施的管理員設定。 |
| 網際網路 | 可透過公開網際網路 IP 位址存取的推論伺服器。前端負載平衡器具有網際網路 NEG 後端,指向託管於網際網路的模型 IP 位址。 | 代管服務供應商會處理資源調度。 |
要求流程
系統會按照下列方式轉送推論要求:
- 使用者將 OpenAI API 要求傳送至 Private Service Connect 端點。這項要求包含下列內容:
- 提示詞。
- 模型名稱,必須與其中一個託管推論伺服器的模型名稱相符。
- Private Service Connect 端點會將要求轉送至前端內部應用程式負載平衡器。
- 負載平衡器會將要求轉送至 Service Extensions。
- Service Extensions 推論酬載處理器程式碼會從要求主體讀取模型名稱,並寫入
X-Gateway-Model-Name標頭。 - 負載平衡器會使用 Service Extensions 流量擴充功能呼叫,將要求傳送至 API 管理系統,以取得所需的 API 管理服務。
- 負載平衡器會使用 Service Extensions 流量擴充功能呼叫,將提示傳送至 Model Armor 進行篩選。
- 如果提示包含無法遮蓋的私密資訊,系統會封鎖提示,Model Armor 則會傳回回覆,指出發現違反政策。
- 如果提示包含可遮蓋的私密資訊,或提示完全沒有問題,Model Armor 會遮蓋所有私密資訊,並轉送提示。
- 如果 Model Armor 允許要求,負載平衡器會參考網址對應,並根據模型名稱自訂標頭,將要求轉送至後端服務。如有需要,網址對應會重寫要求的網址和路徑,以符合後端需求。
- 後端服務會將要求轉送至相關聯的副本集負載平衡器。
- 特定推論服務的負載平衡器會將要求指派給其中一個副本。
- 副本會處理要求並傳回回應。
- 前端區域性內部應用程式負載平衡器會將回覆傳送至 Model Armor 進行篩選。
- 應用程式負載平衡器會將回應傳回 Private Service Connect 端點,再傳送給使用者。
下圖顯示範例部署作業的轉送檢視畫面:
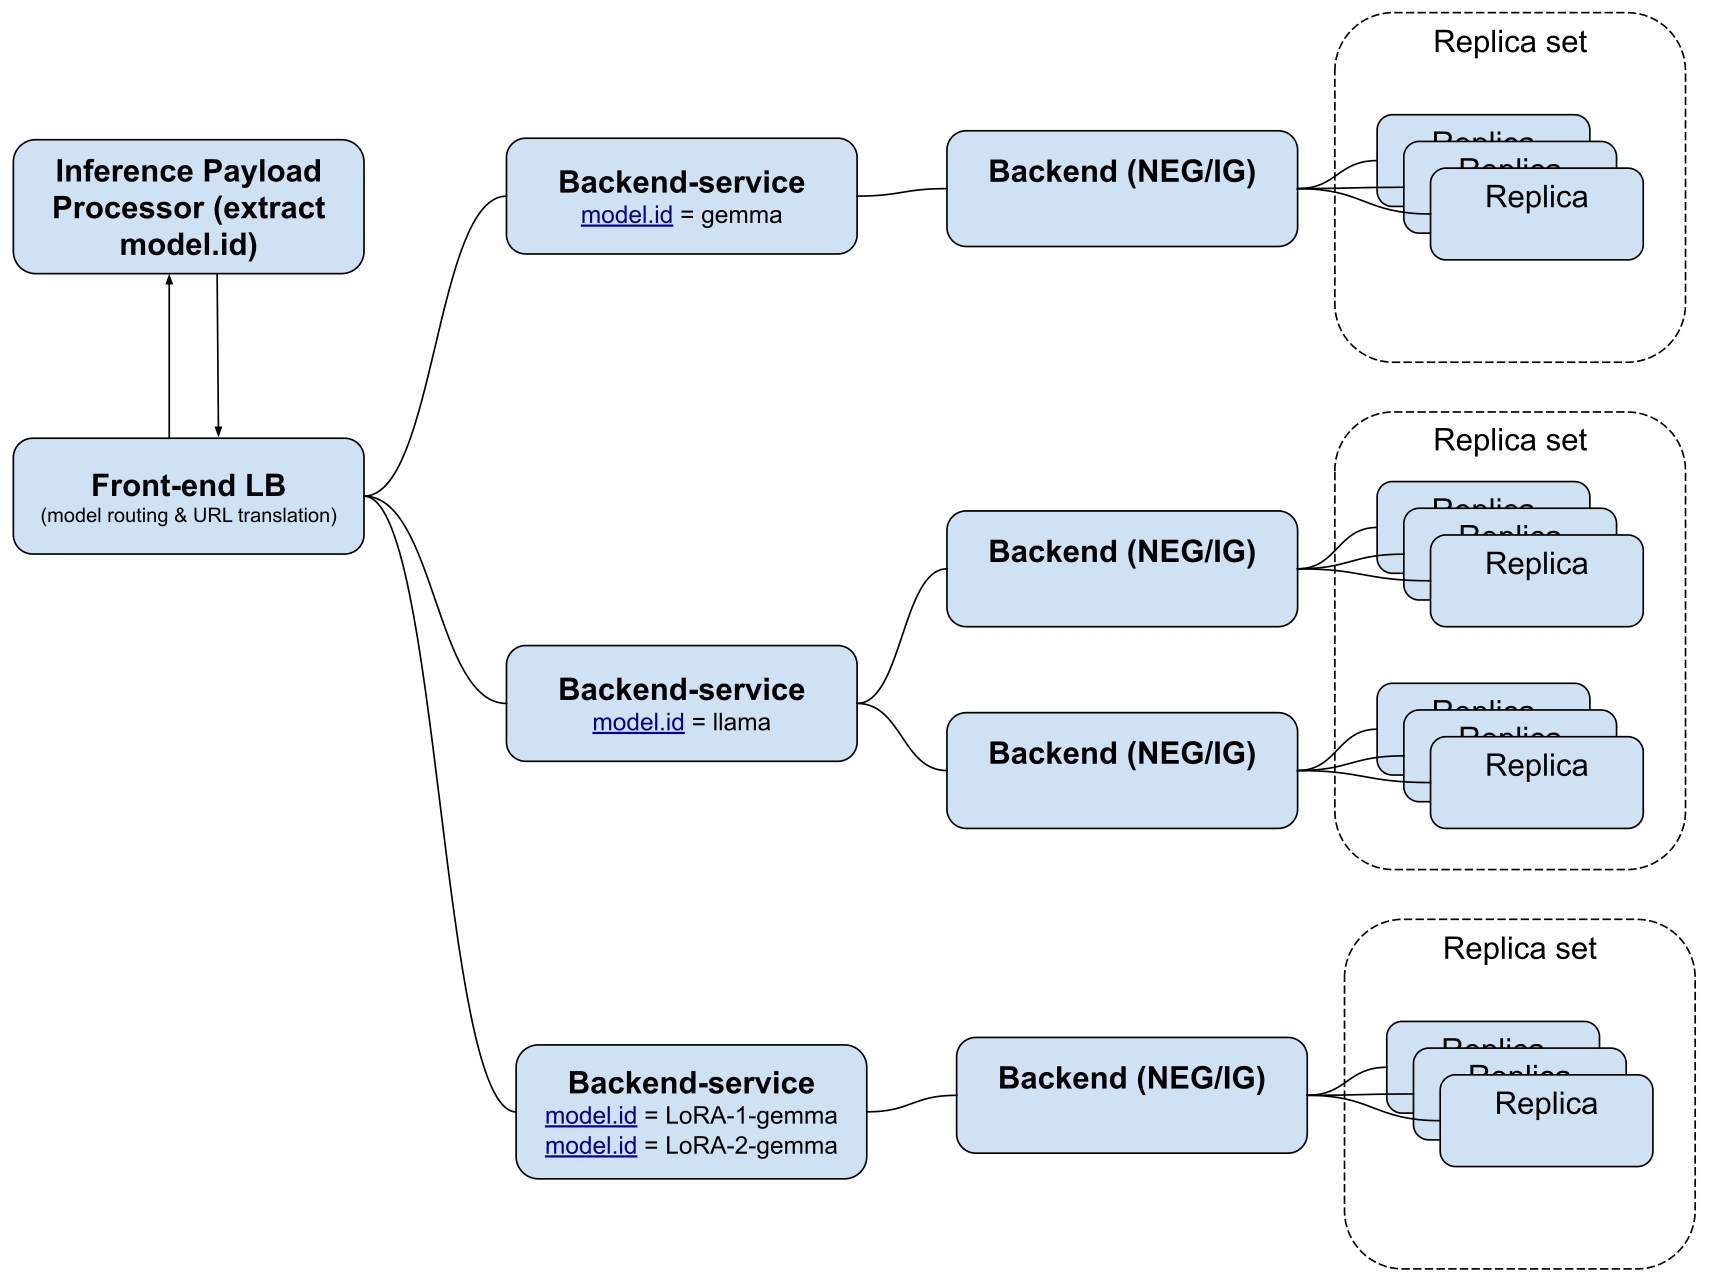
在這個範例中,系統會根據使用者選取的模型處理提示:
- Gemma:所有提示都會轉送至託管 Gemma 模型的副本集。
- Llama:系統會將這些提示平均分配給兩個託管 Llama 模型的副本集,這兩個副本集不一定要以相同方式託管。舉例來說,一個副本集可以託管在 Agent Platform,另一個副本集則託管在 GKE。
- LoRA-1-gemma 或 LoRA-2-gemma:系統會將所有提示傳送至同一個副本集,該副本集可處理這兩個模型。
使用的產品
本文件中的參考架構使用下列 Google Cloud 產品:
- Cloud Load Balancing:高效能、可擴充的全球和區域負載平衡器組合。
- 虛擬私有雲 (VPC):虛擬系統,為 Google Cloud 工作負載提供全球性、可擴充的網路功能。虛擬私有雲包含虛擬私有雲網路對接、Private Service Connect、私人服務存取權和 Shared VPC。
- Private Service Connect:這項功能可讓用戶從虛擬私有雲網路內部,以不公開的方式存取代管服務。
- Cloud Run:無伺服器運算平台,可讓您直接在 Google 可擴充的基礎架構上執行容器。
- Apigee:API 管理工具,可讓您精細控管 API 的存取和使用方式。提供安全性、頻率限制、配額強制執行和數據分析功能。
- Model Armor:這項服務可保護生成式和代理式 AI 資源,防範提示詞注入、敏感資料外洩和有害內容。
設計替代方案
本節說明此架構部分基本假設的替代方案。
AI 防護機制
建議您使用 Model Armor 做為 AI 護欄。為集中管理,建議您直接從負載平衡器呼叫,如這個架構所示。您也可以透過下列方式導入 Model Armor:
- 使用 API 管理政策呼叫 Model Armor。
- 僅在副本部署 Model Armor。
如果您在模型端點以外的位置實作 AI 防護機制,則可在不需要時,於前端負載平衡器關閉 Model Armor。如果不想使用 Model Armor,可以透過流量擴充功能部署其他護欄產品,例如 NVIDIA NeMo Guardrails。
API 管理
本文中的架構使用 Apigee 進行 API 管理,並透過 Service Extensions 部署。如果 Apigee 不符合需求,您可以使用 Service Extensions 部署其他 API 管理服務。
如果使用 Service Extensions 部署 API 管理功能不符合您的需求,您可能需要部署用戶端網路和 API 網路。在這個情境中,API 管理服務會做為兩個網路之間的橋梁。如要瞭解如何為 Apigee 部署這項功能,請參閱「Apigee 網路選項」。
連線到其他網路
本文件中的架構使用單一用戶虛擬私有雲網路。不過,您可以在Cross-Cloud Network 部署中使用服務存取虛擬私有雲網路,與許多其他網路共用 Private Service Connect 端點。
設計須知
本節說明符合 Google Cloud Well-Architected Framework 的設計因素、最佳做法和建議。使用這項參考架構開發拓撲時,請考量這些資訊,確保拓撲符合您在安全性、可靠性、成本最佳化、作業效率和效能方面的特定需求。
安全性、隱私權和法規遵循
基準架構會將推論流量隔離在 Private Service Connect 端點後方、透過 Apigee 強制執行 API 政策,並使用 Model Armor 篩選提示。如要進一步強化多後端推論拓撲,並符合隱私權和法規遵循要求,請考慮下列建議:
- 邊緣和應用程式層防護:如要新增分散式阻斷服務 (DDoS) 防護、網頁應用程式防火牆 (WAF) 規則和 IP 位址檢查,請將 Google Cloud Armor 安全性政策附加至前端區域性內部應用程式負載平衡器。
- 零信任存取權和邊界控管:
- 如要在所有後端新增通用驗證層,請導入 Identity-Aware Proxy (IAP),驗證身分並強制執行授權政策。
- 如要對負載平衡器轉送規則強制執行精細存取規則,請設定授權政策。
- 為防止資料從供應商虛擬私有雲網路和模型端點外洩,請設定 VPC Service Controls service perimeter。如要在 perimeter 內私下連線至區域性 Model Armor API,請建立區域性 Private Service Connect 端點。
- 後端身分和驗證:將網頁應用程式的流量轉送至 Agent Platform 模型時,必須選擇驗證身分模型:
- 服務帳戶身分 (建議用於一般網頁應用程式):應用程式會透過 IAP 驗證使用者。接著,系統會使用 Workload Identity (例如 Cloud Run、GKE 或第三方身分) 呼叫 Agent Platform。這項實作會從使用者中抽象化 Identity and Access Management (IAM),但需要應用程式層級記錄,才能追蹤產生各個提示的使用者。
- 使用者身分傳遞 (建議用於嚴格稽核):應用程式會擷取使用者的 Google OAuth 存取權杖,並在
Authorization: Bearer標頭中直接傳遞至 Agent Platform。這項實作會提供內建的 Cloud 稽核記錄,記錄使用者動作。不過,每位使用者都必須佈建 IAM 權限 (例如roles/aiplatform.user)。
- 自訂提示和回覆範本:如要偵測及遮蓋提示和回覆中的自訂機密資料類型,請在 Model Armor 中設定進階 Sensitive Data Protection 範本。由於 Model Armor 負載平衡器呼叫會忽略串流 OpenAI API 回應,因此在串流權杖時,請在應用程式或後端強制執行回應篩選。
- 代理身分和管理:
- 如果自主式 AI 代理或 Model Context Protocol (MCP) 工具傳送或接收推論流量,請使用 Agent Gateway 管理這些互動。
- 如要將加密編譯 SPIFFE 身分和繫結憑證指派給代理,請使用 Agent Identity。
可靠性
基準架構會在區域、混合和外部模型副本集前方,部署區域性內部應用程式負載平衡器和 Service Extensions 呼叫。如要在流量高峰、呼叫冷啟動,以及區域或混合式連線能力服務中斷期間提高可用性,請考慮下列建議:
- 多區域容錯移轉:為防範區域性故障,請使用Google Cloud 多區域部署原型,將部署作業複製到第二個區域。如要評估跨區域內部應用程式負載平衡器,請確認 Google 服務呼叫支援的負載平衡器,因為 Model Armor 流量擴充功能需要區域性應用程式負載平衡器。
- 呼叫可用性:由於每項要求都仰賴推論酬載處理器呼叫來設定轉送標頭,因此請在 Cloud Run 服務上設定執行個體數量下限。
- 預留推論容量:為避免流量暴增時配額用盡,請使用佈建輸送量或 Compute Engine 預留項目預留容量。
- 備援混合式連線:如果是混合式副本集,請在多個區域設定備援 Cloud Interconnect VLAN 連結或高可用性 Cloud VPN 通道。
成本最佳化
在多後端推論成本中,通常以權杖用量、加速器容量和跨區域資料移轉占最大比例。如要控管權杖用量、減少多餘的模型呼叫,以及最佳化運算和網路支出,請參考下列建議:
- 詞元配額和限制:如要控管每位消費者或應用程式的詞元推論支出,請在 Apigee API Proxy 中強制執行
LLMTokenQuota和PromptTokenLimit政策。 - 語意和脈絡快取:
- 如要減少語意相似提示詞的多餘模型叫用,請使用向量搜尋設定 Apigee
SemanticCacheLookup和SemanticCachePopulate政策。 - 如要在 Agent Platform 重複使用系統指令,請啟用脈絡快取。
- 如要減少語意相似提示詞的多餘模型叫用,請使用向量搜尋設定 Apigee
- 區域共置:為避免跨區域資料移轉費用,請將前端區域性內部應用程式負載平衡器、Apigee 執行階段、Model Armor 範本和 Google Cloud 副本集,共置於相同區域。
- 加速器使用率:如要提高加速器使用率,請在 GKE 上使用 Dynamic Workload Scheduler,或在 Agent Platform 上共同託管模型。
提升作業效率
如要操作多後端推論平台,必須掌握負載平衡器轉送、Service Extensions 呼叫、後端模型指標和混合網路路徑。如要簡化第 2 天的監控、疑難排解和模型探索作業,請參考下列建議:
- 統一流量和後端觀測能力:
- 如要監控流量,以便快速找出並解決問題,請使用區域性內部應用程式負載平衡器的 Cloud Logging 記錄。
- 如要檢查 Service Extensions 呼叫的延遲時間和錯誤,請查看
serviceExtensionInfo記錄欄位和呼叫指標。 - 如要追蹤各後端的推論延遲時間、佇列深度和 KV 快取命中率,請使用 Cloud Monitoring、Inference Gateway 資訊主頁和代理平台模型觀測能力。
- 網路路徑診斷:如要診斷私人和混合網路路徑,請使用 Network Intelligence Center。
- 模型目錄探索:為方便探索貴組織支援的模型,請實作可查詢的清單,傳回可用的模型。舉例來說,您可以在伺服器上建立清單,回應列出模型 API 呼叫。
效能最佳化
推論延遲時間和處理量取決於各後端載入模型權重、調度執行個體資源,以及排定副本要求的方式。如要減少冷啟動延遲、縮短第一個詞元生成時間 (TTFT),以及提高服務處理量,請參考下列建議:
- Cloud Run 模型載入和資源調度:
- 如果模型小於 10 GB,您可以將模型權重儲存在容器映像檔中,加快執行個體啟動速度。
- 如果是較大的模型,請透過直接虛擬私有雲輸出和 Private Google Access,從 Cloud Storage 載入模型權重,並考慮使用 Rapid Cache 縮短讀取延遲時間。
- Cloud Run 會根據 CPU 和並行數量 (而非 GPU 使用率) 調整 GPU 執行個體,因此請調整每個執行個體的並行要求數量上限。
- GKE 推論服務和轉送:
- 請按照「GKE 推論最佳做法總覽」中的建議操作。
- 如要在可變負載下最佳化 TTFT 和每個輸出詞元的時間 (TPOT),請在 Inference Gateway 中設定服務優先順序和預測延遲時間型轉送。
部署作業
如要部署這個架構的範例實作,請使用 GitHub 提供的用於 AI 推論模型服務的網路程式碼範例。
如要瞭解如何部署 AI 模型,請參閱下列資源:
後續步驟
- 如要瞭解如何在部署作業中新增檢索增強生成功能,請參閱「支援 RAG 的生成式 AI 應用程式私人連線」。
- 如要查看更多參考架構、圖表和最佳做法,請瀏覽 Cloud Architecture Center。
貢獻者
作者:Cloud Networking 產品經理 Victor Moreno
其他貢獻者:
- Mark Schlagenhauf | 網路技術文件撰稿者
- James Duncan | 解決方案產品經理
- Ammett Williams | 開發人員關係工程師