


שירותי התשתית שלGoogle Cloud פועלים במיקומים שונים ברחבי העולם. המיקומים מחולקים לדומיינים של כשל, שנקראים אזורים ותחומים (zones). אלה אבני הבניין הבסיסיות לתכנון תשתית אמינה לעומסי העבודה בענן.
דומיין כשל הוא משאב או קבוצת משאבים שיכולים להיכשל בלי קשר למשאבים אחרים. מכונה וירטואלית עצמאית ב-Compute Engine היא דוגמה למשאב שהוא דומיין כשל. אזור או תחום (zone) ב- Google Cloud הם דוגמה לדומיין כשל שמורכב מקבוצת משאבים. כשמפיצים אפליקציה באופן יתיר בדומיינים של כשל, אפשר להשיג רמת זמינות מצטברת גבוהה יותר מזו שמספק כל דומיין של כשל.
בחלק הזה של המדריך לאמינות התשתית ב-Google Cloud מתוארים אבני הבניין של האמינות ב- Google Cloud ואיך הם משפיעים על הזמינות של המשאבים בענן.
אזורים ותחומים
אזורים הם מיקומים גיאוגרפיים עצמאיים שמחולקים לתחומים (zones). האזורים והתחומים הם הפשטות לוגיות של המשאבים הפיזיים שעומדים בבסיס מרכזי הנתונים. למידע נוסף על שיקולים ספציפיים לאזור, קראו את המאמר מיקום גיאוגרפי ואזורים.
זמינות בפלטפורמות השונות
התשתית שלGoogle Cloud מתוכננת להתמודד עם כשלים ולהתאושש מהם. Google משקיעה כל הזמן בגישות חדשניות כדי לשמור על האמינות של Google Cloudולשפר אותה. היכולות הבאות של התשתית שלGoogle Cloud עוזרות לספק פלטפורמה אמינה לעומסי העבודה בענן:
- אזורים שמופרדים גיאוגרפית כדי לצמצם את ההשפעות של אסונות טבע והפסקות זמניות בשירות האזורי על שירותים גלובליים.
- יתירות חומרה ורפליקציה כדי למנוע נקודות כשל בודדות.
- מיגרציה פעילה של משאבים במהלך אירועי תחזוקה. לדוגמה, במהלך תחזוקה מתוכננת של התשתית, אפשר להעביר מכונות וירטואליות של Compute Engine למארח אחר באותו אזור באמצעות מיגרציה פעילה.
- תשתית מאובטחת משלב התכנון לתשתית הפיזית ולתוכנה שבהן פועל Google Cloud , ואמצעי בקרה תפעוליים לאבטחה כדי להגן על הנתונים ועל עומסי העבודה שלכם. למידע נוסף, קראו את הסקירה הכללית על תכנון האבטחה בתשתית של Google.
- רשת בשדרה מרכזית עם ביצועים גבוהים, שמשתמשת בגישה מתקדמת של שירותי Networking מוגדרי-תוכנה (SDN) לניהול הרשת, עם שירותי שמירה במטמון קצה כדי לספק ביצועים עקביים שניתנים להרחבה.
- מעקב ודיווח רציפים. בלוח הבקרה של סטטוס שירותיGoogle Cloud אפשר לראות את הסטטוס של שירותיGoogle Cloud בכל מיקום.
- אירועי בדיקה של תוכנית התאוששות מאסון (DR) שנתיים בכל החברה, כדי לוודא ששירותי Google Cloud והפעילות העסקית הפנימית ימשיכו לפעול בזמן אסון.
- גישה לניהול שינויים שמדגישה את האמינות בכל השלבים של מחזור החיים של פיתוח התוכנה, לכל שינוי בפלטפורמה ובשירותים של Google Cloud .
התשתית שלGoogle Cloud נועדה לתמוך ברמות הזמינות הבאות, שמתאימות לרוב עומסי העבודה של הלקוחות:
| מיקום הפריסה | זמינות (זמן פעולה תקינה) % | זמן ההשבתה המקסימלי המשוער |
|---|---|---|
| תחום אחד | 3 תשיעיות: 99.9% | 43.2 דקות בחודש של 30 ימים |
| כמה אזורים באותו מחוז | 4 תשיעיות: 99.99% | 4.3 דקות בחודש של 30 ימים |
| מספר אזורים | 5 תשיעיות: 99.999% | 26 שניות בחודש של 30 ימים |
אחוזי הזמינות בטבלה שלמעלה הם יעדים. הסכמי רמת השירות (SLAs) לזמן הפעולה התקינה של שירותי Google Cloud ספציפיים עשויים להיות שונים מיעדי הזמינות האלה. לדוגמה, הסכם רמת השירות (SLA) לזמן הפעולה התקינה של מכונה ב-Bigtable תלוי במספר האשכולות, בפיזור שלהם בין המיקומים ובמדיניות הניתוב שהגדרתם.
המינימום של הסכם רמת השירות (SLA) לזמן פעולה תקינה של מכונה ב-Bigtable עם אשכולות בשלושה אזורים או יותר הוא 99.999%, אם מוגדרת מדיניות הניתוב multi-cluster. אבל אם מוגדרת מדיניות ניתוב לאשכול יחיד, הסכם רמת השירות המינימלי לזמן פעולה תקינה הוא 99.9%, בלי קשר למספר האשכולות ולפיזור שלהם.
בתרשימים שבקטע הזה מוצגים מכונות של Bigtable עם אשכולות בגדלים שונים, וההבדלים שנובעים מכך בהסכמי ה-SLA של זמן הפעולה התקינה.
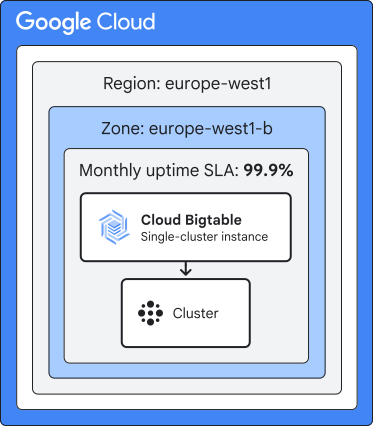
אשכול יחיד
הדיאגרמה הבאה מציגה מכונה של Bigtable עם אשכול יחיד, עם הסכם רמת שירות (SLA) של זמן פעולה תקינה מינימלי של 99.9%:
כמה אשכולות
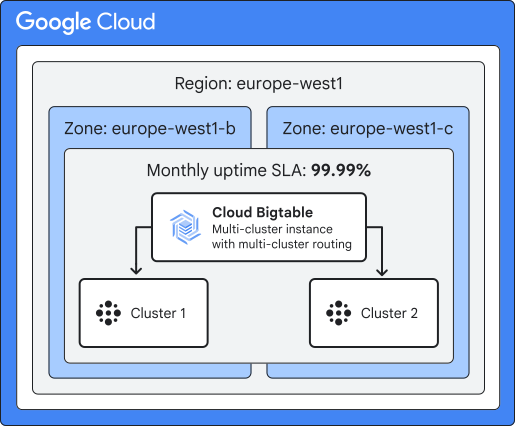
בתרשים הבא מוצג מכונה של Bigtable עם כמה אשכולות בכמה אזורים בתוך אזור אחד, עם ניתוב לכמה אשכולות (הסכם רמת שירות מינימלי לזמן פעולה תקינה: 99.99%):
כמה אשכולות
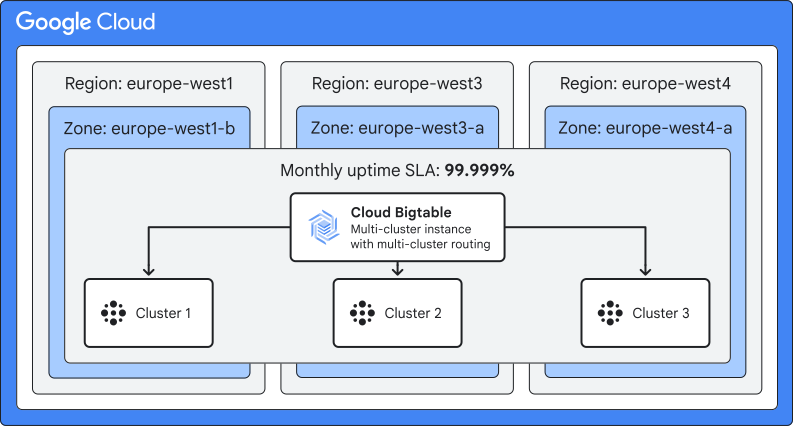
בתרשים הבא מוצג מכונה של Bigtable עם כמה אשכולות בשלושה אזורים, עם ניתוב לכמה אשכולות (הסכם רמת שירות מינימלי לזמן פעולה תקינה: 99.999%):
זמינות התשתית המצטברת
בקטע הזה מוסבר איך לחשב את הזמינות המצטברת של מקבץ תשתית ב- Google Cloud. הוא מתאר את הגורמים שמשפיעים על הזמינות המצטברת ומספק דוגמאות לחישובים.
כדי להריץ את האפליקציות ב- Google Cloud, אתם משתמשים במשאבי תשתית כמו מכונות וירטואליות ומסדי נתונים. משאבי התשתית האלה מרכיבים יחד את מחסנית התשתית של האפליקציה. בתרשים הבא מוצגת דוגמה למקבץ תשתיות ב- Google Cloud , והסכם רמת השירות לזמינות של כל משאב במקבץ:
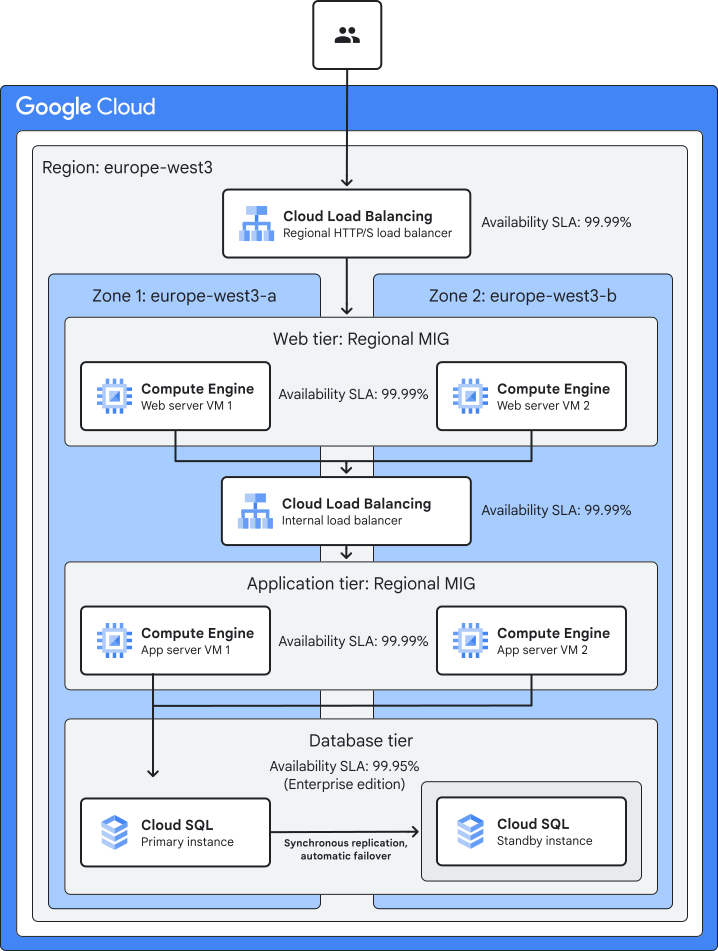
מקבץ התשתית לדוגמה כולל את המשאבים הבאים של Google Cloud:
- מאזן עומסים חיצוני אזורי של אפליקציות (ALB) מקבל בקשות ממשתמשים ומגיב להן.
- קבוצת מופעי מכונה מנוהלים (MIG) אזורית היא הבק-אנד של מאזן העומסים החיצוני האזורי של אפליקציות (ALB). קבוצת ה-MIG מכילה שתי מכונות וירטואליות של Compute Engine באזורים שונים. כל מכונה וירטואלית מארחת מכונה של שרת אינטרנט.
- מאזן עומסים פנימי מטפל בתקשורת בין שרתי האינטרנט לבין שרתי האפליקציות.
- קבוצת MIG אזורית שנייה היא הקצה העורפי של מאזן העומסים הפנימי. בקבוצת המכונות הווירטואליות המנוהלת הזו יש שתי מכונות וירטואליות של Compute Engine באזורים שונים. כל מכונה וירטואלית מארחת מכונה של שרת אפליקציות.
- מכונה של Cloud SQL שמוגדרת לזמינות גבוהה היא מסד הנתונים של האפליקציה. מופע מסד הנתונים הראשי משוכפל באופן סינכרוני למופע מסד נתונים במצב המתנה.
הזמינות המצטברת שאפשר לצפות לה ממקבץ תשתית כמו בדוגמה הקודמת תלויה בגורמים הבאים:
Google Cloud הסכמי רמת שירות (SLA)
הסכמי ה-SLA של זמן הפעולה התקינה של שירותי Google Cloud שבהם אתם משתמשים במקבץ התשתית, משפיעים על הזמינות המצטברת המינימלית שאפשר לצפות לה מהמקבץ.
בטבלאות הבאות מוצגת השוואה בין הסכמי רמת השירות (SLA) של זמן הפעולה התקינה בחלק מהשירותים:
| שירותי Compute | הסכם רמת השירות לזמן פעולה תקינה חודשי | זמן ההשבתה המקסימלי המשוער בחודש של 30 ימים |
|---|---|---|
| מכונה וירטואלית של Compute Engine | 99.9% | 43.2 דקות |
| פודים של Google Kubernetes Engine (GKE) Autopilot בכמה אזורים | 99.9% | 43.2 דקות |
| שירות Cloud Run | 99.95% | 21.6 דקות |
| שירותי מסדי נתונים | הסכם רמת השירות לזמן פעולה תקינה חודשי | זמן ההשבתה המקסימלי המשוער בחודש של 30 ימים |
|---|---|---|
| מכונה של Cloud SQL ל-PostgreSQL (מהדורת Enterprise, הגדרת HA) | 99.95% | 21.6 דקות |
| מכונה של AlloyDB ל-PostgreSQL (הגדרת זמינות גבוהה) | 99.99% | 4.3 דקות |
| מכונה של Spanner במספר אזורים | 99.999% | 26 שניות |
למידע על הסכמי רמת השירות (SLA) של שירותי Google Cloud אחרים, קראו את המאמר הסכמי רמת השירות (SLA) שלGoogle Cloud .
כפי שמוצג בטבלאות הקודמות, שירותי Google Cloud שתבחרו לכל שכבה במקבץ התשתית משפיעים ישירות על זמן הפעולה התקינה הכולל שאתם יכולים לצפות לו ממקבץ התשתית. כדי להגדיל את הזמינות הצפויה של עומס עבודה שפרוס במשאב של Google Cloud , אתם יכולים להקצות מכונות מיותרות של המשאב, כמו שמתואר בקטע הבא.
יתירות של משאבים
יתירות של משאבים פירושה הקצאה של שני מופעים זהים או יותר של משאב, ופריסה של אותו עומס עבודה בכל המשאבים בקבוצה. לדוגמה, כדי לארח את שכבת האינטרנט של אפליקציה, אתם יכולים להקצות קבוצת MIG שמכילה כמה מכונות וירטואליות זהות של Compute Engine.
אם אתם מפיצים קבוצת משאבים באופן יתיר בכמה דומיינים של כשל – לדוגמה, שני אזורים של Google Cloud – זמינות המשאבים שאתם יכולים לצפות לה מהקבוצה הזו גבוהה יותר מהסכם ה-SLA של זמן הפעולה התקינה של כל משאב בקבוצה. הזמינות הגבוהה יותר נובעת מכך שההסתברות שכל המשאבים בקבוצה ייכשלו בו-זמנית נמוכה מההסתברות שהמשאבים בדומיין כשל יחיד ייכשלו באופן מתואם.
לדוגמה, אם הסכם רמת השירות לזמינות של משאב הוא 99.9%, ההסתברות שהמשאב ייכשל היא 0.001 (1 פחות הסכם רמת השירות). אם תפזרו עומס עבודה בין שני מופעים של המשאב הזה שמוקצים בדומיינים נפרדים של כשל, ההסתברות ששני המשאבים ייכשלו בו-זמנית היא 0.000001 (כלומר, 0.001 x 0.001). ההסתברות הזו לכשל מתורגמת לזמינות תיאורטית של 99.9999% לקבוצה של שני המשאבים. עם זאת, הזמינות בפועל שאתם יכולים לצפות לה מוגבלת לזמינות היעד של מיקום הפריסה: 99.9% אם המשאבים נמצאים באזור זמינות יחיד, 99.99% לפריסה במספר אזורי זמינות ו-99.999% אם המשאבים המיותרים מפוזרים על פני מספר אזורים.Google Cloud
עומק המחסנית
עומק מחסנית התשתית הוא מספר השכבות הנפרדות במחסנית. כל שכבה במקבץ התשתית מכילה משאבים שמספקים פונקציה נפרדת לאפליקציה. לדוגמה, השכבה האמצעית במחסנית של שלוש שכבות יכולה להשתמש במכונות וירטואליות של Compute Engine או באשכול GKE כדי לארח שרתי אפליקציות. לכל שכבה במקבץ תשתיות יש בדרך כלל תלות הדדית הדוקה בשכבות הסמוכות לה. כלומר, אם שכבה כלשהי במקבץ לא זמינה, המקבץ כולו לא זמין.
כדי לחשב את הזמינות המצטברת הצפויה של מחסנית תשתית N-tier, אפשר להשתמש בנוסחה הבאה:
לדוגמה, אם כל שכבה במחסנית של שלוש שכבות מתוכננת לספק זמינות של 99.9%, הזמינות המצטברת של המחסנית היא בערך 99.7% (0.999 x 0.999 x 0.999). כלומר, הזמינות המצטברת של מחסנית רב-שכבתית נמוכה מהזמינות של השכבה שמספקת את הזמינות הנמוכה ביותר.
ככל שמספר השכבות התלויות זו בזו במקבץ גדל, הזמינות המצטברת של המקבץ יורדת, כפי שמוצג בטבלה הבאה. לכל דוגמה של סטאק בטבלה יש מספר שונה של שכבות, וכל שכבה אמורה לספק זמינות של 99.9%.
| רמה | ערימה א' | מקבץ ב' | ערימה ג' |
|---|---|---|---|
| קצה קדמי | 99.9% | 99.9% | 99.9% |
| רמת האפליקציה | 99.9% | 99.9% | 99.9% |
| רמה בינונית | – | 99.9% | 99.9% |
| שכבת נתונים | – | – | 99.9% |
| זמינות מצטברת של המקבץ | 99.8% | 99.7% | 99.6% |
| זמן ההשבתה המקסימלי המשוער של המערכת בחודש של 30 ימים | 86 דקות | 130 דקות | 173 דקות |
סיכום של שיקולי התכנון
כשאתם מתכננים את האפליקציות, כדאי להביא בחשבון את הזמינות המצטברת של מקבץ התשתיות שלGoogle Cloud .
- הזמינות של כל Google Cloud משאב במקבץ התשתית משפיעה על הזמינות המצטברת של המקבץ. כשבוחרים שירותים של Google Cloud כדי לבנות את מחסנית התשתית, צריך להביא בחשבון את הסכם רמת השירות (SLA) של זמינות השירותים.
- כדי לשפר את הזמינות של הפונקציה (לדוגמה, מחשוב או מסד נתונים) שמשאב מסוים מספק, אפשר להקצות מופעים מיותרים של המשאב. כשמתכננים ארכיטקטורה עם משאבים מיותרים, בנוסף ליתרונות הזמינות, צריך גם להביא בחשבון את ההשפעות הפוטנציאליות על המורכבות התפעולית, זמן האחזור והעלות.
- מספר השכבות במקבץ התשתית (כלומר, עומק המקבץ) נמצא ביחס הפוך לזמינות המצטברת של המקבץ. חשוב לקחת בחשבון את הקשר הזה כשמתכננים או משנים את ה-stack.
בקטעים הבאים מפורטות דוגמאות נוספות לחישובים של זמינות מצטברת:
- חישוב לדוגמה: פריסה באזור אחד
- חישוב לדוגמה: פריסה בכמה אזורים
- חישוב לדוגמה: פריסה במספר אזורים עם איזון עומסים אזורי
- חישוב לדוגמה: פריסה במספר אזורים עם איזון עומסים גלובלי
היקפי המיקום
היקף המיקום של משאב ב- Google Cloud קובע עד כמה כשל בתשתית יכול להשפיע על המשאב. לרוב המשאבים שאתם מקצים ב- Google Cloud יש אחד מהיקפי המיקום הבאים: תחום, אזור, מספר אזורים או גלובלי.
היקף המיקום של חלק מסוגי המשאבים קבוע, כלומר אי אפשר לבחור או לשנות את היקף המיקום. לדוגמה, רשתות VPC הן משאבים גלובליים, ומכונות וירטואליות (VM) של Compute Engine הן משאבים של תחום מוגדר. במשאבים מסוימים, אפשר לבחור את היקף המיקום בזמן הקצאת המשאב. לדוגמה, כשיוצרים אשכול GKE, אפשר לבחור אם ליצור אשכול GKE אזורי או לפי אזור.
בקטעים הבאים מוסבר בפירוט על היקפי המיקום.
משאבים של תחום מוגדר
משאבים של תחום מוגדר נפרסים בתחום אחד באזור של Google Cloud. הנה כמה דוגמאות למשאבים של תחום מוגדר. זו רשימה חלקית בלבד.
- מכונות וירטואליות של Compute Engine
- קבוצות MIG של אזור
- נפחי Google Cloud Hyperdisk
- אשכולות GKE באזור אחד
- מכונות Filestore Basic ו-Zonal
- משימות ב-Dataflow
- מכונות של Cloud SQL
- אשכולות של Managed Service for Apache Spark ב-Compute Engine
כשל בתחום מוגדר יכול להשפיע על המשאבים של תחום מוגדר שהוקצו באותו תחום מוגדר. האזורים מתוכננים כך שהסיכון לכשלים שקשורים לאזורים אחרים באותו מיקום יהיה מינימלי. בדרך כלל, כשל באזור אחד לא משפיע על המשאבים באזורים אחרים באותו מחוז. בנוסף, תקלה באזור מסוים לא בהכרח גורמת לכך שכל התשתית באותו אזור לא תהיה זמינה. האזור רק מגדיר את הגבול הצפוי להשפעה של כשל.
כדי להגן על אפליקציות שמשתמשות במשאבים של תחום מוגדר מפני אירועים בתחום, אתם יכולים להפיץ או לשכפל את המשאבים בכמה תחומים או אזורים. מידע נוסף מופיע במאמר תכנון תשתית אמינה לעומסי העבודה ב- Google Cloud.
משאבים אזוריים
משאבים אזוריים נפרסים באופן יתיר בכמה תחומים באזור נתון. הנה כמה דוגמאות למשאבים אזוריים. זו רשימה חלקית בלבד.
- קבוצות MIG אזוריות
- קטגוריות אזוריות של Cloud Storage
- נפחי Google Cloud Hyperdisk Balanced High Availability
- אשכולות GKE אזוריים עם הגדרת ברירת המחדל (מספר אזורים)
- רשתות משנה של VPC
- מאזני עומסים חיצוניים אזוריים של אפליקציות (ALB)
- מכונות Spanner אזוריות
- מכונות של Filestore Enterprise
- שירותי Cloud Run
משאבים אזוריים עמידים בפני אירועים באזור ספציפי. הפסקה זמנית בשירות באזור יכולה להשפיע על חלק מהמשאבים האזוריים שהוקצו באותו אזור, או על כולם. הפסקות כאלה יכולות להיגרם מאסונות טבע או מתקלות בתשתיות בקנה מידה גדול.
משאבים במספר אזורים
משאבים במספר אזורים מפוזרים באזורים ספציפיים. הנה כמה דוגמאות למשאבים במספר אזורים. זו רשימה חלקית בלבד.
- קטגוריות של Cloud Storage בשני אזורים ובמספר אזורים
- מכונות Spanner במספר אזורים
- מכונות Bigtable עם כמה אשכולות (בכמה אזורים)
- אוספי מפתחות במספר אזורים ב-Cloud Key Management Service
במאמר מוצרים זמינים לפי מיקום מפורטת רשימה מלאה של שירותי Google שזמינים בהגדרות של מספר אזורים.
משאבים במספר אזורים עמידים בפני אירועים באזורים ובאזורי זמינות ספציפיים. הפסקה זמנית בשירות בתשתית שמתרחשת בכמה אזורים יכולה להשפיע על הזמינות של חלק מהמשאבים במספר אזורים, או על כולם, שמוקצים באזורים המושפעים.
משאבים גלובליים
משאבים גלובליים זמינים בכל המיקומים של Google Cloud . אלה דוגמאות למשאבים גלובליים: זו רשימה חלקית בלבד.
פרויקטים. במאמר בחירה של היררכיית משאבים לאזור הנחיתה ב- Google Cloud תוכלו לקרוא על שיטות מומלצות לארגון המשאבים שלGoogle Cloud בפרויקטים ובתיקיות.
רשתות VPC, כולל נתיבים וכללי חומת אש משויכים
תחומי Cloud DNS
מאזני עומסים גלובליים חיצוניים של אפליקציות (ALB)
אוספי מפתחות גלובליים ב-Cloud KMS
נושאי Pub/Sub
סודות ב-Secret Manager
ברשימת המוצרים הגלובליים מפורטים כל שירותי Google שזמינים ברחבי העולם.
משאבים גלובליים עמידים בפני אירועים אזוריים ושל תחום מוגדר. המשאבים האלה לא מסתמכים על תשתית באזור ספציפי.ל- Google Cloud יש מערכות ותהליכים שעוזרים לצמצם את הסיכון להפסקות גלובליות בתשתית. Google גם עוקבת אחרי התשתית באופן קבוע, ופותרת במהירות הפסקות גלובליות בשירות.
בטבלה הבאה מפורטת העמידות היחסית של משאבים ברמת האזור, במספר אזורים, ברמת התחום וברמה הגלובלית, לבעיות באפליקציות ובתשתיות. בנוסף, מתוארים המאמצים שנדרשים כדי להגדיר את המשאבים האלה, והמלצות לצמצום ההשפעות של הפסקות זמניות בשירות.
| היקף המשאבים | יכולת התמודדות | המלצות לצמצום ההשפעות של הפסקות זמניות בתשתית |
|---|---|---|
| אזורי | נמוכה | לפרוס את המשאבים באופן יתיר בכמה אזורים או תחומים. |
| אזורי | בינוני | לפרוס את המשאבים באופן יתיר בכמה אזורים. |
| במספר אזורים או גלובלי | גבוהה | חשוב לנהל את השינויים בזהירות ולהשתמש בגיבויים של הגנה לעומק כשאפשר. למידע נוסף, קראו את המאמר המלצות לניהול הסיכון של הפסקות זמניות במשאבים גלובליים. |
המלצות לניהול הסיכון להפסקות זמניות בשירות של משאבים גלובליים
כדי לנצל את העמידות של משאבים גלובליים להפסקות זמניות בשירות באזורים ובאזורי זמינות, כדאי להשתמש במשאבים גלובליים מסוימים בארכיטקטורה שלכם. כדי לנהל את הסיכון להפסקות זמניות בפעילות של משאבים גלובליים, Google ממליצה על הגישות הבאות:
ניהול קפדני של שינויים במשאבים גלובליים
משאבים גלובליים עמידים בפני כשלים פיזיים. ההגדרה של משאבים כאלה היא ברמה הגלובלית. לכן, קל יותר להגדיר משאב גלובלי אחד מאשר להפעיל כמה משאבים אזוריים. עם זאת, שגיאה קריטית בהגדרה של משאב גלובלי עלולה להפוך אותו לנקודת כשל בודדת (SPOF). לדוגמה, אפשר להשתמש במאזן עומסים גלובלי כחזית (frontend) לאפליקציה שפרוסה בכמה אזורים גיאוגרפיים. בדרך כלל, מאזן עומסים גלובלי הוא בחירה טובה לאפליקציה כזו. עם זאת, שגיאה בהגדרת מאזן העומסים עלולה לגרום לכך שהוא לא יהיה זמין בכל המיקומים הגיאוגרפיים. כדי למנוע את הסיכון הזה, צריך לנהל בזהירות את השינויים בהגדרות של משאבים גלובליים. איך שולטים בשינויים במשאבים גלובליים
שימוש במשאבים אזוריים כגיבוי להגנה לעומק
באפליקציות עם דרישות זמינות גבוהות במיוחד, אפשר להשתמש בגיבויים אזוריים של הגנה לעומק כדי לצמצם את ההשפעה של הפסקות זמניות בשירות של משאבים גלובליים. לדוגמה, נניח שיש אפליקציה שמפוזרת גיאוגרפית, עם מאזן עומסים גלובלי בתור ממשק קצה. כדי לוודא שהאפליקציה תישאר נגישה גם אם מאזן העומסים הגלובלי יושפע מהפסקה גלובלית, אתם יכולים לפרוס מאזני עומסים אזוריים. אתם יכולים להגדיר את הלקוחות כך שיעדיפו את מאזן העומסים הגלובלי, אבל אם הוא לא זמין, הם יעברו למאזן העומסים האזורי הקרוב ביותר.
כדי להגן מפני הפסקות בשירות של מאזן העומסים הגלובלי ושגיאות בהגדרות, אתם יכולים להטמיע אסטרטגיה אוטומטית של יתירות כשל או מעקף באמצעות Cloud DNS ומאזני עומסים אזוריים לגיבוי. מידע נוסף זמין במאמר אסטרטגיות של יתירות כשל למאזני עומסים חיצוניים גלובליים של אפליקציות.
דוגמה לארכיטקטורה עם משאבים ברמת האזור, המחוז והעולם
הטופולוגיה של הענן יכולה לכלול שילוב של משאבים ברמת האזור, ברמת המחוז וברמה הגלובלית, כמו שמוצג בתרשים הבא. בתרשים הבא מוצגת ארכיטקטורה לדוגמה של אפליקציה בכמה שכבות, שנפרסה ב-Google Cloud.
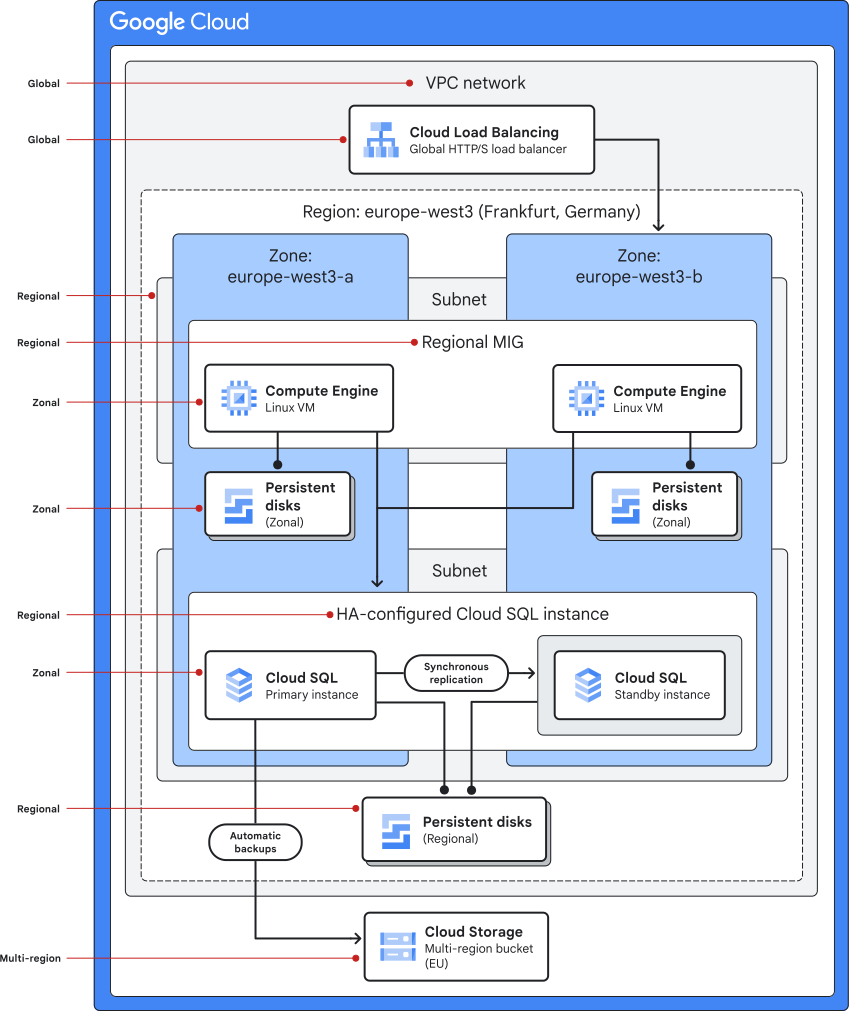
כפי שמוצג בתרשים שלמעלה, מאזן עומסים חיצוני גלובלי של אפליקציות מקבל בקשות מלקוחות. מאזן העומסים מפיץ את הבקשות לקצה העורפי, שהוא קבוצת MIG אזורית עם שתי מכונות וירטואליות של Compute Engine. האפליקציה שפועלת במכונות הווירטואליות כותבת נתונים למסד נתונים של Cloud SQL וקוראת ממנו. מסד הנתונים מוגדר לזמינות גבוהה. המכונות הראשית ומכונה במצב המתנה של מסד הנתונים מוקצות באזורים נפרדים, ומסד הנתונים הראשי משוכפל באופן סינכרוני למכונה במצב המתנה של מסד הנתונים. בנוסף, מסד הנתונים מגובה באופן אוטומטי בקטגוריה עם כמה אזורים ב-Cloud Storage.
בטבלה הבאה מפורטים המשאבים של Google Cloud בארכיטקטורה הקודמת, והעמידות של כל משאב להפסקות זמניות בשירות באזורים ובאזורים גיאוגרפיים:
| משאב | עמידות בפני הפסקות חשמל |
|---|---|
| רשת VPC | רשתות VPC, כולל כללי חומת האש והמסלולים המשויכים, הן משאבים גלובליים. הם עמידים בפני הפסקות זמניות בשירות באזורים ובאזורי משנה. |
| תת-רשתות | תת-רשתות של VPC הן משאבים אזוריים. הם עמידים בפני הפסקות זמניות בשירות באזור מסוים. |
| מאזן עומסים גלובלי חיצוני של אפליקציות (ALB) | מאזני עומסים גלובליים חיצוניים של אפליקציות (ALB) עמידים בפני הפסקות זמניות בשירות באזורים ובאזורים גיאוגרפיים. |
| MIG אזורי | קבוצות MIG אזוריות עמידות בפני הפסקות זמניות בשירות באזור מסוים. |
| מכונות וירטואליות של Compute Engine | המכונות הווירטואליות של Compute Engine הן משאבים של תחום מוגדר. אם יש הפסקה זמנית בשירות באזור מסוים, יכול להיות שהמכונות הווירטואליות של Compute Engine יושפעו. עם זאת, האפליקציה יכולה להמשיך לטפל בבקשות כי הבק-אנד של מאזן העומסים הוא קבוצת MIG אזורית, ולא מכונות וירטואליות עצמאיות. |
| מכונות של Cloud SQL | הפריסה של Cloud SQL בארכיטקטורה הזו מוגדרת לזמינות גבוהה, כלומר הפריסה כוללת זוג של מכונות מסד נתונים – ראשית וגיבוי. מסד הנתונים הראשי משוכפל באופן סינכרוני למסד הנתונים במצב המתנה באמצעות אמצעי אחסון של Hyperdisk Balanced High Availability.
|
| קטגוריה של Cloud Storage במספר אזורים | נתונים שמאוחסנים בקטגוריות של Cloud Storage במספר אזורים עמידים בפני הפסקות חשמל באזור אחד. |
| אמצעי אחסון ב-Hyperdisk | אמצעי אחסון ב-Hyperdisk הם משאבים של תחום מוגדר. לזמינות גבוהה, אפשר להשתמש בנפחי Hyperdisk Balanced High Availability. הנתונים משוכפלים באופן סינכרוני בשני אזורים באותו מחוז. כדי להתכונן להתאוששות מהפסקות זמניות בשירות באזור, אתם יכולים לתזמן קובצי Snapshot של נפחי Hyperdisk ולאחסן את קובצי ה-Snapshot בקטגוריה של Cloud Storage במספר אזורים. |