


Google Cloud Well-Architected Framework 的可靠性支柱提供原則和建議,協助您在 Google Cloud設計、部署及管理可靠的工作負載。
本文適用對象為雲端架構師、開發人員、平台工程師、管理員和網站可靠性工程師。
可靠性是指系統在定義的條件下,持續執行預期功能並維持不中斷服務的能力。可靠性的最佳做法包括備援、容錯設計、監控和自動復原程序。
韌性是可靠性的重要一環,是指系統在承受故障或意外中斷後,能恢復正常運作並維持效能的能力。Google Cloud 功能 (例如多區域部署、自動備份和災難復原解決方案) 可協助您提升系統韌性。
可靠性對雲端策略至關重要,原因有很多,包括:
- 盡可能縮短停機時間:停機可能導致收益損失、生產力下降和商譽受損。具備韌性的架構可確保系統在故障期間仍能繼續運作,或在故障後有效率地復原。
- 提升使用者體驗:使用者期望與技術順暢互動。具備韌性的系統可協助維持一致的效能和可用性,即使在需求量大或發生非預期問題時,也能提供可靠的服務。
- 資料完整性:故障可能導致資料遺失或損毀。具備韌性的系統會實作備份、備援和複製等機制,保護資料並確保資料準確且可供存取。
- 營運持續性:貴公司仰賴技術執行重要作業。具備韌性的架構可確保在發生災難性故障後仍能持續運作,讓業務功能在沒有重大中斷的情況下繼續運作,並支援快速復原。
- 法規遵循:許多產業對系統可用性和資料保護都有法規要求。具備韌性的架構可確保系統持續運作且安全無虞,協助您達到這些標準。
- 降低長期成本:具備韌性的架構需要前期投資,但韌性可防止昂貴的停機時間、避免被動修復,並提高資源使用效率,有助於降低長期成本。
組織思維
如要確保系統可靠,您需要制定計畫和策略。這項策略必須包含教育訓練,以及優先考量可靠性與其他計畫的權限。
明確要求整個組織負責可靠性,包括開發、產品管理、營運、平台工程和網站可靠性工程 (SRE)。即使是行銷和銷售等以業務為主的團隊,也可能影響可靠性。
每個團隊都必須瞭解應用程式的可靠性目標和風險。團隊必須對這些要求負責。如果可靠性和一般產品功能開發之間發生衝突,必須優先處理並視情況提報。
全面規劃及管理所有功能和團隊的可靠性。建議您設定雲端卓越中心 (CCoE),並納入可靠性支柱。詳情請參閱「透過雲端卓越中心,最佳化調整貴機構的 Cloud Journey」。
可靠性重點領域
設計、部署及管理可靠系統時,您執行的活動可分為下列重點領域。本支柱中的每項可靠性原則和建議,都與其中一個重點領域相關。
- 範圍界定:為瞭解系統,請詳細分析其架構。您必須瞭解元件、元件的運作和互動方式、資料和動作在系統中的流動方式,以及可能發生的問題。找出潛在故障、瓶頸和風險,以便採取行動來緩解這些問題。
- 觀測:為避免系統故障,請實施全面且持續的觀測和監控。透過這項觀察,您可以瞭解趨勢並主動找出潛在問題。
- 應變:為降低故障造成的影響,請採取適當應變措施,並有效率地復原。自動化回應也有助於降低故障的影響。即使有規劃和控管機制,仍可能發生故障。
- 學習:從每次經驗中學習,並採取適當行動,避免再次發生故障。
使用代理技能評估工作負載
如要讓 AI 代理依據本支柱的原則和建議評估雲端工作負載,請使用 google-cloud-waf-reliability 技能,該技能位於 GitHub 的 Google 代理技能存放區。
如要安裝技能,請在代理用戶端或終端機中執行下列指令:
npx skills add google/skills --skill google-cloud-waf-reliability
系統提示時,請指定要安裝技能的 AI 代理,並設定安裝範圍 (專案或全域)。
如果已安裝技能,可以執行下列指令,更新至最新版本:
npx skills update
核心原則
Well-Architected Framework 可靠性支柱中的建議,對應至下列核心原則:
- 根據使用者體驗目標定義可靠性
- 設定合理的可靠性目標
- 透過資源備援機制建構可用性高的系統
- 活用水平擴充功能
- 使用觀測能力偵測可能的故障情形
- 納入優雅降級設計
- 執行測試,確保能在故障時復原
- 執行測試,確保能在資料遺失時復原
- 出具全面的檢討報告
貢獻者
作者:
- Laura Hyatt | 金融服務業客戶工程師
- Jose Andrade | 客戶工程師、SRE 專家
- Gino Pelliccia | 首席架構師
其他貢獻者:
- Andrés-Leonardo Martínez-Ortiz | 技術專案經理
- Brian Kudzia | 企業基礎架構客戶工程師
- Daniel Lees | 雲端安全架構師
- Filipe Gracio 博士 | 客戶工程師、AI/機器學習專家
- Gary Harmson | 首席架構師
- Kumar Dhanagopal | 跨產品解決方案開發人員
- Marwan Al Shawi | 合作夥伴客戶工程師
- Nicolas Pintaux | 客戶工程師,應用程式翻新專家
- Radhika Kanakam | Well-Architected Framework 專案負責人 Google Cloud
- Ryan Cox | 首席架構師
- Samantha He | 技術撰稿人
- Wade Holmes | 全球解決方案總監
- Zach Seils | 網路專員
根據使用者體驗目標定義可靠性
這項原則是Google Cloud Well-Architected Framework可靠性支柱的基礎,可協助您評估使用者體驗,然後將發現項目對應至可靠性目標和指標。
這項原則與可靠性的範圍 重點領域相關。
原則總覽
觀測能力工具會提供大量資料,但並非所有資料都與使用者受到的影響直接相關。例如 CPU 使用率偏高、伺服器作業速度緩慢,甚至工作異常終止。不過,如果這些問題不影響使用者體驗,就不算服務中斷。
如要評估使用者體驗,您必須區分內部系統行為和面向使用者的問題。請著重於使用者要求的成功率等指標。請勿只依賴以伺服器為主的指標 (例如 CPU 用量),否則可能會對服務可靠性做出錯誤結論。真正的可靠性是指使用者能持續有效地使用您的應用程式或服務。
建議
為協助您有效評估使用者體驗,請參考下列各節的建議。
評估使用者體驗
如要確實瞭解服務的可靠性,請優先考量能反映使用者實際體驗的指標。例如,評估使用者的查詢成功率、應用程式延遲時間和錯誤率。
建議您直接從使用者的裝置或瀏覽器收集這項資料。如果無法直接收集資料,請逐步將評估點從系統中的使用者移開。例如,您可以使用負載平衡器或前端服務做為測量點。這種做法有助於在問題對使用者造成重大影響前,找出並解決問題。
分析使用者歷程
如要瞭解使用者與系統的互動情形,可以使用 Cloud Trace 等追蹤工具。追蹤使用者在應用程式中的歷程,即可找出可能降低使用者體驗的瓶頸和延遲問題。Cloud Trace 會擷取服務架構中每個躍點的詳細成效資料。這項資料有助於更有效率地找出及解決效能問題,進而提供更可靠、更令人滿意的使用者體驗。
設定合理的可靠性目標
Google Cloud Well-Architected Framework 可靠性支柱中的這項原則,可協助您為 Google Cloud中的工作負載,定義技術上可行的可靠性目標。
這項原則與可靠性的範圍 重點領域相關。
原則總覽
設計系統時,應保持足以讓使用者感到滿意的可靠性就好。這可能與直覺不符,但 100% 可靠性的目標通常不是最有效的策略。提高可靠性可能會大幅增加成本,包括財務投資和創新方面的潛在限制。如果使用者對目前的服務水準感到滿意,那麼進一步提升滿意度的努力可能只會帶來低投資報酬率。因此,您可以將資源用在其他地方。
您必須判斷使用者滿意的可靠性程度,並找出漸進式改善成本開始超過效益的時間點。確定足夠的可靠性後,您就能策略性地分配資源,專注於能為使用者帶來更高價值的功能和改善項目。
建議
如要設定合理的可靠性目標,請參考下列子節中的建議。
接受部分失敗並排定元件優先順序
請以高可用性為目標,例如 99.99% 的運作時間,但不要將目標設為 100% 運作時間。承認有些失敗是不可避免的。
100% 正常運作時間與 99.99% 目標之間的差距,就是允許失敗的容許值。這個差距通常稱為「錯誤預算」。錯誤預算可協助您承擔風險和創新,這是任何企業保持競爭力的根本。
優先確保系統中最重要元件的可靠性。接受較不重要的元件可以有較高的故障容忍度。
兼顧可靠性和成本
如要判斷系統的最佳可靠性等級,請進行徹底的成本效益分析。
請考量系統需求、故障後果,以及貴組織對特定應用程式的風險承受度等因素。請務必考量災難復原指標,例如復原時間目標 (RTO) 和復原點目標 (RPO)。在預算和其他限制條件內,決定可接受的可靠性等級。
尋找提高效率和降低成本的方法,同時不影響重要的可靠性功能。
透過資源備援機制建構可用性高的系統
Google Cloud Well-Architected Framework 可靠性支柱中的這項原則,提供規劃、建構及管理資源備援的建議,協助您避免失敗。
這項原則與可靠性的範圍 重點領域相關。
原則總覽
決定所需的可靠性等級後,您必須設計系統,避免任何單點故障。系統中的每個重要元件都必須在多部機器、可用區和區域中複製。舉例來說,重要資料庫不能只位於一個區域,中繼資料伺服器也不能只部署在一個可用區或區域。在這些範例中,如果唯一的可用區或區域發生中斷,系統就會發生全域中斷。
建議
如要建構備援系統,請參考下列子節中的建議。
找出故障域並複製服務
從個別 VM 到區域,規劃系統的故障域,並設計跨故障域的備援機制。
為確保高可用性,請將服務和應用程式分散並複製到多個可用區和區域。設定系統自動容錯移轉,確保可用區或區域中斷時,服務和應用程式仍可使用。
如需多可用區和多區域架構的範例,請參閱「在 Google Cloud中為工作負載設計可靠的基礎架構」。
及時偵測並解決問題
持續追蹤故障域的狀態,及時偵測並解決問題。
您可以使用Google Cloud Service Health 資訊主頁,監控所有區域的 Google Cloud 服務目前狀態。您也可以使用 Personalized Service Health 查看與專案相關的事件。您可以使用負載平衡器偵測資源健康狀態,並自動將流量轉送至健康狀態良好的後端。詳情請參閱「健康狀態檢查總覽」。
測試容錯移轉情境
就像消防演習一樣,定期模擬故障,驗證複製和容錯移轉策略的成效。
詳情請參閱「模擬區域性 MIG 的可用區中斷情形」和「在 GKE 區域性叢集中模擬可用區故障」。
活用水平擴充功能
Google Cloud Well-Architected Framework 可靠性支柱中的這項原則提供建議,協助您使用水平擴充性。使用水平擴充功能,可確保Google Cloud 中的工作負載能有效擴充並維持效能。
這項原則與可靠性的範圍 重點領域相關。
原則總覽
將系統重新架構為水平架構。如要因應流量或資料成長,可以新增更多資源。您也可以移除未使用的資源。
如要瞭解水平資源調度的價值,請考量垂直資源調度的限制。
垂直擴充的常見情境是使用 MySQL 資料庫做為主要資料庫,並儲存重要資料。隨著資料庫用量增加,需要更多 RAM 和 CPU。最後,資料庫會達到主體機器的記憶體限制,需要升級。這個程序可能需要重複幾次。問題在於資料庫的成長幅度有硬性限制。VM 大小並非無上限。資料庫可能會達到無法再新增資源的狀態。
即使資源無限,大型 VM 也可能成為單一失敗點。主要資料庫 VM 發生任何問題,都可能導致錯誤回應,或造成系統全面中斷,影響所有使用者。避免單點故障,詳情請參閱「透過資源備援機制建構可用性高的系統」。
除了這些資源調度限制外,垂直資源調度通常也較昂貴。隨著取得的機器運算能力和記憶體增加,成本可能會呈指數級成長。
相較之下,水平資源調度的成本可能較低。在設計為可擴充的系統中,水平擴充的潛力幾乎無限。
建議
如要從單一 VM 架構轉換為水平多機架構,您必須仔細規劃並使用合適的工具。為協助您達成水平擴充,請考慮下列子節中的建議。
使用代管服務
代管服務可免除手動管理水平調度資源的需求。舉例來說,您可以使用 Compute Engine 代管執行個體群組 (MIG) 新增或移除 VM,以水平擴充應用程式。如果是容器化應用程式,Cloud Run 是無伺服器平台,可根據傳入流量自動調度無狀態容器。
推廣模組化設計
模組化元件和清楚的介面可協助您視需要擴充個別元件,而非擴充整個應用程式。詳情請參閱效能最佳化支柱中的「推廣模組化設計」。
採用無狀態設計
將應用程式設計為無狀態,也就是不儲存本機資料。這樣一來,您就能新增或移除執行個體,不必擔心資料一致性問題。
使用觀測工具偵測可能的故障情形
Google Cloud Well-Architected Framework 可靠性支柱中的這項原則提供建議,協助您主動找出可能發生錯誤和故障的部分。
這項原則與可靠性的觀測 重點領域相關。
原則總覽
如要維護及提升Google Cloud中工作負載的可靠性,您必須使用指標、記錄和追蹤記錄,實作有效的觀測能力。
- 指標是應用程式在特定時間間隔內,您要追蹤的活動數值。舉例來說,您可能想追蹤要求比率和錯誤率等技術指標,這些指標可做為服務水準指標 (SLI)。您可能也需要追蹤應用程式專屬的業務指標,例如下單數量和收到的付款。
- 記錄是指應用程式或系統中發生的離散事件,並附有時間戳記。事件可能是失敗、錯誤或狀態變更。記錄可能包含指標,您也可以將記錄用於服務水準指標。
- 追蹤記錄代表單一使用者或交易在多個獨立應用程式或應用程式元件中的歷程。例如,這些元件可能是微服務。追蹤記錄可協助您追蹤歷程中使用的元件、瓶頸所在位置,以及歷程所需時間。
指標、記錄和追蹤記錄可協助您持續監控系統。全方位的監控功能可協助您找出錯誤發生的位置和原因。您也可以在錯誤發生前偵測潛在故障。
建議
如要有效偵測潛在故障,請參考下列子節中的建議。
取得全方位洞察資訊
如要追蹤回應時間和錯誤率等重要指標,請使用 Cloud Monitoring 和 Cloud Logging。這些工具也有助於確保指標持續符合工作負載的需求。
如要根據資料做出決策,請分析預設服務指標,瞭解元件依附元件及其對整體工作負載效能的影響。
如要自訂監控策略,請使用 Google Cloud SDK 建立及發布自己的指標。
主動排解問題
導入完善的錯誤處理機制,並為 Google Cloud中工作負載的所有元件啟用記錄功能。啟用 Cloud Storage 存取記錄和 虛擬私有雲流量記錄等記錄。
設定記錄功能時,請考量相關費用。如要控管記錄費用,您可以在記錄檔接收器上設定排除篩選器,排除特定記錄檔,不予儲存。
充分運用資源
監控 CPU 消耗量、網路 I/O 指標和磁碟 I/O 指標,偵測 GKE、Compute Engine 和 Managed Service for Apache Spark 等服務中,資源佈建不足和過度佈建的情況。如需支援服務的完整清單,請參閱「Cloud Monitoring 總覽」。
確定警告處理順序
如要採用快訊,請著重於重要指標、設定適當門檻,盡量避免快訊疲勞轟炸的情形,並確保及時回應重大問題。這種有目標的處理方式可讓您主動維護工作負載的可靠性。詳情請參閱「快訊總覽」。
納入優雅降級設計
Google Cloud Well-Architected Framework 可靠性支柱中的這項原則提供建議,協助您設計 Google Cloud 工作負載,以便在發生故障時妥善處理。
這項原則與可靠性的回應 重點領域有關。
原則總覽
優雅降級是一種設計方法,可讓系統在高負載下繼續運作,但效能或準確度可能會降低。優雅降級可確保系統持續可用,並防止完全故障,即使系統的工作並非最佳狀態。當負載回到可管理的程度時,系統會恢復完整功能。
舉例來說,在負載較高的期間,Google 搜尋會優先顯示排名較高的網頁結果,這可能會犧牲部分準確度。當負載降低時,Google 搜尋會重新計算搜尋結果。
建議
如要設計優雅降級的系統,請參考下列子節的建議。
實作節流
確保副本能獨立處理過載,並在高流量情況下限制傳入要求。這種做法有助於避免因可用區之間的超額流量轉移而導致連鎖故障。
使用 Apigee 等工具,在流量高峰期控管 API 要求率。您可以設定政策規則,反映您希望如何縮減要求。
提早捨棄超額要求
設定系統在前端層捨棄過多要求,保護後端元件。捨棄部分要求可避免全域故障,並讓系統更順利地復原。採用這種方法時,部分使用者可能會遇到錯誤。不過,相較於斷路等做法 (在超載時捨棄「所有」流量),您可以將服務中斷的影響降到最低。
處理部分錯誤和重試
建構應用程式,順暢處理部分錯誤和重試作業。這項設計有助於確保在高負載情況下,盡可能提供最多流量。
測試過載情況
為驗證節流和要求捨棄機制是否有效運作,請定期模擬系統超載情況。測試有助於確保系統已做好準備,可因應實際流量激增的情況。
監控流量高峰
使用數據分析和監控工具,在流量激增演變成超載前,預測並因應。及早偵測並採取因應措施,有助於在需求高峰期維持服務可用性。
執行測試,確保能在故障時復原
Google Cloud Well-Architected Framework 可靠性支柱中的這項原則提供建議,協助您設計及執行測試,以便在發生故障時復原。
這項原則與可靠性的學習 重點領域有關。
原則總覽
為確保系統能從故障中復原,您必須定期執行測試,包括區域容錯移轉、版本復原,以及從備份還原資料。
這項測試可協助您練習如何應對會對可靠性造成重大風險的事件,例如整個區域服務中斷。這項測試也有助於確認系統在服務中斷期間是否正常運作。
如果整個區域停止運作 (這種情況相當少見),您必須將所有流量容錯移轉至其他區域。在工作負載正常運作期間,修改資料時,必須從主要區域同步至容錯移轉區域。您必須確認複製的資料一律為最新資料,以免使用者遇到資料遺失或工作階段中斷的情況。負載平衡系統也必須能隨時將流量轉移至容錯移轉區域,且不會中斷服務。為了盡可能縮短區域性服務中斷後的停機時間,作業工程師也必須能夠手動且有效率地將使用者流量從某個區域移出,並盡可能縮短所需時間。這項作業有時稱為「排空區域」,也就是停止傳入該區域的流量,並將所有流量移至其他位置。
建議
設計及執行故障復原測試時,請參考下列子節的建議。
定義測試目標和範圍
明確定義測試目標。例如,您的目標可能包括:
- 驗證復原時間目標 (RTO) 和復原點目標 (RPO)。詳情請參閱「災難復原規劃基本概念」。
- 評估系統在各種故障情境下的韌性和容錯能力。
- 測試自動容錯移轉機制的成效。
決定測試範圍內的元件、服務或區域。範圍可以包含特定應用程式層 (例如前端、後端和資料庫),也可以包含特定 Google Cloud 資源 (例如 Cloud SQL 執行個體或 GKE 叢集)。範圍也必須指定任何外部依附元件,例如第三方 API 或 Cloud Interconnect。
準備測試環境
選擇合適的環境,最好是複製正式環境設定的測試環境或沙箱環境。如果您在正式環境中進行測試,請務必準備好安全措施,例如自動監控和手動復原程序。
建立備份方案。為重要資料庫和服務建立快照或備份,以免測試期間資料遺失。確保團隊已做好準備,在自動容錯移轉機制失敗時,能手動介入處理。
為避免測試中斷,請確認 IAM 角色、政策和容錯移轉設定正確無誤。確認測試工具和指令碼具備必要權限。
向作業、開發運作和應用程式擁有者等利害關係人,說明測試時程、範圍和潛在影響。向相關人員提供預估時間軸和測試期間的預期行為。
模擬故障情形
使用 Chaos Monkey 等工具規劃及執行故障。您可以使用自訂指令碼模擬重要服務故障,例如關閉多可用區 GKE 叢集中的主要節點,或停用 Cloud SQL 執行個體。您也可以使用指令碼,根據測試範圍,透過防火牆規則或 API 限制模擬整個區域的網路中斷。逐步提高故障情境的嚴重程度,觀察系統在各種情況下的行為。
在故障情境中加入負載測試,模擬服務中斷期間的實際使用情形。測試連鎖性故障的影響,例如後端服務無法使用時,前端系統的行為。
如要驗證設定變更,並評估系統對人為錯誤的復原能力,請測試涉及錯誤設定的情境。例如,使用不正確的 DNS 容錯移轉設定或 IAM 權限執行測試。
監控系統行為
監控負載平衡器、健康狀態檢查和其他機制如何重新轉送流量。使用 Google Cloud 工具 (例如 Cloud Monitoring 和 Cloud Logging),在測試期間擷取指標和事件。
觀察故障模擬期間和之後的延遲時間、錯誤率和處理量變化,並監控整體效能影響。找出使用者體驗中的任何效能下降或不一致之處。
確保系統會針對重要事件 (例如服務中斷或容錯移轉) 產生記錄並觸發警告。您可以運用這項資料,驗證警告和事件應變系統的成效。
根據 RTO 和 RPO 驗證復原作業
評估系統在故障後恢復正常運作所需的時間,然後將這項資料與定義的 RTO 進行比較,並記錄任何差距。
確保資料完整性和可用性符合 RPO。如要測試資料庫一致性,請比較故障前後的資料庫快照或備份。
評估服務復原情形,確認所有服務都已恢復正常運作,且對使用者的影響降到最低。
記錄並分析結果
記錄每個測試步驟、失敗情境和對應的系統行為。 包括時間戳記、記錄和指標,以便進行詳細分析。
並指出測試期間觀察到的瓶頸、單點故障或非預期行為。為排定修正順序,請依嚴重性和影響程度分類問題。
建議如何改善系統架構、容錯移轉機制或監控設定。根據測試結果,更新所有相關的容錯移轉政策和教戰手冊。向利害關係人提交事後檢討報告。報告應總結成果、經驗教訓和後續步驟。詳情請參閱「進行徹底的事後檢討」。
疊代執行並改善
為驗證持續的可靠性和韌性,請規劃定期測試 (例如每季)。
在不同情境下執行測試,包括基礎架構變更、軟體更新和流量負載增加。
使用 CI/CD 管道自動執行容錯移轉測試,將可靠性測試整合至開發生命週期。
在事後檢討期間,請根據利害關係人和使用者的意見回饋,改善測試程序和系統韌性。
執行測試,確保能在資料遺失時復原
Google Cloud Well-Architected Framework 可靠性支柱中的這項原則提供建議,協助您設計及執行測試,從資料遺失中復原。
這項原則與可靠性的學習 重點領域有關。
原則總覽
為確保系統能從資料遺失或損毀的情況中復原,您需要針對這些情境執行測試。資料遺失可能是由軟體錯誤或某種天災造成。發生這類事件後,您必須從備份還原資料,並使用剛還原的資料重新啟動所有服務。
建議您使用三項條件來判斷這類復原測試是否成功:資料完整性、復原時間目標 (RTO) 和復原點目標 (RPO)。如要進一步瞭解 RTO 和 RPO 指標,請參閱「災難復原規劃基本概念」。
資料還原測試的目標是定期驗證貴組織是否能持續符合業務連續性需求。除了評估 RTO 和 RPO 之外,資料還原測試也必須包含測試整個應用程式堆疊,以及所有重要基礎架構服務與還原資料。這是為了確認整個部署的應用程式在測試環境中正常運作。
建議
設計及執行資料遺失復原測試時,請參考下列子節的建議。
驗證備份一致性並測試還原程序
您必須確認備份包含一致且可用的資料快照,以便還原資料,立即讓應用程式恢復運作。如要驗證資料完整性,請設定自動一致性檢查,在每次備份後執行。
如要測試備份,請在非正式環境中還原。為確保備份能有效率地還原,且還原的資料符合應用程式需求,請定期模擬資料復原情境。記錄資料還原步驟,並訓練團隊在發生故障時有效執行這些步驟。
定期且頻繁地備份
為盡量減少還原期間的資料遺失,並達成 RPO 目標,請務必定期排定備份。根據 RPO 建立備份頻率。舉例來說,如果 RPO 為 15 分鐘,請排定至少每 15 分鐘執行一次備份。最佳化備份間隔,降低資料遺失的風險。
使用 Google Cloud 工具 (例如 Cloud Storage、Cloud SQL 自動備份或 Spanner 備份) 安排及管理備份。如果是重要應用程式,請使用近乎連續的備份解決方案,例如 Cloud SQL 的時間點復原 (PITR),或大型資料集的增量備份。
定義及監控 RPO
根據業務需求設定明確的 RPO,並監控 RPO 遵循情況。如果備份間隔超過定義的 RPO,請使用 Cloud Monitoring 設定警告。
監控備份健康狀態
使用 Google Cloud Backup and DR 服務或類似工具,追蹤備份的健康狀態,並確認備份儲存在安全可靠的位置。確保備份會複製到多個區域,進一步提升韌性。
規劃備份以外的情境
將備份與災難復原策略結合,例如主動-主動容錯移轉設定或跨區域複製,在極端情況下縮短復原時間。詳情請參閱「災難復原規劃指南」。
出具全面的檢討報告
Google Cloud Well-Architected Framework 可靠性支柱中的這項原則提供建議,協助您在發生故障和事件後,有效進行事後檢討。
這項原則與可靠性的學習 重點領域有關。
原則總覽
事後檢討報告是事件的書面記錄,內容包括事件影響、為緩解或解決事件而採取的行動、根本原因,以及防止事件再次發生的後續行動。事後檢討的目的是從錯誤中學習,而非歸咎責任。
下圖顯示事後檢討的工作流程:
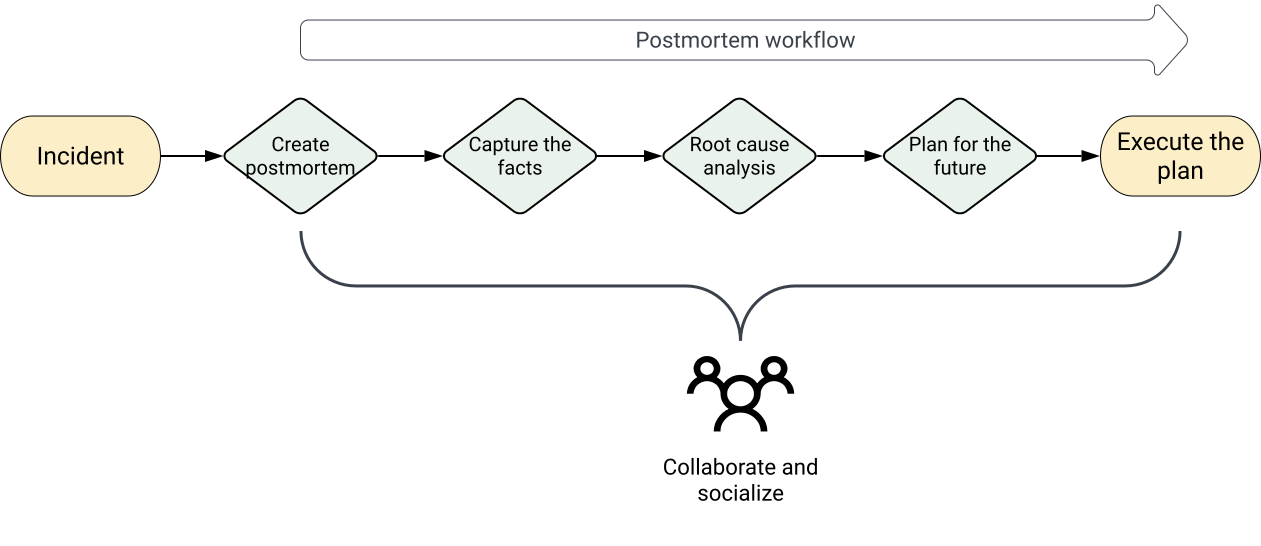
事後檢討的工作流程包含下列步驟:
- 建立事後檢討
- 擷取事實
- 找出並分析根本原因
- 規劃未來
- 執行計畫
在重大事件和非重大事件後進行事後檢討分析,例如:
- 使用者可見的停機時間或效能降低超過特定門檻。
- 任何形式的資料遺失。
- 待命工程師的介入,例如復原版本或重新規劃流量路徑。
- 解決時間超過定義的門檻。
- 監控失敗,通常代表需要手動發現事件。
建議
在事件發生前定義檢討報告條件,讓所有人都知道何時需要檢討報告。
如要有效進行事後檢討,請參考下列子節的建議。
以不互相責難的態度檢討
有效的檢討會著重於流程、工具和技術,不會歸咎於個人或團隊。事後分析的目的是改善技術和未來,而非找出罪魁禍首。人人都會犯錯。目標應該是分析錯誤並從中學習。
以下範例說明指責性意見回饋和不指責性意見回饋之間的差異:
- 指責他人的意見:「我們需要重寫整個複雜的後端系統!過去三季以來,每週都會發生故障,我想大家也厭倦了零星的修復工作。說真的,如果再收到一次呼叫,我就要自己重寫…」
- 不歸咎責任的意見回饋:「重寫整個後端系統的待辦事項,實際上可能可以防止這些頁面繼續發生。這個版本的維護手冊很長,要完全掌握並不容易。相信未來的值班工程師一定會感謝我們!」
讓所有目標對象都能閱讀事後檢討報告
對於您打算納入報告的每項資訊,請評估該資訊是否重要且必要,能否協助讀者瞭解事件。您可以將補充資料和說明移至報表的附錄。審查人員如需更多資訊,可以提出要求。
避免複雜或過度設計的解決方案
開始探索問題的解決方案之前,請先評估問題的重要性和再次發生的可能性。如果為了避免不太可能再次發生的問題而增加系統複雜度,可能會導致系統不穩定。
盡可能廣泛分享事後檢討
為確保問題不會懸而未決,請向廣大對象發布事後檢討結果,並取得管理階層的支援。事後檢討的價值與事後檢討後發生的學習成正比。當更多人從事件中汲取經驗,類似失敗再次發生的可能性就會降低。