


Last reviewed 2026-10-27 UTC
Google Cloud Well-Architected Framework 可靠性支柱中的這項原則提供建議,協助您在發生故障和事件後,有效進行事後檢討。
這項原則與可靠性的學習 重點領域有關。
原則總覽
事後檢討報告是事件的書面記錄,內容包括事件的影響、為緩解或解決事件而採取的行動、根本原因,以及防止事件再次發生的後續行動。事後檢討的目的是從錯誤中學習,而非歸咎責任。
下圖顯示事後檢討的工作流程:
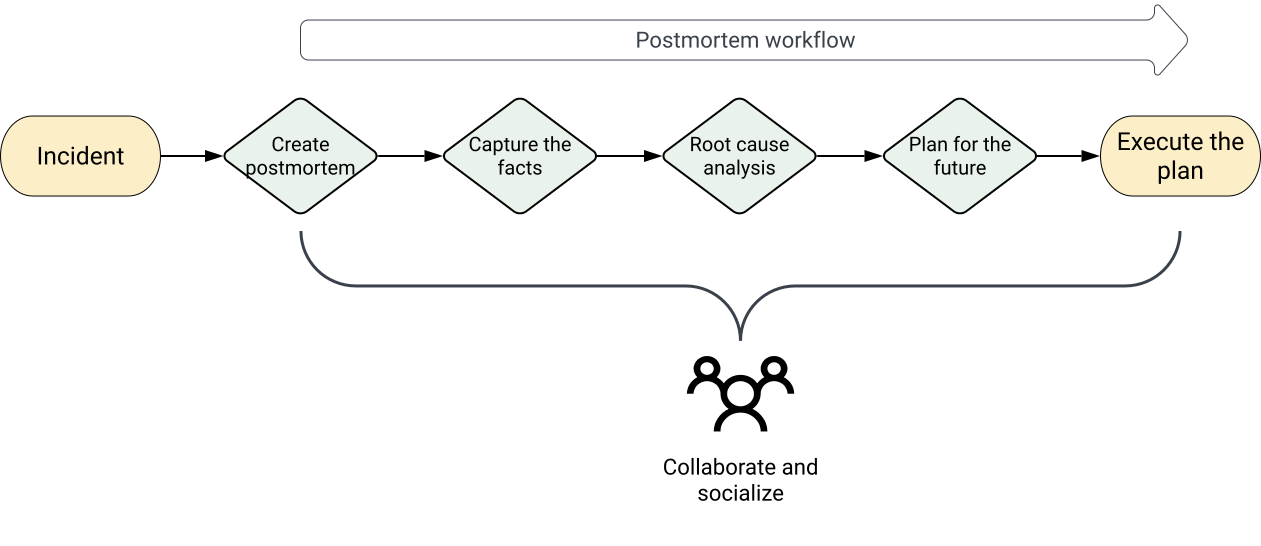
事後檢討的工作流程包含下列步驟:
- 建立事後檢討
- 擷取事實
- 找出並分析根本原因
- 規劃未來
- 執行計畫
在重大事件和非重大事件後進行事後檢討分析,例如:
- 使用者可見的停機時間或效能降低超過特定門檻。
- 任何形式的資料遺失。
- 待命工程師的介入措施,例如復原版本或重新轉送流量。
- 解決時間超過定義的門檻。
- 監控失敗,通常代表需要手動發現事件。
建議
在事件發生前定義事後檢討條件,讓所有人知道何時需要進行事後檢討。
如要有效進行事後檢討,請參考下列子節的建議。
以不互相責難的態度檢討
有效的檢討會著重於流程、工具和技術,不會歸咎於個人或團隊。事後分析的目的是改善技術和未來,而非找出罪魁禍首。人人都會犯錯。目標應該是分析錯誤並從中學習。
以下範例說明指責性意見回饋和不指責性意見回饋之間的差異:
- 指責他人的意見:「我們必須重寫整個複雜的後端系統!過去三季以來,每週都會發生故障,我想大家也厭倦了零星的修復工作。說真的,如果再收到一次呼叫,我就要自己重寫…」
- 不歸咎責任的意見回饋:「重寫整個後端系統的待辦事項,實際上可能可以防止這些頁面繼續發生。這個版本的維護手冊相當冗長,很難完整訓練。相信未來的值班工程師一定會感謝我們!」
讓所有目標對象都能閱讀事後檢討報告
對於您打算納入報告的每項資訊,請評估該資訊是否重要且必要,能否協助讀者瞭解事件。您可以將補充資料和說明移至報表的附錄。如果審查人員需要更多資訊,可以提出要求。
避免複雜或過度設計的解決方案
開始探索問題的解決方案之前,請先評估問題的重要性和再次發生的可能性。為了避免不太可能再次發生的問題而增加系統複雜度,可能會導致不穩定性增加。
盡可能廣泛分享事後檢討
為確保問題不會懸而未決,請向廣大對象發布事後檢討結果,並取得管理階層的支持。事後檢討的價值與事後檢討後發生的學習成正比。當更多人從事件中學習,類似故障再次發生的可能性就會降低。