


Ce document du Google Cloud Well-Architected Framework : perspective des services financiers (FS) présente les principes et les recommandations pour concevoir, déployer et exploiter des charges de travail FS fiables dans Google Cloud. Ce document explique comment intégrer des pratiques de fiabilité avancées et l'observabilité dans vos plans d'architecture. Les recommandations de ce document sont conformes au pilier de fiabilité du Well-Architected Framework.
Pour les institutions financières, une infrastructure fiable et résiliente est à la fois un besoin commercial et un impératif réglementaire. Pour garantir la fiabilité des charges de travail FS dansGoogle Cloud , vous devez comprendre et atténuer les points de défaillance potentiels, déployer des ressources de manière redondante et planifier la récupération. La résilience opérationnelle est un résultat de la fiabilité. C'est la capacité à absorber les perturbations, à s'y adapter et à s'en remettre. La résilience opérationnelle aide les organisations de services financiers à respecter des exigences réglementaires strictes. Cela permet également d'éviter des préjudices intolérables pour les clients.
Les principaux composants fondamentaux de la fiabilité dans Google Cloud sont les régions, les zones et les différents champs d'application des ressources cloud : zonal, régional, multirégional et mondial. Vous pouvez améliorer la disponibilité en utilisant des services gérés, en distribuant les ressources, en mettant en œuvre des modèles de haute disponibilité et en automatisant les processus.
Exigences réglementaires
Les organisations de services financiers sont soumises à des exigences strictes en matière de fiabilité par des organismes de réglementation tels que le Federal Reserve System aux États-Unis, l'Autorité bancaire européenne dans l'UE et la Prudential Regulation Authority au Royaume-Uni. À l'échelle mondiale, les organismes de réglementation mettent l'accent sur la résilience opérationnelle, qui est essentielle pour la stabilité financière et la protection des consommateurs. La résilience opérationnelle est la capacité à résister aux perturbations, à récupérer efficacement et à maintenir les services critiques. Cela nécessite une approche harmonisée pour gérer les risques technologiques et les dépendances vis-à-vis de tiers.
Les exigences réglementaires de la plupart des juridictions ont les thèmes communs suivants :
- Cybersécurité et résilience technologique : renforcement des défenses contre les cybermenaces et garantie de la résilience des systèmes informatiques.
- Gestion des risques tiers : gestion des risques associés à l'externalisation de services auprès de fournisseurs de technologies de l'information et de la communication (TIC).
- Continuité d'activité et réponse aux incidents : planification robuste pour maintenir les opérations critiques pendant les interruptions et récupérer efficacement.
- Protéger la stabilité financière : assurer la solidité et la stabilité du système financier dans son ensemble.
Les recommandations de fiabilité de ce document sont mappées aux principes fondamentaux suivants :
- Prioriser les déploiements multizones et multirégionaux
- Éliminer les points de défaillance uniques (SPOF)
- Comprendre et gérer la disponibilité globale
- Mettre en œuvre une stratégie de reprise après sinistre robuste
- Exploiter les services gérés
- Automatiser les processus de provisionnement et de récupération de l'infrastructure
Privilégier les déploiements multizones et multirégionaux
Pour les applications de services financiers critiques, nous vous recommandons d'utiliser une topologie multirégionale répartie sur au moins deux régions et sur trois zones dans chaque région. Cette approche est importante pour la résilience face aux pannes de zones et de régions. Les réglementations prescrivent souvent cette approche, car si une défaillance se produit dans une zone ou une région, la plupart des juridictions considèrent qu'une perturbation grave dans une deuxième zone est une conséquence plausible. En effet, lorsqu'un emplacement échoue, l'autre peut recevoir une quantité exceptionnellement élevée de trafic supplémentaire.
Tenez compte des recommandations suivantes pour renforcer la résilience face aux pannes de zone et de région :
- Privilégiez les ressources qui ont un champ d'application géographique plus large. Dans la mesure du possible, utilisez des ressources régionales plutôt que des ressources zonales, et des ressources multirégionales ou mondiales plutôt que des ressources régionales. Cette approche permet d'éviter d'avoir à restaurer les opérations à l'aide de sauvegardes.
- Dans chaque région, utilisez trois zones plutôt que deux. Pour gérer les basculements, surprovisionnez la capacité d'un tiers de plus que l'estimation.
- Réduisez les étapes de récupération manuelle en mettant en œuvre des déploiements de type actif-actif, comme dans les exemples suivants :
- Les bases de données distribuées telles que Spanner offrent une redondance et une synchronisation intégrées entre les régions.
- La fonctionnalité de haute disponibilité de Cloud SQL fournit une topologie quasi active-active, avec des instances répliquées avec accès en lecture dans plusieurs zones. Il fournit un objectif de point de récupération (RPO) entre les régions proche de 0.
- Répartissez le trafic utilisateur entre les régions à l'aide de Cloud DNS et déployez un équilibreur de charge régional dans chaque région. Un équilibreur de charge mondial est une autre option que vous pouvez envisager en fonction de vos exigences et de votre niveau de criticité. Pour en savoir plus, consultez la page Avantages et risques de l'équilibrage de charge global pour les déploiements multirégionaux.
- Pour stocker des données, utilisez des services multirégionaux tels que Spanner et Cloud Storage.
Éliminer les points de défaillance uniques
Répartissez les ressources entre différents emplacements et utilisez des ressources redondantes pour éviter qu'un point de défaillance unique (SPOF) n'affecte l'ensemble de la pile d'applications.
Tenez compte des recommandations suivantes pour éviter les points de défaillance uniques :
- Évitez de déployer un seul serveur d'applications ou une seule base de données.
- Assurez la recréation automatique des VM défaillantes à l'aide de groupes d'instances gérés (MIG).
- Répartissez le trafic de manière uniforme entre les ressources disponibles en mettant en œuvre l'équilibrage de charge.
- Utilisez des configurations de haute disponibilité pour les bases de données telles que Cloud SQL.
- Améliorez la disponibilité des données en utilisant des disques persistants régionaux avec réplication synchrone.
Pour en savoir plus, consultez Concevoir une infrastructure fiable pour vos charges de travail dans Google Cloud.
Comprendre et gérer la disponibilité globale
Sachez que la disponibilité globale ou agrégée d'un système est affectée par la disponibilité de chaque niveau ou composant du système. Le nombre de niveaux d'une pile d'application présente une relation inverse avec la disponibilité globale de la pile. Tenez compte des recommandations suivantes pour gérer la disponibilité globale :
Calculez la disponibilité globale d'une pile à plusieurs niveaux à l'aide de la formule tier1_availability × tier2_availability × tierN_availability.
Le schéma suivant montre le calcul de la disponibilité globale d'un système à plusieurs niveaux composé de quatre services :
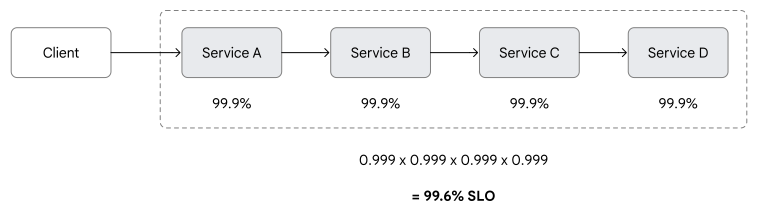
Dans le schéma précédent, le service de chaque niveau offre une disponibilité de 99,9 %, mais la disponibilité globale du système est inférieure à 99,6 % (0,999 × 0,999 × 0,999 × 0,999). En général, la disponibilité globale d'une pile à plusieurs niveaux est inférieure à celle du niveau qui offre la plus faible disponibilité.
Dans la mesure du possible, privilégiez la parallélisation au chaînage. Avec les services parallélisés, la disponibilité de bout en bout est supérieure à la disponibilité de chaque service individuel.
Le schéma suivant montre deux services, A et B, déployés à l'aide des approches de chaînage et de parallélisation :
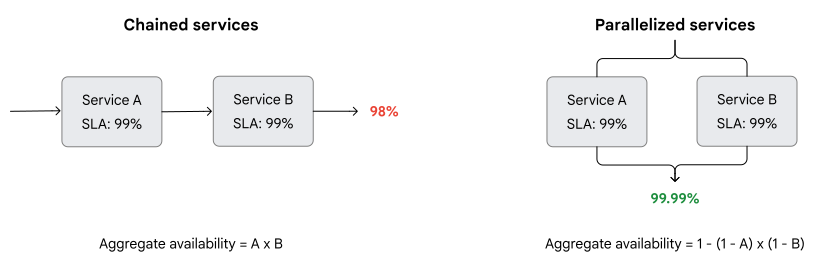
Dans les exemples précédents, les deux services ont un SLA de 99 %, ce qui se traduit par la disponibilité globale suivante en fonction de l'approche de mise en œuvre :
- Les services en chaîne n'offrent qu'une disponibilité globale de 98 % (0,99 × 0,99).
- Les services parallélisés offrent une disponibilité globale plus élevée de 99,99 %, car chaque service s'exécute indépendamment et les services individuels ne sont pas affectés par la disponibilité des autres services. La formule pour les services parallélisés agrégés est 1 − (1 − A) × (1 − B).
Choisissez des services Google Cloud avec des SLA de temps d'activité qui peuvent vous aider à atteindre le niveau de temps d'activité global requis pour votre pile d'applications.
Lorsque vous concevez votre architecture, tenez compte des compromis entre disponibilité, complexité opérationnelle, latence et coût. L'augmentation du nombre de neuf de disponibilité coûte généralement plus cher, mais elle vous aide à respecter les exigences réglementaires.
Par exemple, une disponibilité de 99,9 % (trois neuf) signifie un temps d'arrêt potentiel de 86 secondes sur une journée de 24 heures. En revanche, 99 % (deux neuf) signifie un temps d'arrêt de 864 secondes sur la même période, soit 10 fois plus de temps d'arrêt qu'avec trois neuf de disponibilité.
Pour les services financiers critiques, les options d'architecture peuvent être limitées. Cependant, il est essentiel d'identifier les exigences de disponibilité et de calculer précisément la disponibilité. Cette évaluation vous aide à évaluer les implications de vos décisions de conception sur votre architecture et votre budget.
Mettre en œuvre une stratégie de reprise après sinistre robuste
Créez des plans bien définis pour différents scénarios de sinistre, y compris les pannes zonales et régionales. Une stratégie de reprise après sinistre (DR) bien définie vous permet de vous remettre d'une interruption et de reprendre vos opérations normales avec un impact minimal.
La reprise après sinistre et la haute disponibilité sont deux concepts différents. Avec les déploiements cloud, la reprise après sinistre s'applique généralement aux déploiements multirégionaux et la haute disponibilité aux déploiements régionaux. Ces archétypes de déploiement sont compatibles avec différents mécanismes de réplication.
- HA : de nombreux services gérés fournissent par défaut une réplication synchrone entre les zones d'une même région. Ces services sont compatibles avec un objectif de temps de récupération (RTO) et un objectif de point de récupération (RPO) nuls ou proches de zéro. Cette compatibilité vous permet de créer une topologie de déploiement actif-actif sans SPOF.
- DR : pour les charges de travail déployées dans au moins deux régions, si vous n'utilisez pas de services multirégionaux ou mondiaux, vous devez définir une stratégie de réplication. La stratégie de réplication est généralement asynchrone. Évaluez soigneusement l'impact de cette réplication sur le RTO et le RPO des applications critiques. Identifiez les opérations manuelles ou semi-automatisées nécessaires au basculement.
Pour les institutions financières, le choix de la région de basculement peut être limité par les réglementations sur la souveraineté et la résidence des données. Si vous avez besoin d'une topologie actif-actif dans deux régions, nous vous recommandons de choisir des services gérés multirégionaux, tels que Spanner et Cloud Storage, en particulier lorsque la réplication des données est essentielle.
Tenez compte des recommandations suivantes :
- Utilisez des services de stockage multirégional gérés pour les données.
- Prenez des instantanés des données sur les disques persistants et stockez-les dans des emplacements multirégionaux.
- Lorsque vous utilisez des ressources régionales ou zonales, configurez la réplication des données vers d'autres régions.
- Vérifiez que vos plans de reprise après sinistre sont efficaces en les testant régulièrement.
- Tenez compte du RTO et du RPO, ainsi que de leur corrélation avec la tolérance d'impact stipulée par les réglementations financières de votre juridiction.
Pour en savoir plus, consultez Concevoir une solution de reprise après sinistre pour les pannes d'infrastructure cloud.
Exploiter tout le potentiel des services gérés
Dans la mesure du possible, utilisez des services gérés pour profiter des fonctionnalités intégrées de sauvegarde, de haute disponibilité et d'évolutivité. Tenez compte des recommandations suivantes pour l'utilisation des services gérés :
- Utilisez des services gérés dans Google Cloud. Ils offrent une haute disponibilité garantie par des SLA. Ils offrent également des mécanismes de sauvegarde intégrés et des fonctionnalités de résilience.
- Pour la gestion des données, envisagez d'utiliser des services tels que Cloud SQL, Cloud Storage et Spanner.
- Pour l'hébergement de calcul et d'applications, envisagez d'utiliser des groupes d'instances gérés (MIG) Compute Engine et des clusters Google Kubernetes Engine (GKE). Les MIG régionaux et les clusters GKE régionaux sont résilients aux pannes zonales.
- Pour améliorer la résilience contre les pannes régionales, utilisez des services multirégionaux gérés.
- Identifiez la nécessité de mettre en place des plans de sortie pour les services présentant des caractéristiques uniques et définissez les plans requis. Les organismes de réglementation financière tels que la FCA, la PRA et l'ABE exigent que les entreprises disposent de stratégies et de plans d'urgence pour la récupération des données et la continuité opérationnelle en cas de rupture de la relation avec un fournisseur de services cloud. Les entreprises doivent évaluer la faisabilité de la sortie avant de conclure des contrats cloud et doivent conserver la possibilité de changer de fournisseur sans interruption opérationnelle.
- Vérifiez que les services que vous choisissez permettent d'exporter des données vers un format ouvert tel que CSV, Parquet et Avro. Vérifiez si les services sont basés sur des technologies ouvertes, comme la compatibilité de GKE avec le format OCI (Open Container Initiative) ou Managed Service pour Apache Airflow.
Automatiser les processus de provisionnement et de récupération de l'infrastructure
L'automatisation permet de minimiser les erreurs humaines et de réduire le temps et les ressources nécessaires pour répondre aux incidents. L'automatisation peut contribuer à accélérer la récupération après une défaillance et à obtenir des résultats plus cohérents. Tenez compte des recommandations suivantes pour automatiser le provisionnement et la récupération des ressources :
- Réduisez les erreurs humaines en utilisant des outils d'infrastructure en tant que code (IaC) tels que Terraform.
- Réduisez les interventions manuelles en automatisant les processus de basculement. Les réponses automatisées peuvent également contribuer à réduire l'impact des défaillances. Par exemple, vous pouvez utiliser Eventarc ou Workflows pour déclencher automatiquement des actions correctives en réponse aux problèmes observés via les journaux d'audit.
- Augmentez la capacité de vos ressources cloud lors du basculement à l'aide de l'autoscaling.
- Appliquez automatiquement des règles et des garde-fous pour répondre aux exigences réglementaires dans l'ensemble de votre topologie cloud lors du déploiement des services en adoptant l'ingénierie de plate-forme.