


建議您設計資料網格,支援各種資料使用情境。本文說明組織中最常見的資料使用案例。此外,這份文件也探討資料消費者在判斷適合自身用途的資料產品時,必須考量哪些資訊,以及如何探索和使用資料產品。瞭解這些因素有助於組織確保具備適當的指引和工具,可為資料使用者提供支援。
本文件屬於系列文章,說明如何在 Google Cloud實作資料網格。本指南假設您已閱讀並熟悉資料網格的架構與功能和使用 Google Cloud建構現代分散式資料網格中描述的概念。
這個系列包含以下部分:
- 資料網格的架構與功能
- 為資料網格設計自助式資料平台
- 在資料網格中建構資料產品
- 探索及使用資料網格中的資料產品 (本文件)
資料消費層的設計 (具體來說,資料網域型消費者如何使用資料產品) 取決於資料消費者的需求。前提是消費者已有明確的使用情境。假設他們已找出所需資料,並可搜尋中央資料產品目錄來找到該資料。如果資料不在目錄中,或不符合偏好狀態 (例如介面不合適或服務水準協議不足),消費者必須與資料產生者聯絡。
或者,消費者可以聯絡資料網格的卓越中心 (COE),諮詢哪個網域最適合產生該資料產品。資料消費者也可以詢問如何提出要求。如果貴組織規模較大,應建立以自助方式提出資料產品要求的程序。
資料消費者會透過執行的應用程式使用資料產品。所需的洞察類型會決定資料使用應用程式的設計選擇。開發應用程式設計時,資料消費者也會找出他們偏好在應用程式中使用資料產品的方式。他們會建立對資料可信度和可靠性的信心。接著,資料使用者可以根據應用程式所需的資料產品介面和服務水準協議,建立檢視畫面。
資料使用案例
資料消費者建立資料應用程式時,來源可能是一或多項資料產品,也可能是資料消費者自有網域中的資料。如「在資料網格中建構資料產品」所述,分析資料產品可由以各種實體資料存放區為基礎的資料產品製成。
雖然資料使用可能發生在同一個網域內,但最常見的使用模式是搜尋合適的資料產品 (不限網域),做為應用程式的來源。如果合適的資料產品存在於其他網域,則消耗模式會要求您設定後續機制,以便跨網域存取及使用資料。如要瞭解如何使用在其他網域建立的資料產品,請參閱「資料使用步驟」。
架構
下圖顯示一個範例情境,其中消費者透過各種介面 (包括授權資料集和 API) 使用資料產品。
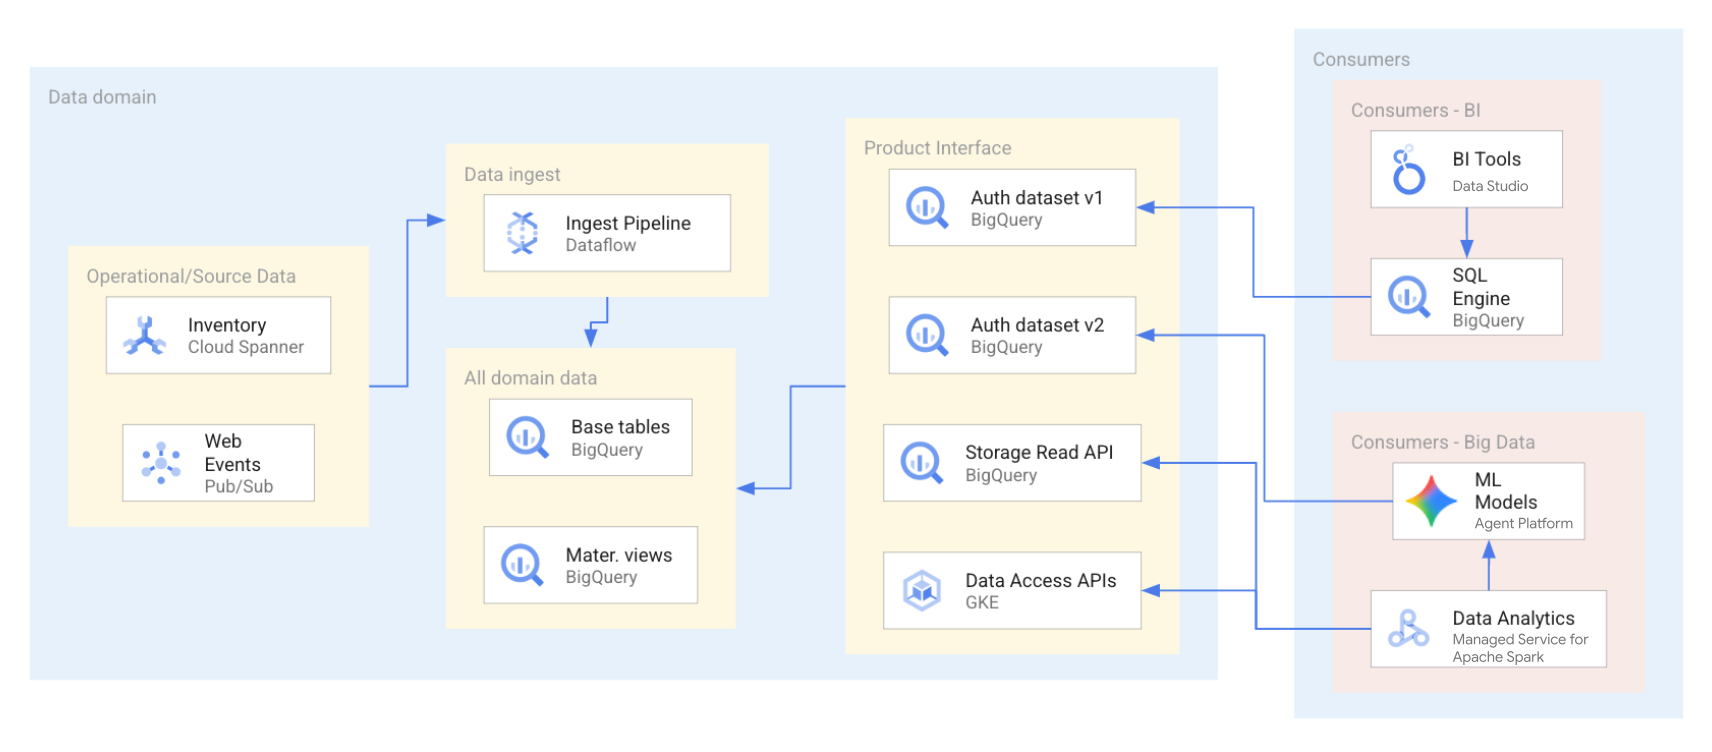
如上圖所示,資料產生者公開了四個資料產品介面:兩個 BigQuery 授權資料集、一個由 BigQuery Storage Read API 公開的 BigQuery 資料集,以及託管於 Google Kubernetes Engine 的資料存取 API。資料消費者在使用資料產品時,會透過各種應用程式查詢或直接存取資料產品中的資料資源。在這種情況下,資料消費者會根據特定的資料存取需求,透過兩種不同方式之一存取資料資源。第一種方式是 Looker 使用 BigQuery SQL 查詢授權資料集。第二種方法是 Managed Service for Apache Spark 透過 BigQuery API 直接存取資料集,然後處理擷取的資料,訓練機器學習 (ML) 模型。
使用資料消耗應用程式不一定會產生商業智慧 (BI) 報表或 BI 資訊主頁。使用網域中的資料,也能產生機器學習模型,進一步豐富分析產品、用於資料分析,或成為營運程序的一部分,例如詐欺偵測。
以下列舉一些常見的資料產品使用案例:
- BI 報表和資料分析:在這種情況下,資料應用程式會建構來使用多項資料產品的資料。舉例來說,客戶關係管理 (CRM) 團隊的資料消費者需要存取多個領域的資料,例如銷售、客戶和財務。這些資料消費者開發的 CRM 應用程式,可能需要查詢某個網域中的 BigQuery 授權檢視表,並從另一個網域中的 Cloud Storage Read API 擷取資料。對資料消費者而言,影響其偏好消費介面的最佳化因素,是運算成本和查詢資料產品後所需的任何額外資料處理。在商業智慧和資料分析用途中,BigQuery 授權檢視表可能是最常用的。
- 資料科學用途和模型訓練:在這種情況下,資料使用團隊會使用其他網域的資料產品,充實自己的分析資料產品,例如機器學習模型。 Google Cloud 使用 Managed Service for Apache Spark 執行 Spark,提供資料預先處理和特徵工程功能,可在執行機器學習工作前充實資料。考量重點包括:能否以合理成本取得足夠的訓練資料,以及是否確信訓練資料合適。為降低成本,建議使用直接讀取 API 做為消耗介面。資料使用團隊可以建構機器學習模型做為資料產品,進而成為新的資料產生團隊。
- 操作人員程序:使用是資料使用網域內作業程序的一部分。舉例來說,處理詐欺行為的團隊中,資料消費者可能會使用來自商家網域中作業資料來源的交易資料。透過變更資料擷取等資料整合方法,系統會近乎即時地攔截這項交易資料。接著,您可以使用 Pub/Sub 定義這項資料的結構定義,並將該資訊公開為事件。在這種情況下,適當的介面會是以 Pub/Sub 主題形式公開的資料。
資料使用步驟
資料產生者會在中央目錄中記錄資料產品,包括如何使用資料的指引。對於擁有多個網域的組織,這種說明文件方法建立的架構與傳統集中建構的 ELT/ETL 管道不同,其中處理器建立輸出內容時不受業務網域的限制。資料網格中的資料消費者必須具備完善的探索和消費層,才能建立資料消費生命週期。圖層應包含下列項目:
步驟 1:透過宣告式搜尋和探索資料產品規格,探索資料產品:資料消費者可以自由搜尋資料生產者在中央目錄中註冊的任何資料產品。對於所有資料產品,資料產品標記會指定如何提出資料存取要求,以及從必要資料產品介面使用資料的模式。您可以使用搜尋應用程式,搜尋資料產品標記中的欄位。資料產品介面會實作資料 URI,也就是說,資料不需要移至獨立的使用區,即可提供給消費者。在不需要即時資料的情況下,消費者會查詢資料產品,並根據產生的結果建立報表。
步驟 2:透過互動式資料存取和原型設計探索資料:資料消費者使用 BigQuery Studio 和 Jupyter Notebooks 等互動式工具,解讀及實驗資料,精進正式環境所需的查詢。互動式查詢可讓資料消費者探索新的資料維度,並提高實際工作環境中產生的洞察資料準確度。
步驟 3:透過應用程式使用資料產品,並以程式輔助方式存取及產生資料:
- 商業智慧報表。批次和近乎即時的報表和資訊主頁,是資料消費者最常需要的分析用途。報表可能需要跨資料產品存取權,才能協助制定決策。舉例來說,顧客資料平台需要以排程方式,透過程式輔助查詢訂單和 CRM 資料產品。這種做法的結果可為使用資料的企業使用者提供全方位的客戶檢視。
- 用於批次和即時預測的 AI/機器學習模型。資料科學家會使用常見的 MLOps 原則,建構及提供機器學習模型,這些模型會使用資料產品團隊提供的資料產品。機器學習模型可為詐欺偵測等交易用途提供即時推論功能。同樣地,資料消費者可以透過探索性資料分析,充實來源資料。舉例來說,對銷售和行銷廣告活動資料進行探索式資料分析,可找出預期銷售額最高的客層,並在這些客層中放送廣告活動。
後續步驟
- 查看資料網格架構的參考實作。
- 進一步瞭解 BigQuery。
- 進一步瞭解 Gemini Enterprise Agent Platform。
- 瞭解 Managed Service for Apache Spark 的資料科學。
- 如要查看更多參考架構、圖表和最佳做法,請瀏覽 Cloud Architecture Center。