


이 문서에서는 AI 에이전트를 사용하는 크로스 클라우드 분석 워크플로를 구현하기 위한 대략적인 아키텍처를 제공합니다. 이 문서는 멀티 클라우드 데이터 레이크, 정형 데이터 웨어하우스, 비정형 데이터 스토어 전반에서 분석 워크플로에 에이전트 AI를 사용하려는 클라우드 설계자, 데이터 엔지니어, 데이터 과학자를 대상으로 합니다. 이 문서에서는 독자가 에이전트형 AI 개념, 데이터 분석, 클라우드 아키텍처에 대한 기본적인 지식이 있다고 가정합니다.
이 문서의 배포 섹션에서는 에이전트 분석 솔루션을 빌드하는 방법을 알아볼 수 있는 Codelab을 제공합니다.
아키텍처
다음 다이어그램은 여러 데이터 스토어와 클라우드 서비스 제공업체에 분산된 정형 및 비정형 데이터에서 비즈니스 인사이트를 도출하는 에이전트 분석 솔루션의 아키텍처를 보여줍니다.
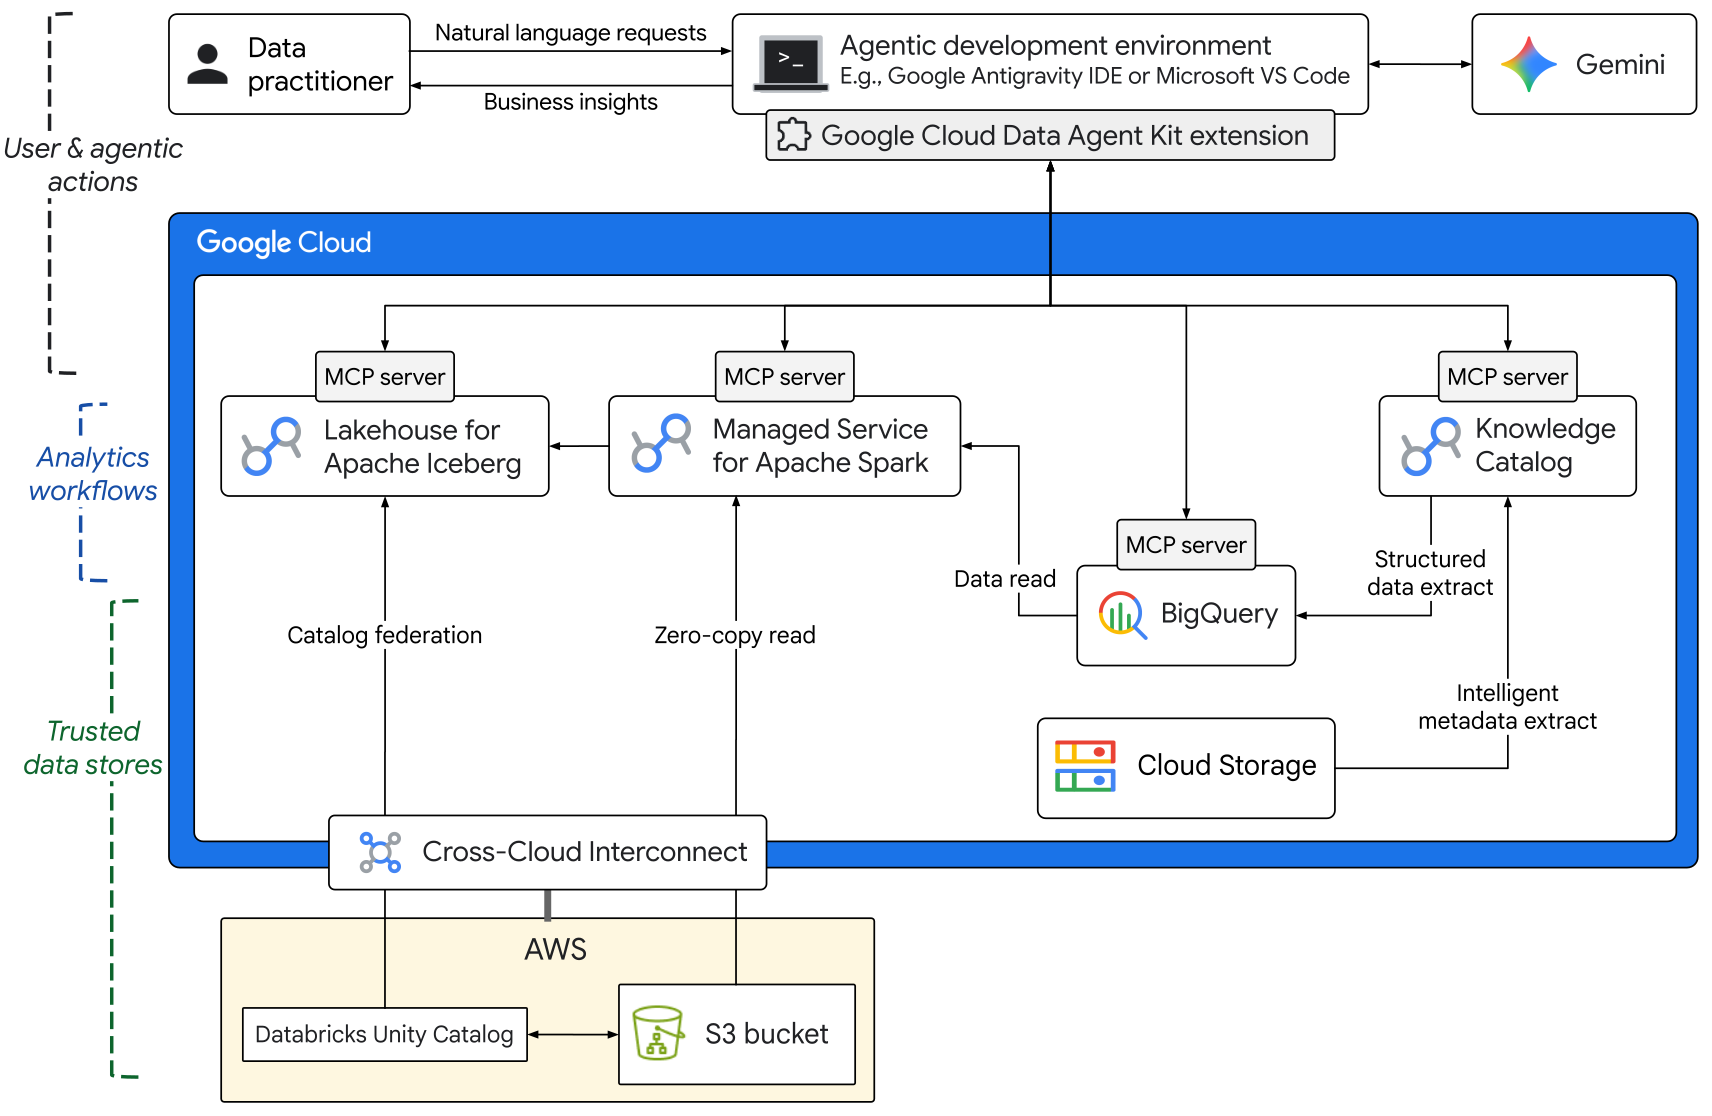
이 아키텍처의 구성요소는 다음 레이어로 구성됩니다.
사용자 및 에이전트 작업
- 에이전트형 개발 환경: 데이터 엔지니어 및 데이터 과학자와 같은 데이터 실무자는 다음 방법 중 하나를 사용하여 자연어 요청을 제출합니다.
- Google Antigravity IDE 또는 Microsoft Visual Studio Code와 같은 에이전트 개발 환경
- Gemini CLI, Claude Code, Codex와 같은 CLI 에이전트
- Google Cloud Data Agent Kit: Data Agent Kit를 사용하면 에이전트가 적절한 스킬을 로드하고 Google Cloud 서비스를 위해 원격 MCP 서버에 연결하여Google Cloud 의 신뢰할 수 있는 데이터에 액세스할 수 있습니다.
- 파운데이션 모델: 신뢰할 수 있는 컨텍스트와 데이터에서 비즈니스 인사이트를 생성하기 위해 에이전트 개발 환경에서는 Gemini 제품군의 모델과 같은 파운데이션 모델을 사용합니다. 모델은 Data Agent Kit의 적절한 스킬을 사용하고 필요한 MCP 서버 도구를 사용하여 복잡한 분석 워크플로를 구현합니다.
- 에이전트형 개발 환경: 데이터 엔지니어 및 데이터 과학자와 같은 데이터 실무자는 다음 방법 중 하나를 사용하여 자연어 요청을 제출합니다.
분석 워크플로
- 경계 없는 레이크하우스: 레이크하우스는 Apache Iceberg 개방형 테이블 형식을 Google Cloud의 엔터프라이즈급 스토리지와 통합하는 고성능 통합 메타데이터 카탈로그를 제공합니다. 크로스 클라우드 데이터 액세스를 사용하면 레이크하우스에서 데이터를 이동하거나 복사하지 않고도 Databricks Unity 카탈로그와 같은 외부 카탈로그를 제휴할 수 있습니다.
- Managed Service for Apache Spark: 아키텍처의 핵심 데이터 처리 구성요소입니다. Managed Service for Apache Spark의 Lightning Engine 기능은 일괄 및 대화형 모드에서 고성능 서버리스 데이터 처리를 지원합니다. Spark 데이터 처리 작업은 Lakehouse의 Iceberg 카탈로그에서 메타데이터를 사용하고, BigQuery에서 정형 데이터를 읽고, Amazon S3와 같은 외부 소스에서 제로 카피 읽기를 수행합니다.
- Knowledge Catalog: 에이전트는 Knowledge Catalog를 사용하여 Cloud Storage의 비정형 데이터를 지능적으로 스캔하고, 시맨틱 메타데이터를 추출하고, 컨텍스트 그래프를 빌드합니다.
신뢰할 수 있는 데이터 스토어
- Google Cloud의 데이터: BigQuery는 Cloud Storage의 비정형 데이터에서 추출된 정형 데이터를 포함하여 정형 데이터의 중앙 웨어하우스 역할을 합니다.
- 외부 소스의 데이터: 아키텍처는 Amazon S3 버킷의 데이터 및 Databricks Unity 카탈로그의 메타데이터와 같은 외부 데이터 소스를 보여줍니다. Cross-Cloud Interconnect는 Google Cloud와 다른 클라우드 서비스 제공업체 간의 고대역폭 전용 연결을 제공합니다.
사용 제품
이 아키텍처에는 다음과 같은 Google Cloud 제품 및 도구가 사용됩니다.
- Google Cloud Data Agent Kit: 데이터 과학자, 데이터 엔지니어, 데이터 앱 개발자가 선호하는 에이전트형 개발 환경 내에서 전체 데이터 수명 주기를 관리할 수 있는 에이전트 확장 프로그램입니다.
- BigQuery: 머신러닝, 지리 정보 분석, 비즈니스 인텔리전스와 같은 기본 제공 기능으로 데이터를 관리 및 분석하는 데 도움이 되는 엔터프라이즈 데이터 웨어하우스입니다.
- Managed Service for Apache Spark: 관리형 컴퓨팅 인프라에서 Apache Spark 일괄 워크로드를 실행하는 관리형 서비스입니다.
- Lakehouse: 개방형 데이터 레이크하우스를 빌드할 수 있게 해주고 고급 분석 및 AI를 위한 통합 인터페이스를 제공하는 고성능 스토리지 엔진입니다.
- Knowledge Catalog: 지능형 메타데이터 및 거버넌스 기능을 갖춘 데이터 애셋의 통합 카탈로그를 제공하는 AI 기반 서비스입니다.
- Gemini: Google에서 개발한 멀티모달 AI 모델 제품군입니다.
- Cloud Storage: 다양한 데이터 유형에 적합한 저비용, 무제한 객체 스토어입니다. Google Cloud내부 및 외부에서 데이터에 액세스할 수 있고 중복성을 위해 여러 위치에 복제됩니다.
- Cross-Cloud Interconnect: Google Cloud 와 다른 클라우드 서비스 제공업체 간에 대역폭이 높고 지연 시간이 짧은 전용 연결을 제공하는 서비스입니다.
- Google Cloud MCP 서버: 모델 컨텍스트 프로토콜(MCP)을 구현하여 AI 애플리케이션에 Google 및 Google Cloud 제품 및 서비스에 대한 액세스 권한을 제공하는 Google 관리형 원격 서비스입니다.
사용 사례
이 문서에서 설명하는 아키텍처는 다음 사용 사례에 적합합니다.
- 멀티 클라우드 데이터 분석: 파일을 이동하거나 복잡한 추출, 변환, 로드 (ETL) 파이프라인을 빌드하지 않고도 Google Cloud 및 기타 클라우드 서비스 제공업체에 분산된 데이터를 효율적으로 쿼리하고 분석합니다. 예를 들어 글로벌 소매업체의 마케팅 관리자는 Amazon S3의 고객 충성도 데이터를 BigQuery의 마케팅 운영 데이터와 조인하여 마케팅 캠페인의 효과를 분석할 수 있습니다.
- 지능형 데이터 탐색: 자연어 프롬프트와 AI 에이전트를 사용하여 여러 환경에서 제휴 데이터 세트를 탐색, 쿼리, 처리합니다. 예를 들어 조달 전문가는 공급망 관리 (SCM) 시스템의 정형 데이터와 비정형 이메일 커뮤니케이션 및 피해 평가 보고서의 인사이트를 결합하여 공급망 중단의 일반적인 원인을 파악할 수 있습니다.
- 비정형 소스에서 정형 데이터 추출: 대량의 비정형 데이터를 스캔하고, 시맨틱 메타데이터를 도출하고, 다운스트림 분석을 위해 정형 데이터 추출을 BigQuery에 저장합니다. 예를 들어 운영 컨트롤러는 PDF 파일과 같은 비정형 형식으로 저장된 수천 개의 인보이스에서 정형 데이터를 추출하여 비용을 효율적으로 분석할 수 있습니다.
보안 고려사항
AI 에이전트의 고유한 보안 위험을 해결하기 위해 Google은 결정론적 보안 제어와 동적 추론 기반 방어를 결합하는 접근 방식을 권장합니다.
- 인간 감독: 비즈니스에 중요한 시스템에 휴먼인더루프 흐름을 통합하여 인간 감독자가 출력을 검토하고 에이전트 작업을 승인, 재정의 또는 일시중지할 수 있도록 합니다.
- 에이전트 ID: 각 에이전트에 워크로드 바인딩 ID를 할당하여 최소 권한 액세스 제어를 적용하고 외부 도구의 사용자 인증 정보를 중앙에서 관리합니다.
- Agent Gateway: Model Armor를 사용하여 인그레스 및 이그레스 트래픽 거버넌스, 기본 거부 액세스 정책, 인라인 프롬프트 및 도구 검사를 시행합니다.
- 에이전트 레지스트리: 에이전트가 승인된 하위 에이전트 및 MCP 도구에만 연결되는지 확인합니다.
이 섹션의 안내는 일부일 뿐 모든 내용을 포함하지는 않습니다. 설계 요소 및 권장사항에 대한 자세한 내용과 멀티 에이전트 AI 시스템 빌드 및 배포에 대한 권장사항은 Google Cloud의 멀티 에이전트 AI 시스템을 참조하세요.
AI 및 ML 워크로드와 관련된 보안 원칙 및 권장사항은 Well-Architected Framework의 AI 및 ML 관점: 보안을 참조하세요.
배포
Data Agent Kit를 사용하여 에이전트 분석 솔루션을 빌드하는 방법을 알아보려면 AI 에이전트로 원시 데이터를 몇 초 만에 예측으로 전환 Codelab을 참조하세요. 이 Codelab에서는 Data Agent Kit를 사용하여 선호하는 에이전트형 개발 환경 내에서 데이터를 효율적으로 분석하는 방법을 보여줍니다. Codelab에서 사용하는 모든 샘플 데이터는Google Cloud에 저장됩니다.
다음 단계
- Data Agent Kit를 사용하여 데이터 변환 및 분석에 노트북을 사용하는 방법을 알아보세요.
- Knowledge Catalog 사용 사례 살펴보기
- Lakehouse를 사용한 크로스 클라우드 데이터 액세스 자세히 알아보기
- Lightning Engine을 사용하여 Apache Spark 워크로드를 가속화하는 방법을 알아봅니다.
- BigQuery의 거버넌스 및 에이전트 레이어로 Knowledge Catalog를 사용하는 방법을 알아보세요.
- 그 밖의 참조 아키텍처, 다이어그램, 튜토리얼, 권장사항을 알아보려면 클라우드 아키텍처 센터를 확인하세요.
참여자
저자: 쿠마르 다나고팔 | 크로스 프로덕트 솔루션 개발자
기타 참여자:
- 아비라미 수쿠마란 | 직원 Developer Advocate
- 아르티 프라사드 | 테크니컬 라이터
- 브래드 미로 | 선임 Developer Advocate
- 매튜 라만 | 선임 제품 관리자
- 라나딥 채터지 | 솔루션 엔지니어
- 레미기우시 삼보르스키 | 개발자 관계팀 리드 엔지니어