


Questo documento fornisce un'architettura di alto livello per l'implementazione di flussi di lavoro di analisi cross-cloud che utilizzano agenti AI. Il documento è rivolto ad architetti cloud, data engineer e data scientist che vogliono utilizzare l'AI agentica per i workflow di dati e analisi in data lake multi-cloud, data warehouse strutturati e datastore non strutturati. Il documento presuppone che tu abbia una conoscenza di base dei concetti di AI agentica, analisi dei dati e architettura cloud.
La sezione Deployment di questo documento fornisce un codelab che puoi utilizzare per scoprire come creare una soluzione di analisi agentica.
Architettura
Il seguente diagramma mostra un'architettura per una soluzione di analisi agentica che ricava insight aziendali da dati strutturati e non strutturati distribuiti su più datastore e provider di servizi cloud.
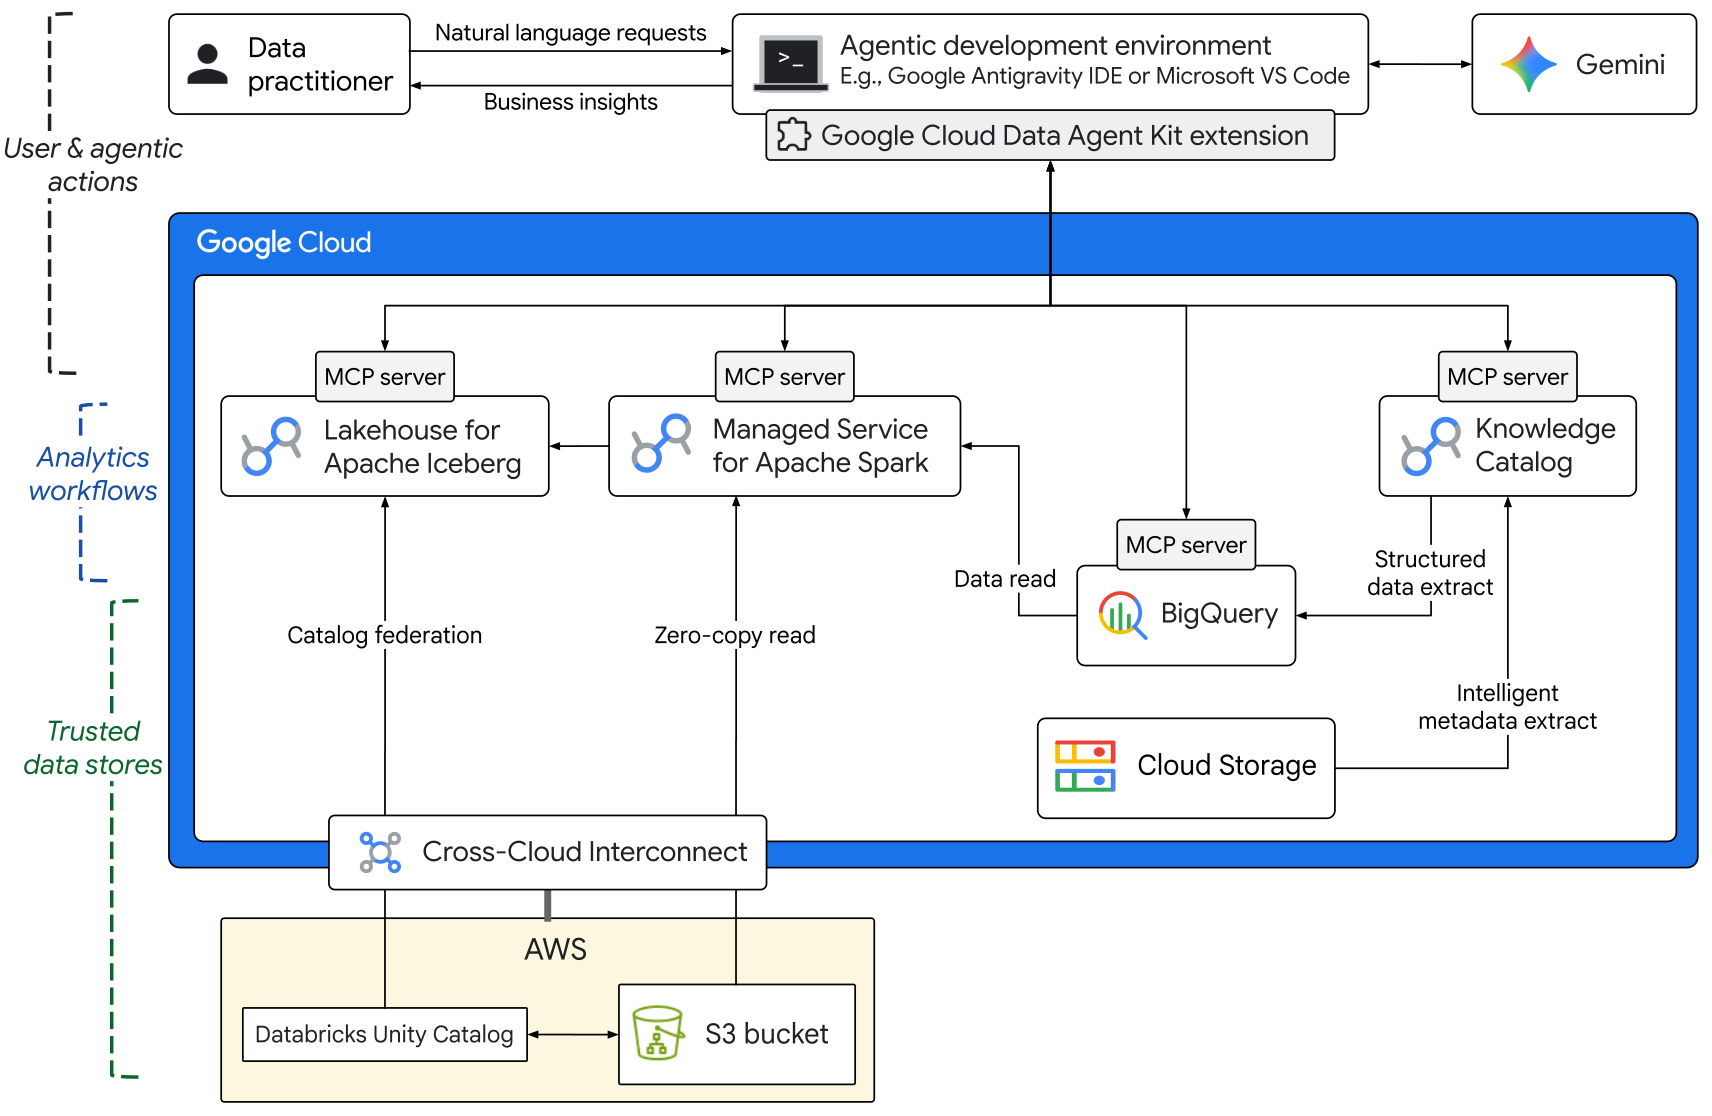
I componenti di questa architettura sono organizzati nei seguenti livelli:
Azioni dell'utente e dell'agente
- Ambiente di sviluppo agentico: i Data Practitioner, come i Data Engineer e i Data Scientist, inviano richieste in linguaggio naturale utilizzando uno dei seguenti metodi:
- Un ambiente di sviluppo basato su agenti come Google Antigravity IDE o Microsoft Visual Studio Code.
- Un agente CLI come Gemini CLI, Claude Code o Codex.
- Google Cloud Data Agent Kit: Data Agent Kit consente agli agenti di accedere a dati attendibili inGoogle Cloud caricando le competenze appropriate e connettendosi ai server MCP remoti per i servizi Google Cloud .
- Foundation model: per generare insight aziendali da contesto e dati attendibili, l'ambiente di sviluppo basato su agenti utilizza un foundation model, ad esempio un modello della famiglia Gemini. Il modello utilizza le competenze appropriate di Data Agent Kit e gli strumenti del server MCP richiesti per implementare workflow di analisi complessi.
- Ambiente di sviluppo agentico: i Data Practitioner, come i Data Engineer e i Data Scientist, inviano richieste in linguaggio naturale utilizzando uno dei seguenti metodi:
Workflow di Analytics
- Lakehouse senza confini: Lakehouse fornisce un catalogo di metadati unificato e ad alte prestazioni che integra il formato di tabella aperta Apache Iceberg con lo spazio di archiviazione di livello enterprise in Google Cloud. Con l'accesso ai dati cross-cloud, Lakehouse ti consente di federare cataloghi esterni come Databricks Unity Catalog senza spostare o copiare i dati.
- Managed Service for Apache Spark: questo è il componente principale per il trattamento dati nell'architettura. La funzionalità Lightning Engine di Managed Service for Apache Spark supporta l'elaborazione dei dati serverless ad alte prestazioni in modalità batch e interattiva. I job di elaborazione dei dati Spark utilizzano i metadati del catalogo Iceberg in Lakehouse, leggono i dati strutturati da BigQuery ed eseguono letture zero-copy da origini esterne come Amazon S3.
- Knowledge Catalog: l'agente utilizza Knowledge Catalog per eseguire scansioni intelligenti dei dati non strutturati in Cloud Storage, estrae i metadati semantici e crea un grafico di contesto.
Datastore attendibili
- Dati in Google Cloud: BigQuery funge da data warehouse centrale per i dati strutturati, inclusi gli estratti strutturati dai dati non strutturati in Cloud Storage.
- Dati provenienti da origini esterne: l'architettura mostra origini dati esterne, come i dati nei bucket Amazon S3 e i metadati in Databricks Unity Catalog. Cross-Cloud Interconnect fornisce una connettività dedicata a elevata larghezza di banda tra Google Cloud e altri provider di servizi cloud.
Prodotti utilizzati
L'architettura utilizza i seguenti prodotti e strumenti Google Cloud :
- Google Cloud Data Agent Kit: estensioni degli agenti per consentire a data scientist, data engineer e sviluppatori di app di dati di gestire l'intero ciclo di vita dei dati dai loro ambienti di sviluppo agentici preferiti.
- BigQuery: un data warehouse aziendale che ti aiuta a gestire e analizzare i tuoi dati con funzionalità integrate come machine learning, analisi geospaziale e business intelligence.
- Managed Service for Apache Spark: un servizio gestito che esegue workload batch Apache Spark su un'infrastruttura di computing gestita.
- Lakehouse: un motore di archiviazione ad alte prestazioni che consente di creare data lakehouse aperti e fornisce un'interfaccia unificata per l'analisi avanzata e l'AI.
- Knowledge Catalog: un servizio basato sull'AI che fornisce un catalogo unificato di asset di dati con funzionalità intelligenti di metadati e governance.
- Gemini: una famiglia di modelli di AI multimodali sviluppati da Google.
- Cloud Storage: un archivio di oggetti a basso costo e senza limiti per diversi tipi di dati. I dati sono accessibili dall'interno e dall'esterno di Google Cloude vengono replicati in più località per la ridondanza.
- Cross-Cloud Interconnect: un servizio che fornisce connettività dedicata a larghezza di banda elevata e bassa latenza tra Google Cloud e altri provider di servizi cloud.
- Server MCP di Google Cloud: servizi remoti gestiti da Google che implementano il Model Context Protocol (MCP) per fornire alle applicazioni AI l'accesso ai prodotti e ai servizi Google e Google Cloud .
Casi d'uso
L'architettura descritta in questo documento è adatta ai seguenti casi d'uso:
- Analisi dei dati multi-cloud: esegui query e analizza in modo efficiente i dati distribuiti su Google Cloud e altri provider di servizi cloud senza spostare i file o creare pipeline di estrazione, trasformazione, caricamento (ETL) complesse. Ad esempio, un responsabile del marketing di un retailer globale può analizzare l'efficacia delle campagne di marketing unendo i dati sulla fedeltà dei clienti in Amazon S3 con i dati sulle operazioni di marketing in BigQuery.
- Rilevamento intelligente dei dati: utilizza prompt in linguaggio naturale e agenti AI per scoprire, eseguire query ed elaborare set di dati federati in più ambienti. Ad esempio, un esperto di approvvigionamento può determinare le cause comuni delle interruzioni della catena di fornitura in base ai dati strutturati in un sistema di gestione della catena di fornitura (SCM) combinati con gli insight provenienti da comunicazioni via email non strutturate e report di valutazione dei danni.
- Estrazione di dati strutturati da fonti non strutturate: scansiona grandi volumi di dati non strutturati, ricava metadati semantici e archivia estratti di dati strutturati in BigQuery per l'analisi downstream. Ad esempio, un controller delle operazioni può analizzare in modo efficiente le spese estraendo dati strutturati da migliaia di fatture archiviate in un formato non strutturato, come i file PDF.
Considerazioni sulla sicurezza
Per contribuire ad affrontare i rischi di sicurezza unici degli agenti AI, Google consiglia un approccio che combina controlli di sicurezza deterministici con difese dinamiche basate sul ragionamento:
- Supervisione umana: incorpora un flusso human-in-the-loop nei sistemi aziendali critici in modo che i supervisori umani possano esaminare gli output e approvare, ignorare o mettere in pausa le azioni degli agenti.
- Agent Identity: assegna a ogni agente un'identità associata al workload per applicare controllo dell'accesso con privilegio minimo e gestire centralmente le credenziali per gli strumenti esterni.
- Agent Gateway: applica la governance del traffico in entrata e in uscita, le policy di accesso con rifiuto predefinito e l'ispezione dei prompt e degli strumenti in linea con Model Armor.
- Agent Registry: verifica che gli agenti si connettano solo a subagenti e strumenti MCP approvati.
Le indicazioni riportate in questa sezione non sono esaustive. Per saperne di più sui fattori di progettazione e sulle best practice, nonché per i consigli sulla creazione e sul deployment di un sistema di AI multi-agente, consulta Sistema di AI multi-agente in Google Cloud.
Per i principi e i suggerimenti di sicurezza specifici per i workload di AI e ML, consulta Prospettiva di AI e ML: sicurezza nel Well-Architected Framework.
Deployment
Per scoprire come creare una soluzione di analisi basata su agenti utilizzando Data Agent Kit, consulta il codelab Trasforma i dati non elaborati in previsioni in pochi secondi con gli agenti AI. Il codelab mostra come Data Agent Kit ti consente di analizzare i dati in modo efficiente dall'interno del tuo ambiente di sviluppo agentico preferito. Tutti i dati di esempio utilizzati dal codelab sono archiviati inGoogle Cloud.
Passaggi successivi
- Scopri come Data Agent Kit ti consente di utilizzare i notebook per la trasformazione e l'analisi dei dati.
- Esplora i casi d'uso di Knowledge Catalog.
- Scopri di più sull'accesso ai dati cross-cloud con Lakehouse.
- Scopri come accelerare i workload Apache Spark utilizzando Lightning Engine.
- Scopri come utilizzare Knowledge Catalog come livello di governance e agentico per BigQuery.
- Per ulteriori architetture di riferimento, diagrammi e best practice, esplora Cloud Architecture Center.
Collaboratori
Autore: Kumar Dhanagopal | Cross-Product Solution Developer
Altri collaboratori:
- Abirami Sukumaran | Staff Developer Advocate
- Arti Prasad | Technical Writer
- Brad Miro | Senior Developer Advocate
- Matthew Rahmann | Senior Product Manager
- Ranadip Chatterjee | Solutions Engineer
- Remigiusz Samborski | Lead Developer Relations Engineer