


Ce document fournit une architecture de haut niveau pour un système d'IA multi-agent déployé sur Cloud Run qui analyse des données multimodales disparates et produit une classification de haute confiance. Cette approche permet de valider de manière croisée les médias fragmentés en comparant les données en direct à la vérité terrain historique pour produire des insights ancrés et vérifiables.
Ce document s'adresse aux architectes, aux développeurs et aux administrateurs qui créent et gèrent des infrastructures et des applications d'IA dans le cloud. Ce document suppose que vous avez des connaissances de base sur les agents et les modèles d'IA. Ce document ne fournit pas de conseils spécifiques pour la conception et le codage d'agents IA.
La section Déploiement de ce document liste des exemples de code que vous pouvez utiliser pour apprendre à créer et à déployer des systèmes d'IA multi-agents.
Architecture
Le schéma suivant illustre l'architecture du système d'IA multi-agent qui utilise un modèle de conception d'agent parallèle pour coordonner l'analyse indépendante des données multimodales afin de produire une seule classification.
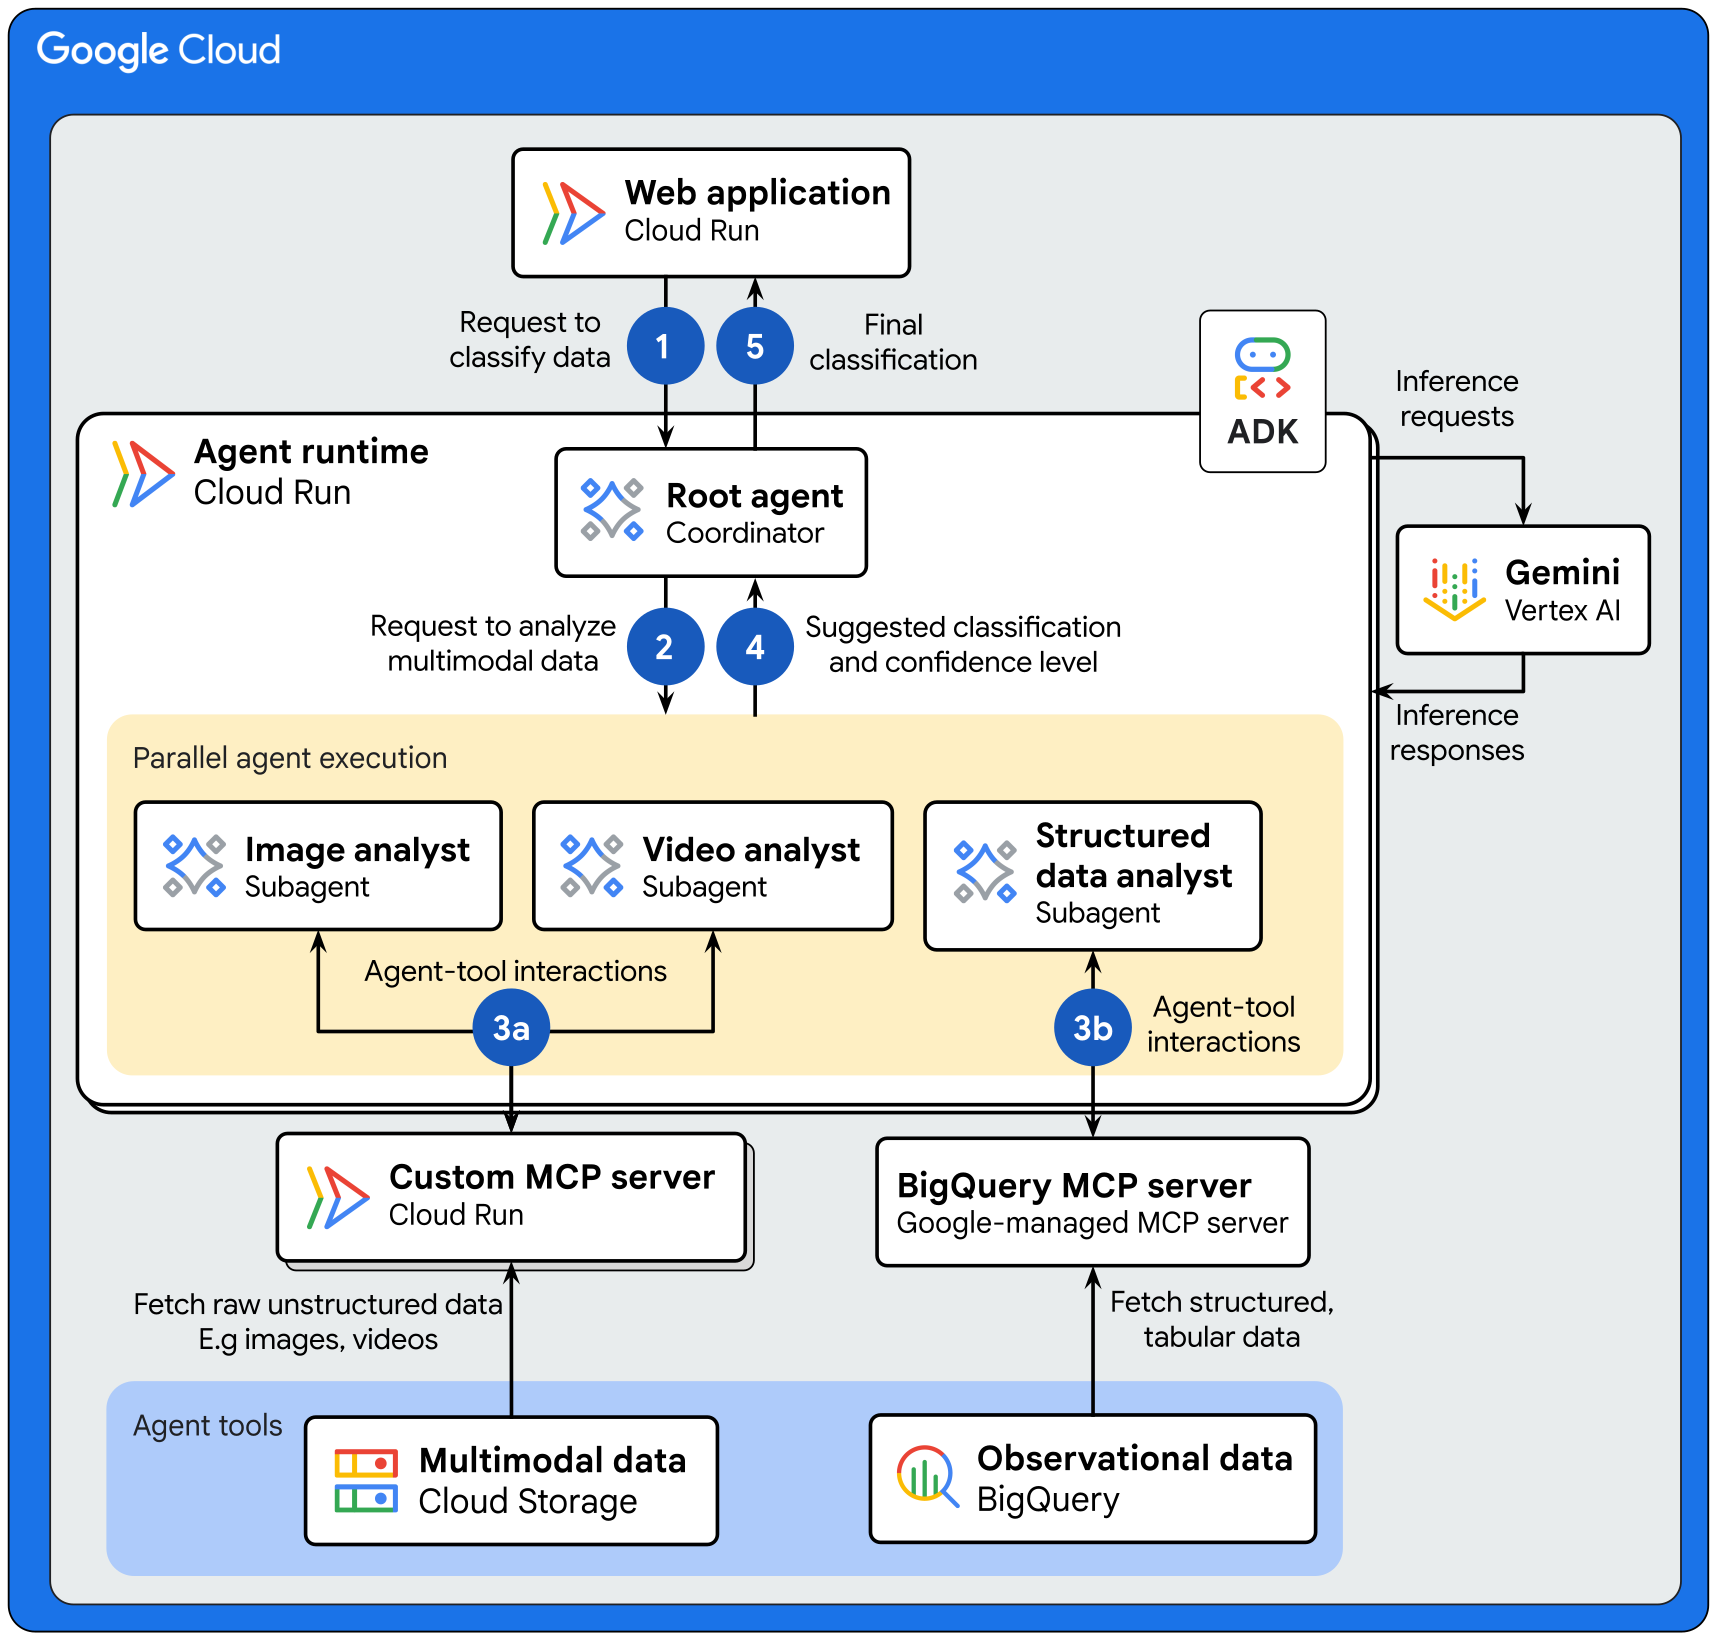
L'architecture présente le flux de données suivant :
- L'application Web envoie une requête à l'agent racine pour analyser un ensemble de données multimodales à des fins de classification. L'agent racine est un agent coordinateur qui reçoit les requêtes et est déployé sur un service Cloud Run.
- L'agent racine traite la requête comme suit :
- L'agent racine lance un
before_agent_callbackpour collecter les configurations d'environnement, valider les entrées utilisateur et enregistrer les chemins d'accès aux ressources dans un état de session partagé. Tous les sous-agents peuvent accéder à l'état de session partagé, ce qui élimine les appels redondants pour récupérer les données d'état et réduit la latence globale. - L'agent racine utilise Gemini sur Gemini Enterprise Agent Platform pour interpréter la requête de l'utilisateur et distribuer les tâches à des sous-agents spécialisés qui s'exécutent en parallèle.
- L'agent racine lance un
- Chaque sous-agent est spécialisé dans un domaine particulier et effectue les tâches suivantes de manière indépendante :
- Les sous-agents d'analyse d'images et de vidéos interagissent avec des serveurs MCP (Model Context Protocol) personnalisés pour effectuer les actions suivantes :
- Récupérez des données brutes non structurées stockées dans un bucket Cloud Storage.
- Envoyez une requête à Gemini pour interpréter les données d'entrée, les classer et calculer un niveau de confiance.
- Gemini renvoie la classification et le niveau de confiance suggérés au serveur MCP personnalisé.
- Le serveur MCP personnalisé transmet la réponse au sous-agent.
- Le sous-agent d'analyse de données structurées orchestre l'analyse en effectuant les tâches suivantes :
- Interagit avec le serveur MCP BigQuery pour récupérer des données structurées et contextuelles (telles que des enregistrements historiques, des journaux d'événements ou des relevés de capteurs) stockées dans un ensemble de données BigQuery.
- L'analyste de données structurées envoie une requête à Gemini pour interpréter les données d'entrée, les classer et calculer un niveau de confiance.
- Gemini renvoie la classification et le niveau de confiance suggérés au sous-agent.
- Les sous-agents d'analyse d'images et de vidéos interagissent avec des serveurs MCP (Model Context Protocol) personnalisés pour effectuer les actions suivantes :
- Chaque sous-agent renvoie la classification et le niveau de confiance suggérés à l'agent racine.
- L'agent racine utilise Gemini pour résumer les résultats des sous-agents spécialisés afin de produire une classification unique et fiable.
- Si la majorité des classifications des sous-agents spécialisés correspondent, l'agent racine envoie la classification correspondante à l'application Web.
- Si les sous-agents ne fournissent pas de classification correspondante, l'agent racine sélectionne la classification avec le niveau de confiance le plus élevé et l'envoie à l'application Web.
Produits utilisés
Cette architecture de référence utilise les produits et outils Google Cloud suivants :
- Cloud Run : plate-forme de calcul gérée qui vous permet d'exécuter des conteneurs directement sur l'infrastructure évolutive de Google.
- Gemini Enterprise Agent Platform : plate-forme complète qui vous permet de créer, de faire évoluer, de gérer et d'optimiser des agents IA de niveau entreprise.
- Gemini : famille de modèles d'IA multimodaux développés par Google.
- BigQuery : entrepôt de données d'entreprise qui vous aide à gérer et analyser vos données grâce à des fonctionnalités intégrées telles que le machine learning, l'analyse géospatiale et l'informatique décisionnelle.
- Cloud Storage : store d'objets économique et sans limite pour tout type de données. Les données sont accessibles depuis et en dehors de Google Cloud, et sont répliquées sur plusieurs emplacements à des fins de redondance.
- Serveurs MCP Google Cloud : services distants gérés par Google qui implémentent le protocole MCP (Model Context Protocol) pour permettre aux applications d'IA d'accéder aux produits et services Google et Google Cloud .
- Model Context Protocol (MCP) : norme Open Source permettant de connecter des applications d'IA à des systèmes externes.
- Agent Development Kit (ADK) : ensemble d'outils et de bibliothèques permettant de développer, de tester et de déployer des agents IA.
Pour savoir comment sélectionner d'autres composants pour votre système d'IA agentique, y compris le framework, l'Agent Runtime, les outils, la mémoire et les modèles de conception, consultez Choisir les composants de votre architecture d'IA agentique.
Cas d'utilisation
Cette architecture est conçue pour les cas d'utilisation qui synthétisent diverses données multimodales pour les tâches de classification et de détection. Pour améliorer la précision et l'évolutivité, l'architecture utilise un système d'IA multi-agent au lieu d'une approche monolithique à agent unique. Ce modèle de conception fournit des instructions ciblées, évite les directives contradictoires, permet d'utiliser des ensembles d'outils plus petits pour prendre des décisions plus rapidement et accepte les mises à jour indépendantes, ce qui permet d'obtenir des résultats plus robustes et plus sophistiqués.
Voici des exemples de cas d'utilisation de l'architecture décrite dans ce document :
- Diagnostic médical : fournissez des évaluations diagnostiques complètes en déployant des agents spécialisés pour analyser de manière indépendante les images médicales, les symptômes des patients et les résultats de laboratoire. Le système d'IA résume ces résultats en fonction d'un seuil de confiance déterminé afin de fournir aux cliniciens des insights fondés et vérifiables.
- Détection des fraudes : détectez et signalez les fraudes potentielles en déployant des agents pour analyser de manière indépendante les schémas de comportement des utilisateurs et les données de transaction, comme les reçus scannés et les factures des marchands. En croisant les preuves visuelles des documents avec l'activité réseau numérique, le système identifie les écarts et signale toutes les transactions pour lesquelles un seul agent identifie un indicateur suspect.
- Traitement des documents : automatisez la classification et l'extraction d'informations à partir de documents en déployant des agents spécialisés pour la reconnaissance optique des caractères (OCR), la classification des documents et l'extraction de données. Pour assurer un traitement hautement fiable, le système d'IA exige que tous les agents s'accordent sur le résultat.
- Contrôle qualité : classez la qualité des produits ou détectez les anomalies en déployant des agents spécialisés pour l'inspection visuelle, l'analyse des données des capteurs et la vérification des spécifications. Le système détermine si le test est réussi ou non en fonction d'un seuil de confiance déterminé parmi les agents.
Considérations de conception
Cette section décrit les facteurs de conception, les bonnes pratiques et les recommandations à prendre en compte lorsque vous utilisez cette architecture de référence pour développer une topologie qui répond à vos exigences spécifiques en termes de sécurité, de coût et de performances.
Les conseils de cette section ne sont pas exhaustifs. Pour en savoir plus sur les facteurs de conception et les bonnes pratiques, et pour obtenir des recommandations sur la création et le déploiement d'un système d'IA multi-agent, consultez Système d'IA multi-agent dans Google Cloud.
Sécurité, confidentialité et conformité
Pour aider à gérer les risques de sécurité uniques des agents d'IA, Google recommande une approche qui combine des contrôles de sécurité déterministes avec des défenses dynamiques basées sur le raisonnement :
- Supervision humaine : intégrez un flux human-in-the-loop (avec intervention humaine) dans les systèmes critiques pour l'entreprise afin que les superviseurs humains puissent examiner les résultats et approuver, ignorer ou suspendre les actions des agents.
- Agent Identity : attribuez à chaque agent une identité liée à la charge de travail pour appliquer le contrôle des accès basé sur le principe du moindre privilège et gérer de manière centralisée les identifiants des outils externes.
- Agent Gateway : appliquez la gouvernance du trafic entrant et sortant, des règles d'accès de refus par défaut, ainsi que l'inspection intégrée des prompts et des outils avec Model Armor.
Agent Registry : vérifiez que les agents ne se connectent qu'aux sous-agents et aux outils MCP approuvés.
Sécurité d'entrée de l'application : pour contrôler l'accès à l'application, désactivez l'URL run.app par défaut du service Cloud Run d'interface et configurez un équilibreur de charge d'application externe régional. En plus d'équilibrer la charge du trafic entrant vers l'application, l'équilibreur de charge gère les certificats SSL. Pour une protection renforcée, utilisez les stratégies de sécurité Google Cloud Armor afin de fournir un filtrage des requêtes, une protection contre les attaques DDoS et une limitation du débit pour le service.
Sécurité des images de conteneurs : pour vous assurer que seules les images de conteneurs autorisées sont déployées sur Cloud Run, utilisez l'autorisation binaire. Pour identifier et atténuer les risques de sécurité dans les images de conteneurs, exécutez automatiquement des analyses de failles à l'aide d'Artifact Analysis. Pour en savoir plus, consultez Présentation de l'analyse des conteneurs.
Sécurité du stockage : Cloud Storage propose deux systèmes pour contrôler l'accès des utilisateurs à vos buckets et objets : Identity and Access Management (IAM) et les listes de contrôle des accès (LCA). Dans la plupart des cas, nous vous recommandons d'utiliser IAM, qui vous permet d'accorder des autorisations au niveau du bucket et du projet. Pour en savoir plus, consultez la page Présentation du contrôle des accès.
Optimisation des coûts
Pour vous assurer que les configurations de votre agent répondent à vos exigences de coût, tenez compte des recommandations suivantes :
- Prompting économique : la longueur de vos prompts (entrée) et des réponses générées (sortie) affecte directement les performances et les coûts. Rédigez des prompts courts, directs et fournissant suffisamment de contexte. Pour en savoir plus, consultez les bonnes pratiques pour la conception de requêtes.
- Coûts de stockage : pour contrôler les coûts de stockage, vous pouvez choisir la classe de stockage Standard et activer la gestion du cycle de vie des objets et la classe automatique. Ces fonctionnalités vous aident à optimiser les coûts en déplaçant ou en supprimant automatiquement des données entre les classes de stockage en fonction de vos modèles d'accès ou des règles que vous définissez.
Optimisation des performances
Pour vous assurer que vos configurations d'agent répondent à vos exigences de performances, tenez compte des recommandations suivantes :
- Allocation des ressources : en fonction de vos exigences de performances, configurez les limites de mémoire et les limites de processeur à allouer au service Cloud Run. Pour obtenir d'autres conseils d'optimisation des performances, consultez Conseils de développement généraux pour Cloud Run.
Déploiement
Pour déployer un exemple d'implémentation de cette architecture, suivez l'atelier de programmation Way Back Home : niveau 1.
Étapes suivantes
- Découvrez comment héberger des agents IA sur Cloud Run.
- Découvrez comment créer et déployer un serveur MCP distant sur Cloud Run.
- Découvrez comment choisir les composants de votre architecture d'IA agentive.
- (Vidéo) Regardez le podcast Agent Factory sur la création d'outils personnalisés pour les agents.
- Découvrez des ressources de formation pour créer et déployer des agents de niveau entreprise avec Gemini Enterprise Agent Ready (GEAR).
- Découvrez d'autres guides sur l'architecture de l'IA agentique.
- Pour obtenir un aperçu des principes et recommandations d'architecture spécifiques aux charges de travail d'IA et de ML dans Google Cloud, consultez la perspective IA et ML dans le Well-Architected Framework.
- Pour découvrir d'autres architectures de référence, schémas et bonnes pratiques, consultez le Centre d'architecture cloud.
Contributeurs
Auteur : Samantha He | Rédactrice technique
Autres contributeurs :
- Amina Mansour | Tech Lead, Global Developer Relations & Strategic Content
- Andrey Shakirov | Architecte de solutions, Google Cloud
- Ayo Adedeji | Ingénieur relations avec les développeurs
- Christina Lin | Responsable des ingénieurs relations avec les développeurs
- Kumar Dhanagopal Développeur de solutions multiproduits
- Ryan Pei | Responsable produit, Google Cloud