


במסמך הזה מתוארת ארכיטקטורה לדוגמה, שבעזרתה תוכלו ליצור מנגנון לייצוא יומנים שמוכן לייצור, ניתן להתאמה לעומס, עמיד בפני תקלות ומעביר בסטרימינג יומנים ואירועים מהמשאבים שלכם ב- Google Cloud אל Splunk. Splunk הוא כלי פופולרי לניתוח נתונים שמציע פלטפורמה מאוחדת לאבטחה וליכולת תצפית. למעשה, אתם יכולים לייצא את נתוני הרישום ל-Splunk Enterprise או ל-Splunk Cloud Platform. אדמינים יכולים להשתמש בארכיטקטורה הזו גם לתרחישי שימוש של פעולות IT או אבטחה.
ארכיטקטורת ההפניה הזו מניחה היררכיית משאבים שדומה לתרשים הבא. כל Google Cloud יומני המשאבים מכל הרמות – ארגון, תיקייה ופרויקט – נאספים ב-aggregated sink. לאחר מכן, הכיור המצטבר שולח את היומנים האלה לצינור עיבוד נתונים לייצוא יומנים, שמעבד את היומנים ומייצא אותם ל-Splunk.

ארכיטקטורה
בתרשים הבא מוצגת ארכיטקטורת העזר שבה משתמשים כשפורסים את הפתרון הזה. התרשים הבא ממחיש איך נתוני היומן זורמים מ-Google Cloud ל-Splunk.

הארכיטקטורה הזו כוללת את הרכיבים הבאים:
- Cloud Logging: כדי להתחיל את התהליך, Cloud Logging אוסף את היומנים ל-sink ביומן מצטבר ברמת הארגון ושולח את היומנים ל-Pub/Sub.
- Pub/Sub: שירות Pub/Sub יוצר נושא ומינוי יחידים ליומנים, ומעביר את היומנים לצינור הראשי של Dataflow.
- Dataflow: בארכיטקטורה לדוגמה יש שני צינורות עיבוד נתונים של Dataflow:
- פייפליין Dataflow ראשי: במרכז התהליך, פייפליין Dataflow הראשי הוא פייפליין זורם מ-Pub/Sub ל-Splunk, שמושך יומנים מהמינוי ל-Pub/Sub ומעביר אותם ל-Splunk.
- צינור עיבוד נתונים משני של Dataflow: במקביל לצינור עיבוד הנתונים הראשי של Dataflow, צינור עיבוד הנתונים המשני של Dataflow הוא צינור עיבוד נתונים בסטרימינג מ-Pub/Sub ל-Pub/Sub, שמשמש להפעלה מחדש של הודעות אם המסירה נכשלת.
- Splunk: בסוף התהליך, Splunk Enterprise או Splunk Cloud Platform פועלים כ-HTTP Event Collector (HEC) ומקבלים את היומנים לצורך ניתוח נוסף. אפשר לפרוס את Splunk באופן מקומי, ב-Google Cloud כ-SaaS או בגישה היברידית.
תרחיש לדוגמה
ארכיטקטורת העזר הזו מבוססת על גישה מבוססת-דחיפה בענן. בשיטה הזו, שמתבססת על דחיפה, משתמשים בתבנית של Dataflow להעברת נתונים מ-Pub/Sub ל-Splunk כדי להעביר בסטרימינג יומנים אל Splunk HTTP Event Collector (HEC). בארכיטקטורה לדוגמה מוסבר גם איך לתכנן את הקיבולת של צינור עיבוד הנתונים ב-Dataflow, ואיך לטפל בכשלים פוטנציאליים במסירה כשיש בעיות זמניות בשרת או ברשת.
למרות שארכיטקטורת העזר הזו מתמקדת ביומני Google Cloud , אפשר להשתמש באותה ארכיטקטורה כדי לייצא נתוני Google Cloud אחרים, כמו שינויים בנכסים בזמן אמת וממצאי אבטחה. שילוב היומנים מ-Cloud Logging מאפשר לכם להמשיך להשתמש בשירותים קיימים של שותפים, כמו Splunk, כפתרון מאוחד לניתוח יומנים.
לשיטה שמבוססת על דחיפה להעברת נתונים מ- Google Cloud ל-Splunk יש את היתרונות הבאים:
- שירות מנוהל. כחלק מהשירות המנוהל, Dataflow מתחזק את המשאבים הנדרשים ב- Google Cloud למשימות של עיבוד נתונים, כמו ייצוא יומנים.
- עומס עבודה מבוזר. השיטה הזו מאפשרת לכם לפזר את עומסי העבודה בין כמה מופעי worker לעיבוד מקביל, כך שלא תהיה נקודה אחת של כשל.
- אבטחה. Google Cloud מעביר את הנתונים שלכם ל-Splunk HEC, כך שאין צורך ליצור ולנהל מפתחות של חשבון שירות, ואין נטל תחזוקה ואבטחה שקשור לכך.
- התאמה אוטומטית לעומס. שירות Dataflow משנה באופן אוטומטי את מספר ה-workers בהתאם לשינויים בנפח היומנים הנכנסים ובצבר המשימות.
- עמיד בכשלים. אם יש בעיות זמניות בשרת או ברשת, השיטה מבוססת-הדחיפה מנסה לשלוח מחדש את הנתונים ל-Splunk HEC באופן אוטומטי. הוא גם תומך בנושאים שלא עברו עיבוד (שנקראים גם נושאים להודעות ללא מוצא) לכל הודעות היומן שלא ניתן לשלוח, כדי למנוע אובדן נתונים.
- פשטות. אתם נמנעים מהתקורה של הניהול ומהעלות של הפעלת מעבירי נתונים כבדים אחד או יותר ב-Splunk.
ארכיטקטורת העזר הזו רלוונטית לעסקים בענפים רבים ושונים, כולל ענפים בפיקוח כמו תרופות ושירותים פיננסיים. כשבוחרים לייצא את Google Cloud הנתונים אל Splunk, יכולות להיות לכך כמה סיבות:
- ניתוח נתונים עסקיים
- תפעול IT
- מעקב אחר ביצועי אפליקציות
- תפעול אבטחה (SecOps)
- תאימות
חלופות עיצוב
שיטה חלופית לייצוא יומנים אל Splunk היא שליפת יומנים מ-Google Cloud. בשיטה הזו, שמתבססת על משיכה, משתמשים בממשקי Google Cloud API כדי לאחזר את הנתונים באמצעות Splunk Add-on for Google Cloud. אפשר להשתמש בשיטה מבוססת-משיכה במצבים הבאים:
- בפריסה של Splunk אין נקודת קצה (endpoint) של Splunk HEC.
- נפח היומן נמוך.
- רוצים לייצא ולנתח מדדים של Cloud Monitoring, אובייקטים של Cloud Storage, מטא-נתונים של Cloud Resource Manager API, נתוני חיוב ב-Cloud או יומנים עם נפח נמוך.
- אתם כבר מנהלים לפחות משגר כבד אחד ב-Splunk.
- אתם משתמשים ב-Inputs Data Manager for Splunk Cloud שמתארח.
חשוב גם לזכור את השיקולים הנוספים שעולים כשמשתמשים בשיטה הזו:
- עובד יחיד מטפל בעומס העבודה של הטמעת נתונים, ולכן אין אפשרות להתאמה אוטומטית לעומס.
- ב-Splunk, שימוש ב-heavy forwarder כדי למשוך נתונים עלול לגרום לנקודת כשל בודדת.
- בשיטה מבוססת-השליפה, צריך ליצור ולנהל את המפתחות של חשבון השירות שמשמשים להגדרת התוסף Splunk ל- Google Cloud.
לפני שמשתמשים בתוסף של Splunk, צריך לנתב את רשומות היומן ל-Pub/Sub באמצעות sink ביומן. כדי ליצור sink ביומן עם נושא Pub/Sub כיעד, ראו יצירת sink.
חשוב להקצות את התפקיד "פרסום הודעות ב-Pub/Sub" (roles/pubsub.publisher) לזהות הכותב של הכיור ביעד של הנושא ב-Pub/Sub. למידע נוסף על הגדרת הרשאות ליעד של sink, קראו את המאמר הגדרת הרשאות ליעד.
כדי להפעיל את התוסף של Splunk:
- ב-Splunk, פועלים לפי ההוראות של Splunk כדי להתקין את התוסף של Splunk ל- Google Cloud.
- אם אין לכם עדיין מינוי שליפה ב-Pub/Sub, יוצרים מינוי כזה לנושא Pub/Sub שאליו מנותבים היומנים.
- יצירה של חשבון שירות.
- יוצרים מפתח לחשבון השירות שזה עתה יצרתם.
- כדי לאפשר לחשבון השירות לקבל הודעות מהמינוי ל-Pub/Sub, צריך להקצות לחשבון השירות את התפקידים 'צפייה ב-Pub/Sub' (
roles/pubsub.viewer) ו'הרשמה למינוי ב-Pub/Sub' (roles/pubsub.subscriber). ב-Splunk, פועלים לפי ההוראות של Splunk כדי להגדיר קלט חדש של Pub/Sub בתוסף Splunk ל- Google Cloud.
ההודעות של Pub/Sub מייצוא היומנים מופיעות ב-Splunk.
כדי לוודא שהתוסף פועל, פועלים לפי השלבים הבאים:
- ב-Cloud Monitoring, פותחים את Metrics Explorer.
- בתפריט Resources, בוחרים באפשרות
pubsub_subscription. - בקטגוריות Metric, בוחרים באפשרות
pubsub/subscription/pull_message_operation_count. - עוקבים אחרי מספר הפעולות של שליפת הודעות למשך דקה עד שתי דקות.
שיקולים בתכנון
ההנחיות הבאות יעזרו לכם לפתח ארכיטקטורה שעומדת בדרישות הארגון שלכם בנוגע לאבטחה, פרטיות, תאימות, יעילות תפעולית, מהימנות, עמידות בפני תקלות, ביצועים ואופטימיזציה של עלויות.
אבטחה, פרטיות ותאימות
בקטעים הבאים מתוארים שיקולי האבטחה של ארכיטקטורת העזר הזו:
- שימוש בכתובות IP פרטיות כדי לאבטח את המכונות הווירטואליות שתומכות בצינור עיבוד הנתונים ב-Dataflow
- הפעלת גישה פרטית ל-Google
- הגבלת תעבורת הנתונים הנכנסת (ingress) של Splunk HEC לכתובות IP ידועות שמשמשות את Cloud NAT
- אחסון האסימון של Splunk HEC ב-Secret Manager
- יצירת חשבון שירות מותאם אישית של Dataflow worker VM כדי לפעול לפי השיטות המומלצות להרשאות מינימליות
- הגדרת אימות SSL לאישור CA בסיסי פנימי אם משתמשים ב-CA פרטי
שימוש בכתובות IP פרטיות כדי לאבטח את המכונות הווירטואליות שתומכות בצינור עיבוד הנתונים ב-Dataflow
מומלץ להגביל את הגישה למכונות הווירטואליות של ה-worker שמשמשות בצינור עיבוד הנתונים של Dataflow. כדי להגביל את הגישה, צריך לפרוס את המכונות הווירטואליות האלה עם כתובות IP פרטיות. עם זאת, המכונות הווירטואליות האלה צריכות גם להיות מסוגלות להשתמש ב-HTTPS כדי להזרים את היומנים המיוצאים ל-Splunk ולגשת לאינטרנט. כדי לספק את הגישה הזו ל-HTTPS, צריך שער Cloud NAT שמקצה באופן אוטומטי כתובות IP של Cloud NAT למכונות הווירטואליות שזקוקות להן. חשוב למפות את רשת המשנה שמכילה את המכונות הווירטואליות לשער Cloud NAT.
הפעלת גישה פרטית ל-Google
כשיוצרים שער Cloud NAT, הגישה הפרטית ל-Google מופעלת באופן אוטומטי. עם זאת, כדי לאפשר ל-workers של Dataflow עם כתובות IP פרטיות לגשת לכתובות ה-IP החיצוניות שבהן משתמשים ממשקי ה-API והשירותים של Google Cloud, צריך גם להפעיל באופן ידני את הגישה הפרטית ל-Google ברשת המשנה.
הגבלת תעבורת נתונים נכנסת (ingress) של Splunk HEC לכתובות IP מוכרות שמשמשות את Cloud NAT
אם אתם רוצים להגביל את התנועה ל-Splunk HEC לקבוצת משנה של כתובות IP ידועות, אתם יכולים לשמור כתובות IP סטטיות ולהקצות אותן באופן ידני לשער Cloud NAT. בהתאם לפריסה של Splunk, תוכלו להגדיר את כללי חומת האש של Ingress ב-HEC של Splunk באמצעות כתובות ה-IP הסטטיות האלה. מידע נוסף על Cloud NAT זמין במאמר בנושא הגדרה וניהול של תרגום כתובות רשת באמצעות Cloud NAT.
אחסון הטוקן של Splunk HEC ב-Secret Manager
כשפורסים את צינור עיבוד הנתונים של Dataflow, אפשר להעביר את ערך הטוקן באחת מהדרכים הבאות:
- Plaintext
- טקסט מוצפן שהוצפן באמצעות מפתח של Cloud Key Management Service
- גרסת סוד שמוצפנת ומנוהלת על ידי Secret Manager
בארכיטקטורה לדוגמה הזו, אתם משתמשים באפשרות Secret Manager כי היא מציעה את הדרך הכי פחות מורכבת והכי יעילה להגן על טוקן ה-HEC של Splunk. האפשרות הזו גם מונעת דליפה של אסימון Splunk HEC ממסוף Dataflow או מפרטי המשימה.
סוד ב-Secret Manager מכיל אוסף של גרסאות סוד. בכל גרסה של סוד מאוחסנים נתוני הסוד בפועל, כמו אסימון Splunk HEC. אם בהמשך תבחרו להחליף את אסימון ה-HEC של Splunk כאמצעי אבטחה נוסף, תוכלו להוסיף את האסימון החדש כגרסה חדשה של הסוד הזה. מידע כללי על רוטציה של סודות מופיע במאמר מידע על לוחות זמנים לרוטציה.
יצירת חשבון שירות של worker VM בהתאמה אישית ל-Dataflow כדי לפעול לפי השיטות המומלצות של הרשאות מינימליות
רכיבי ה-worker בצינור עיבוד הנתונים של Dataflow משתמשים בחשבון השירות של Dataflow worker כדי לגשת למשאבים ולבצע פעולות. כברירת מחדל, ה-workers משתמשים בחשבון השירות שמוגדר כברירת מחדל ב-Compute Engine בפרויקט שלכם בתור חשבון השירות של ה-worker, מה שנותן להם הרשאות נרחבות לכל המשאבים בפרויקט. עם זאת, כדי להריץ משימות של Dataflow בסביבת ייצור, מומלץ ליצור חשבון שירות בהתאמה אישית עם סט מינימלי של תפקידים והרשאות. לאחר מכן, תוכלו להקצות את חשבון השירות המותאם אישית הזה לעובדים בצינור Dataflow.
בתרשים הבא מפורטים התפקידים הנדרשים שצריך להקצות לחשבון שירות כדי שעובדי Dataflow יוכלו להריץ משימת Dataflow בהצלחה.
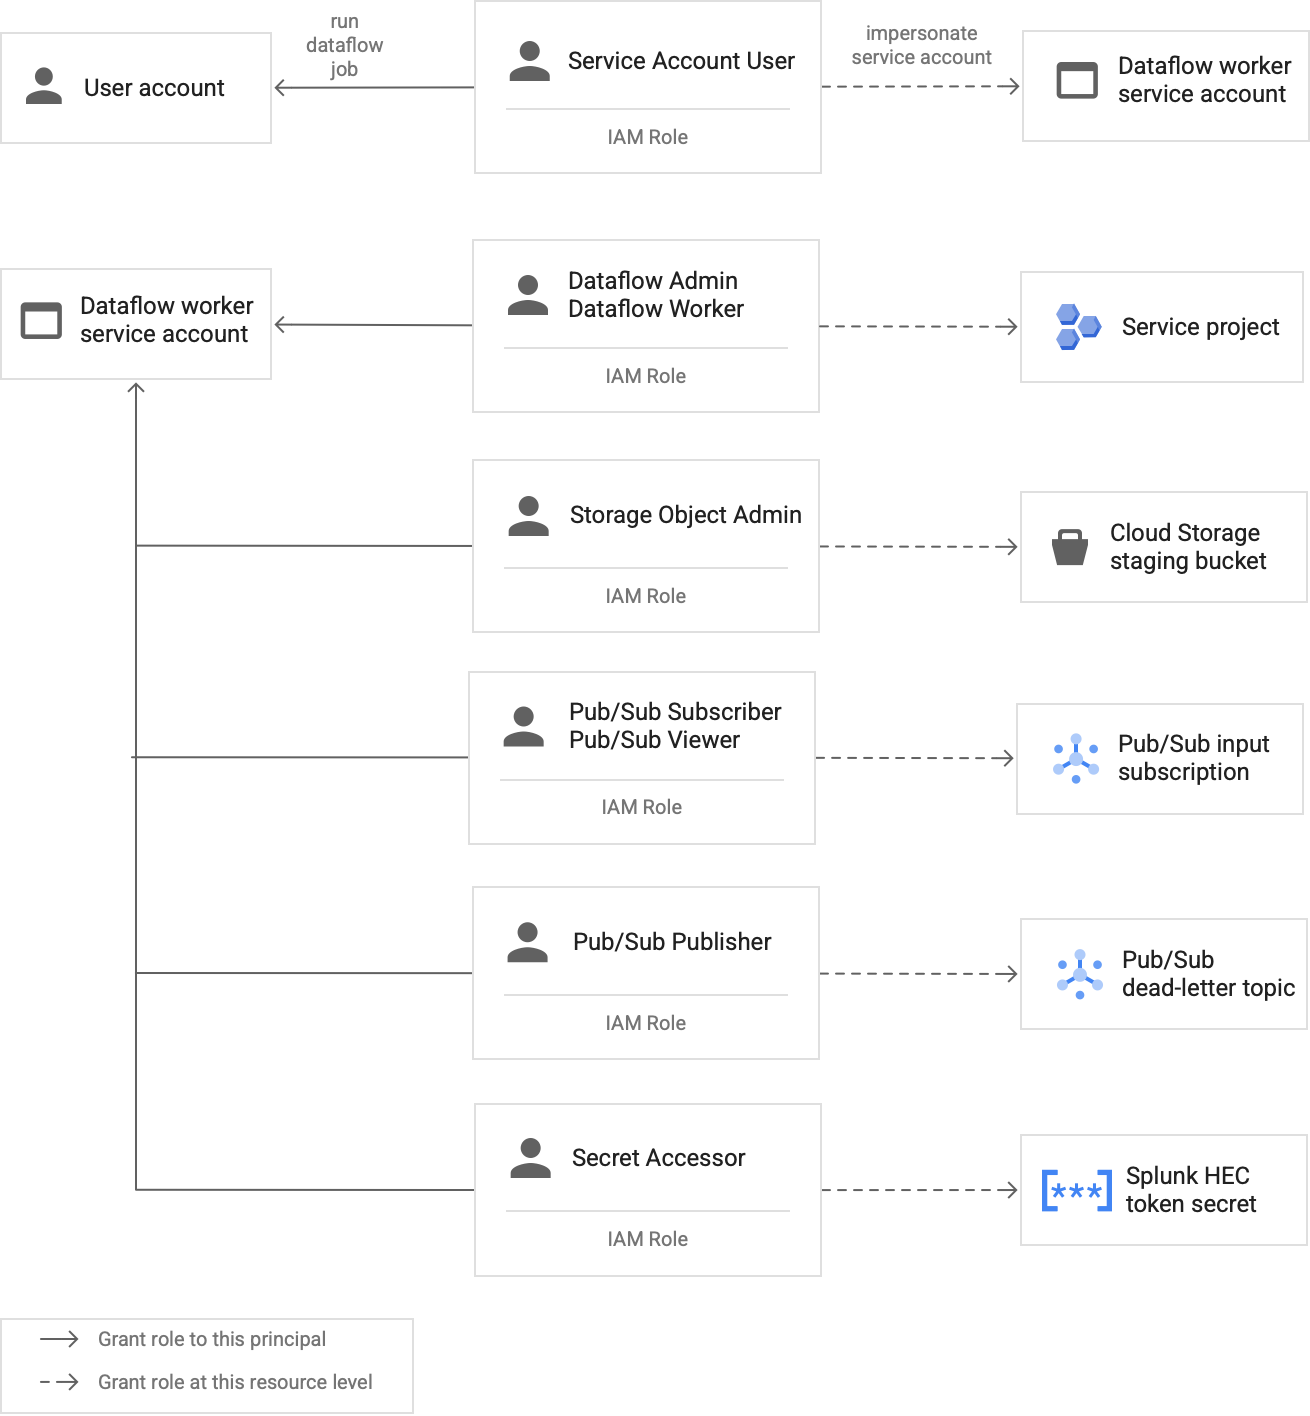
כפי שמוצג בדיאגרמה, צריך להקצות את התפקידים הבאים לחשבון השירות של ה-worker ב-Dataflow:
- אדמין ב-Dataflow
- Dataflow Worker
- אדמין של אובייקטים באחסון
- קבלת הודעות ב-Pub/Sub
- צפייה ב-Pub/Sub
- פרסום הודעות ב-Pub/Sub
- Secret Accessor
אם אתם משתמשים ברשות אישורים פרטית, אתם צריכים להגדיר אימות SSL עם אישור CA בסיסי פנימי
כברירת מחדל, צינור עיבוד הנתונים של Dataflow משתמש במאגר האישורים שמוגדר כברירת מחדל ב-Dataflow worker כדי לאמת את אישור ה-SSL של נקודת הקצה של Splunk HEC. אם אתם משתמשים ברשות אישורים (CA) פרטית כדי לחתום על אישור SSL שמשמש את נקודת הקצה של Splunk HEC, אתם יכולים לייבא את אישור ה-CA הבסיסי הפנימי שלכם למאגר האישורים. לאחר מכן, תהיה לעובדים של Dataflow אפשרות להשתמש באישור המיובא לצורך אימות אישור SSL.
אתם יכולים להשתמש באישורי CA פנימיים משלכם ברמת הבסיס ולייבא אותם לפריסות של Splunk עם אישורים בחתימה עצמית או בחתימה פרטית. אפשר גם להשבית את אימות ה-SSL לחלוטין, רק למטרות פיתוח ובדיקה פנימיים. השיטה הזו של רשות אישורים פנימית ברמה הבסיסית מתאימה במיוחד לפריסות פנימיות של Splunk שלא מחוברות לאינטרנט.
למידע נוסף, קראו את הפרמטרים של תבנית Pub/Sub to Splunk Dataflow
rootCaCertificatePath ו-disableCertificateValidation.
יעילות תפעולית
בקטעים הבאים מפורטים שיקולים לגבי יעילות תפעולית בארכיטקטורת ההפניה הזו:
שימוש ב-UDF כדי לשנות יומנים או אירועים בזמן ההעברה
תבנית Pub/Sub ל-Splunk Dataflow תומכת בפונקציות מוגדרות על ידי המשתמש (UDF) לצורך טרנספורמציה של אירועים בהתאמה אישית. דוגמאות לתרחישי שימוש: הוספת שדות נוספים לרשומות, הסתרת שדות רגישים או סינון רשומות לא רצויות. הפונקציה UDF מאפשרת לשנות את פורמט הפלט של צינור Dataflow בלי להדר מחדש או לתחזק את קוד התבנית עצמה. בארכיטקטורת ההפניה הזו נעשה שימוש בפונקציה מוגדרת על ידי המשתמש (UDF) כדי לטפל בהודעות שצינור הנתונים לא יכול להעביר ל-Splunk.
הפעלה מחדש של הודעות שלא עברו עיבוד
לפעמים מתקבלות שגיאות מסירה בצינור עיבוד הנתונים, והוא לא מנסה לשלוח שוב את ההודעה. במקרה כזה, Dataflow שולח את ההודעות שלא עובדו לנושא שלא עובד, כמו שמוצג בתרשים הבא. אחרי שמתקנים את שורש הבעיה שגרמה לכשל במסירה, אפשר להפעיל מחדש את ההודעות שלא עובדו.
השלבים הבאים מתארים את התהליך שמוצג בתרשים הקודם:
- צינור עיבוד המסירה הראשי מ-Pub/Sub ל-Splunk מעביר אוטומטית הודעות שלא ניתן למסור לנושא שלא עבר עיבוד, כדי שהמשתמש יוכל לבדוק אותן.
האופרטור או מהנדס ה-SRE בודקים את ההודעות שנכשלו במינוי שלא עבר עיבוד. המפעיל פותר בעיות ומתקן את שורש הבעיה של כשל המסירה. לדוגמה, תיקון הגדרה שגויה של אסימון HEC יכול לאפשר את שליחת ההודעות.
המפעיל מפעיל את צינור עיבוד הנתונים של ההודעות שנכשלו בהפעלה מחדש. הצינור הזה, מ-Pub/Sub ל-Pub/Sub (מודגש בקטע המקווקו בתרשים הקודם), הוא צינור זמני שמעביר את ההודעות שנכשלו מהמינוי שלא עבר עיבוד בחזרה לנושא המקורי של ה-sink ביומן.
צינור המסירה הראשי מעבד מחדש את ההודעות שנכשלו קודם. בשלב הזה, צריך להשתמש ב-UDF בצינור עיבוד הנתונים כדי לזהות ולפענח בצורה נכונה את המטענים הייעודיים של ההודעות שנכשלו. הקוד הבא הוא דוגמה לפונקציה שמיישמת את הלוגיקה הזו של פענוח מותנה, כולל סיכום של ניסיונות המסירה למטרות מעקב:
// If the message has already been converted to a Splunk HEC object
// with a stringified obj.event JSON payload, then it's a replay of
// a previously failed delivery.
// Unnest and parse the obj.event. Drop the previously injected
// obj.attributes such as errorMessage and timestamp
if (obj.event) {
 try {
   event = JSON.parse(obj.event);
   redelivery = true;
 } catch(e) {
   event = obj;
 }
} else {
 event = obj;
}

// Keep a tally of delivery attempts
event.delivery_attempt = event.delivery_attempt || 1;
if (redelivery) {
 event.delivery_attempt += 1;
}
אמינות ועמידות בפני תקלות
בטבלה הבאה, טבלה 1, מפורטות כמה שגיאות אפשריות בשליחה של Splunk, בהקשר של אמינות ועמידות בפני תקלות. בטבלה מפורטים גם המאפיינים התואמים של errorMessage שהצינור מתעד בכל הודעה לפני שהוא מעביר את ההודעות האלה לנושא שלא עבר עיבוד.
טבלה 1: סוגי שגיאות מסירה ב-Splunk
| סוג שגיאת המסירה | האם הצינור לעיבוד נתונים ניסה שוב באופן אוטומטי? | דוגמה למאפיין errorMessage |
|---|---|---|
שגיאה זמנית בחיבור לרשת |
כן |
או
|
שגיאת 5xx בשרת Splunk |
כן |
|
שגיאת 4xx בשרת Splunk |
לא |
|
השרת של Splunk מושבת |
לא |
|
אישור ה-SSL של Splunk לא תקין |
לא |
|
שגיאת תחביר JavaScript בפונקציה בהגדרת המשתמש (UDF) |
לא |
|
במקרים מסוימים, הצינור מבצע השהיה מעריכית לפני ניסיון חוזר (exponential backoff) ומנסה לשלוח את ההודעה שוב באופן אוטומטי. לדוגמה, כששרת Splunk יוצר קוד שגיאה 5xx, הצינור צריך לשלוח מחדש את ההודעה. קודי השגיאה האלה מופיעים כשנקודת הקצה של Splunk HEC עמוסה מדי.
לחלופין, יכול להיות שיש בעיה מתמשכת שמונעת את שליחת ההודעה לנקודת הקצה של HEC. במקרים כאלה, הצינור לא מנסה למסור את ההודעה שוב. הנה כמה דוגמאות לבעיות מתמשכות:
- שגיאת תחביר בפונקציית UDF.
- טוקן HEC לא תקין שגורם לשרת Splunk ליצור תגובת שרת
4xx"Forbidden".
אופטימיזציה של ביצועים ועלויות
לגבי אופטימיזציה של הביצועים והעלויות, צריך לקבוע את הגודל המקסימלי ואת קצב העברת הנתונים של צינור עיבוד הנתונים של Dataflow. אתם צריכים לחשב את הערכים הנכונים של הגודל וקצב העברת הנתונים כדי שצינור הנתונים יוכל להתמודד עם נפח היומנים היומי המקסימלי (GB/יום) ועם קצב ההודעות ביומן (אירועים לשנייה, או EPS) מהמינוי של Pub/Sub במעלה הזרם.
צריך לבחור את ערכי הגודל והתפוקה כדי שהמערכת לא תגרום לאחת מהבעיות הבאות:
- עיכובים שנגרמים בגלל הצטברות של הודעות בתור או הגבלת קצב השליחה של הודעות.
- עלויות נוספות כתוצאה מהקצאת יתר של משאבים לצינור עיבוד נתונים.
אחרי שמבצעים את חישובי הגודל וקצב הנתונים, אפשר להשתמש בתוצאות כדי להגדיר צינור עיבוד נתונים אופטימלי שמאזן בין הביצועים לעלות. כדי להגדיר את הקיבולת של צינור המכירות, משתמשים בהגדרות הבאות:
- הדגלים Machine type ו-Machine count הם חלק מפקודת gcloud שפורסת את משימת Dataflow. הדגלים האלה מאפשרים להגדיר את הסוג ומספר המכונות הווירטואליות שבהן רוצים להשתמש.
- הפרמטרים Parallelism ו-Batch count הם חלק מהתבנית של Pub/Sub ל-Splunk Dataflow. הפרמטרים האלה חשובים להגדלת ה-EPS, תוך הימנעות מעומס יתר על נקודת הקצה של Splunk HEC.
בקטעים הבאים מוסבר על ההגדרות האלה. במקרים הרלוונטיים, בקטעים האלה מופיעות גם נוסחאות ודוגמאות לחישובים שמשתמשים בכל נוסחה. בדוגמאות הבאות לחישובים ולערכים שמתקבלים, אנחנו מניחים שמדובר בארגון עם המאפיינים הבאים:
- יוצרת 1TB של יומנים ביום.
- גודל ההודעה הממוצע הוא 1KB.
- שיעור ההודעות המקסימלי שלו גבוה פי שניים מהשיעור הממוצע.
סביבת Dataflow שלכם היא ייחודית, לכן כשאתם מבצעים את השלבים, החליפו את ערכי הדוגמה בערכים מהארגון שלכם.
סוג המכונה
שיטה מומלצת: מגדירים את הדגל --worker-machine-type לערך n2-standard-4 כדי לבחור גודל מכונה שמספק את היחס הטוב ביותר בין ביצועים לעלות.
מכיוון שסוג המכונה n2-standard-4 יכול לטפל ב-12,000 אירועים לשנייה, מומלץ להשתמש בסוג המכונה הזה כבסיס לכל ה-workers של Dataflow.
בדוגמה הזו לארכיטקטורה, מגדירים את הערך של הדגל --worker-machine-type ל-n2-standard-4.
מספר המכונות
שיטה מומלצת: מגדירים את הדגל --max-workers כדי לשלוט במספר המקסימלי של ה-workers שנדרשים לטיפול בשיא הצפוי של אירועים לשנייה.
התאמה אוטומטית לעומס ב-Dataflow מאפשרת לשירות לשנות באופן דינמי את מספר ה-workers שמשמשים להפעלת פייפליין זורם, כשיש שינויים בעומס ובשימוש במשאבים. כדי להימנע מהקצאת יתר של משאבים במהלך התאמה אוטומטית לעומס (automatic scaling), מומלץ תמיד להגדיר את המספר המקסימלי של מכונות וירטואליות שמשמשות כ-workers של Dataflow. אתם מגדירים את המספר המקסימלי של מכונות וירטואליות באמצעות הדגל --max-workers כשאתם פורסים את צינור עיבוד הנתונים של Dataflow.
כדי להעביר את האחסון של מצב הפייפליין מה-worker VMs ולצמצם את עלויות האחסון, צריך להשתמש במנוע הסטרימינג של Dataflow. כדי להפעיל את מנוע הסטרימינג של Dataflow בפרויקט, מגדירים את הדגל --enableStreamingEngine.
כדי לקבוע את המספר המקסימלי של העובדים שדרושים לצינור, משתמשים בנוסחאות הבאות ברצף:
כדי לחשב את מספר האירועים הממוצע לשנייה (EPS), משתמשים בנוסחה הבאה:
\( {AverageEventsPerSecond}\simeq\frac{TotalDailyLogsInTB}{AverageMessageSizeInKB}\times\frac{10^9}{24\times3600} \)חישוב לדוגמה: בהתאם לערכים לדוגמה של 1TB של יומנים ביום עם גודל הודעה ממוצע של 1KB, הנוסחה הזו יוצרת ערך EPS ממוצע של 11.5k EPS.
כדי לקבוע את ערך ה-EPS המקסימלי המתמשך, משתמשים בנוסחה הבאה, שבה המכפיל N מייצג את אופי הרישום של פרצי נתונים:
\( {PeakEventsPerSecond = N \times\ AverageEventsPerSecond} \)דוגמה לחישוב: אם ערך הדוגמה הוא N=2 והערך הממוצע של EPS הוא 11.5k שחישבתם בשלב הקודם, הנוסחה הזו יוצרת ערך שיא של EPS של 23k.
כדי לקבוע את המספר המקסימלי של מעבדי vCPU שנדרשים, משתמשים בנוסחה הבאה:
\( {maxCPUs = ⌈PeakEventsPerSecond / 3k ⌉} \)חישוב לדוגמה: לפי ערך ה-EPS המקסימלי המתמשך של 23,000 שחישבתם בשלב הקודם, הנוסחה הזו יוצרת מקסימום של ⌈23 / 3⌉ = 8 ליבות vCPU.
כדי לקבוע את המספר המקסימלי של ה-workers ב-Dataflow, משתמשים בנוסחה הבאה:
\( maxNumWorkers = ⌈maxCPUs / 4 ⌉ \)דוגמה לחישוב: אם ערך ה-vCPU המקסימלי הוא 8, כמו בדוגמה שחישבנו בשלב הקודם, הנוסחה [8/4] מחזירה את המספר המקסימלי 2 עבור סוג המכונה
n2-standard-4.
בדוגמה הזו, צריך להגדיר את הדגל --max-workers לערך 2 על סמך קבוצת החישובים הקודמת לדוגמה. עם זאת, חשוב להשתמש בערכים ובחישובים הייחודיים שלכם כשאתם פורסים את ארכיטקטורת העזר הזו בסביבה שלכם.
מקביליות
שיטה מומלצת: הגדירו את הפרמטר parallelism בתבנית Pub/Sub to Splunk Dataflow למספר כפול ממספר ה-vCPUs שמשמשים את המספר המקסימלי של ה-workers ב-Dataflow.
הפרמטר parallelism עוזר למקסם את מספר החיבורים המקבילים ל-Splunk HEC, וכך למקסם את קצב ה-EPS של צינור עיבוד הנתונים.
ערך ברירת המחדל של parallelism הוא 1, שמשבית את המקביליות ומגביל את קצב הפלט. כדי להביא בחשבון 2 עד 4 חיבורים מקבילים לכל vCPU, עם המספר המקסימלי של עובדים שנפרסו, צריך לבטל את הגדרת ברירת המחדל הזו. ככלל, כדי לחשב את ערך ברירת המחדל של ההגדרה הזו, מכפילים את המספר המקסימלי של עובדי Dataflow במספר המעבדים הווירטואליים לכל עובד, ואז מכפילים את הערך הזה ב-2.
כדי לקבוע את המספר הכולל של חיבורים מקבילים ל-Splunk HEC בכל ה-workers של Dataflow, משתמשים בנוסחה הבאה:
דוגמה לחישוב: אם נשתמש בדוגמה הקודמת של 8 מעבדי vCPU מקסימליים שחושבו למספר המכונות, הנוסחה הזו תפיק את מספר החיבורים המקבילים: 8 כפול 2 = 16.
בדוגמה הזו, מגדירים את הפרמטר parallelism לערך 16 על סמך החישוב בדוגמה הקודמת. עם זאת, חשוב לזכור להשתמש בערכים ובחישובים הייחודיים שלכם כשמטמיעים את ארכיטקטורת ההפניה הזו בסביבה שלכם.
מספר הבקשות באצווה
שיטה מומלצת: כדי לאפשר ל-Splunk HEC לעבד אירועים בקבוצות במקום אחד בכל פעם, מגדירים את הפרמטר batchCount לערך שבין 10 ל-50 אירועים/בקשה ליומנים.
הגדרת מספר האצווה עוזרת להגדיל את ה-EPS ולהפחית את העומס על נקודת הקצה של Splunk HEC. ההגדרה משלבת כמה אירועים לחבילה אחת כדי לייעל את העיבוד. מומלץ להגדיר את הפרמטר batchCount לערך שבין 10 ל-50 אירועים/בקשות ליומנים, בתנאי שעיכוב אגירה מקסימלי של שתי שניות הוא קביל.
בדוגמה הזו, הגודל הממוצע של הודעת יומן הוא 1KB, ולכן מומלץ לאסוף לפחות 10 אירועים בכל בקשה. בדוגמה הזו, צריך להגדיר את הפרמטר batchCount לערך 10. עם זאת, חשוב לזכור להשתמש בערכים ובחישובים הייחודיים שלכם כשמטמיעים את ארכיטקטורת ההפניה הזו בסביבה שלכם.
למידע נוסף על ההמלצות האלה לאופטימיזציה של ביצועים ועלויות, קראו את המאמר תכנון צינור עיבוד הנתונים ב-Dataflow.
המאמרים הבאים
- רשימה מלאה של פרמטרים של תבנית Pub/Sub ל-Splunk Dataflow זמינה במסמכי התיעוד של Pub/Sub ל-Splunk Dataflow.
- במאגר
terraform-splunk-log-exportב-GitHub תוכלו למצוא את התבניות התואמות של Terraform שיעזרו לכם לפרוס את ארכיטקטורת העזר הזו. הוא כולל לוח בקרה מוכן מראש של Cloud Monitoring למעקב אחרי צינור עיבוד הנתונים של Splunk Dataflow. - לפרטים נוספים על מדדים מותאמים אישית ורישום ביומן של Splunk Dataflow שיעזרו לכם לעקוב אחרי פייפליינים זורמים של Splunk Dataflow ולפתור בהם בעיות, עיינו בפוסט בבלוג New observability features for your Splunk Dataflow streaming pipelines.
- לדוגמאות נוספות של ארכיטקטורות, תרשימים ושיטות מומלצות, עיינו במאמר Cloud Architecture Center.