


In diesem Dokument wird beschrieben, wie Sie die JupyterLab-Erweiterung auf einem Computer oder einer selbstverwalteten VM mit Zugriff auf Google-Dienste installieren und verwenden. Außerdem wird beschrieben, wie Sie serverlosen Spark-Notebook-Code entwickeln und bereitstellen.
Installieren Sie die Erweiterung innerhalb weniger Minuten, um die folgenden Funktionen zu nutzen:
- Serverlose Spark- und BigQuery-Notebooks starten, um Code schnell zu entwickeln
- BigQuery-Datasets in JupyterLab ansehen und in der Vorschau anzeigen
- Cloud Storage-Dateien in JupyterLab bearbeiten
- Notebook in Composer planen
Google Cloud Data Agent Kit verwenden: Neben JupyterLab können Sie Ihre Managed Service for Apache Spark-Arbeitslasten auch in VS Code mit dem Data Agent Kit entwickeln und verwalten. Mit dem Data Agent Kit können Sie den gesamten Lebenszyklus Ihrer Datenarbeitslasten in Ihrer IDE oder mit einer unterstützten agentischen Befehlszeile verwalten, einschließlich des Erstellens von Datenpipelines.
Hinweis
- Melden Sie sich in Ihrem Google Cloud -Konto an. Wenn Sie mit Google Cloudnoch nicht vertraut sind, erstellen Sie einfach ein Konto, um die Leistungsfähigkeit unserer Produkte in der Praxis sehen und bewerten zu können. Neukunden erhalten außerdem ein Guthaben von 300 $, um Arbeitslasten auszuführen, zu testen und bereitzustellen.
-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that you have the permissions required to complete this guide.
-
Verify that billing is enabled for your Google Cloud project.
Enable the Dataproc API, if it is not already enabled.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.-
Install the Google Cloud CLI.
-
If you're using an external identity provider (IdP), you must first sign in to the gcloud CLI with your federated identity.
-
To initialize the gcloud CLI, run the following command:
gcloud init -
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that you have the permissions required to complete this guide.
-
Verify that billing is enabled for your Google Cloud project.
Enable the Dataproc API, if it is not already enabled.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.-
Install the Google Cloud CLI.
-
If you're using an external identity provider (IdP), you must first sign in to the gcloud CLI with your federated identity.
-
To initialize the gcloud CLI, run the following command:
gcloud init
Erforderliche Rollen
Bestimmte IAM-Rollen sind erforderlich, um die Beispiele auf dieser Seite auszuführen. Je nach Organisationsrichtlinien wurden diese Rollen möglicherweise bereits gewährt. Informationen zum Prüfen von Rollenzuweisungen finden Sie unter Müssen Sie Rollen zuweisen?.
Weitere Informationen zum Zuweisen von Rollen finden Sie unter Zugriff auf Projekte, Ordner und Organisationen verwalten.
Nutzerrollen
Bitten Sie Ihren Administrator, Ihnen die folgenden IAM-Rollen zuzuweisen, um die Berechtigungen zu erhalten, die Sie zum Erstellen einer interaktiven Notebook-Sitzung benötigen:
- Dataproc-Bearbeiter (
roles/dataproc.editor) für das Projekt - Dienstkontonutzer (
roles/iam.serviceAccountUser) für das Compute Engine-Standarddienstkonto
Dienstkontorolle
Bitten Sie Ihren Administrator, dem Compute Engine-Standarddienstkonto die IAM-Rolle Dataproc-Worker (roles/dataproc.worker) für das Projekt zuzuweisen, damit das Compute Engine-Standarddienstkonto die erforderlichen Berechtigungen zum Erstellen einer interaktiven Sitzung hat.
JupyterLab-Erweiterung installieren
Sie können die JupyterLab-Erweiterung auf einem Computer oder einer VM installieren und verwenden, die Zugriff auf Google-Dienste hat, z. B. auf Ihrem lokalen Computer oder einer Compute Engine-VM-Instanz.
So installieren Sie die Erweiterung:
Laden Sie Python 3.11 oder höher von
python.org/downloadsherunter und installieren Sie es.- Prüfen Sie die Python 3.11+-Installation.
python3 --version
- Prüfen Sie die Python 3.11+-Installation.
Virtualisieren Sie die Python-Umgebung.
pip3 install pipenv
- Erstellen Sie einen Installationsordner.
mkdir jupyter
- Wechseln Sie in den Installationsordner.
cd jupyter
- Erstellen Sie eine virtuelle Umgebung.
pipenv shell
- Erstellen Sie einen Installationsordner.
Installieren Sie JupyterLab in der virtuellen Umgebung.
pipenv install jupyterlab
Installieren Sie die JupyterLab-Erweiterung.
pipenv install bigquery-jupyter-plugin
jupyter lab
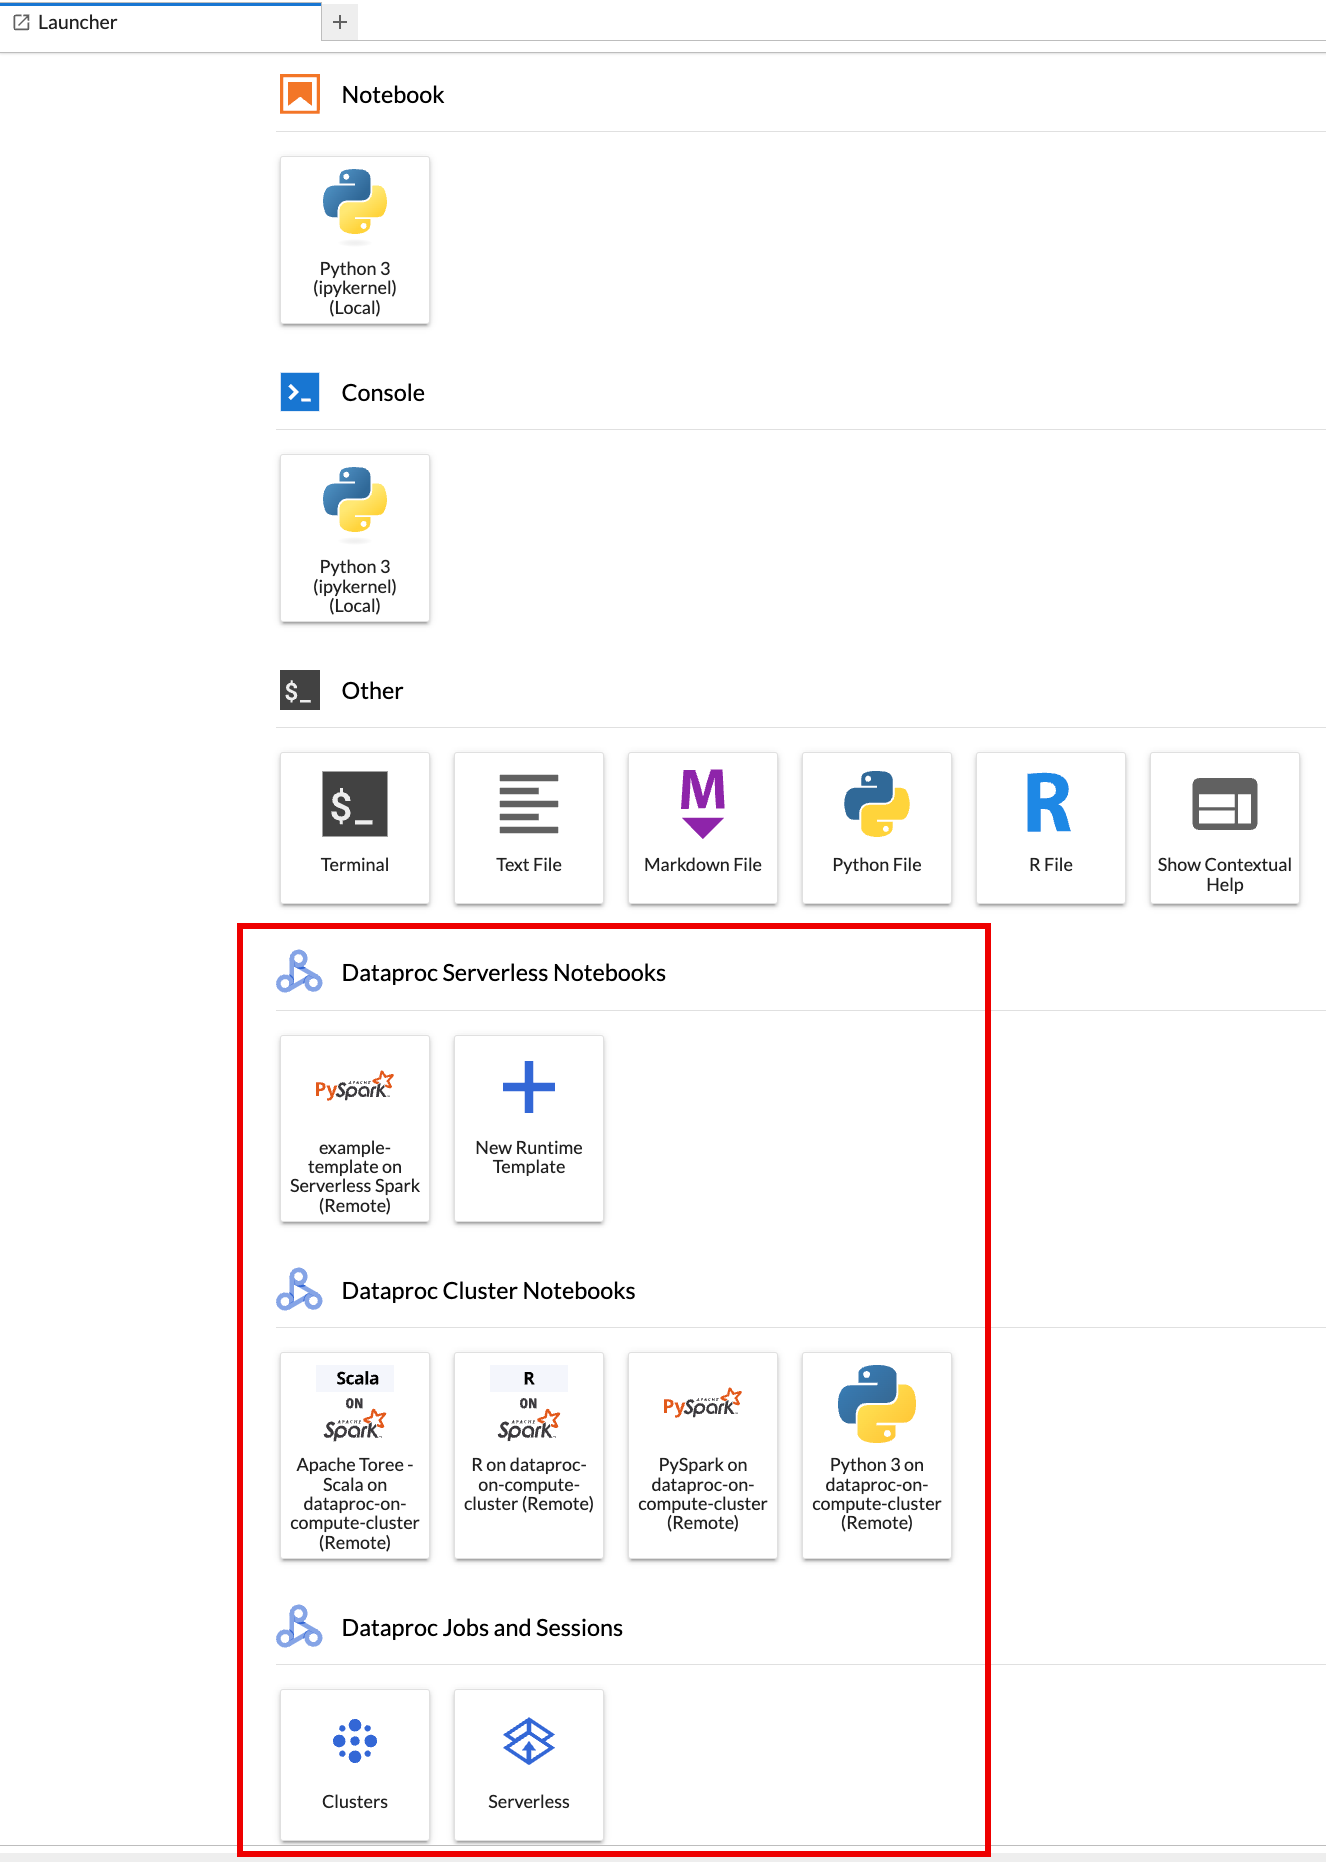
Die JupyterLab-Launcher-Seite wird in Ihrem Browser geöffnet. Er enthält den Abschnitt Dataproc-Jobs und -Sitzungen. Er kann auch die Abschnitte Dataproc Serverless Notebooks und Dataproc Cluster Notebooks enthalten, wenn Sie Zugriff auf Managed Service for Apache Spark-Notebooks oder -Cluster mit der optionalen Jupyter-Komponente haben, die in Ihrem Projekt ausgeführt wird.
Standardmäßig wird Ihre interaktive Sitzung in dem Projekt und in der Region ausgeführt, die Sie beim Ausführen von
gcloud initunter Vorbereitung festgelegt haben. Sie können die Projekt- und Regionseinstellungen für Ihre Sitzungen in JupyterLab unter Einstellungen > Google Cloud Einstellungen > Google Cloud Projekteinstellungen ändern.Sie müssen die Erweiterung neu starten, damit die Änderungen wirksam werden.
Managed Service for Apache Spark-Laufzeitvorlage erstellen
Laufzeitvorlagen für Managed Service for Apache Spark (auf der Seite Laufzeitprofile in derGoogle Cloud Console als Laufzeitprofile und in der Google Cloud CLI und der Dataproc API als Sitzungsvorlagen bezeichnet) enthalten Konfigurationseinstellungen für die Ausführung von Spark-Code in einer Sitzung. Sie können Laufzeitvorlagen mit JupyterLab, der Google Cloud Console oder der Google Cloud CLI erstellen und verwalten.
JupyterLab
Klicken Sie auf der JupyterLab-Seite Launcher im Abschnitt Dataproc Serverless Notebooks auf die Karte
New runtime template.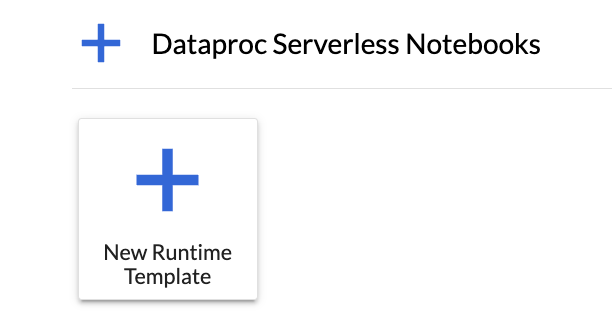
Füllen Sie das Formular Laufzeitvorlage aus.
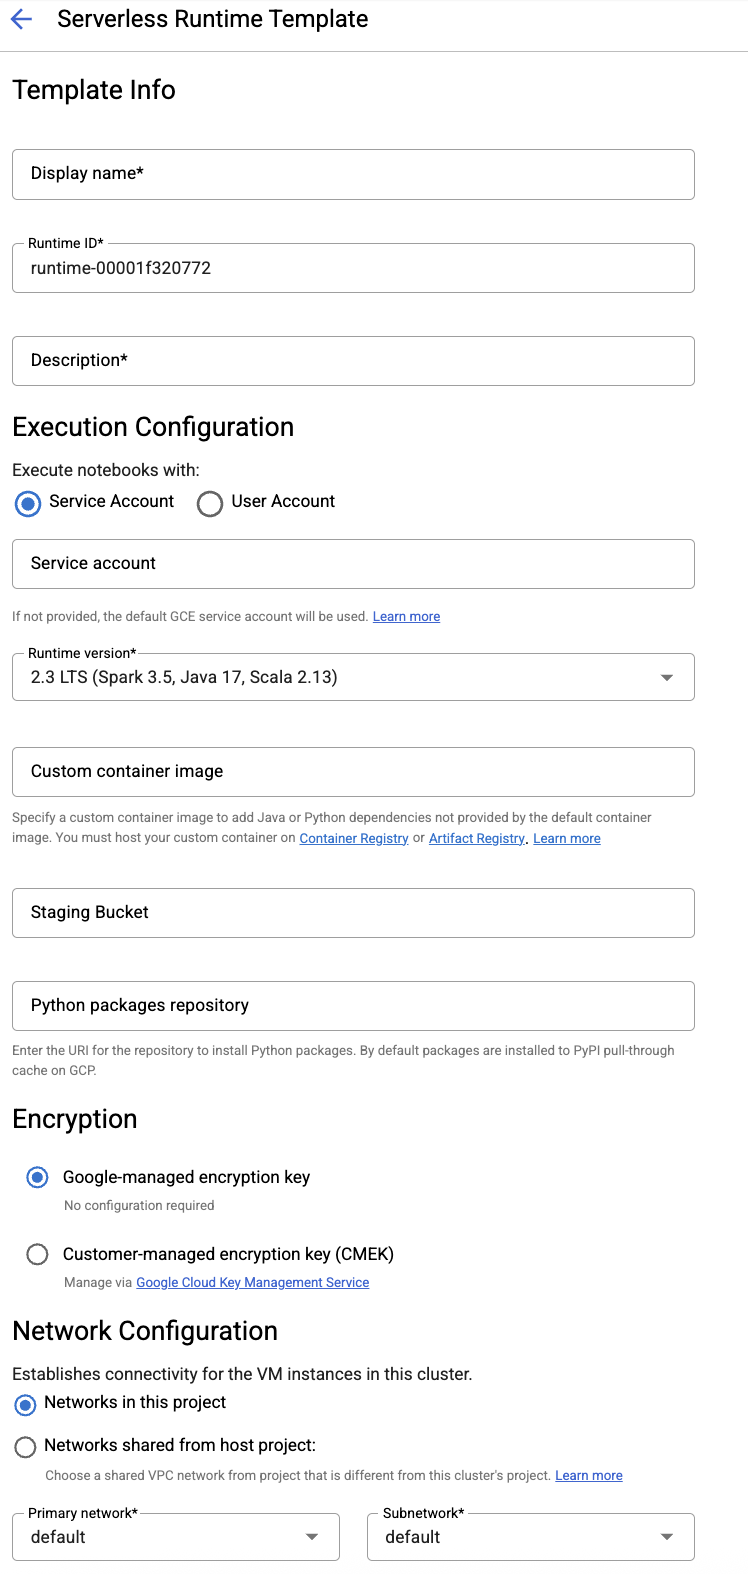
Vorlageninformationen:
- Anzeigename, Laufzeit-ID und Beschreibung: Akzeptieren oder füllen Sie einen Anzeigenamen, eine Laufzeit-ID und eine Beschreibung für die Vorlage aus.
Ausführungskonfiguration: Wählen Sie Nutzerkonto aus, um Notebooks mit der Nutzeridentität anstelle der Dataproc-Dienstkontoidentität auszuführen.
- Dienstkonto: Wenn Sie kein Dienstkonto angeben, wird das Compute Engine-Standarddienstkonto verwendet.
- Laufzeitversion: Bestätigen oder wählen Sie die
2.3-Laufzeitversion aus. - Benutzerdefiniertes Container-Image: Geben Sie optional den URI eines benutzerdefinierten Container-Images an.
- Staging-Bucket: Sie können optional den Namen eines Cloud Storage-Staging-Buckets angeben, der von Managed Service for Apache Spark verwendet werden soll.
- Python-Paket-Repository: Standardmäßig werden Python-Pakete aus dem PyPI-Pull-Through-Cache heruntergeladen und installiert, wenn Nutzer
pip-Installationsbefehle in ihren Notebooks ausführen. Sie können das private Artefakt-Repository Ihrer Organisation für Python-Pakete als Standard-Repository für Python-Pakete angeben.
Verschlüsselung: Übernehmen Sie die Standardeinstellung Google-owned and Google-managed encryption key oder wählen Sie kundenverwalteter Verschlüsselungsschlüssel (CMEK) aus. Wenn Sie CMEK verwenden, wählen Sie die Schlüsselinformationen aus oder geben Sie sie an.
Netzwerkkonfiguration: Wählen Sie ein Subnetzwerk im Projekt aus oder ein Subnetzwerk, das von einem Hostprojekt freigegeben wurde. Sie können das Projekt in JupyterLab unter Einstellungen > Google Cloud Einstellungen > Google Cloud Projekteinstellungen ändern. Sie können Netzwerk-Tags angeben, die auf das angegebene Netzwerk angewendet werden sollen. Beachten Sie, dass Managed Service for Apache Spark den privaten Google-Zugriff (PGA) im angegebenen Subnetz aktiviert. Informationen zu den Anforderungen an die Netzwerkverbindung finden Sie unter Netzwerkkonfiguration für Managed Service for Apache Spark.
Sitzungskonfiguration: Sie können diese Felder optional ausfüllen, um die Dauer der mit der Vorlage erstellten Sitzungen zu begrenzen.
- Maximale Inaktivitätszeit: Die maximale Inaktivitätszeit, bevor die Sitzung beendet wird. Zulässiger Bereich: 10 Minuten bis 336 Stunden (14 Tage).
- Maximale Sitzungsdauer: Die maximale Lebensdauer einer Sitzung, bevor sie beendet wird. Zulässiger Bereich: 10 Minuten bis 336 Stunden (14 Tage).
Metastore: Wenn Sie einen Dataproc Metastore-Dienst mit Ihren Sitzungen verwenden möchten, wählen Sie die Metastore-Projekt-ID und den Dienst aus.
Persistent History Server: Sie können einen verfügbaren Persistent Spark History Server auswählen, um während und nach Sitzungen auf Sitzungslogs zuzugreifen.
Spark-Attribute: Sie können Spark-Attribute für Ressourcenzuweisung, Autoscaling oder GPU auswählen und hinzufügen. Klicken Sie auf Property hinzufügen, um weitere Spark-Properties hinzuzufügen. Weitere Informationen finden Sie unter Spark-Attribute.
Labels: Klicken Sie für jedes Label, das für mit der Vorlage erstellte Sitzungen festgelegt werden soll, auf Label hinzufügen.
Klicken Sie auf Speichern, um die Vorlage zu erstellen.
Zum Aufrufen oder Löschen einer Laufzeitvorlage.
- Klicken Sie auf Einstellungen > Google Cloud Einstellungen.
Im Abschnitt Dataproc-Einstellungen > Serverlose Laufzeitvorlagen wird die Liste der Laufzeitvorlagen angezeigt.
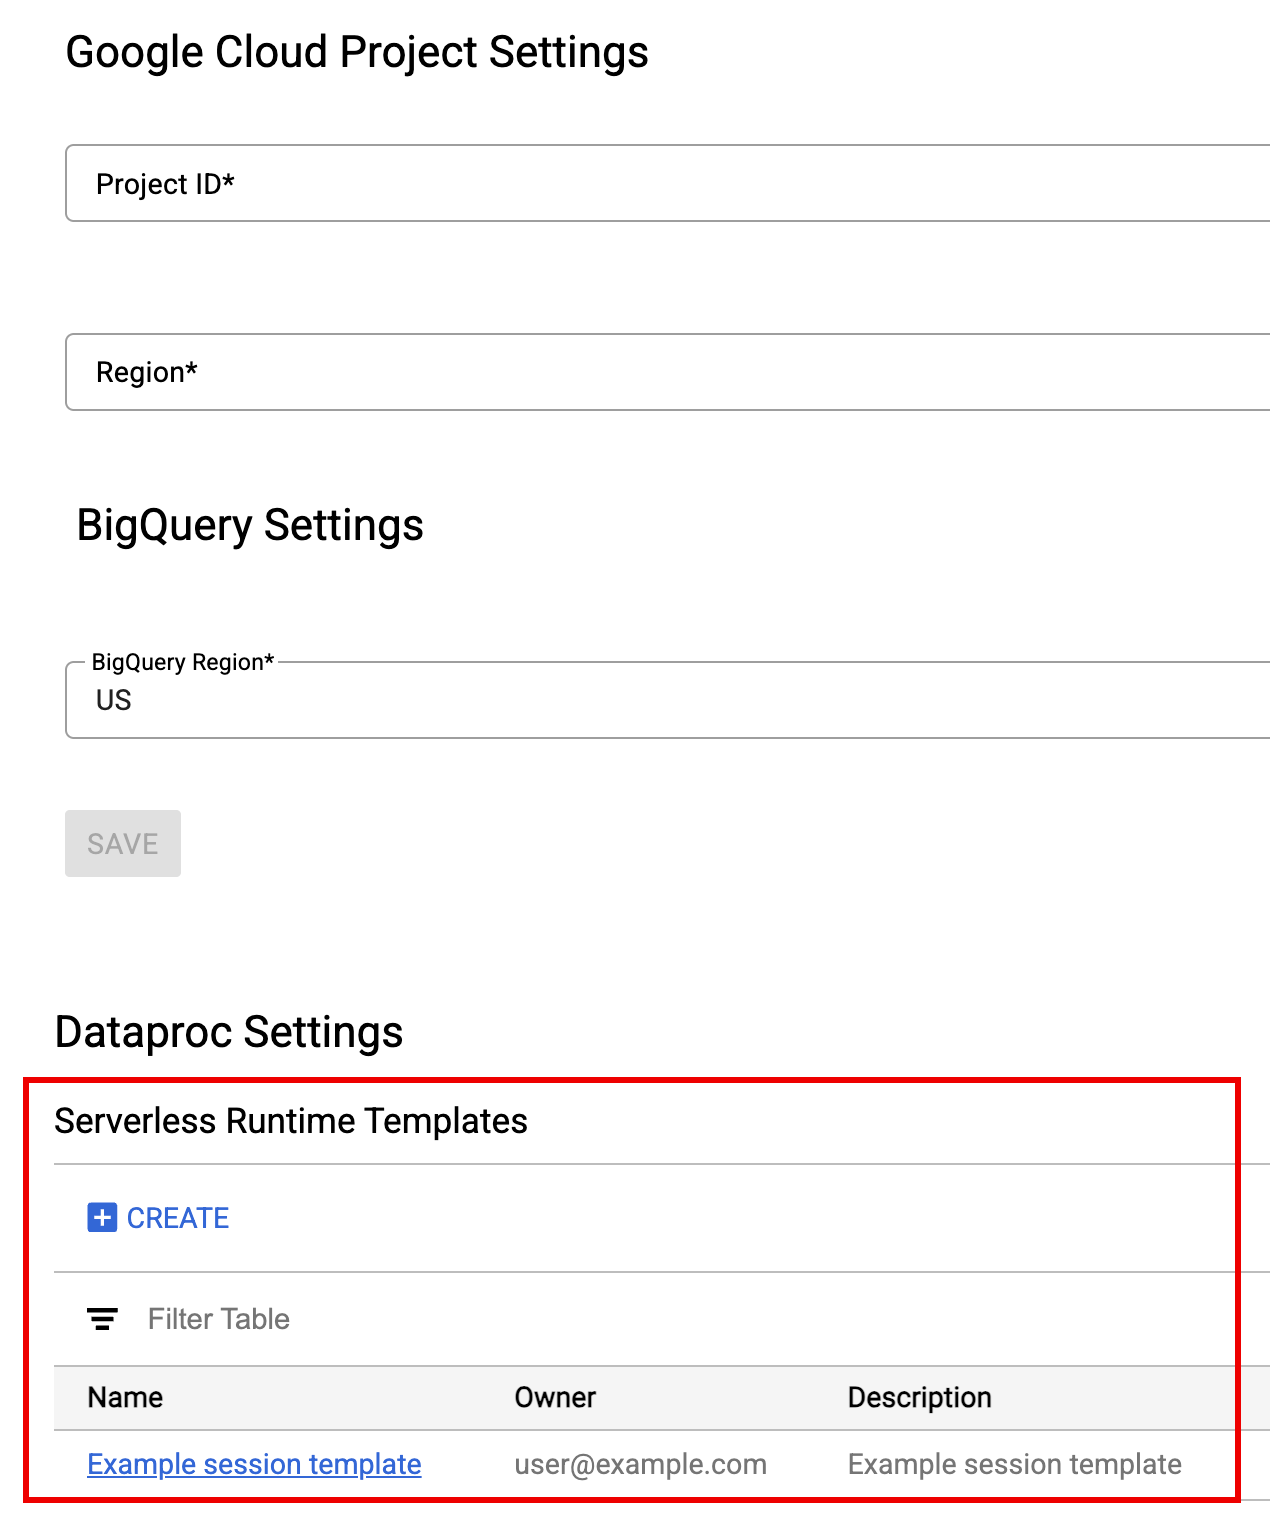
- Klicken Sie auf einen Vorlagennamen, um die Vorlagendetails aufzurufen.
- Sie können eine Vorlage über das Aktionsmenü für die Vorlage löschen.
Öffnen Sie die Seite Launcher von JupyterLab und laden Sie sie neu, um die Karte mit der gespeicherten Notebook-Vorlage auf der Seite Launcher von JupyterLab aufzurufen.
gcloud
Erstellen Sie eine YAML-Datei mit der Konfiguration Ihrer Laufzeitvorlage.
Einfaches YAML
environmentConfig:
  executionConfig:
    networkUri: default
jupyterSession:
  kernel: PYTHON
  displayName: Team A
labels:
  purpose: testing
description: Team A Development Environment
Komplexe YAML-Datei
description: Example session template
environmentConfig:
  executionConfig:
    serviceAccount: sa1
    # Choose either networkUri or subnetworkUri
    networkUri:
    subnetworkUri: default
    networkTags:
     - tag1
    kmsKey: key1
    idleTtl: 3600s
    ttl: 14400s
    stagingBucket: staging-bucket
  peripheralsConfig:
    metastoreService: projects/my-project-id/locations/us-central1/services/my-metastore-id
    sparkHistoryServerConfig:
      dataprocCluster: projects/my-project-id/regions/us-central1/clusters/my-cluster-id
jupyterSession:
  kernel: PYTHON
  displayName: Team A
labels:
  purpose: testing
runtimeConfig:
  version: "2.3"
  containerImage: gcr.io/my-project-id/my-image:1.0.1
  properties:
    "p1": "v1"
description: Team A Development Environment
Erstellen Sie eine Sitzungsvorlage (Laufzeitprofil) aus Ihrer YAML-Datei. Führen Sie dazu den folgenden gcloud beta dataproc session-templates import-Befehl lokal oder in Cloud Shell aus:
gcloud beta dataproc session-templates import TEMPLATE_ID \
    --source=YAML_FILE \
    --project=PROJECT_ID \
    --location=REGION
- Unter gcloud beta dataproc session-templates finden Sie Befehle zum Beschreiben, Auflisten, Exportieren und Löschen von Sitzungsvorlagen (Laufzeitprofilen).
Notebooks starten und verwalten
Nachdem Sie die Managed Service for Apache Spark JupyterLab-Erweiterung installiert haben, können Sie auf der JupyterLab-Seite Launcher auf Vorlagenkarten klicken, um Folgendes zu tun:
Jupyter-Notebook starten
Im Abschnitt Dataproc Serverless Notebooks auf der JupyterLab Launcher-Seite werden Notebook-Vorlagenkarten angezeigt, die Managed Service for Apache Spark-Laufzeitvorlagen zugeordnet sind (siehe Managed Service for Apache Spark-Laufzeitvorlage erstellen).
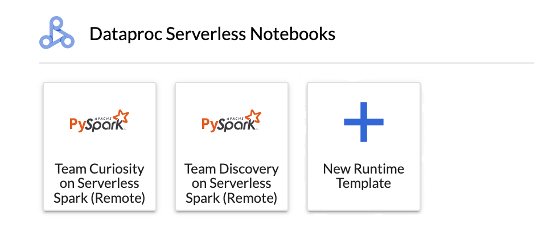
Klicken Sie auf eine Karte, um eine Managed Service for Apache Spark-Sitzung zu erstellen und ein Notebook zu starten. Wenn die Sitzung erstellt wurde und der Notebook-Kernel einsatzbereit ist, ändert sich der Kernel-Status von
StartingzuIdle (Ready).Notebook-Code schreiben und testen
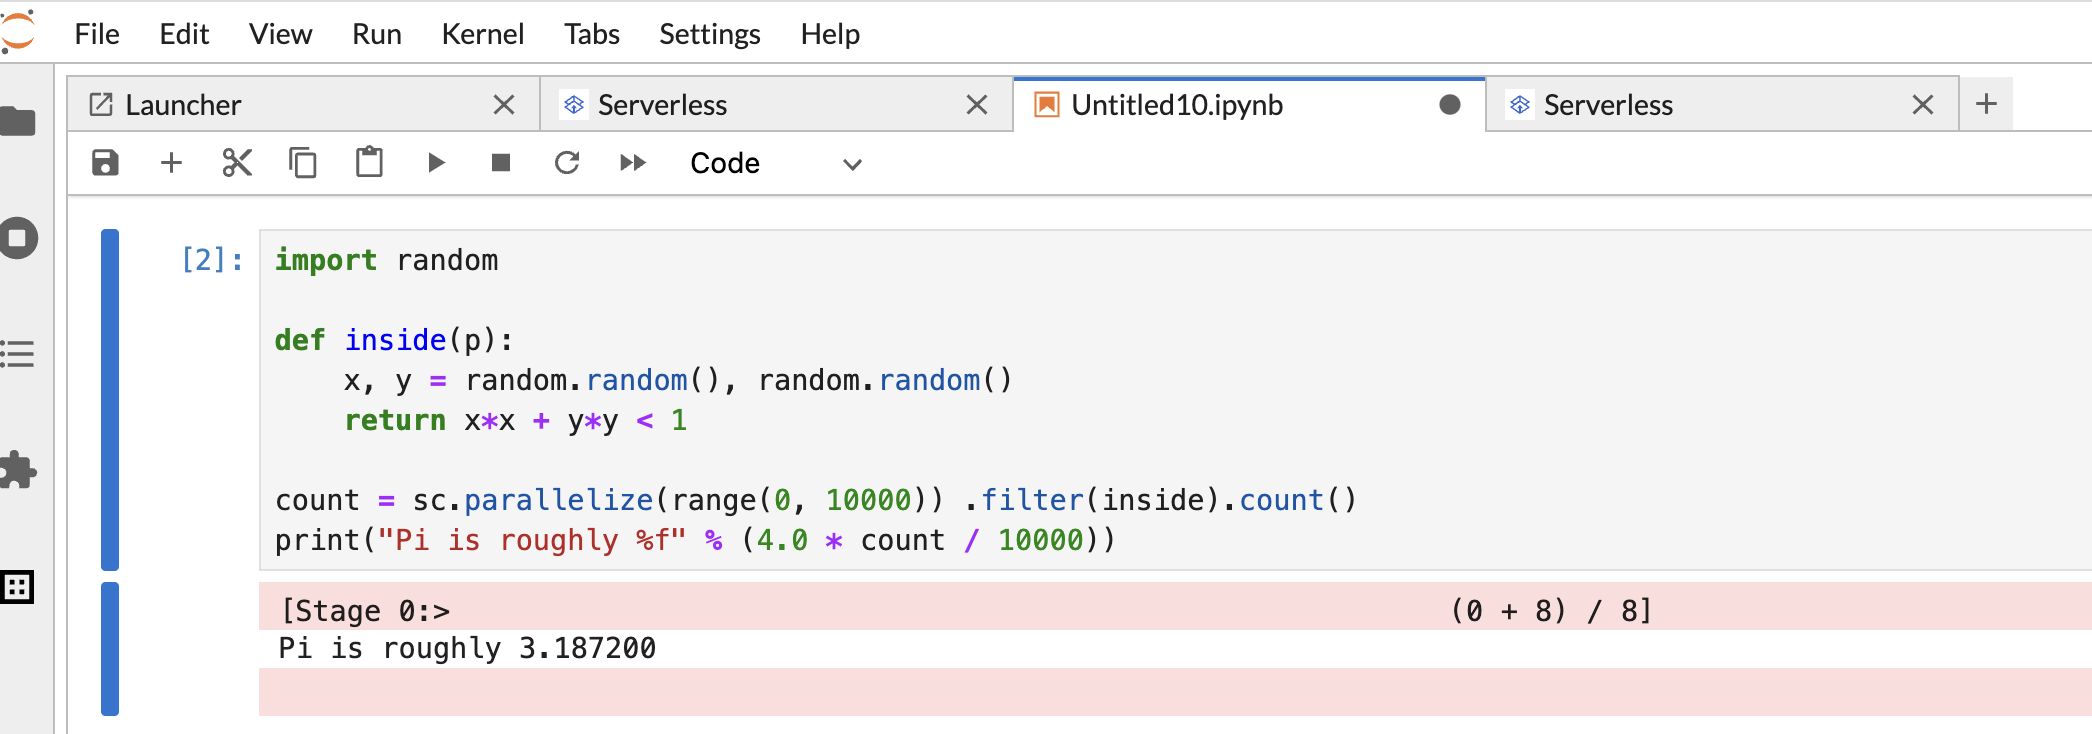
Kopieren Sie den folgenden PySpark-
Pi estimation-Code und fügen Sie ihn in die PySpark-Notebook-Zelle ein. Drücken Sie dann Umschalttaste + Eingabetaste, um den Code auszuführen.import random def inside(p): x, y = random.random(), random.random() return x*x + y*y < 1 count = sc.parallelize(range(0, 10000)) .filter(inside).count() print("Pi is roughly %f" % (4.0 * count / 10000))
Notebook-Ergebnis:
Nachdem Sie ein Notebook erstellt und verwendet haben, können Sie die Notebook-Sitzung beenden, indem Sie auf dem Tab Kernel auf Kernel herunterfahren klicken.
- Wenn Sie die Sitzung wiederverwenden möchten, erstellen Sie ein neues Notebook. Wählen Sie dazu im Menü Datei > Neu die Option Notebook aus. Nachdem das neue Notebook erstellt wurde, wählen Sie die vorhandene Sitzung im Dialogfeld zur Kernelauswahl aus. Im neuen Notebook wird die Sitzung wiederverwendet und der Sitzungskontext aus dem vorherigen Notebook beibehalten.
Wenn Sie die Sitzung nicht beenden, wird sie von Managed Service for Apache Spark beendet, wenn der Timer für die Inaktivität der Sitzung abläuft. Sie können die Leerlaufzeit der Sitzung in der Laufzeitvorlagenkonfiguration konfigurieren. Die Standard-Inaktivitätszeit für Sitzungen beträgt eine Stunde.
Notebook in einem Cluster starten
Wenn Sie einen Managed Service for Apache Spark-Jupyter-Cluster erstellt haben, enthält die JupyterLab-Seite Launcher den Abschnitt Dataproc Cluster Notebook mit vorinstallierten Kernel-Karten.
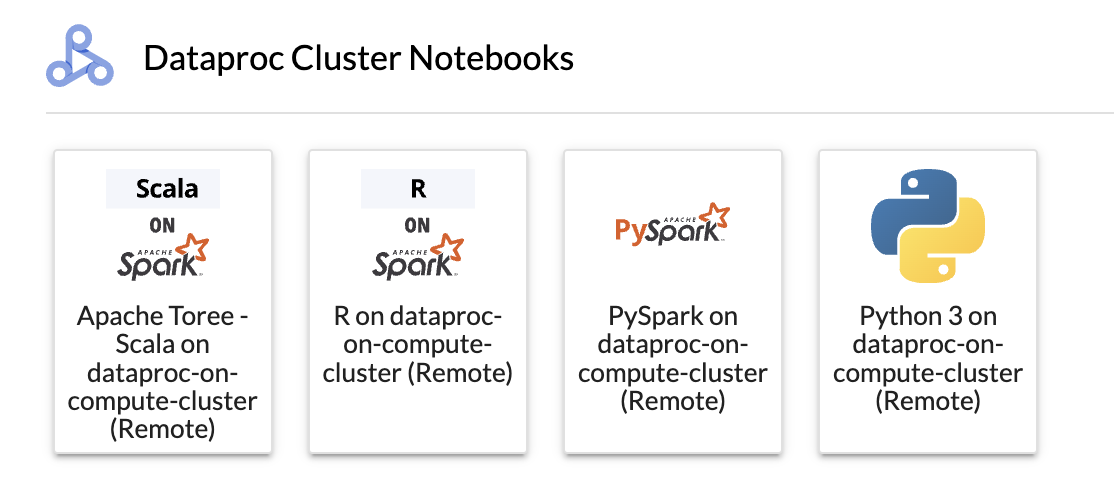
So starten Sie ein Jupyter-Notebook in Ihrem Managed Service for Apache Spark on Compute Engine-Cluster:
Klicken Sie im Abschnitt Dataproc-Cluster-Notebook auf eine Karte.
Wenn sich der Kernelstatus von
StartinginIdle (Ready)ändert, können Sie mit dem Schreiben und Ausführen von Notebook-Code beginnen.Nachdem Sie ein Notebook erstellt und verwendet haben, können Sie die Notebook-Sitzung beenden, indem Sie auf dem Tab Kernel auf Kernel herunterfahren klicken.
Eingabe- und Ausgabedateien in Cloud Storage verwalten
Die Analyse explorativer Daten und die Erstellung von ML-Modellen umfassen häufig dateibasierte Ein- und Ausgaben. Managed Service for Apache Spark greift auf diese Dateien in Cloud Storage zu.
Klicken Sie in der Seitenleiste der JupyterLab-Seite Launcher auf das Cloud Storage-Browsersymbol, um den Cloud Storage-Browser aufzurufen. Doppelklicken Sie dann auf einen Ordner, um dessen Inhalt anzusehen.
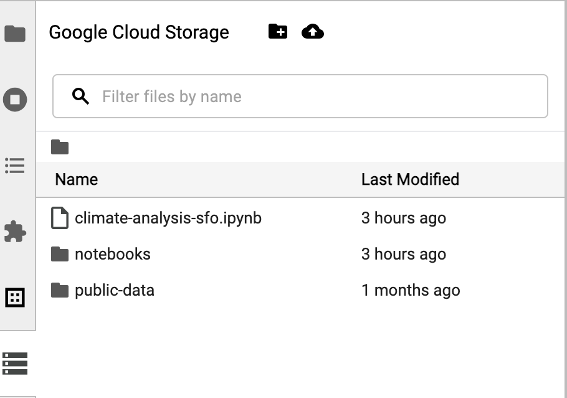
Sie können auf von Jupyter unterstützte Dateitypen klicken, um sie zu öffnen und zu bearbeiten. Wenn Sie Änderungen an den Dateien speichern, werden sie in Cloud Storage geschrieben.
Wenn Sie einen neuen Cloud Storage-Ordner erstellen möchten, klicken Sie auf das Symbol für einen neuen Ordner und geben Sie den Namen des Ordners ein.
Wenn Sie Dateien in einen Cloud Storage-Bucket oder einen Ordner hochladen möchten, klicken Sie auf das Upload-Symbol und wählen Sie die Dateien aus, die Sie hochladen möchten.
Spark-Notebook-Code entwickeln
Nachdem Sie die JupyterLab-Erweiterung installiert haben, können Sie Jupyter-Notebooks über die Launcher-Seite von JupyterLab starten, um Anwendungscode zu entwickeln.
PySpark- und Python-Codeentwicklung
Managed Service for Apache Spark-Cluster unterstützen PySpark- und Python-Kernel.
Klicken Sie auf der JupyterLab-Seite Launcher im Abschnitt Dataproc Serverless Notebooks oder Dataproc Cluster Notebook auf eine PySpark-Karte, um ein PySpark-Notebook zu öffnen.
Klicken Sie auf der JupyterLab-Seite Launcher im Abschnitt Dataproc-Cluster-Notebook auf eine Python-Kernel-Karte, um ein Python-Notebook zu öffnen.
SQL-Code-Entwicklung
Wenn Sie ein PySpark-Notebook zum Schreiben und Ausführen von SQL-Code öffnen möchten, klicken Sie auf der JupyterLab-Seite Launcher im Abschnitt Dataproc Serverless Notebooks oder Dataproc Cluster Notebook auf die PySpark-Kernel-Karte.
Spark SQL Magic: Da der PySpark-Kernel, der serverlose Dataproc-Notebooks startet, mit Spark SQL Magic vorinstalliert ist, können Sie anstelle von spark.sql('SQL STATEMENT').show() zum Verpacken Ihrer SQL-Anweisung %%sparksql magic oben in einer Zelle eingeben und dann Ihre SQL-Anweisung in die Zelle eingeben.
BigQuery SQL: Mit dem BigQuery Spark-Connector kann Ihr Notebook-Code Daten aus BigQuery-Tabellen laden, Analysen in Spark durchführen und die Ergebnisse dann in eine BigQuery-Tabelle schreiben.
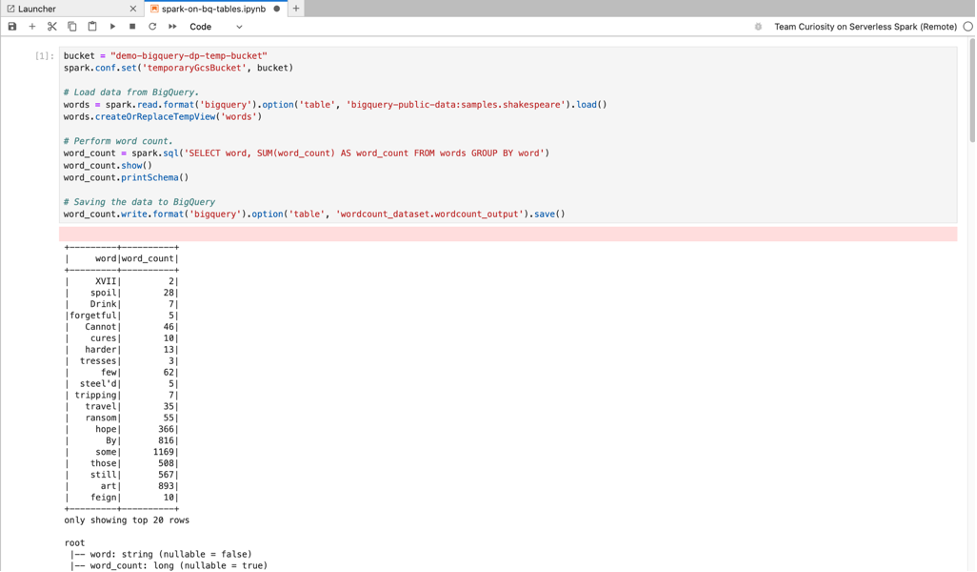
Der Managed Service for Apache Spark 2.2 und spätere Laufzeiten enthalten den BigQuery Spark-Connector.
Wenn Sie eine frühere Laufzeit zum Starten von Managed Service for Apache Spark-Notebooks verwenden, können Sie den Spark BigQuery-Connector installieren, indem Sie die folgende Spark-Property zu Ihrer Managed Service for Apache Spark-Laufzeitvorlage hinzufügen:
spark.jars: gs://spark-lib/bigquery/spark-bigquery-with-dependencies_2.12-0.25.2.jar
Scala-Codeentwicklung
Managed Service for Apache Spark-Cluster, die mit Image-Versionen ab 2.0 erstellt wurden, enthalten Apache Toree, einen Scala-Kernel für die Jupyter Notebook-Plattform, der interaktiven Zugriff auf Spark bietet.
Klicken Sie auf der Seite Launcher von JupyterLab im Abschnitt Dataproc-Cluster-Notebook auf die Karte „Apache Toree“, um ein Notebook für die Scala-Codeentwicklung zu öffnen.
Abbildung 1. Apache Toree-Kernel-Karte auf der JupyterLab-Launcher-Seite.
Code mit der Visual Studio Code-Erweiterung entwickeln
Mit der Google Cloud Visual Studio Code (VS Code)-Erweiterung können Sie Folgendes tun:
Spark-Code in Managed Service for Apache Spark-Notebooks entwickeln und ausführen.
Managed Service for Apache Spark-Laufzeitprofile (Sitzungsvorlagen), interaktive Sitzungen und Batcharbeitslasten erstellen und verwalten.
Die Visual Studio Code-Erweiterung ist kostenlos, aber Ihnen werden alle von Ihnen verwendetenGoogle Cloud -Dienste in Rechnung gestellt, einschließlich Managed Service for Apache Spark, Managed Service for Apache Spark und Cloud Storage-Ressourcen.
VS Code mit BigQuery verwenden: Sie können VS Code auch mit BigQuery verwenden, um Folgendes zu tun:
- BigQuery-Notebooks entwickeln und ausführen
- BigQuery-Datasets durchsuchen, prüfen und in der Vorschau ansehen
Hinweis
- Laden Sie VS Code herunter und installieren Sie es.
- Öffnen Sie VS Code und klicken Sie in der Aktivitätsleiste auf Erweiterungen.
Suchen Sie in der Suchleiste nach der Erweiterung Jupyter und klicken Sie dann auf Installieren. Die Jupyter-Erweiterung von Microsoft ist eine erforderliche Abhängigkeit.
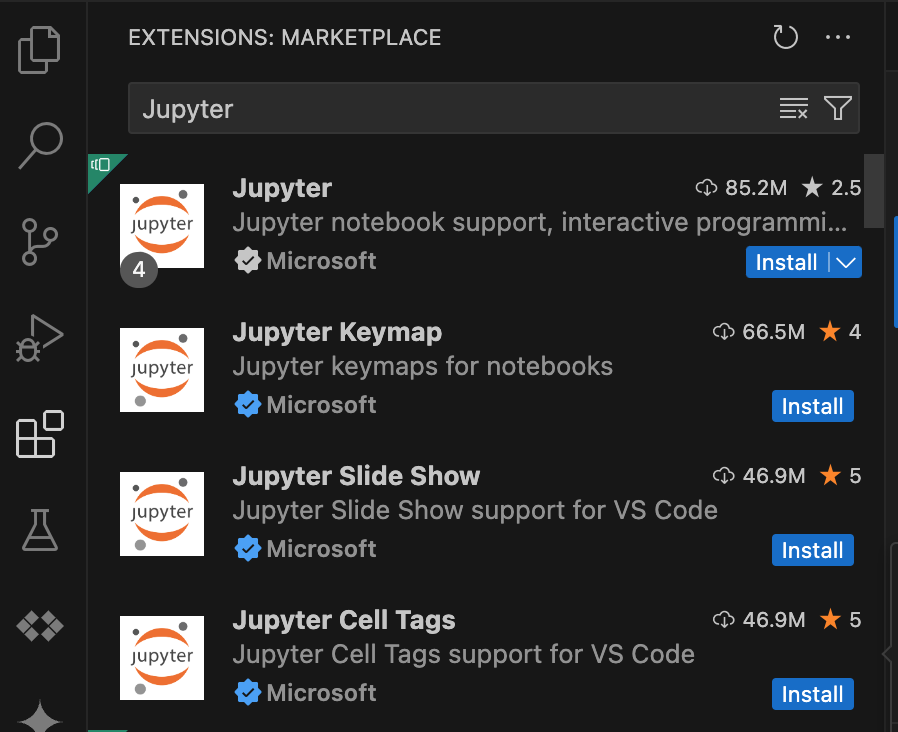
Google Cloud -Erweiterung installieren
- Öffnen Sie VS Code und klicken Sie in der Aktivitätsleiste auf Erweiterungen.
Suchen Sie über die Suchleiste nach der Erweiterung Google Cloud Code und klicken Sie dann auf Installieren.
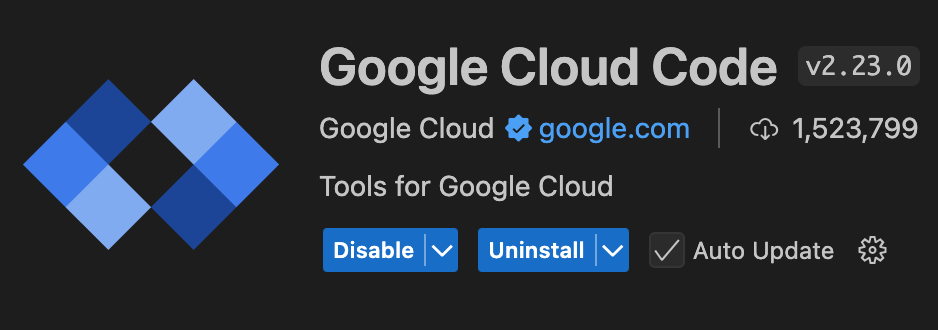
Starten Sie VS Code neu, wenn Sie dazu aufgefordert werden.
Das Symbol Google Cloud Code ist jetzt in der Aktivitätsleiste von VS Code sichtbar.
Erweiterung konfigurieren
- Öffnen Sie VS Code und klicken Sie in der Aktivitätsleiste auf Google Cloud Code.
- Öffnen Sie den Bereich Dataproc.
- Klicken Sie auf Bei Google Cloudanmelden. Sie werden weitergeleitet, um sich mit Ihren Anmeldedaten anzumelden.
- Rufen Sie über die Taskleiste der Anwendung auf oberster Ebene Code > Einstellungen > Einstellungen > Erweiterungen auf.
- Suchen Sie nach Google Cloud Code und klicken Sie auf das Symbol Verwalten, um das Menü zu öffnen.
- Wählen Sie Einstellungen aus.
- Geben Sie in die Felder Projekt und Region für Managed Service for Apache Spark den Namen des Google Cloud -Projekts und die Region ein, die Sie zum Entwickeln von Notebooks und zum Verwalten von Managed Service for Apache Spark-Ressourcen verwenden möchten.
Notebooks entwickeln
- Öffnen Sie VS Code und klicken Sie in der Aktivitätsleiste auf Google Cloud Code.
- Öffnen Sie den Bereich Notebooks und klicken Sie auf Neues serverloses Spark-Notebook.
- Wählen Sie ein neues Laufzeitprofil (Sitzungsvorlage) für die Notebook-Sitzung aus oder erstellen Sie eines.
Eine neue
.ipynb-Datei mit Beispielcode wird erstellt und im Editor geöffnet.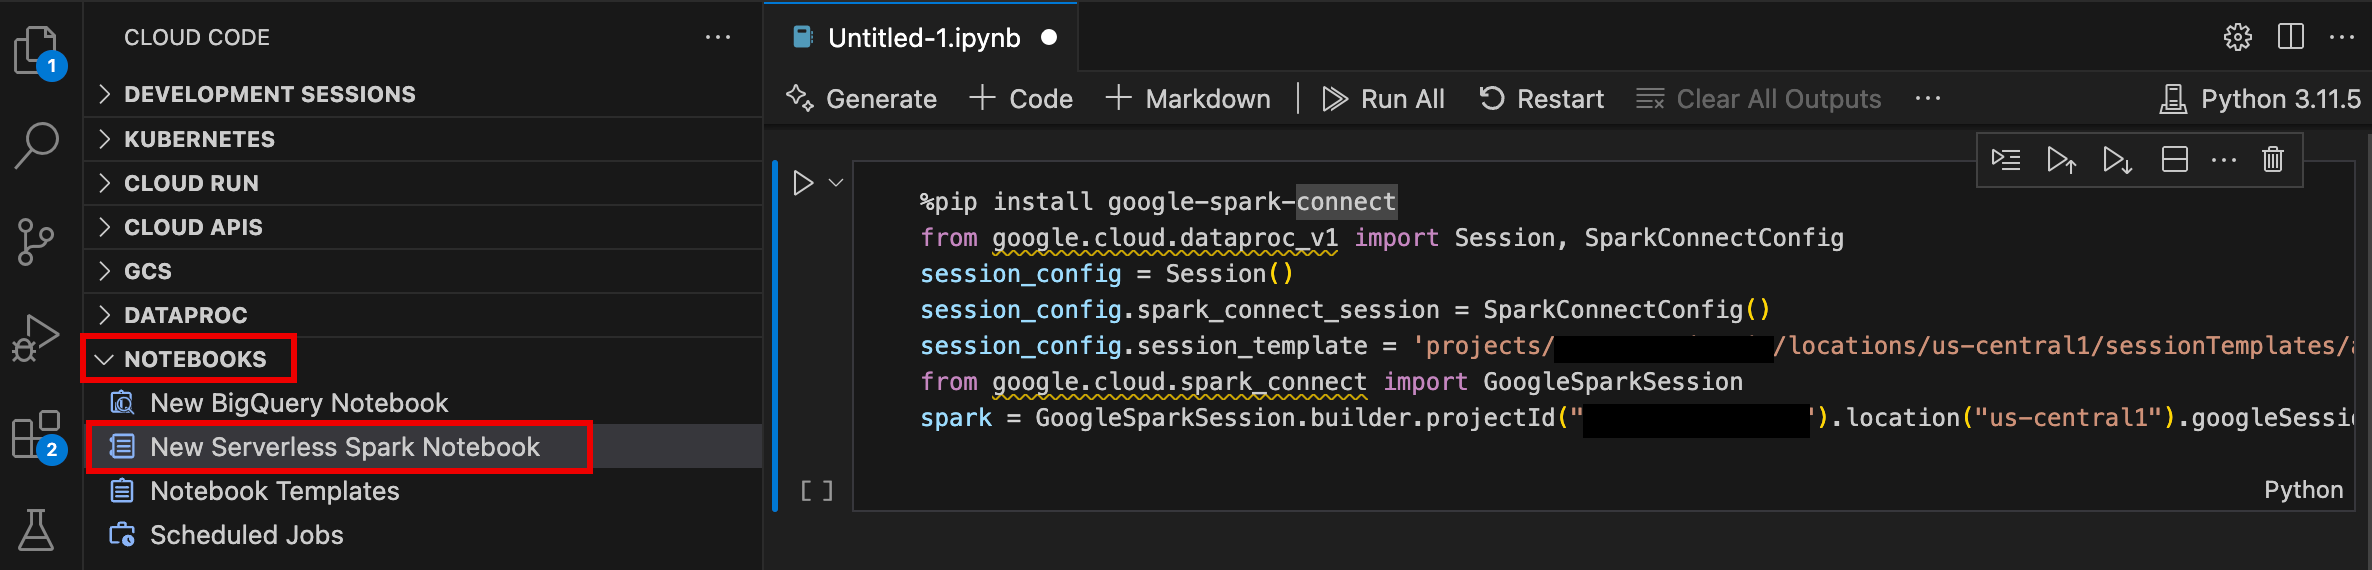
Sie können jetzt Code in Ihrem Managed Service for Apache Spark-Notebook schreiben und ausführen.
Ressourcen erstellen und verwalten
- Öffnen Sie VS Code und klicken Sie in der Aktivitätsleiste auf Google Cloud Code.
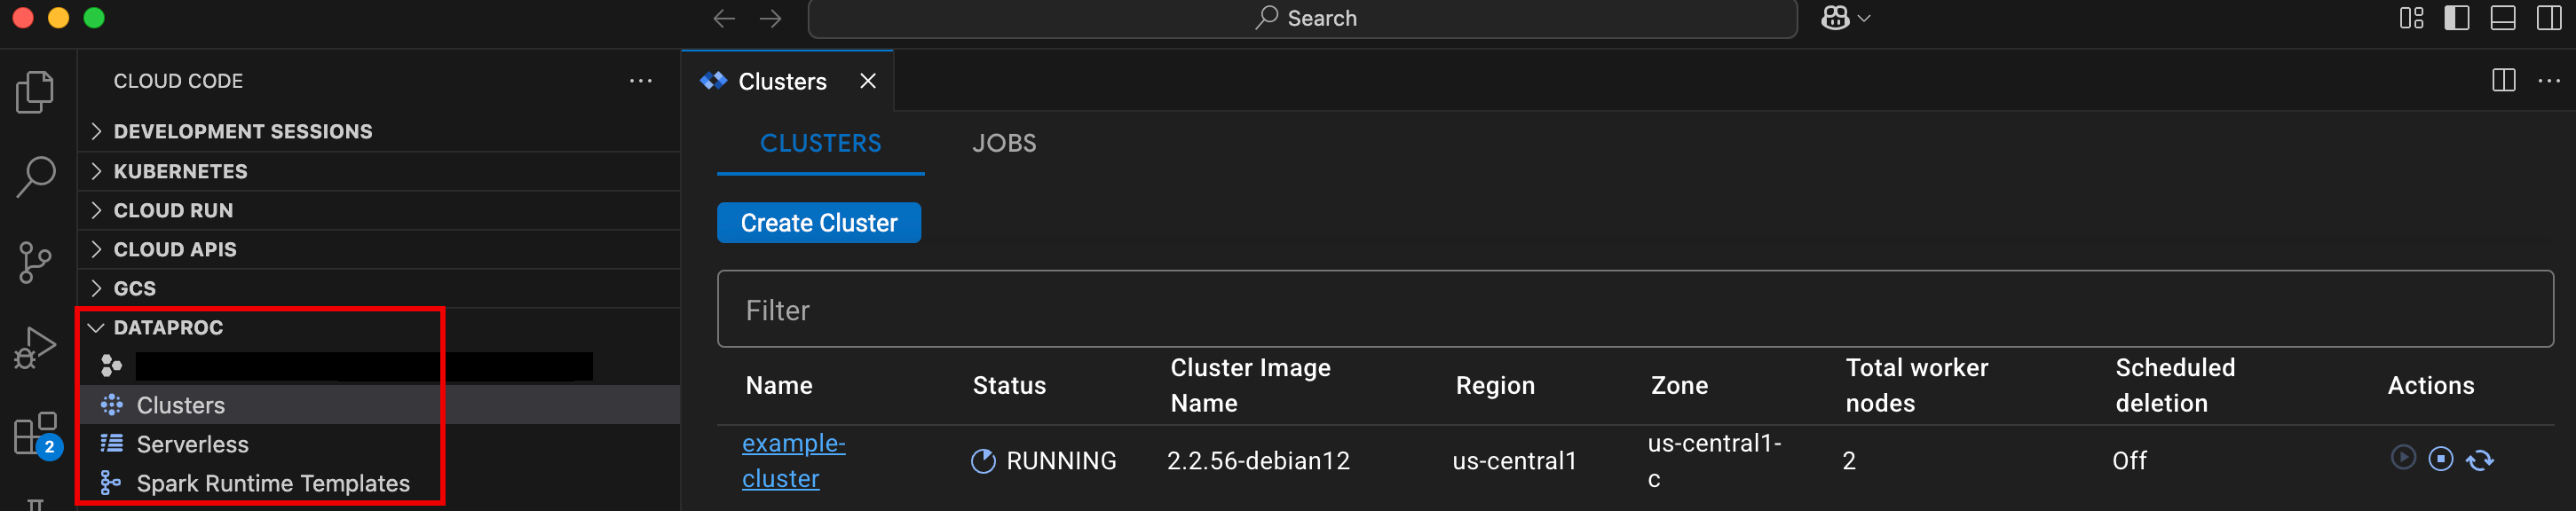
Öffnen Sie den Bereich Dataproc und klicken Sie dann auf die folgenden Ressourcennamen:
Cluster: Cluster und Jobs erstellen und verwalten.
Serverlos: Batcharbeitslasten und interaktive Sitzungen erstellen und verwalten.
Spark-Laufzeitvorlagen: Laufzeitprofile (Sitzungsvorlagen) erstellen und verwalten.
Dataset-Explorer
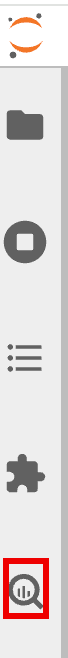
Verwenden Sie den JupyterLab-Dataset-Explorer, um BigLake Metastore-Datasets anzusehen.
Klicken Sie in der Seitenleiste auf das Symbol für den JupyterLab Dataset Explorer, um ihn zu öffnen.
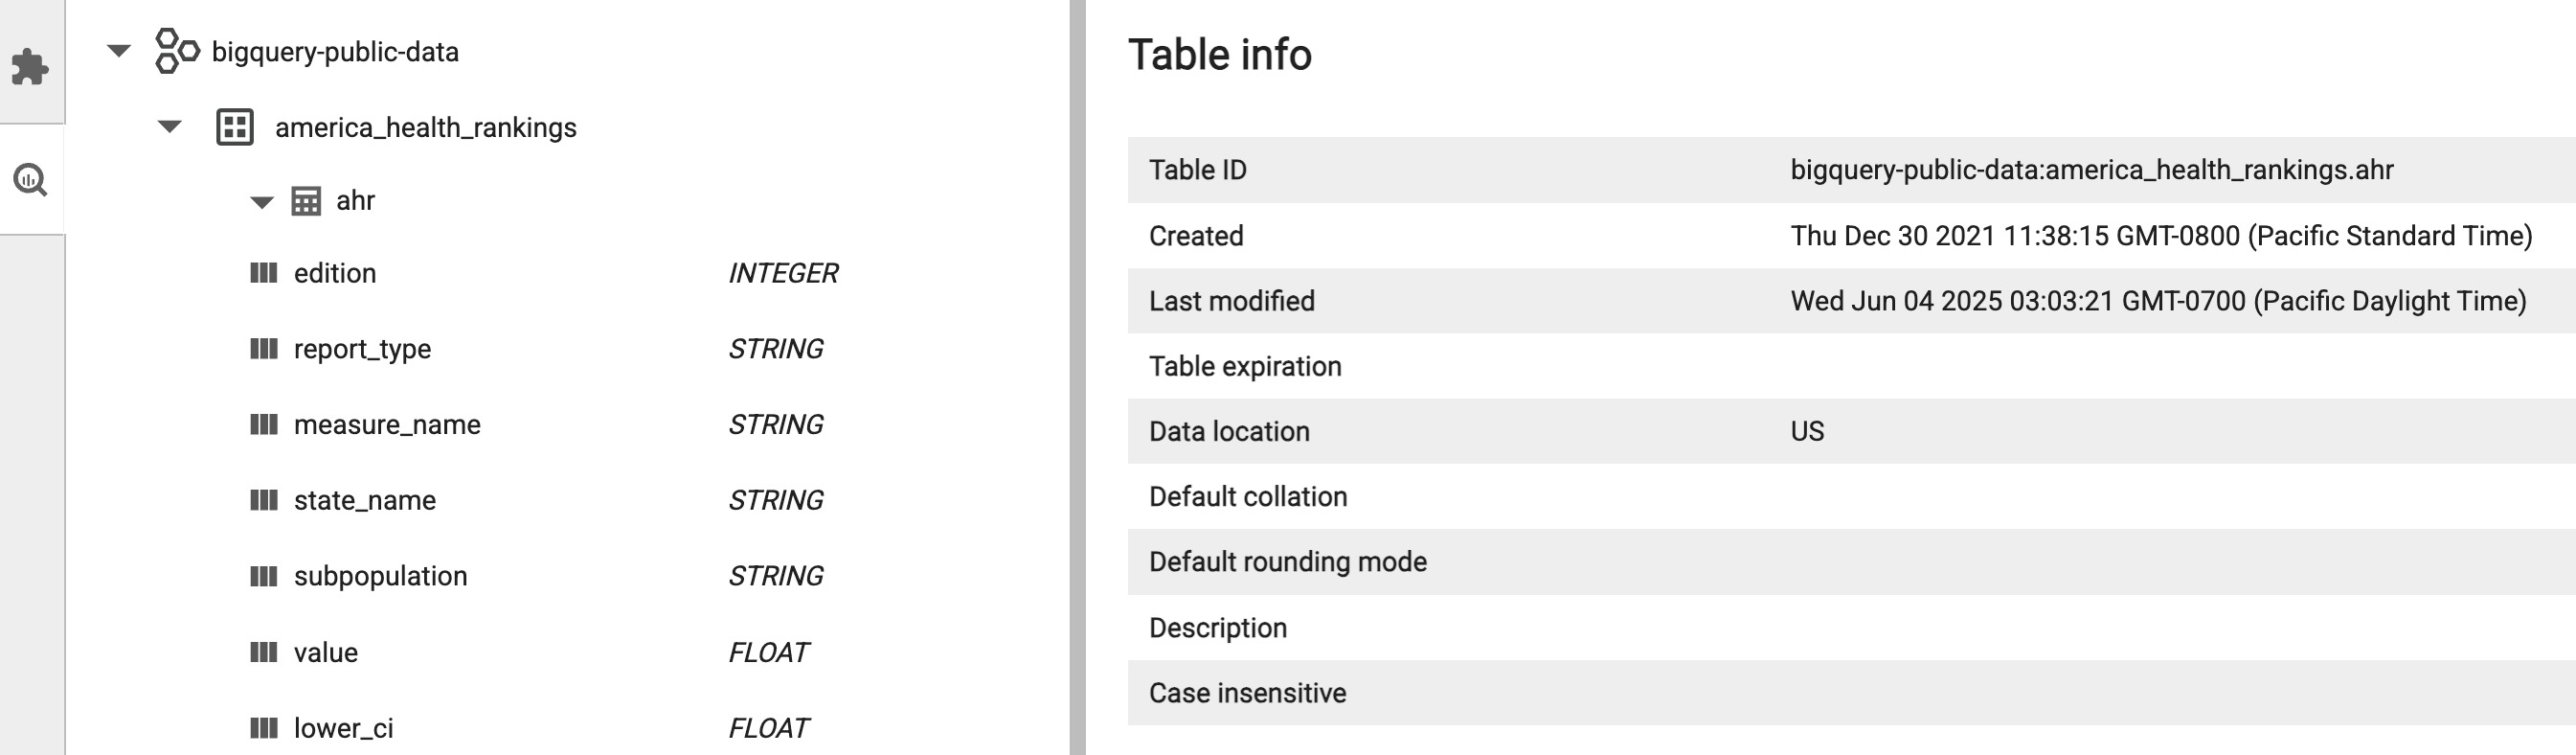
Im Dataset Explorer können Sie nach einer Datenbank, einer Tabelle oder einer Spalte suchen. Klicken Sie auf den Namen einer Datenbank, Tabelle oder Spalte, um die zugehörigen Metadaten aufzurufen.
Code bereitstellen
Nachdem Sie die JupyterLab-Erweiterung installiert haben, können Sie JupyterLab für Folgendes verwenden:
Notebook-Code in der Managed Service for Apache Spark-Infrastruktur ausführen
Notebook-Ausführung in Managed Service for Apache Airflow planen
Senden Sie Batchjobs an die Managed Service for Apache Spark-Infrastruktur oder an Ihren Managed Service for Apache Spark-Cluster.
Notebookausführung in Managed Airflow planen
Führen Sie die folgenden Schritte aus, um Ihren Notebook-Code in Managed Airflow so zu planen, dass er als Batchjob in Managed Service for Apache Spark oder in einem Managed Service for Apache Spark-Cluster ausgeführt wird.
Klicken Sie rechts oben im Notebook auf den Button Job Scheduler.
Geben Sie im Formular Geplanten Job erstellen die folgenden Informationen an:
- Eindeutiger Name für den Notebook-Ausführungsjob
- Die Managed Airflow-Umgebung, die zum Bereitstellen des Notebooks verwendet werden soll
- Eingabeparameter, wenn das Notebook parametrisiert ist
- Der Managed Service for Apache Spark-Cluster oder die serverlose Laufzeitvorlage, die zum Ausführen des Notebooks verwendet werden soll
- Wenn ein Cluster ausgewählt ist, wird festgelegt, ob der Cluster beendet werden soll, nachdem das Notebook auf dem Cluster ausgeführt wurde.
- Wiederholungsanzahl und Wiederholungsverzögerung in Minuten, wenn die Notebookausführung beim ersten Versuch fehlschlägt
- Ausführungsbenachrichtigungen, die gesendet werden sollen, und die Empfängerliste. Benachrichtigungen werden über eine SMTP-Konfiguration von Airflow gesendet.
- Der Zeitplan für die Notebookausführung
Klicken Sie auf Erstellen.
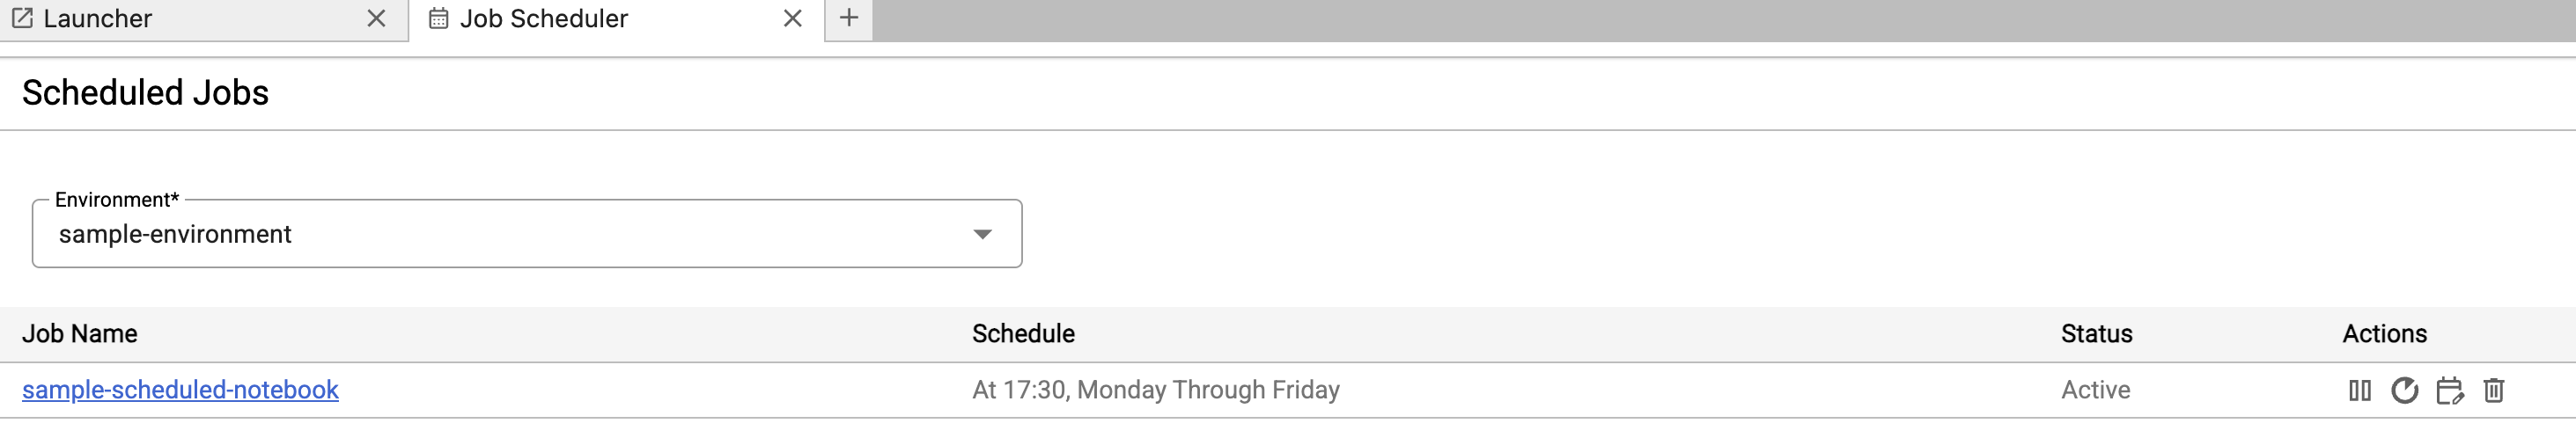
Nachdem das Notebook erfolgreich geplant wurde, wird der Jobname in der Liste der geplanten Jobs in der Managed Airflow-Umgebung angezeigt.
Batchjob an Managed Service for Apache Spark senden
Klicken Sie auf der JupyterLab-Seite Launcher im Abschnitt Dataproc-Jobs und -Sitzungen auf die Karte Serverlos.
Klicken Sie auf den Tab Batch, dann auf Batch erstellen und füllen Sie die Felder unter Batch-Informationen aus.
Klicken Sie auf Senden, um den Job zu senden.
Batchjob an einen Managed Service for Apache Spark-Cluster senden
Klicken Sie auf der JupyterLab-Seite Launcher im Abschnitt Dataproc-Jobs und -Sitzungen auf die Karte Cluster.
Klicken Sie auf den Tab Jobs und dann auf Job senden.
Wählen Sie einen Cluster aus und füllen Sie die Jobfelder aus.
Klicken Sie auf Senden, um den Job zu senden.
Ressourcen ansehen und verwalten
Nachdem Sie die JupyterLab-Erweiterung installiert haben, können Sie Managed Service for Apache Spark und Managed Service for Apache Spark im Abschnitt Dataproc-Jobs und -Sitzungen auf der JupyterLab-Seite Launcher aufrufen und verwalten.
Klicken Sie auf den Abschnitt Dataproc-Jobs und -Sitzungen, um die Karten Cluster und Serverlos anzuzeigen.
So rufen Sie Managed Service for Apache Spark-Sitzungen auf und verwalten sie:
- Klicken Sie auf die Karte Serverlos.
- Klicken Sie auf den Tab Sitzungen und dann auf eine Sitzungs-ID, um die Seite Sitzungsdetails zu öffnen. Dort können Sie Sitzungsattribute aufrufen, Google Cloud -Logs im Log-Explorer ansehen und eine Sitzung beenden. Hinweis: Für jedes Managed Service for Apache Spark-Notebook wird eine eindeutige Managed Service for Apache Spark-Sitzung erstellt.
So rufen Sie Managed Service for Apache Spark-Batches auf und verwalten sie:
- Klicken Sie auf den Tab Batches, um die Liste der Managed Service for Apache Spark-Batches im aktuellen Projekt und in der aktuellen Region aufzurufen. Klicken Sie auf eine Batch-ID, um Batchdetails aufzurufen.
So rufen Sie Managed Service for Apache Spark-Cluster auf und verwalten sie:
- Klicken Sie auf die Karte Cluster. Der Tab Cluster ist ausgewählt, um aktive Managed Service for Apache Spark-Cluster im aktuellen Projekt und in der aktuellen Region aufzulisten. Sie können auf die Symbole in der Spalte Aktionen klicken, um einen Cluster zu starten, zu beenden oder neu zu starten. Klicken Sie auf einen Clusternamen, um die Clusterdetails aufzurufen. Sie können auf die Symbole in der Spalte Aktionen klicken, um einen Job zu klonen, zu beenden oder zu löschen.
So rufen Sie Managed Service for Apache Spark-Jobs auf und verwalten sie:
- Klicken Sie auf die Karte Jobs, um die Liste der Jobs im aktuellen Projekt aufzurufen. Klicken Sie auf eine Job-ID, um die Jobdetails aufzurufen.