


Übersicht
Der Persistent History Server (PHS) von Managed Service for Apache Spark bietet Weboberflächen, über die Sie den Jobverlauf für Jobs aufrufen können, die in aktiven oder gelöschten Managed Service for Apache Spark-Clustern ausgeführt wurden. Es ist in Image-Version 1.5 und höher von Managed Service for Apache Spark verfügbar und wird auf einem Managed Service for Apache Spark-Cluster mit einem einzelnen Knoten ausgeführt. Es bietet Weboberflächen für die folgenden Dateien und Daten:
MapReduce- und Spark-Jobverlaufsdateien
Flink-Jobverlaufsdateien (Informationen zum Erstellen eines Managed Service for Apache Spark-Clusters zum Ausführen von Flink-Jobs finden Sie unter Optionale Flink-Komponente von Dataproc)
Anwendungszeitachsendaten-Dateien, die von YARN Timeline Service v2 erstellt und in einer Bigtable-Instanz gespeichert werden.
YARN-Aggregationslogs
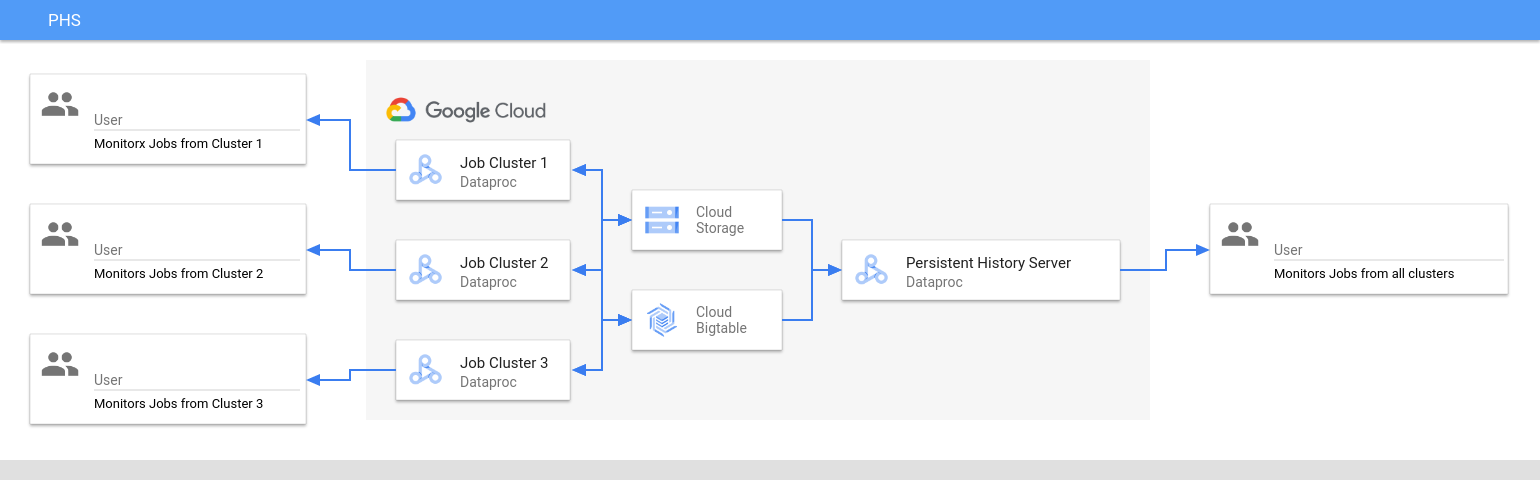
Der persistente Verlaufsserver greift auf Spark- und MapReduce-Jobverlaufsdateien, Flink-Jobverlaufsdateien und YARN-Logdateien zu, die während der Lebensdauer von Managed Service for Apache Spark-Jobclustern in Cloud Storage geschrieben wurden, und zeigt sie an.
Beschränkungen
Die Image-Version des PHS-Clusters und die Image-Version der Managed Service for Apache Spark-Jobcluster müssen übereinstimmen. Sie können beispielsweise einen PHS-Cluster mit der Image-Version von Managed Service for Apache Spark 2.0 verwenden, um Jobverlaufsdateien von Jobs anzusehen, die auf Jobclustern mit der Image-Version von Managed Service for Apache Spark 2.0 ausgeführt wurden, die sich in dem Projekt befinden, in dem sich der PHS-Cluster befindet.
Ein PHS-Cluster unterstützt weder Kerberos noch die persönliche Authentifizierung.
Managed Service for Apache Spark-PHS-Cluster erstellen
Sie können den folgenden gcloud dataproc clusters create-Befehl in einem lokalen Terminal oder in Cloud Shell mit den folgenden Flags und Clustereigenschaften ausführen, um einen Managed Service for Apache Spark Persistent History Server-Cluster mit einem einzelnen Knoten zu erstellen.
gcloud dataproc clusters create CLUSTER_NAME \
    --project=PROJECT \
    --region=REGION \
    --single-node \
    --enable-component-gateway \
    --optional-components=COMPONENT \
    --properties=PROPERTIES
- CLUSTER_NAME: Geben Sie den Namen des PHS-Clusters an.
- PROJECT: Geben Sie das Projekt an, das mit dem PHS-Cluster verknüpft werden soll. Dieses Projekt sollte mit dem Projekt übereinstimmen, das mit dem Cluster verknüpft ist, auf dem Ihre Jobs ausgeführt werden (siehe Dataproc-Jobcluster erstellen).
- REGION: Geben Sie eine Compute Engine-Region an, in der sich der PHS-Cluster befinden soll.
--single-node: Ein PHS-Cluster ist ein Dataproc-Cluster mit einem einzelnen Knoten.--enable-component-gateway: Mit diesem Flag werden Component Gateway-Weboberflächen im PHS-Cluster aktiviert.- COMPONENT: Verwenden Sie dieses Flag, um eine oder mehrere optionale Komponenten im Cluster zu installieren. Sie müssen die optionale Komponente
FLINKangeben, um den Flink HistoryServer-Webdienst auf dem PHS-Cluster auszuführen und Flink-Jobverlaufsdateien aufzurufen. - PROPERTIES. Geben Sie ein oder mehrere Clusterattribute an.
Fügen Sie optional das Flag --image-version hinzu, um die Image-Version des PHS-Clusters anzugeben. Die PHS-Image-Version muss mit der Image-Version der Managed Service for Apache Spark-Jobcluster übereinstimmen. Siehe Einschränkungen.
Hinweise:
- In den Beispielen für Attributwerte in diesem Abschnitt wird ein Platzhalterzeichen „*“ verwendet, damit der PHS mit mehreren Verzeichnissen im angegebenen Bucket übereinstimmen kann, in die von verschiedenen Jobclustern geschrieben wird (siehe aber Überlegungen zur Effizienz von Platzhaltern).
- In den folgenden Beispielen werden separate
--properties-Flags zur besseren Lesbarkeit angezeigt. Wenn Siegcloud dataproc clusters createverwenden, um einen Managed Service for Apache Spark-Cluster zu erstellen, sollten Sie ein--properties-Flag verwenden, um eine Liste von kommagetrennten Attributen anzugeben (siehe Formatierung von Clusterattributen).
Attribute:
yarn:yarn.nodemanager.remote-app-log-dir=gs://bucket-name/*/yarn-logs: Fügen Sie diese Property hinzu, um den Cloud Storage-Speicherort anzugeben, an dem der PHS auf YARN-Logs zugreift, die von Jobclustern geschrieben wurden.spark:spark.history.fs.logDirectory=gs://bucket-name/*/spark-job-history: Fügen Sie dieses Attribut hinzu, um den persistenten Spark-Jobverlauf zu aktivieren. Dieses Attribut gibt den Speicherort an, an dem der PHS auf die von Jobclustern geschriebenen Spark-Jobverlaufsprotokolle zugreift.In Managed Service for Apache Spark-Clustern der Version 2.0 oder höher müssen außerdem die folgenden beiden Properties festgelegt werden, um PHS-Spark-Verlaufsprotokolle zu aktivieren (siehe Konfigurationsoptionen für den Spark History Server). Der Wert
spark.history.custom.executor.log.urlist ein Literalwert, der {{PLATZHALTER}} für Variablen enthält, die vom Persistent History Server festgelegt werden. Diese Variablen werden nicht von Nutzern festgelegt. Übergeben Sie den Attributwert wie gezeigt.--properties=spark:spark.history.custom.executor.log.url.applyIncompleteApplication=false
--properties=spark:spark.history.custom.executor.log.url={{YARN_LOG_SERVER_URL}}/{{NM_HOST}}:{{NM_PORT}}/{{CONTAINER_ID}}/{{CONTAINER_ID}}/{{USER}}/{{FILE_NAME}}mapred:mapreduce.jobhistory.read-only.dir-pattern=gs://bucket-name/*/mapreduce-job-history/done: Fügen Sie dieses Attribut hinzu, um den nichtflüchtigen MapReduce-Jobverlauf zu aktivieren. Diese Property gibt den Cloud Storage-Speicherort an, an dem der PHS auf MapReduce-Jobverlaufslogs zugreift, die von Jobclustern geschrieben wurden.dataproc:yarn.atsv2.bigtable.instance=projects/project-id/instance_id/bigtable-instance-id: Nachdem Sie Yarn Timeline Service v2 konfiguriert haben, fügen Sie dieses Attribut hinzu, um den PHS-Cluster zum Aufrufen von Zeitachsendaten auf den Weboberflächen YARN Application Timeline Service V2 und Tez zu verwenden (siehe Weboberflächen des Component Gateway).flink:historyserver.archive.fs.dir=gs://bucket-name/*/flink-job-history/completed-jobs: Mit dieser Property können Sie den Flink-HistoryServerso konfigurieren, dass eine durch Kommas getrennte Liste von Verzeichnissen überwacht wird.
Beispiele für Properties:
--properties=spark:spark.history.fs.logDirectory=gs://bucket-name/*/spark-job-history
--properties=mapred:mapreduce.jobhistory.read-only.dir-pattern=gs://bucket-name/*/mapreduce-job-history/done
--properties=flink:flink.historyserver.archive.fs.dir=gs://bucket-name/*/flink-job-history/completed-jobs
Managed Service for Apache Spark-Jobcluster erstellen
Sie können den folgenden Befehl in einem lokalen Terminal oder in Cloud Shell ausführen, um einen Managed Service for Apache Spark-Jobcluster zu erstellen, der Jobs ausführt und Jobverlaufsdateien auf einen Persistent History Server (PHS) schreibt.
gcloud dataproc clusters create CLUSTER_NAME \ --project=PROJECT \ --region=REGION \ --optional-components=COMPONENT \ --enable-component-gateway \ --properties=PROPERTIES \ other args ...
- CLUSTER_NAME: Geben Sie den Namen des Jobclusters an.
- PROJECT: Geben Sie das Projekt an, das mit dem Jobcluster verknüpft ist.
- REGION: Geben Sie die Compute Engine-Region an, in der sich der Jobcluster befinden soll.
--enable-component-gateway: Mit diesem Flag werden Component Gateway-Weboberflächen im Jobcluster aktiviert.- COMPONENT: Verwenden Sie dieses Flag, um eine oder mehrere optionale Komponenten im Cluster zu installieren. Geben Sie die optionale Komponente
FLINKan, um Flink-Jobs im Cluster auszuführen. PROPERTIES: Fügen Sie eine oder mehrere der folgenden Clustereigenschaften hinzu, um PHS-bezogene, nicht standardmäßige Cloud Storage-Speicherorte und andere Jobclustereigenschaften festzulegen.
Hinweise:
- In den Beispielen für Attributwerte in diesem Abschnitt wird ein Platzhalterzeichen „*“ verwendet, damit der PHS mit mehreren Verzeichnissen im angegebenen Bucket übereinstimmen kann, in die von verschiedenen Jobclustern geschrieben wird (siehe aber Überlegungen zur Effizienz von Platzhaltern).
- In den folgenden Beispielen werden separate
--properties-Flags zur besseren Lesbarkeit angezeigt. Wenn Siegcloud dataproc clusters createverwenden, um einen Managed Service for Apache Spark-Cluster zu erstellen, sollten Sie ein--properties-Flag verwenden, um eine Liste von kommagetrennten Attributen anzugeben (siehe Formatierung von Clusterattributen).
Attribute:
yarn:yarn.nodemanager.remote-app-log-dir: Standardmäßig sind aggregierte YARN-Logs in Managed Service for Apache Spark-Jobclustern aktiviert und werden in den temporären Bucket des Clusters geschrieben. Fügen Sie dieses Attribut hinzu, um einen anderen Cloud Storage-Speicherort anzugeben, an den der Cluster Aggregationslogs für den Zugriff durch den Persistent History Server schreibt.--properties=yarn:yarn.nodemanager.remote-app-log-dir=gs://bucket-name/directory-name/yarn-logs
spark:spark.history.fs.logDirectoryundspark:spark.eventLog.dir: Standardmäßig werden Spark-Jobverlaufsdateien im Clustertemp bucketim Verzeichnis/spark-job-historygespeichert. Sie können diese Attribute hinzufügen, um verschiedene Cloud Storage-Speicherorte für diese Dateien anzugeben. Wenn beide Attribute verwendet werden, müssen sie auf Verzeichnisse im selben Bucket verweisen.--properties=spark:spark.history.fs.logDirectory=gs://bucket-name/directory-name/spark-job-history
--properties=spark:spark.eventLog.dir=gs://bucket-name/directory-name/spark-job-history
mapred:mapreduce.jobhistory.done-dirundmapred:mapreduce.jobhistory.intermediate-done-dir: Standardmäßig werden MapReduce-Jobverlaufsdateien im Clustertemp bucketin den Verzeichnissen/mapreduce-job-history/doneund/mapreduce-job-history/intermediate-donegespeichert. Der Zwischenspeicherortmapreduce.jobhistory.intermediate-done-dirist ein temporärer Speicher. Zwischendateien werden nach Abschluss des MapReduce-Jobs an den Speicherortmapreduce.jobhistory.done-dirverschoben. Sie können diese Properties hinzufügen, um verschiedene Cloud Storage-Speicherorte für diese Dateien anzugeben. Wenn beide Attribute verwendet werden, müssen sie auf Verzeichnisse im selben Bucket verweisen.--properties=mapred:mapreduce.jobhistory.done-dir=gs://bucket-name/directory-name/mapreduce-job-history/done
--properties=mapred:mapreduce.jobhistory.intermediate-done-dir=gs://bucket-name/directory-name/mapreduce-job-history/intermediate-done
spark:spark.history.fs.gs.outputstream.type: Dieses Attribut gilt für Cluster mit den Image-Versionen2.0und2.1, die die Cloud Storage-Connector-Version2.0.xverwenden (die Standard-Connector-Version für Cluster mit den Image-Versionen2.0und2.1). Sie steuert, wie Spark-Jobs Daten an Cloud Storage senden. Die Standardeinstellung istBASIC. Dadurch werden Daten nach Abschluss des Jobs an Cloud Storage gesendet. Wenn der Wert aufFLUSHABLE_COMPOSITEgesetzt ist, werden die Daten in regelmäßigen Abständen in Cloud Storage kopiert, während der Job ausgeführt wird, wie durchspark:spark.history.fs.gs.outputstream.sync.min.interval.msfestgelegt.--properties=spark:spark.history.fs.gs.outputstream.type=FLUSHABLE_COMPOSITE
spark:spark.history.fs.gs.outputstream.sync.min.interval.ms: Diese Property gilt für Cluster mit den Image-Versionen2.0und2.1, die die Cloud Storage-Connector-Version2.0.xverwenden (die Standard-Connector-Version für Cluster mit den Image-Versionen2.0und2.1). Sie steuert die Häufigkeit in Millisekunden, mit der Daten an Cloud Storage übertragen werden, wennspark:spark.history.fs.gs.outputstream.typeaufFLUSHABLE_COMPOSITEgesetzt ist. Das Standardzeitintervall ist5000ms. Der Wert für das Zeitintervall in Millisekunden kann mit oder ohne das Suffixmsangegeben werden.--properties=spark:spark.history.fs.gs.outputstream.sync.min.interval.ms=INTERVALms
spark:spark.history.fs.gs.outputstream.sync.min.interval: Dieses Attribut gilt für Cluster mit der Image-Version2.2und höher, die die Cloud Storage-Connector-Version3.0.xverwenden (die Standard-Connector-Version für Cluster mit der Image-Version2.2). Es ersetzt das vorherige Attributspark:spark.history.fs.gs.outputstream.sync.min.interval.msund unterstützt Werte mit Zeitsuffix, z. B.ms,sundm. Sie steuert die Häufigkeit, mit der Daten an Cloud Storage übertragen werden, wennspark:spark.history.fs.gs.outputstream.typeaufFLUSHABLE_COMPOSITEfestgelegt ist.--properties=spark:spark.history.fs.gs.outputstream.sync.min.interval=INTERVAL
dataproc:yarn.atsv2.bigtable.instance: Nachdem Sie Yarn Timeline Service v2 konfiguriert haben, fügen Sie dieses Attribut hinzu, um YARN-Zeitachsendaten in die angegebene Bigtable-Instanz zu schreiben, damit sie auf den Weboberflächen YARN Application Timeline Service V2 und Tez des PHS-Clusters angezeigt werden können. Hinweis: Die Clustererstellung schlägt fehl, wenn die Bigtable-Instanz nicht vorhanden ist.--properties=dataproc:yarn.atsv2.bigtable.instance=projects/project-id/instance_id/bigtable-instance-id
flink:jobhistory.archive.fs.dir: Der Flink JobManager archiviert abgeschlossene Flink-Jobs, indem er archivierte Jobinformationen in ein Dateisystemverzeichnis hochlädt. Verwenden Sie dieses Attribut, um das Archivverzeichnis inflink-conf.yamlfestzulegen.--properties=flink:jobmanager.archive.fs.dir=gs://bucket-name/job-cluster-1/flink-job-history/completed-jobs
PHS mit Spark-Batcharbeitslasten verwenden
So verwenden Sie den Persistent History Server mit Managed Service for Apache Spark Serverless for Spark-Batcharbeitslasten:
Wählen Sie den PHS-Cluster aus oder geben Sie ihn an, wenn Sie eine Spark-Batcharbeitslast einreichen.
PHS mit Managed Service for Apache Spark in der Google Kubernetes Engine verwenden
So verwenden Sie den Persistent History Server mit Managed Service for Apache Spark in GKE:
Wählen Sie den PHS-Cluster aus oder geben Sie ihn an, wenn Sie einen virtuellen Managed Service for Apache Spark-Cluster in GKE erstellen.
Component Gateway-Weboberflächen
Klicken Sie in der Google Cloud Console auf der Seite Cluster des Managed Service for Apache Spark auf den Namen des PHS-Clusters, um die Seite Clusterdetails zu öffnen. Wählen Sie auf dem Tab Weboberflächen die Links zum Komponentengateway aus, um Weboberflächen zu öffnen, die im PHS-Cluster ausgeführt werden.

Weboberfläche des Spark-Verlaufsservers
Der folgende Screenshot zeigt die Weboberfläche des Spark History Servers mit Links zu Spark-Jobs, die auf job-cluster-1 und job-cluster-2 ausgeführt wurden, nachdem die Speicherorte spark.history.fs.logDirectory und spark:spark.eventLog.dir der Jobcluster und der Speicherort spark.history.fs.logDirectory des PHS-Clusters so eingerichtet wurden:
| job-cluster-1 | gs://example-cloud-storage-bucket/job-cluster-1/spark-job-history |
| job-cluster-2 | gs://example-cloud-storage-bucket/job-cluster-2/spark-job-history |
| phs-cluster | gs://example-cloud-storage-bucket/*/spark-job-history |

Suche nach App-Namen
Sie können Jobs in der Weboberfläche des Spark-Verlaufsservers nach App-Name auflisten, indem Sie einen App-Namen in das Suchfeld eingeben. Der App-Name kann auf eine der folgenden Arten festgelegt werden (nach Priorität aufgelistet):
- Wird im Anwendungscode beim Erstellen des Spark-Kontexts festgelegt
- Wird beim Senden des Jobs durch das Attribut spark.app.name festgelegt.
- Wird von Managed Service for Apache Spark auf den vollständigen REST-Ressourcennamen für den Job (
projects/project-id/regions/region/jobs/job-id) festgelegt.
Nutzer können im Feld Suchen den Namen einer App oder Ressource eingeben, um Jobs zu finden und aufzulisten.
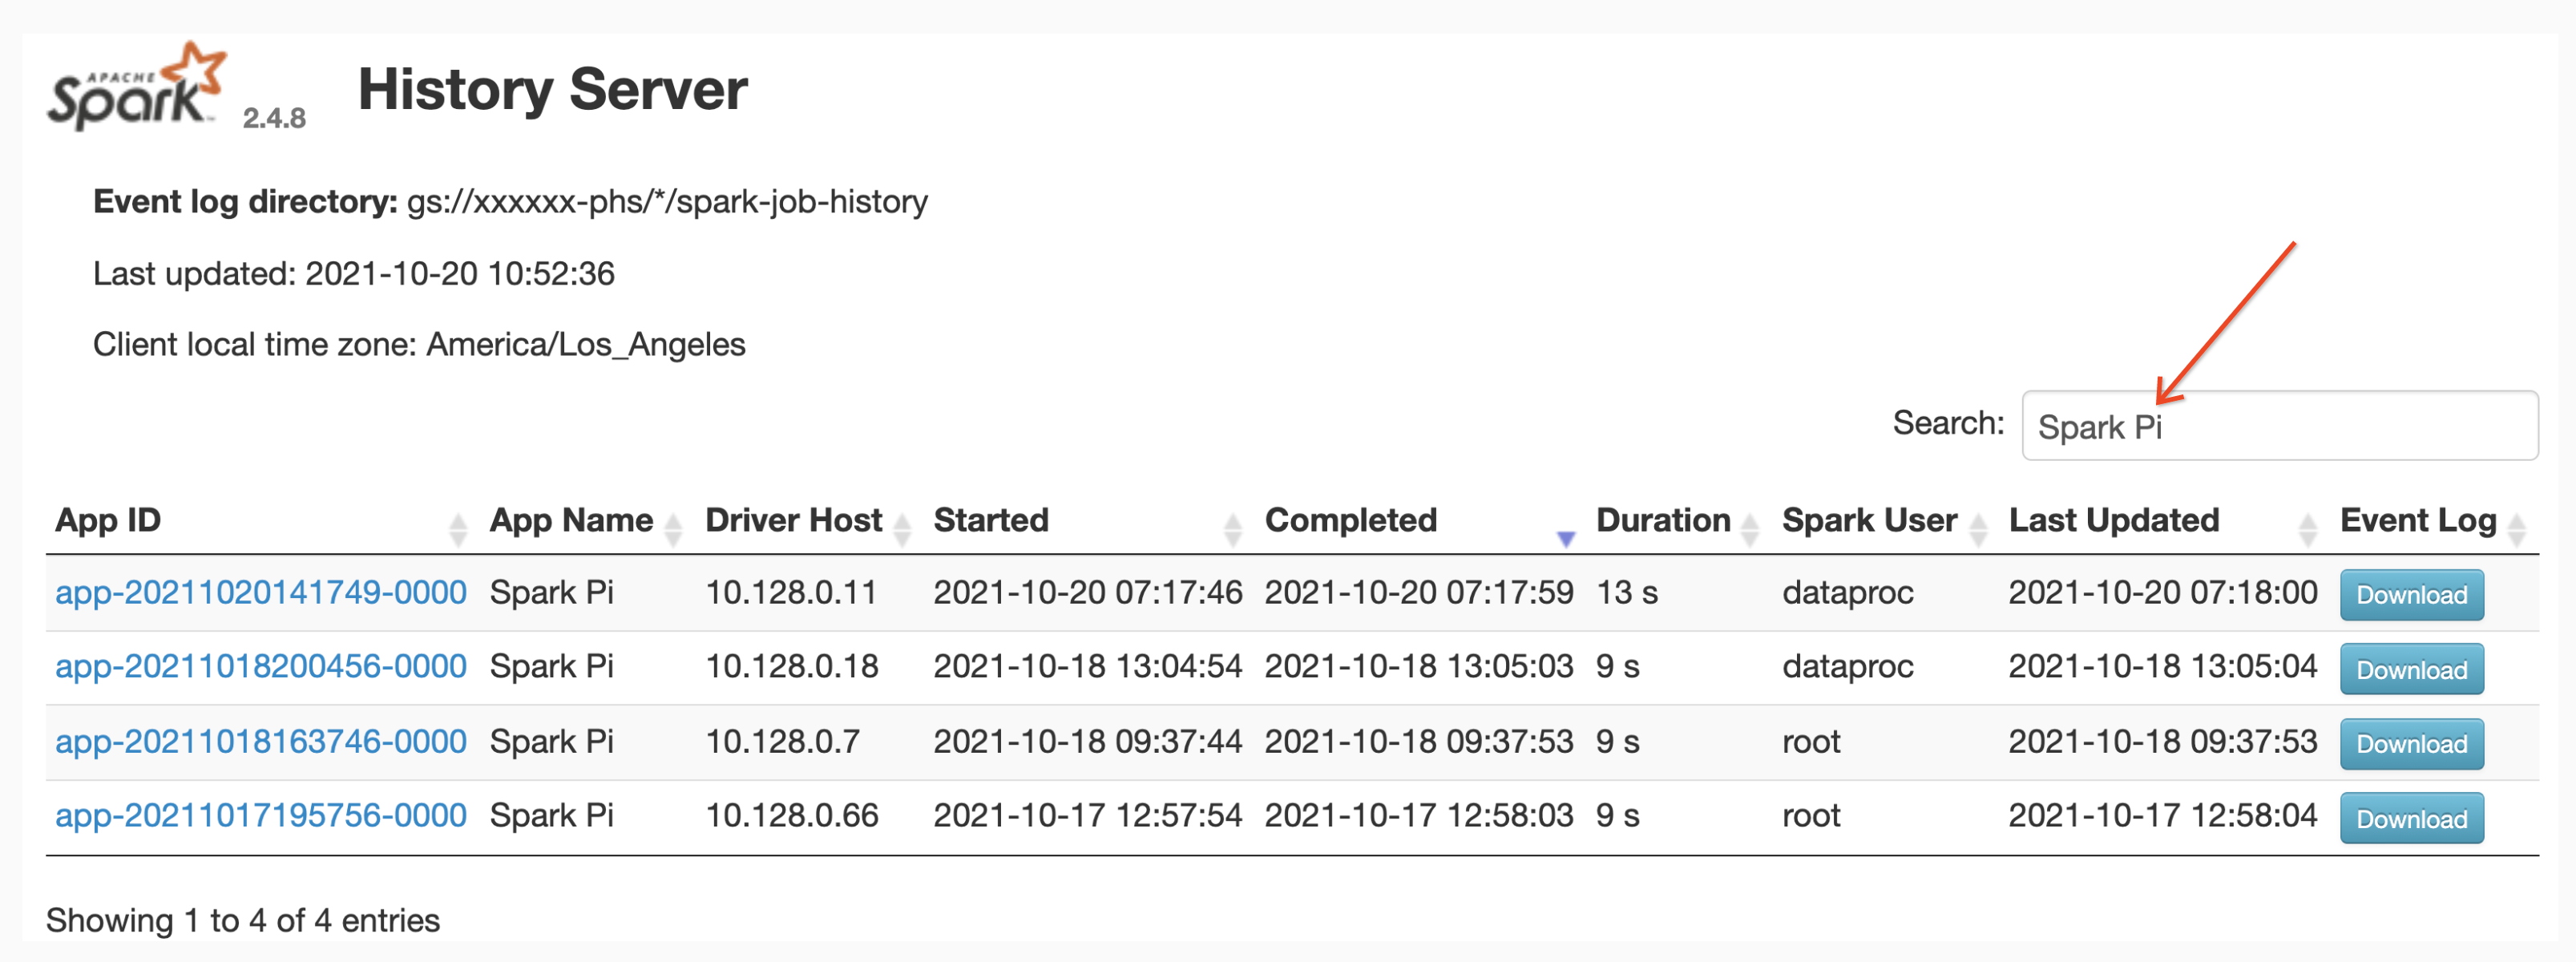
Ereignisprotokolle
Die Spark History Server-Weboberfläche bietet einen Button Ereignisprotokoll, auf den Sie klicken können, um Spark-Ereignisprotokolle herunterzuladen. Diese Logs sind nützlich, um den Lebenszyklus der Spark-Anwendung zu untersuchen.
Spark-Jobs
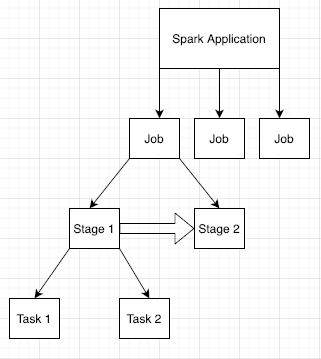
Spark-Anwendungen sind in mehrere Jobs unterteilt, die weiter in mehrere Phasen unterteilt werden. Jede Phase kann mehrere Aufgaben enthalten, die auf Executor-Knoten (Workern) ausgeführt werden.
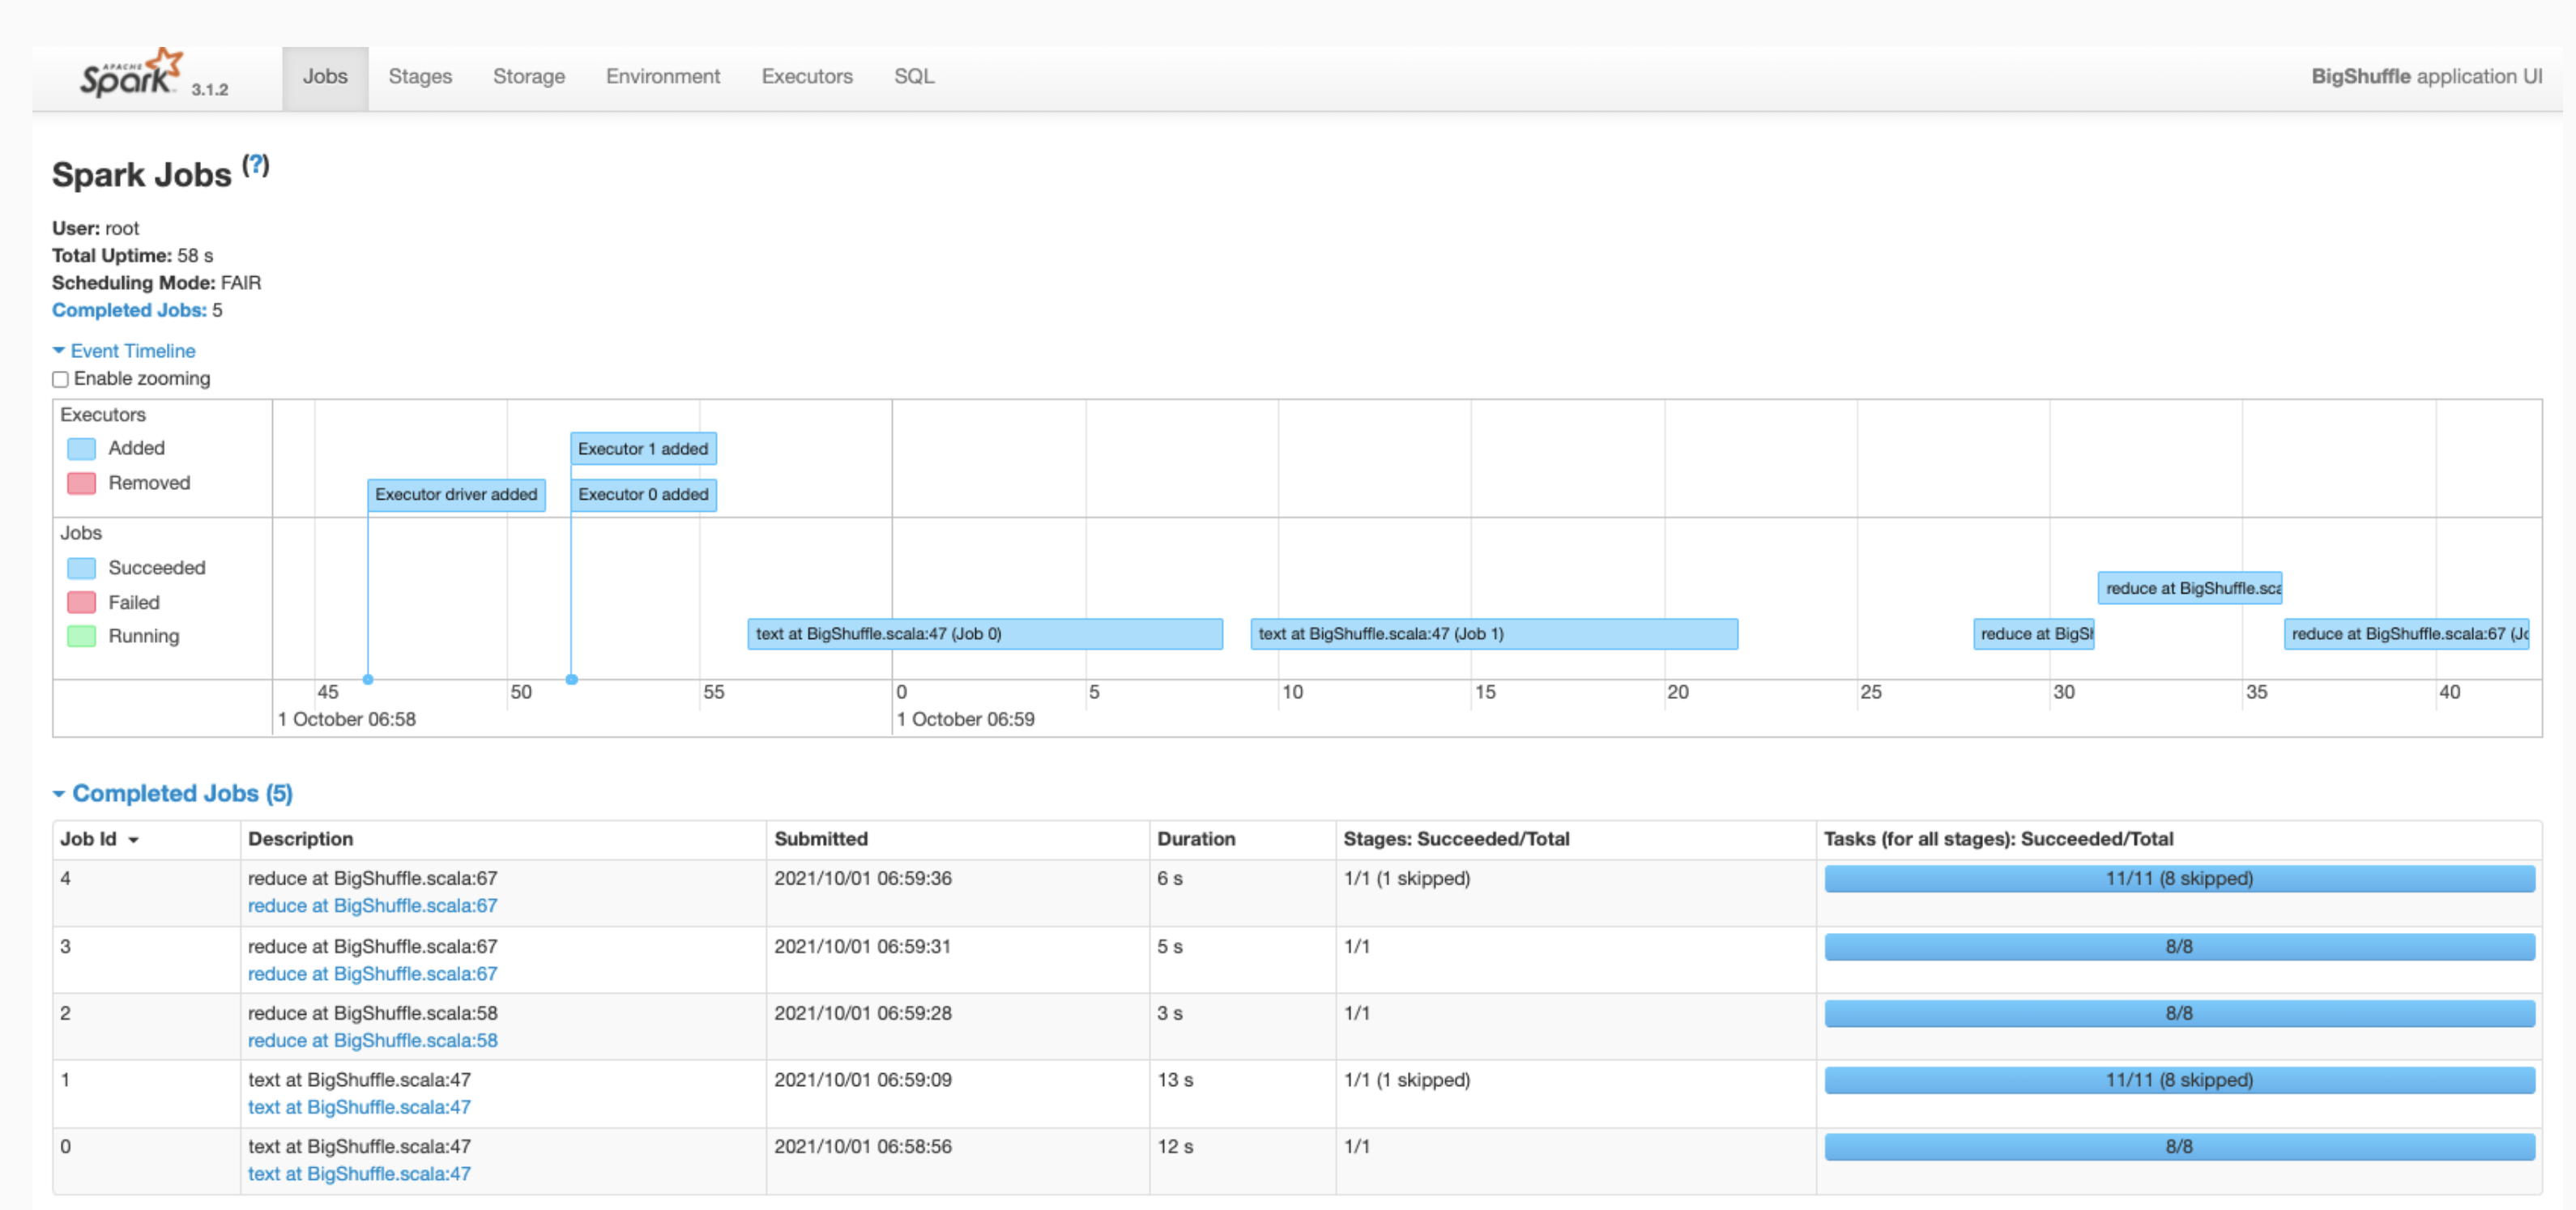
Klicken Sie in der Weboberfläche auf eine Spark-Anwendungs-ID, um die Seite „Spark-Jobs“ zu öffnen. Dort finden Sie eine Ereigniszeitachse und eine Zusammenfassung der Jobs in der Anwendung.
Klicken Sie auf einen Job, um die Seite "Jobdetails" mit einem gerichteten azyklischen Graphen (Directed Acyclic Graph, DAG) und einer Zusammenfassung der Jobphasen zu öffnen.

Klicken Sie auf eine Phase oder wählen Sie auf dem Tab „Phasen“ eine Phase aus, um die Detailseite der Phase zu öffnen.

Stage Details umfassen eine DAG-Visualisierung, eine Ereigniszeitachse und Messwerte für die Aufgaben innerhalb der Phase. Auf dieser Seite können Sie Probleme im Zusammenhang mit gedrosselten Aufgaben, Verzögerungen beim Planer und Out of Memory-Fehlern beheben. Der DAG-Visualisierer zeigt die Codezeile, aus der die Phase abgeleitet ist, sodass Sie Probleme wieder im Code verfolgen können.
Klicken Sie auf den Tab „Executors“, um Informationen zu den Treiber- und Executor-Knoten der Spark-Anwendung aufzurufen.

Wichtige Informationen auf dieser Seite umfassen die Anzahl der Kerne und die Anzahl der Aufgaben, die auf jedem Executor ausgeführt wurden.
Tez-Weboberfläche
Tez ist die Standardausführungs-Engine für Hive und Pig in Managed Service for Apache Spark. Wenn Sie einen Hive-Job in einem Managed Service for Apache Spark-Jobcluster einreichen, wird eine Tez-Anwendung gestartet.
Wenn Sie Yarn Timeline Service v2 konfiguriert und das Attribut dataproc:yarn.atsv2.bigtable.instance beim Erstellen der PHS- und Managed Service for Apache Spark-Jobcluster festgelegt haben, schreibt YARN generierte Hive- und Pig-Jobzeitachsendaten in die angegebene Bigtable-Instanz, damit sie auf der Tez-Weboberfläche abgerufen und angezeigt werden können, die auf dem PHS-Server ausgeführt wird.

Weboberfläche für YARN Application Timeline V2
Wenn Sie Yarn Timeline Service v2 konfiguriert und das Attribut dataproc:yarn.atsv2.bigtable.instance beim Erstellen der PHS- und Managed Service for Apache Spark-Jobcluster festgelegt haben, schreibt YARN generierte Jobzeitachsendaten in die angegebene Bigtable-Instanz, damit sie abgerufen und auf der Weboberfläche des YARN Application Timeline Service angezeigt werden können, die auf dem PHS-Server ausgeführt wird. Managed Service for Apache Spark-Jobs werden in der Weboberfläche auf dem Tab Flow-Aktivität aufgeführt.

Yarn Timeline Service v2 konfigurieren
So konfigurieren Sie Yarn Timeline Service v2: Richten Sie eine Bigtable-Instanz ein und prüfen Sie bei Bedarf die Dienstkontorollen:
Prüfen Sie bei Bedarf die Dienstkontorollen. Das standardmäßige VM-Dienstkonto, das von Dataproc-Cluster-VMs verwendet wird, hat die erforderlichen Berechtigungen zum Erstellen und Konfigurieren der Bigtable-Instanz für den YARN Timeline Service. Wenn Sie Ihren Job oder PHS-Cluster mit einem benutzerdefinierten VM-Dienstkonto erstellen, muss das Konto entweder die Bigtable-Rolle
AdministratoroderBigtable Userhaben.
Erforderliches Tabellenschema
Die Unterstützung des Managed Service for Apache Spark PHS für YARN Timeline Service v2 erfordert ein bestimmtes Schema, das in der Bigtable-Instanz erstellt wurde. Managed Service for Apache Spark erstellt das erforderliche Schema, wenn ein Jobcluster oder PHS-Cluster erstellt wird und das Attribut dataproc:yarn.atsv2.bigtable.instance auf die Bigtable-Instanz verweist.
Das folgende Bigtable-Instanzschema ist erforderlich:
| Tabellen | Spaltenfamilien |
|---|---|
| prod.timelineservice.application | c,i,m |
| prod.timelineservice.app_flow | m |
| prod.timelineservice.entity | c,i,m |
| prod.timelineservice.flowactivity | i |
| prod.timelineservice.flowrun | i |
| prod.timelineservice.subapplication | c,i,m |
Automatische Speicherbereinigung in Bigtable
Sie können die altersbasierte Bigtable-automatische Speicherbereinigung für ATSv2-Tabellen konfigurieren:
Installieren Sie cbt (einschließlich der Erstellung der
.cbrtc file).Erstellen Sie die altersbasierte Richtlinie für die automatische Speicherbereinigung für ATSv2:
export NUMBER_OF_DAYS = number \
cbt setgcpolicy prod.timelineservice.application c maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.application i maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.application m maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.app_flow m maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.entity c maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.entity i maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.entity m maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.flowactivity i maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.flowrun i maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.subapplication c maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.subapplication i maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.subapplication m maxage=${NUMBER_OF_DAYS}
Hinweise:
NUMBER_OF_DAYS: Die maximale Anzahl von Tagen beträgt 30d.