


Mit dem Lakehouse-Laufzeitkatalog können Sie Tabellenmetadaten in einem vollständig verwalteten, serverlosen Metastore zentralisieren, der als zentrale Informationsquelle für Ihre Daten im grenzenlosen Lakehouse dient. Mit zentralisierten Metadaten können Verarbeitungs-Engines wie Apache Spark, Apache Flink, Apache Hive und BigQuery Tabellen direkt freigeben, ohne Dateien zu duplizieren.
Wenn Sie einen Clientendpunkt wie den Apache Iceberg REST-Katalogendpunkt konfigurieren, fungiert er als Verwaltungsoberfläche, die Abfrage-Engines mit dem Lakehouse-Laufzeitkatalog verbindet. Der Endpunkt verarbeitet Tabellenmetadaten und Cloud Storage speichert die zugrunde liegenden Metadaten und Datendateien.
Als Kernkomponente von Lakehouse bietet der Lakehouse-Laufzeitkatalog Interoperabilität mit offenen APIs und unterstützt in Kombination mit BigQuery Analyse-, Streaming- und KI-Arbeitslasten. Weitere Informationen zu diesen architektonischen Vorteilen finden Sie unter Was ist ein grenzenloses Lakehouse?.
So wird Lakehouse in Google Cloudeingebunden
Informationen dazu, wie Lakehouse Ihre Daten verwaltet, finden Sie unter „Integration der Lakehouse-Architektur in Google Cloud -Dienste“. Apache Iceberg speichert Daten nicht in monolithischen Tabellen. Stattdessen wird eine mehrschichtige Architektur von Metadatendateien verwendet, um Datendateien in einer zusammenhängenden Tabellenstruktur mit ACID-Transaktionsunterstützung zu organisieren.
Das folgende Diagramm zeigt, wie Compute-Engines wie Managed Service for Apache Spark den Lakehouse-Laufzeitkatalog verwenden, um Tabellenmetadaten zu verwalten und zugrunde liegende Parquet-Datendateien direkt in Cloud Storage zu lesen und zu schreiben.
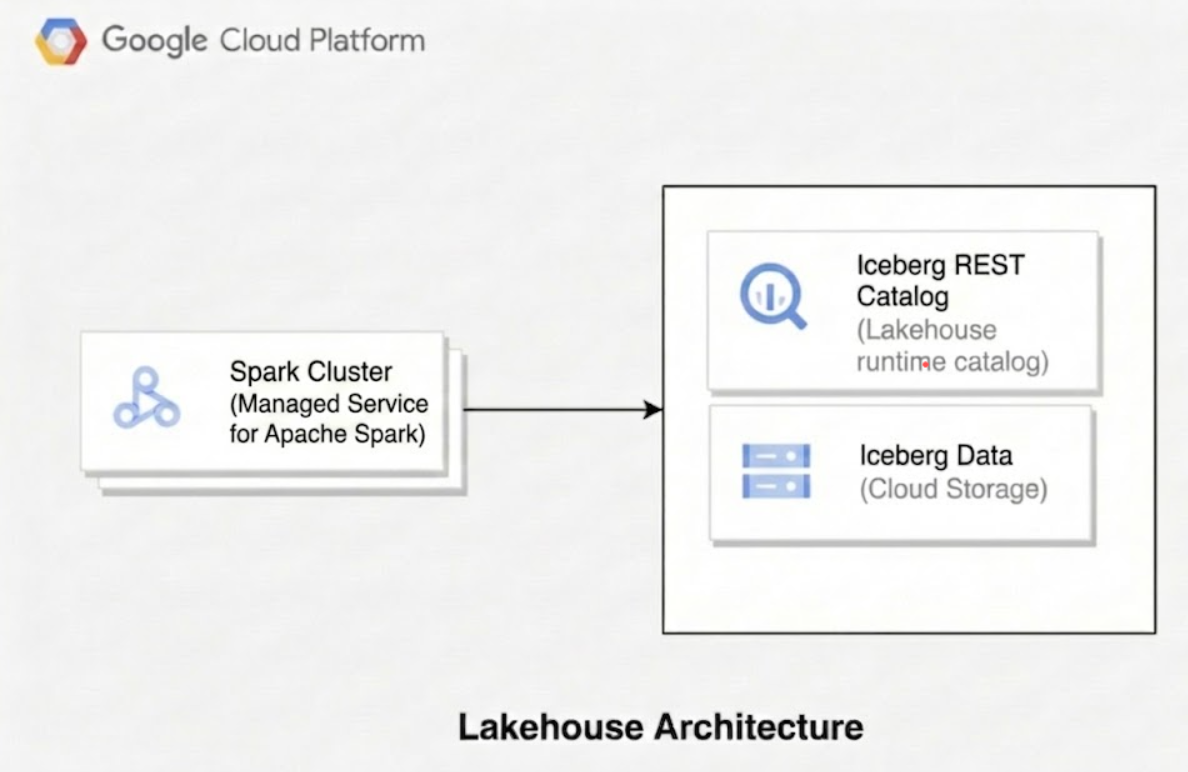
Wenn Sie Lakehouse verwenden, besteht die technische Architektur aus drei verschiedenen Ebenen:
Katalogebene:
- Grundlegendes Iceberg-Konzept: Der Katalog speichert den aktuellen Status der Tabelle, indem er einen Verweis auf die neueste Metadatendatei enthält. Diese Ebene ermöglicht die ACID-Compliance und Transaktionsisolation, damit gleichzeitige Schreibvorgänge sich nicht gegenseitig beeinträchtigen.
- Lakehouse-Implementierung: Der Lakehouse-Laufzeitkatalog fungiert als regionaler Metastore-Dienst auf oberster Ebene. In diesem Dienst erstellen Sie einzelne Kataloge, um Ihre Datenhierarchie zu verwalten. Client-Abfrage-Engines stellen über bestimmte Endpunkt-Katalogtypen eine Verbindung zu diesen Katalogen her, z. B. über den Apache Iceberg REST-Katalog-Endpunkt. Der Metastore verwaltet Transaktions-Commits, die Bereitstellung von Anmeldedaten für die Delegierung des Speicherzugriffs und die Verwaltung von Zeigern in Ihren Katalogen.
Metadatenebene:
- Zentrales Iceberg-Konzept: Diese Ebene verfolgt die Tabellenstruktur, Snapshots und Dateispeicherorte mithilfe einer Hierarchie von drei Dateitypen:
- Metadatendateien: Speichern das Schema der Tabelle, die Partitionsspezifikation und ein Protokoll der Snapshot-Verweise.
- Manifestlisten: Stellen einen einzelnen Snapshot der Tabelle dar, indem eine Sammlung von Manifestdateien gruppiert wird.
- Manifestdateien: Verfolgen Daten auf der Ebene einzelner Dateien und speichern Dateipfade, Partitionierungsinformationen und Statistiken auf Spaltenebene, z. B. Zeilenanzahl sowie Mindest- und Höchstwerte, die für die Abfrageoptimierung und das Partition Pruning verwendet werden.
- Lakehouse-Implementierung: In einem Katalogcontainer organisieren Sie Ihre Daten in logischen Namespaces (ähnlich wie Datasets) und Tabellen. Für jede Tabelle generiert und verwaltet der Lakehouse-Laufzeitkatalog die zugrunde liegende Iceberg-Metadatenhierarchie, beginnend mit einer
metadata.json-Stammdatei, die auf die Manifestlisten und Manifestdateien verweist. Der Lakehouse-Laufzeitkatalog speichert diese Dateien direkt am angegebenen Warehouse-Speicherort.
- Zentrales Iceberg-Konzept: Diese Ebene verfolgt die Tabellenstruktur, Snapshots und Dateispeicherorte mithilfe einer Hierarchie von drei Dateitypen:
Datenebene:
- Zentrales Iceberg-Konzept: Diese Komponente ist der zugrunde liegende Speicher, in dem die eigentlichen Rohdatensätze gespeichert werden, in der Regel in optimierten spalten- oder zeilenbasierten offenen Dateiformaten wie Parquet, ORC oder Avro.
- Lakehouse-Implementierung: Wenn Sie Cloud Storage-Warehouse-Standorte (
gs://) konfigurieren, werden die physischen Datendateien, auf die Ihre Tabellen verweisen, sicher in Ihren Buckets gespeichert. Der Lakehouse-Laufzeitkatalog verwaltet den Zugriff über die Delegation des Speicherzugriffs (Anmeldedaten-Vending) und stellt kurzlebige Zugriffstokens direkt für Client-Engines bereit. So können Engines Datendateien sicher lesen und schreiben, ohne dass umfassende, direkte IAM-Berechtigungen für die zugrunde liegenden Buckets erforderlich sind.
So implementiert Lakehouse die Apache Iceberg REST Catalog API
Der Lakehouse-Laufzeitkatalog implementiert die Open-Source-Apache Iceberg REST Catalog API, um Namespaces und Tabellen zu verwalten. Außerdem bietet es eine Erweiterungs-API speziell für die Katalogverwaltung.
Clientabfrage-Engines interagieren mit dem Metastore über diese Standard-REST-Katalog-APIs. Weitere Informationen zu Google Cloud-Ressourcen und -Endpunkten finden Sie in der Lakehouse REST API-Referenz.
Sie können diese Ressourcen mit derGoogle Cloud Console, der gcloud CLI, der REST API oder Terraform erstellen, konfigurieren und verwalten. Weitere Informationen finden Sie auf den folgenden Seiten:
- Iceberg-REST-Katalogressourcen verwalten
- Apache Iceberg-Tabellen verwalten
- Terraform mit Lakehouse verwenden
- Regionale Endpunkte mit dem Lakehouse-Laufzeitkatalog verwenden
Kompatibilität und Konfiguration der Abfrage-Engine
Wenn Sie Daten im Lakehouse-Laufzeitkatalog analysieren und verwalten möchten, können Sie verschiedene Open-Source- und Enterprise-Abfrage-Engines verbinden. Je nach Ihrer vorhandenen Architektur und Ihren Arbeitslastanforderungen können Sie aus mehreren unterstützten Engines auswählen und den entsprechenden Katalogendpunkt konfigurieren.
Unterstützte Suchmaschinen
Der Lakehouse-Laufzeitkatalog ist mit mehreren Abfrage-Engines kompatibel, darunter Apache Spark, Apache Flink, Apache Hive und Trino. In der folgenden Tabelle finden Sie Links zur Dokumentation für die einzelnen Engines:
| Engine | Dokumentation |
|---|---|
| Apache Spark | Mit Apache Spark verwenden |
| Apache Hive | Mit Spark und dem Hive-Katalog verwenden |
| Apache Flink | Mit Apache Flink verwenden |
| Trino | Mit Trino verwenden |
Katalogtypen und Endpunktkonfiguration
Wenn Sie Client-Engines für die Verbindung mit dem Metastore des Lakehouse-Laufzeitkatalogs konfigurieren, wählen Sie einen bestimmten Katalogendpunkt aus, z. B. den Apache Iceberg REST-Katalogendpunkt oder den Apache Hive-Endpunkt. Die beste Option hängt von Ihrem Anwendungsfall ab, wie in der folgenden Tabelle dargestellt:
| Anwendungsfall | Empfehlung |
|---|---|
| Neue Nutzer des Lakehouse-Laufzeitkatalogs, die mit ihrer Open-Source-Engine auf Daten in Cloud Storage zugreifen möchten und Interoperabilität mit anderen Engines wie BigQuery und AlloyDB for PostgreSQL benötigen. | Verwenden Sie den Apache Iceberg REST-Katalogendpunkt. |
| Nutzer, die Apache Hive- oder Spark-Arbeitslasten ausführen, die von der Hive Metastore-Schnittstelle abhängen, und einen vollständig verwalteten Metastore-Dienst benötigen. | Verwenden Sie den Apache Hive-Katalogendpunkt. |
| Vorhandene Nutzer des Lakehouse-Laufzeitkatalogs, die aktuelle Tabellen mit dem benutzerdefinierten Apache Iceberg-Katalog für den BigQuery-Endpunkt erstellt haben. | Verwenden Sie weiterhin den benutzerdefinierten Apache Iceberg-Katalog für den BigQuery-Endpunkt, aber verwenden Sie den Apache Iceberg REST-Katalog für neue Workflows. |
Einschränkungen des Lakehouse-Laufzeitkatalogs
Die folgenden allgemeinen Einschränkungen gelten für Tabellen im Lakehouse-Laufzeitkatalog, wenn sie über BigQuery abgefragt werden. Für einzelne Katalogendpunkte (z. B. Apache Iceberg REST oder Apache Hive) gelten möglicherweise zusätzliche endpunktspezifische Einschränkungen.
Tabellenverwaltung
- Apache Iceberg V2-Tabellen (GA) und V3-Tabellen (Vorabversion) werden unterstützt. Iceberg V1-Tabellen werden nicht unterstützt. Bevor Sie vorhandene V1-Tabellen mit dem Lakehouse-Laufzeitkatalog verwenden können, müssen Sie sie auf eine unterstützte Version aktualisieren. Weitere Informationen finden Sie unter Iceberg-V1-Tabellen auf V2 aktualisieren.
- Tabellen im Lakehouse-Laufzeitkatalog unterstützen keine Umbenennungsvorgänge und keine
ALTER TABLE ... RENAME TO-Spark-SQL-Anweisung. - Tabellen im Lakehouse-Laufzeitkatalog unterstützen kein Clustering.
- Tabellen im Lakehouse-Laufzeitkatalog unterstützen keine Extraktionsjobs. Diese Einschränkung gilt sowohl für
EXPORT DATA-Anweisungen als auch für denbq extract-CLI-Befehl. - Der Lakehouse-Laufzeitkatalog unterstützt keine Datenbank- oder Metastore-Ansichten.
- Der Lakehouse-Laufzeitkatalog unterstützt keine Apache Iceberg-Ansichten.
Abfragen
- Die Abfrageleistung für Tabellen im Lakehouse-Laufzeitkatalog über die BigQuery-Engine ist möglicherweise langsamer als bei der Abfrage von Daten in BigQuery-Standardtabellen. Im Allgemeinen sollte die Abfragegeschwindigkeit dem Lesen von Daten aus Cloud Storage entsprechen.
- Ein BigQuery-Probelauf einer Abfrage, die eine Tabelle im Lakehouse-Laufzeitkatalog verwendet, kann eine Untergrenze von 0 Byte an Daten melden, auch wenn Zeilen zurückgegeben werden. Dieses Ergebnis tritt auf, weil die Menge der aus der Tabelle verarbeiteten Daten erst nach Ausführung der vollständigen Abfrage bestimmt werden kann. Für die Ausführung der Abfrage fallen Kosten für die Verarbeitung dieser Daten an.
- Sie können in einer Abfrage mit einer Platzhaltertabelle nicht auf eine Tabelle im Lakehouse-Laufzeitkatalog verweisen.
API und Metadaten
- Sie können die Methode
tabledata.listnicht verwenden, um Daten aus Tabellen im Lakehouse-Laufzeitkatalog abzurufen. Stattdessen können Sie Abfrageergebnisse in einer BigQuery-Tabelle speichern und dann die Methodetabledata.listfür diese Tabelle verwenden. - Die Anzeige von Tabellenspeicherstatistiken für Tabellen im Lakehouse-Laufzeitkatalog wird nicht unterstützt.
Kontingente und Limits
- Für Tabellen im Lakehouse-Laufzeitkatalog in BigQuery gelten dieselben Kontingente und Limits wie für Standardtabellen.
Unterschiede zu BigLake Metastore (klassisch)
Zu den wichtigsten Unterschieden zwischen dem Lakehouse-Laufzeitkatalog und dem BigLake-Metastore (klassisch) gehören:
- Der Lakehouse-Laufzeitkatalog unterstützt eine direkte Integration in Open-Source-Engines wie Spark. Dadurch wird die Redundanz beim Speichern von Metadaten und Ausführen von Jobs reduziert. Auf Tabellen im Lakehouse-Laufzeitkatalog kann direkt über mehrere Open-Source-Engines und BigQuery zugegriffen werden.
- Der Lakehouse-Laufzeitkatalog unterstützt den Apache Iceberg REST-Katalogendpunkt, BigLake Metastore (klassisch) jedoch nicht.
Nächste Schritte
- Apache Iceberg REST-Katalogendpunkt verstehen.
- Regionale Endpunkte konfigurieren