


總覽
Looker 會運用匯總感知邏輯,在資料庫中找出最小、最有效率的資料表來執行查詢,同時維持結果的準確性。
對於資料庫中的超大型資料表,Looker 開發人員可以建立較小的匯總資料表,將資料依不同屬性組合分組。匯總表格就像「匯總」或「彙整」資料的表格,Looker 可在查詢時盡可能使用這類表格,而非原始的大型資料表。如果在妥善規劃下導入這項功能,可讓平均查詢速度提升好幾倍。
舉例來說,您可能有一個 PB 級資料表,其中每一列都代表網站上的一筆訂單。您可以根據這個資料庫,建立包含每日銷售總額的匯總表格。如果網站每天收到 1,000 筆訂單,每日匯總表格會比原始表格少 999 列。您可以建立另一個匯總表格,其中包含每月銷售總額,這樣會更有效率。現在,如果使用者查詢每日或每週銷售額,Looker 就會使用每日銷售總額資料表。如果使用者執行年度銷售查詢,但您沒有年度匯總表格,Looker 就會使用次佳選項,在本例中為月銷售匯總表格。
Looker 會盡可能使用最小的匯總資料表,回答使用者的問題。例如:
- 如果是查詢每月銷售總額,Looker 會使用以每月銷售額為基礎的匯總表格 (
sales_monthly_aggregate_table)。 - 如果查詢的是每日每筆銷售總額,由於沒有該精細程度的匯總表格,Looker 會從原始資料庫表格 (
orders_database) 取得查詢結果。(不過,如果使用者經常執行這類查詢,您可以為此建立匯總表格)。 - 查詢每週銷售額時,由於沒有每週匯總表格,Looker 會使用次佳選項,也就是根據每日銷售額 (
sales_daily_aggregate_table) 建立的匯總表格。
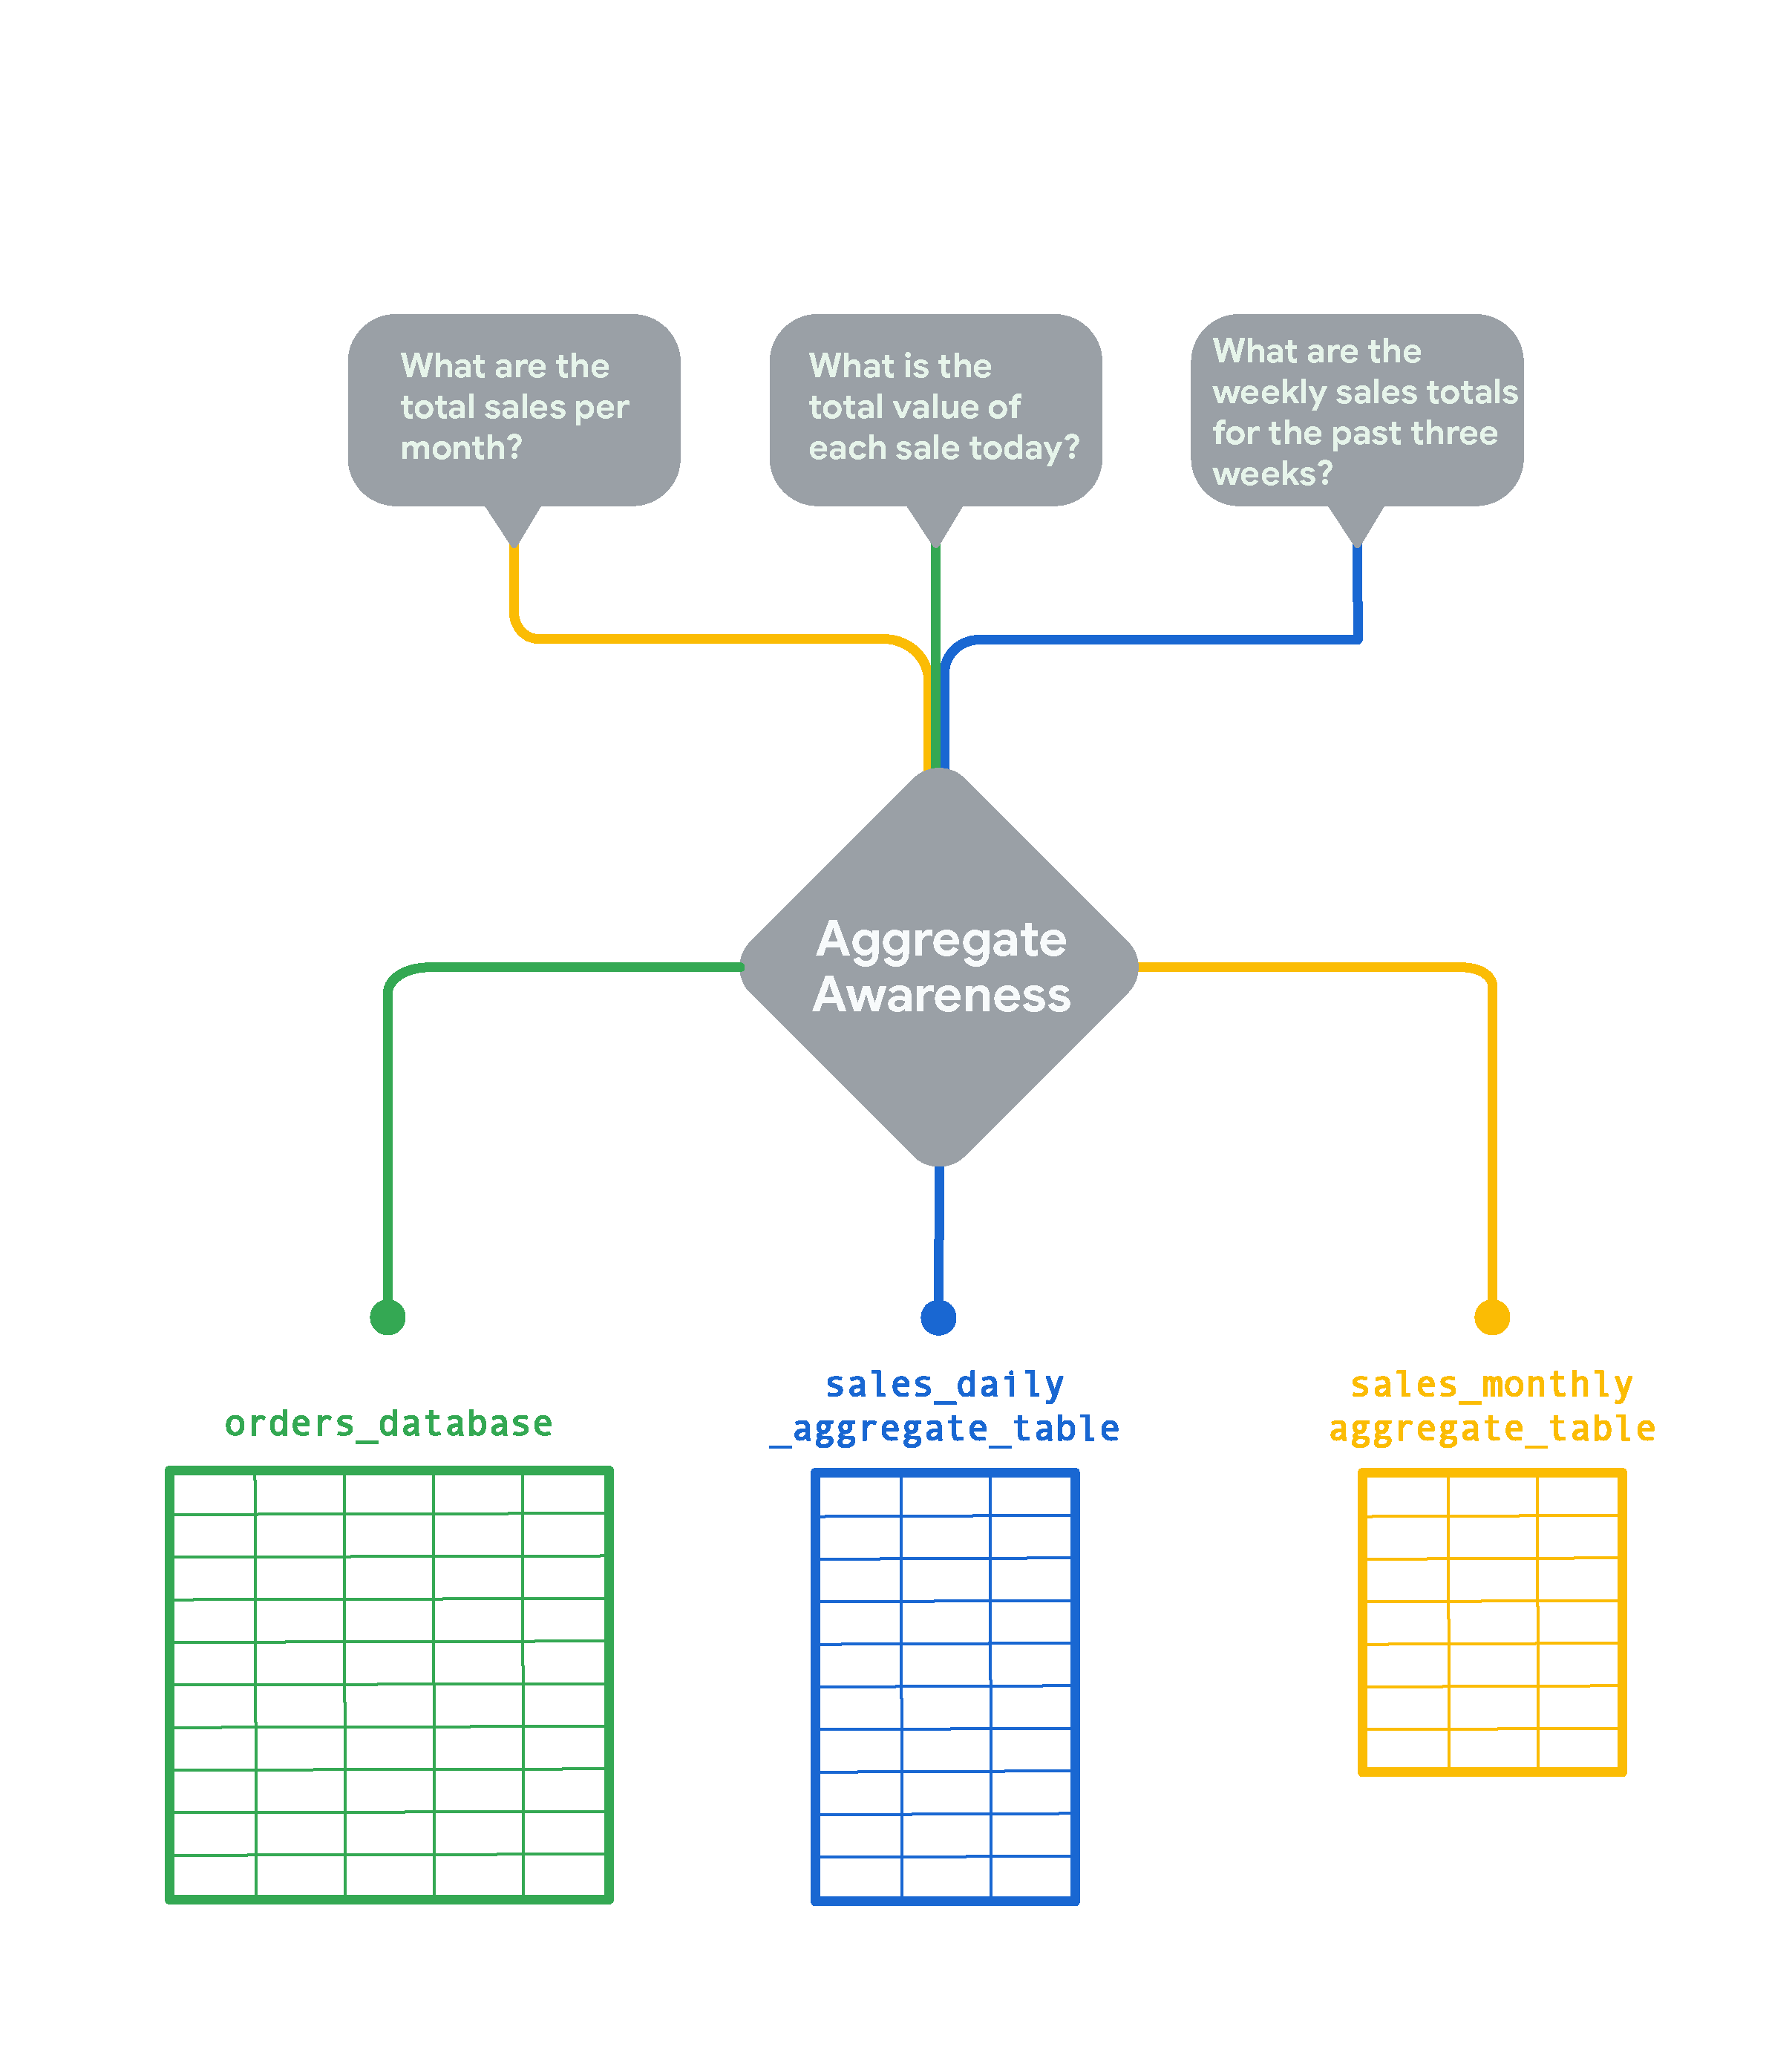
Looker 會運用匯總感知邏輯,查詢最小的匯總表格,回答使用者的問題。只有在查詢需要比匯總表格更精細的資料時,才會使用原始資料表。
匯總表格不需要加入或新增至個別探索。而是動態調整探索查詢的 FROM 子句,存取最適合該查詢的匯總表格。也就是說,系統會保留細查,並整合探索。有了匯總感知功能,單一探索就能自動運用匯總表格,但仍可視需要深入探討精細資料。
您也可以運用匯總表格,大幅提升資訊主頁的效能,尤其是查詢大型資料集的圖塊。詳情請參閱 aggregate_table 參數說明文件頁面的「從資訊主頁取得匯總表格 LookML」一節。
在專案中新增匯總表格
Looker 開發人員可以建立符合策略需求的匯總表格,盡量減少須對資料庫中大型資料表執行查詢的次數。匯總表格必須保留在資料庫中,才能供匯總感知功能使用。因此,匯總表格也是一種永久衍生資料表 (PDT)。
匯總表格是透過 LookML 專案中 explore 參數下的 aggregate_table 參數定義。
以下是 LookML 中含有匯總表格的 explore 範例:
explore: orders {
  label: "Sales Totals"
  join: order_items {
    sql_on: ${orders.id} = ${order_items.id} ;;
  }
  aggregate_table: sales_monthly {
    materialization: {
      datagroup_trigger: orders_datagroup
    }
    query: {
      dimensions: [created_month]
      measures: [order_items.total_sales]
    }
  }
  # other explore parameters
}
如要建立匯總表格,您可以從頭開始編寫 LookML,也可以從探索或資訊主頁取得匯總表格 LookML。如要瞭解 aggregate_table 參數及其子參數的詳細資訊,請參閱 aggregate_table 參數說明文件頁面。
設計匯總表格
如要讓「探索」查詢使用匯總表格,匯總表格必須能為「探索」查詢提供準確的資料。如果符合下列所有條件,Looker 就能使用匯總表格執行探索查詢:
- 探索查詢的欄位是匯總表格欄位的子集 (請參閱本頁的「欄位因素」一節)。如果是時間範圍,探索查詢的時間範圍可以從匯總表格的時間範圍衍生 (請參閱本頁的「時間範圍因素」一節)。
- 探索查詢包含匯總感知功能支援的測量指標類型 (請參閱本頁的「測量指標類型因素」一節),或探索查詢有完全比對的匯總表格 (請參閱本頁的「建立與探索查詢完全比對的匯總表格」一節)。
- 「探索」查詢的時區與匯總表格使用的時區相符 (請參閱本頁的「時區因素」一節)。
- 探索查詢的篩選器參照欄位,可做為匯總表格中的維度,或探索查詢的每個篩選器都與匯總表格中的篩選器相符 (請參閱本頁的「篩選器因素」一節)。
如要確保匯總表格能為探索查詢提供準確資料,其中一個方法是建立與探索查詢完全相符的匯總表格。詳情請參閱本頁的「建立與探索查詢完全相符的匯總表格」一節。
現場因素
如要用於「探索」查詢,匯總表格必須包含該查詢所需的所有維度和測量指標,包括查詢中用於篩選器的欄位。如果「探索」查詢包含匯總表格沒有的維度或測量指標,Looker 就無法使用匯總表格,而會改用基礎資料表。
舉例來說,如果查詢依維度 A 和 B 分組依據、依測量指標 C 匯總,並依維度 D 篩選,則匯總表格至少必須包含維度 A、B 和 D,以及測量指標 C。
匯總表格也可以有其他欄位,但至少必須有「探索」查詢欄位,才能進行最佳化。時間範圍維度是唯一的例外,因為較粗略的時間範圍可以從較精細的時間範圍衍生而來。
基於這些欄位考量,匯總表格會專屬於定義該表格的探索。在某個探索下定義的匯總表格,不會用於其他探索的查詢。
時間範圍因素
Looker 的匯總感知邏輯可從某個時間範圍衍生出另一個時間範圍。只要匯總表格的時間範圍精細程度,比探索查詢更精細 (或相同),就能用於查詢。舉例來說,以每日資料為基礎的匯總表格,可用於要求其他時間範圍的探索查詢,例如查詢每日、每月和每年資料,甚至是每月日期、每年日期和每年週數資料。不過,年度匯總表格無法用於需要每小時資料的「探索」查詢,因為匯總表格的資料精細程度不足,無法用於「探索」查詢。
日期範圍子集也適用相同原則。舉例來說,如果匯總表格篩選了過去三個月的資料,而使用者查詢資料時篩選了過去兩個月的資料,Looker 就能使用該匯總表格進行查詢。
此外,相同的邏輯也適用於含有時間範圍篩選器的查詢:只要匯總表格的時間範圍精細程度,比探索查詢中使用的時間範圍篩選器更精細 (或相等),就能用於含有時間範圍篩選器的查詢。舉例來說,如果匯總表格的時間範圍維度為每日,則可用於按日、週或月篩選的探索查詢。
評估類型因素
如要讓「探索」查詢使用匯總表格,匯總表格中的測量指標必須能為「探索」查詢提供準確的資料。
因此,我們僅支援特定類型的測量指標,詳情請參閱以下各節:
如果探索查詢使用其他類型的測量指標,Looker 會使用原始資料表 (而非匯總表格) 傳回結果。唯一的例外狀況是「探索」查詢與匯總資料表查詢完全相符,詳情請參閱「建立與『探索』查詢完全相符的匯總資料表」一節。
否則,Looker 會使用原始資料表 (而非匯總表格) 傳回結果。
測量指標類型符合支援範圍
匯總感知功能可用於「探索」查詢,這些查詢使用的測量指標類型如下:
如要使用匯總表格進行探索查詢,Looker 必須能對匯總表格的測量指標執行操作,才能在探索查詢中提供正確資料。舉例來說,具有 type: sum 的測量指標可用於匯總感知,因為您可以加總多個總和:將每週總和的匯總表格加在一起,即可取得準確的每月總和。同樣地,您也可以使用含有 type: max 的測量指標,因為每日最大值的匯總表格可用於找出準確的每週最大值。
如果是 type: average 測量指標,則支援匯總感知,因為 Looker 會使用加總和計數資料,從匯總表格中準確推導平均值。
使用 SQL 運算式定義的測量指標
匯總感知功能也可與 sql 參數中以運算式定義的測量指標搭配使用。如果使用 SQL 運算式定義,也支援下列測量指標類型:
如果測量指標定義為其他測量指標的組合,則支援匯總感知功能,例如:
measure: total_revenue_in_dollars {
  type: number
  sql: ${total_revenue_in_dollars} - ${inventory_item.total_cost_in_dollars} ;;
}
匯總感知也支援在 sql 參數中定義計算方式的測量指標,例如:
measure: wholesale_value {
  type: number
    sql: (${order_items.total_sale_price} * 0.60) ;;
}
如果測量指標在 sql 參數中定義了 MIN、MAX 和 COUNT 運算,則支援匯總感知,例如以下測量指標:
measure: most_recent_order_date {
  type: date
  sql: MAX(${users.created_at_raw})
}
參照 LookML 欄位的測量指標
在測量指標中使用 sql 運算式時,匯總感知功能支援下列類型的欄位參照:
- 使用
${view_name.field_name}格式的參照,表示其他檢視表中的欄位 - 使用
${field_name}格式的參照,表示同一檢視表中的欄位
如果指標是以 ${TABLE}.column_name 格式定義 (表示資料表中的資料欄),則不支援匯總感知功能。(如要瞭解如何在 LookML 中使用參照,請參閱「整合 SQL 並參照 LookML 物件」說明文件頁面)。
舉例來說,使用這個 sql 參數定義的測量指標不支援匯總表格,因為該指標使用 ${TABLE}.column_name 格式:
measure: wholesale_value {
  type: number
  sql: (${TABLE}.total_sale_price * 0.60) ;;
}
如要在匯總表格中加入這項測量指標,可以改為建立以 ${TABLE}.column_name 格式定義的維度,然後建立參照該維度的測量指標,如下所示:
 dimension: total_sale_price {
    sql: (${TABLE}.total_sale_price) ;;
  }

  measure: wholesale_value {
    type: number
    sql: (${total_sale_price} * 0.60) ;;
}
現在,您可以在匯總表格中使用 wholesale_value 測量指標。
近似不重複計數的測量指標
一般來說,匯總感知功能不支援不重複計數,因為嘗試匯總不重複計數時,無法取得準確的資料。舉例來說,如果您計算網站的不重複使用者,可能會有一位使用者在三週內造訪網站兩次。如果您嘗試套用每週匯總表格,取得網站每月不重複使用者人數,該使用者就會在每月不重複計數查詢中重複計算,導致資料不正確。
解決方法之一是建立與「探索」查詢完全相符的匯總表格,詳情請參閱本頁的「建立與『探索』查詢完全相符的匯總表格」一節。如果「探索」查詢和匯總表格查詢相同,不重複計數測量指標確實會提供準確的資料,因此可用於匯總感知。
另一個選項是使用不重複計數的近似值。如果方言支援 HyperLogLog 草圖,Looker 就能運用 HyperLogLog 演算法,估算匯總表格的不重複計數。
HyperLogLog 演算法的誤差率約為 2%。allow_approximate_optimization: yes 參數需要 Looker 開發人員確認,可以使用近似資料計算測量指標,這樣才能從匯總表格中計算出近似測量指標。
如要瞭解詳情,以及支援使用 HyperLogLog 計算不重複值的方言清單,請參閱 allow_approximate_optimization 參數說明文件頁面。
時區因素
在許多情況下,資料庫管理員會使用世界標準時間 (UTC) 做為資料庫時區。不過,許多使用者可能不在世界標準時間時區。Looker 提供多種轉換時區的選項,讓使用者能以自己的時區取得查詢結果:
- 「查詢時區」:這項設定適用於資料庫連線的所有查詢。如果所有使用者都位於相同時區,您可以設定單一查詢時區,將所有查詢從資料庫時區轉換為查詢時區。
- 使用者專屬時區:可為使用者指派時區,使用者也能自行選取時區。在這種情況下,查詢會從資料庫時區轉換為個別使用者的時區。
如要進一步瞭解這些選項,請參閱「使用時區設定」說明文件頁面。
這些概念對於瞭解匯總感知功能非常重要,因為如果匯總表格要用於含有日期維度或日期篩選器的查詢,匯總表格的時區必須與原始查詢使用的時區設定相符。
如果未指定 timezone 值,匯總表格會使用資料庫時區。如果符合下列任一情況,資料庫連線也會使用資料庫時區:
如果符合上述任一情況,您可以在匯總表格中省略 timezone 參數。
否則,匯總表格的時區應定義為與可能查詢相符,這樣匯總表格就更有可能使用:
- 如果資料庫連線使用單一查詢時區,請將匯總表格的
timezone值與查詢時區值設為一致。 - 如果資料庫連線使用使用者專屬時區,請建立相同的匯總表格,並為每個表格設定不同的
timezone值,以符合使用者可能的時區。
篩選因素
在匯總表格中加入篩選器時,請務必小心。匯總表格的篩選器可能會縮小結果範圍,導致匯總表格無法使用。舉例來說,假設您建立每日訂單數量的匯總表格,並篩選出僅來自澳洲的太陽眼鏡訂單。如果使用者執行「探索」查詢,想瞭解全球太陽眼鏡的每日訂單數量,Looker 就無法使用該匯總表格,因為該表格只有澳洲的資料。匯總表格篩選資料的範圍過窄,無法用於「探索」查詢。
此外,請留意 Looker 開發人員可能在探索中內建的篩選器,例如:
access_filters:套用使用者專屬的資料限制。always_filter:要求使用者在探索查詢中加入一組特定篩選條件。使用者可在查詢時變更預設篩選條件值,但無法移除篩選條件。conditionally_filter:定義一組預設篩選條件,使用者只要從探索中定義的替換清單套用至少一個篩選條件,就能覆寫這些預設篩選條件。
這些篩選器類型是以特定欄位為依據。如果探索包含這些篩選器,您必須在 aggregate_table 的 dimensions 參數中加入這些欄位。
舉例來說,以下探索包含以 orders.region 欄位為基礎的存取權篩選器:
explore: orders {
  access_filter: {
    field: orders.region
    user_attribute: region
  }
}
如要建立用於這項探索的匯總表格,匯總表格必須包含存取權篩選器所依據的欄位。在下一個範例中,存取權篩選器是以 orders.region 欄位為基礎,且匯總表格中包含這個欄位做為維度:
explore: orders {
  access_filter: {
    field: orders.region  # <-- orders.region field
    user_attribute: region
  }
  aggregate_table: sales_monthly {
    materialization: {
      datagroup_trigger: orders_datagroup
    }
    query: {
      dimensions: [orders.created_day, orders.region] # <-- orders.region field
      measures: [orders.total_sales]
      timezone: America/Los_Angeles
    }
  }
}
由於匯總表格查詢包含 orders.region 維度,Looker 可以動態篩選匯總表格中的資料,以符合「探索」查詢中的篩選器。因此,即使探索有存取權篩選器,Looker 仍可使用匯總表格進行探索查詢。
如果探索查詢使用以 bind_filters 設定的原生衍生資料表,也適用這項規則。bind_filters 參數會將探索查詢中的指定篩選器,傳遞至原生衍生資料表子查詢。在匯總感知的情況下,如果探索查詢需要使用 bind_filters 的原生衍生資料表,則只有在原生衍生資料表 bind_filters 參數中使用的所有欄位,在探索查詢中的篩選條件值與匯總表格中的篩選條件值完全相同時,探索查詢才能使用匯總表格。
建立與探索查詢完全相符的匯總資料表
如要確保匯總表格可用於探索查詢,其中一個方法是建立與探索查詢完全相符的匯總表格。如果「探索」查詢和匯總表格使用相同的測量指標、維度、篩選器、時區和其他參數,則匯總表格的結果會套用至「探索」查詢。如果匯總表格與探索查詢完全比對,Looker 就能使用包含任何類型測量指標的匯總表格。
您可以在「探索」的齒輪選單中,使用「取得 LookML」選項,從「探索」建立匯總表格。您也可以在資訊主頁的齒輪選單中,使用「Get LookML」選項,為資訊主頁中的所有圖塊建立完全比對。
判斷查詢使用的匯總表格
具備 see_sql 權限的使用者,可以在「探索」的「SQL」分頁中查看註解,瞭解查詢會使用哪個匯總表格。「SQL」分頁中的註解也會顯示在開發模式中,因此開發人員可以測試新的匯總資料表,瞭解 Looker 如何使用這些資料表,再將新資料表推送至實際工作環境。
舉例來說,根據先前顯示的每月匯總表格範例,您可以前往「探索」並執行查詢,取得年度銷售總額。接著,您可以點選「SQL」分頁標籤,查看 Looker 建立的查詢詳細資料。如果您處於開發模式,Looker 會顯示註解,指出用於查詢的匯總表格。
從「SQL」分頁中的下列註解,我們可以看到 Looker 正在使用 sales_monthly 匯總表格進行這項查詢,以及未將其他匯總表格用於查詢的原因:
-- use existing orders::sales_monthly in sandbox_scratch.LR$LB4151619827209021_orders$sales_monthly
-- Did not use orders::sales_weekly; it does not include the following fields in the query: orders.created_month
-- Did not use orders::sales_daily; orders::sales_monthly was a better fit for optimization.
-- Did not use orders::sales_last_3_days; contained filters not in the query: orders.created_date
請參閱本頁的「疑難排解」一節,瞭解「SQL」分頁中可能出現的註解,以及解決建議。
匯總感知功能的運算節省估算值
如果資料庫連線支援費用預估,且匯總表格可用於查詢,「探索」視窗會顯示使用匯總表格 (而非直接查詢資料庫) 所節省的運算費用。在「探索」中,執行查詢前,「執行」按鈕旁會顯示匯總感知節省量。
執行查詢前,如要查看查詢會使用哪個匯總表格,請按一下「SQL」分頁標籤,詳情請參閱本說明文件頁面的「判斷查詢使用的匯總表格」一節。
查詢執行後,「探索」視窗會在「執行」按鈕旁,顯示用於回答查詢的匯總資料表。
如果資料庫連線已啟用費用預估功能,系統會顯示匯總感知節省金額。詳情請參閱「在 Looker 中探索資料 」說明文件頁面。
Looker 會將新資料與匯總表格合併
如果匯總表格設有時間篩選器,Looker 可以將新資料聯集至匯總表格。您可能有一個匯總表格,其中包含過去三天的資料,但該匯總表格可能是在昨天建立。匯總表格會缺少當天的資訊,因此您不會預期使用該表格對最近的每日資訊進行探索查詢。
不過,Looker 仍可使用該匯總資料表中的資料執行查詢,因為 Looker 會對最新資料執行查詢,然後將這些結果與匯總資料表中的結果合併。
在下列情況下,Looker 可以將最新資料與匯總表格的資料合併:
- 匯總表格設有時間篩選器。
- 匯總表格包含一個維度,其時間欄位與時間篩選器相同。
舉例來說,下列匯總表格有一個以 orders.created_date 欄位為基礎的維度,以及一個以相同欄位為基礎的時間篩選器 ("3 days"):
aggregate_table: sales_last_3_days {
  query:  {
    dimensions: [orders.created_date]
    measures: [order_items.total_sales]
    filters: [orders.created_date: "3 days"]  # <-- time filter
    timezone: America/Los_Angeles
  }
  ...
}
如果這個匯總表格是昨天建立,Looker 會擷取尚未納入匯總表格的最新資料,然後將最新結果與匯總表格的結果合併。這表示使用者將取得最新資料,同時仍可使用匯總感知功能最佳化效能。
在開發模式下,您可以點選「探索」的「SQL」分頁標籤,查看 Looker 用於查詢的匯總表格,以及 Looker 用於匯入匯總表格未包含的新資料的 UNION 陳述式。
匯總表格必須保留
匯總表格必須保留在資料庫中,才能供匯總感知功能使用。持續性策略是在匯總表格的 materialization 參數中指定。匯總表格是一種永久衍生資料表 (PDT),因此兩者的需求條件相同。詳情請參閱「Looker 中的衍生資料表」說明文件頁面。
如果方言支援,您可以在專案中建立永久累加型衍生資料表。Looker 建構永久累加型衍生資料表時,會將新資料附加至資料表,而非重新建構整個資料表。由於匯總資料表本身也是一種 PDT,因此您也可以建立累加型匯總資料表。如要進一步瞭解永久累加型衍生資料表,請參閱永久累加型衍生資料表說明文件頁面。如需累加匯總表格的範例,請參閱 increment_key 參數說明文件頁面。
具備 develop 權限的使用者可以覆寫持續性設定,並重新建立查詢的所有匯總表格,取得最新資料。如要重建查詢的資料表,請在「探索動作」齒輪選單中,選取「重建衍生資料表並執行」選項。
必須等到「探索」查詢載入完成,才能使用這個選項。
「重建衍生資料表並執行」選項會重建查詢中參照的所有衍生資料表,以及查詢中資料表所依賴的任何衍生資料表。這包括匯總表格,其本身就是一種永久衍生資料表。
如果使用者啟動「重建衍生資料表並執行」選項,查詢會等待資料表重建完成,再載入結果。其他使用者的查詢仍會使用現有資料表。重建永久性資料表後,所有使用者都會使用重建的資料表。
如要進一步瞭解「重建衍生資料表並執行」選項,請參閱「Looker 中的衍生資料表」說明文件頁面。
疑難排解
如「判斷查詢使用的匯總表格」一節所述,如果您處於開發模式,可以在「探索」中執行查詢,然後點選「SQL」分頁標籤,查看查詢使用的匯總表格相關註解 (如有)。
如果查詢未使用匯總表格,「SQL」分頁也會包含相關註解。如果未使用匯總表格,註解開頭會是:
Did not use [explore name]::[aggregate table name];
舉例來說,以下註解說明為何在 order_items 探索中定義的 sales_daily 匯總表格未用於查詢:
-- Did not use order_items::sales_daily; query contained the following filters
that were neither included as fields nor exactly matched by filters in the aggregate table:
order_items.created_year.
在這個情況下,查詢中的篩選器會導致系統無法使用匯總表格。
下表列出無法使用匯總表格的其他可能原因,以及提高匯總表格可用性的步驟。
| 未使用匯總表格的原因 | 說明和可能步驟 |
|---|---|
| 探索中沒有這個欄位。 | LookML 驗證類型錯誤。這很可能是因為匯總表格未正確定義,或匯總表格的 LookML 有錯字。可能的原因是欄位名稱不正確等。如要解決這個問題,請確認匯總表格中的維度和測量指標與「探索」中的欄位名稱相符。如要進一步瞭解如何定義匯總表格,請參閱 aggregate_table 參數說明文件頁面。 |
| 匯總表格不含查詢中的下列欄位。 | 如要用於「探索」查詢,匯總表格必須包含該查詢所需的所有維度和測量指標,包括查詢中用於篩選器的欄位。如果「探索」查詢包含的維度或測量指標不在匯總表格中,Looker 就無法使用匯總表格,而會改用基礎資料表。詳情請參閱本頁的「欄位因素」一節。時間範圍維度是唯一的例外,因為較粗略的時間範圍可以從較精細的時間範圍衍生出來。如要解決這個問題,請確認探索查詢的欄位包含在匯總表格定義中。 |
| 查詢包含下列篩選器,但這些篩選器並未納入欄位,也與匯總表格中的篩選器不完全相符。 | 「探索」查詢中的篩選器會阻止 Looker 使用匯總表格。 如要解決這個問題,請採取下列任一做法:
|
| 查詢含有下列無法匯總的測量指標。 | 查詢包含一或多個匯總感知不支援的測量指標類型,例如不重複計數、中位數或百分位數。如要解決這個問題,請檢查查詢中各項測量指標的類型,確認屬於支援的測量指標類型。此外,如果探索包含彙整,請確認測量指標未透過展開彙整轉換為相異測量指標 (對稱式匯總函式)。如需說明,請參閱本頁的「探索與彙整的對稱式匯總函式」一節。 |
| 另一個匯總表格更適合最佳化。 | 查詢有多個可用的匯總表格,Looker 找到更合適的匯總表格。在這種情況下,您無須採取任何行動。 |
Looker 未執行任何分組 (因為 primary_key 或 cancel_grouping_fields 參數),因此無法匯總查詢。 |
查詢參照的維度會導致查詢無法包含 GROUP BY 子句,因此 Looker 無法使用任何匯總表格。
如要解決這個問題,請確認檢視表的 primary_key 參數和探索的 cancel_grouping_fields 參數設定正確。 |
| 匯總表格包含查詢中沒有的篩選器。 | 匯總表格含有查詢中沒有的非時間篩選器。如要解決這個問題,您可以從匯總表格中移除篩選器。詳情請參閱本頁的「篩選因素」一節。 |
在「探索」查詢中,某個欄位定義為篩選器限定欄位,但列在匯總表格的 dimensions 參數中。 |
匯總表格的 dimensions 參數列出的欄位,在「探索」查詢中僅定義為 filter 欄位。如要解決這個問題,請從匯總表格的 dimensions 清單中移除該欄位。如果匯總表格需要這個欄位,請將其新增至匯總表格查詢的 filters 清單。 |
| 最佳化工具無法判斷未使用匯總表格的原因。 | 這則註解僅適用於極端情況。如果經常使用的探索查詢出現這則訊息,您可以建立與探索查詢完全相符的匯總表格。您可以從「探索」取得匯總表格 LookML,詳情請參閱 aggregate_table 參數頁面。 |
注意事項
對稱式匯總函式,用於含彙整的探索
請注意,在彙整多個資料庫資料表的探索中,Looker 可將 SUM、COUNT 和 AVERAGE 類型的測量指標,分別轉譯為 SUM DISTINCT、COUNT DISTINCT 和 AVERAGE DISTINCT。Looker 這麼做是為了避免扇出誤算。舉例來說,count 測量指標會算做 count_distinct 測量指標類型。這是為了避免彙整時發生扇出錯誤計算,也是 Looker 對稱式匯總函式功能的一部分。如需 Looker 這項功能的說明,請參閱對稱式匯總函式的最佳做法頁面。
對稱式匯總函式功能可避免計算錯誤,但在某些情況下,也可能導致無法使用匯總表格,因此請務必瞭解這項功能。
對於匯總感知支援的測量指標類型,這適用於 sum、count 和 average。在下列情況下,Looker 會將這類測量指標算為 DISTINCT:
如需這些彙整類型的說明,請參閱 relationship 參數說明文件頁面。
如果發現匯總表格因這個原因而未啟用,您可以建立與探索查詢完全相符的匯總表格,以便在有彙整的探索中使用這些測量指標類型。詳情請參閱本頁的「建立與探索查詢完全相符的匯總表格」一節。
此外,如果 SQL 方言支援 HyperLogLog 草圖,您可以在測量指標中加入 allow_approximate_optimization: yes 參數。使用 allow_approximate_optimization: yes 定義計數測量指標時,Looker 可將該指標用於匯總感知,即使該指標會顯示為不重複計數也一樣。
如要瞭解詳情,以及哪些 SQL 方言支援 HyperLogLog 草圖,請參閱 allow_approximate_optimization 參數說明文件頁面。
匯總感知功能支援的方言
能否使用匯總感知功能,取決於 Looker 連線使用的資料庫方言。在最新版 Looker 中,下列方言支援匯總感知功能:
| 方言 | 是否支援? |
|---|---|
| Actian Avalanche | |
| Amazon Athena | |
| Amazon Aurora MySQL | |
| Amazon Redshift | |
| Amazon Redshift 2.1+ | |
| Amazon Redshift Serverless 2.1+ | |
| Apache Druid | |
| Apache Druid 0.13.x - 0.17.x | |
| Apache Druid 0.18+ | |
| Apache Hive 2.3+ | |
| Apache Hive 3.1.2+ | |
| Apache Spark 3+ | |
| ClickHouse | |
| ClickHouse 26+ | |
| Cloudera Impala 3.1+ | |
| Cloudera Impala 3.1+ with Native Driver | |
| Cloudera Impala with Native Driver | |
| DataVirtuality | |
| Databricks | |
| Denodo 7 | |
| Denodo 8 & 9 | |
| Dremio | |
| Dremio 11+ | |
| Dremio 26+ with Arrow Flight SQL | |
| Exasol | |
| Google BigQuery Legacy SQL | |
| Google BigQuery Standard SQL | |
| Google Cloud AlloyDB for PostgreSQL | |
| Google Cloud PostgreSQL | |
| Google Cloud SQL | |
| Google Spanner | |
| Greenplum | |
| HyperSQL | |
| IBM Netezza | |
| MariaDB | |
| Microsoft Azure PostgreSQL | |
| Microsoft Azure SQL Database | |
| Microsoft Azure Synapse Analytics | |
| Microsoft SQL Server 2008+ | |
| Microsoft SQL Server 2012+ | |
| Microsoft SQL Server 2016 | |
| Microsoft SQL Server 2017+ | |
| MongoBI | |
| MongoSQL | |
| MySQL | |
| MySQL 8.0.12+ | |
| Oracle | |
| Oracle ADWC | |
| PostgreSQL 9.5+ | |
| PostgreSQL pre-9.5 | |
| PrestoDB | |
| PrestoSQL | |
| SAP HANA | |
| SAP HANA 2+ | |
| SingleStore | |
| SingleStore 7+ | |
| Snowflake | |
| Teradata | |
| Trino | |
| Vector | |
| Vertica |
支援以方言逐步建構匯總表格
如要讓 Looker 支援 Looker 專案中的累加匯總表格,資料庫方言也必須支援這類表格。下表列出在最新版 Looker 中,支援 PDT 增量建構的方言:
| 方言 | 是否支援? |
|---|---|
| Actian Avalanche | |
| Amazon Athena | |
| Amazon Aurora MySQL | |
| Amazon Redshift | |
| Amazon Redshift 2.1+ | |
| Amazon Redshift Serverless 2.1+ | |
| Apache Druid | |
| Apache Druid 0.13.x - 0.17.x | |
| Apache Druid 0.18+ | |
| Apache Hive 2.3+ | |
| Apache Hive 3.1.2+ | |
| Apache Spark 3+ | |
| ClickHouse | |
| ClickHouse 26+ | |
| Cloudera Impala 3.1+ | |
| Cloudera Impala 3.1+ with Native Driver | |
| Cloudera Impala with Native Driver | |
| DataVirtuality | |
| Databricks | |
| Denodo 7 | |
| Denodo 8 & 9 | |
| Dremio | |
| Dremio 11+ | |
| Dremio 26+ with Arrow Flight SQL | |
| Exasol | |
| Google BigQuery Legacy SQL | |
| Google BigQuery Standard SQL | |
| Google Cloud AlloyDB for PostgreSQL | |
| Google Cloud PostgreSQL | |
| Google Cloud SQL | |
| Google Spanner | |
| Greenplum | |
| HyperSQL | |
| IBM Netezza | |
| MariaDB | |
| Microsoft Azure PostgreSQL | |
| Microsoft Azure SQL Database | |
| Microsoft Azure Synapse Analytics | |
| Microsoft SQL Server 2008+ | |
| Microsoft SQL Server 2012+ | |
| Microsoft SQL Server 2016 | |
| Microsoft SQL Server 2017+ | |
| MongoBI | |
| MongoSQL | |
| MySQL | |
| MySQL 8.0.12+ | |
| Oracle | |
| Oracle ADWC | |
| PostgreSQL 9.5+ | |
| PostgreSQL pre-9.5 | |
| PrestoDB | |
| PrestoSQL | |
| SAP HANA | |
| SAP HANA 2+ | |
| SingleStore | |
| SingleStore 7+ | |
| Snowflake | |
| Teradata | |
| Trino | |
| Vector | |
| Vertica |