


您可以使用動態資源分配 (DRA),將 GPU 分配給 Google Kubernetes Engine (GKE) 工作負載。本文說明 DRA 的基本概念、如何在 GKE 中使用 DRA,以及使用 DRA 的好處。
本文件適用於下列角色:
您應已熟悉下列項目:
DRA 簡介
DRA 是 Kubernetes 內建功能,可讓您在叢集中的 Pod 和容器之間,彈性要求、分配及共用硬體。 DRA 可讓裝置供應商和平台管理員宣告可要求及分配的裝置類別,進而改善分配附加硬體 (例如加速器) 的體驗。應用程式運算子可以在這些類別中要求特定裝置設定,然後在工作負載中要求這些設定。Kubernetes 和 GKE 會根據工作負載要求,管理 Pod 排程、節點指派和裝置分配。
例如,平台管理員可以定義僅含 NVIDIA A100 GPU 的裝置類別。應用程式營運商接著可以根據工作負載需求篩選該裝置類別中的裝置,例如篩選出 GPU 記憶體至少有 80 GB 的裝置。當應用程式操作員部署要求篩選設定的工作負載時,GKE 會將 Pod 放在符合所選條件的節點上。在這個範例中,GKE 會尋找具有可用 A100 (80 GB) GPU 的節點。應用程式操作員不需要在工作負載資訊清單中選取特定節點或裝置設定。
DRA 的優點
如果沒有 DRA,在 Kubernetes 中分配硬體裝置時,就必須仰賴裝置外掛程式。如要使用裝置外掛程式將硬體資源附加至 Pod,請使用節點標籤將 Pod 放在特定節點上。此外,如要將整個節點的資源專用於單一 Pod,請要求節點所連結的確切裝置數量。
使用 DRA 時,將裝置分配給 Pod 的方式與分配儲存空間磁碟區類似。您可以定義裝置類別、要求這些類別中的裝置,然後將要求的裝置指派給工作負載。DRA 提供更具擴充性的介面,可根據工作負載和業務需求篩選裝置。使用運算式和範本聲明硬體並排定 Pod 時間表的 DRA 方法具有下列優點:
- 宣告式裝置分配:平台管理員可以為特定類型的工作負載或團隊定義裝置設定。
- 降低跨團隊複雜度:平台管理員佈建具有特殊硬體設定的節點時,應用程式操作員不需要知道哪些節點具有特定設定。平台管理員不需要為節點加上標籤,也不必向操作人員傳達特定節點和裝置的相關資訊。
- 降低開發人員的複雜度:Kubernetes 會根據參照的裝置設定排定 Pod。應用程式操作員不需要在工作負載中選取特定節點,也不必確保每個 Pod 要求的裝置數量,與連接至這些節點的裝置數量完全相同。
- 集中管理基礎架構:平台管理員可以集中定義符合特定業務需求的硬體設定。舉例來說,平台管理員可以宣告具有 H100 GPU 的高效能設定,以及具有 Tesla T4 GPU 的小型推論設定。
- 彈性選取硬體:您可以使用 CEL 運算式篩選具有特定屬性的裝置。使用運算式可彈性篩選出最適合特定工作負載的裝置。
使用 DRA 的時機
在 GKE 中使用 DRA 的主要原因,是能彈性地為工作負載要求裝置。您只需編寫一次資訊清單,即可將工作負載部署至具有不同裝置類型的不同叢集,而不必變更資訊清單。這項彈性非常適合下列用途:
- 提升 GPU 彈性、效率和運算容量可用性:如果工作負載需要存取 GPU 硬體,您可以使用 DRA 要求叢集中的「任何」可用 GPU,不必指定 GPU 模型。如果這些工作負載有特定的 GPU 記憶體 (VRAM) 需求,您可以要求叢集中任何具有最低記憶體容量的 GPU。這類彈性要求可擴充工作負載可執行的 GPU 節點組合,降低因資源不足而無法排程工作負載的風險。
在資源調度期間,盡量確保節點可用性:工作負載所需的裝置數量可能會因裝置類型和功能等因素而異。您可以使用 GKE ComputeClasses,根據裝置可用性,將加速 Pod 放在特定節點集區。接著,您可以設定 Pod,在 GKE 將 Pod 放置於任何節點時,聲明裝置擁有權。
搭配使用 DRA 和 ComputeClasses,可盡量降低工作負載未排定的風險,並在最佳化硬體上執行工作負載。
術語
開放原始碼 Kubernetes 和 GKE 等代管 Kubernetes 供應商,會使用下列核心 DRA API 種類:
- ResourceSlice
- ResourceSlice 會列出叢集內一或多個節點可存取的硬體裝置。 舉例來說,在可存取單一 GPU 的節點中,ResourceSlice 會列出 GPU 和節點名稱。每個節點上的 DRA 裝置驅動程式都會建立 ResourceSlice。Kubernetes 排程器會使用 ResourceSlice,決定要分配哪些裝置來滿足工作負載要求。
- DeviceClass
-
DeviceClass 定義了可供工作負載要求的裝置類別,例如 GPU。
部分裝置驅動程式提供內建的 DeviceClass,例如
gpu.nvidia.comNVIDIA GPU 的 DeviceClass。平台管理員也可以建立自訂 DeviceClass,定義特定裝置設定。 - ResourceClaim
-
Pod 或使用者可透過 ResourceClaim,依據 DeviceClass 中的特定參數篩選硬體資源。 當工作負載參照 ResourceClaim 時,Kubernetes 會將符合指定參數的裝置指派給該 ResourceClaim。
舉例來說,假設您為一個 A100 (40 GB) GPU 建立 ResourceClaim,然後部署選取該 ResourceClaim 的工作負載。Kubernetes 會將可用的 A100 (40 GB) GPU 指派給 ResourceClaim,並將 Pod 排程至可存取該 GPU 的節點。
- ResourceClaimTemplate
-
ResourceClaimTemplate 定義 Pod 可用來自動建立每個 Pod 的新 ResourceClaim 的範本。當多個工作負載需要存取類似的裝置設定時,ResourceClaimTemplates 就非常實用,特別是使用 Deployments 或 StatefulSets 等工作負載控制器時。
應用程式運作人員會部署 ResourceClaimTemplates,然後在工作負載中參照範本。Kubernetes 會根據指定的範本為每個 Pod 建立 ResourceClaim、分配裝置,並排定 Pod 的時間。Pod 終止時,Kubernetes 會清除對應的 ResourceClaim。
如要進一步瞭解 DRA API 種類,請參閱「DRA 術語」。
DRA 的運作方式
在叢集和工作負載中使用 DRA 的程序,與使用 StorageClass、PersistentVolumeClaim 和 PersistentVolume 為 Pod 動態佈建磁碟區類似。
下圖顯示叢集管理員和應用程式操作員使用 DRA 分配裝置的步驟:
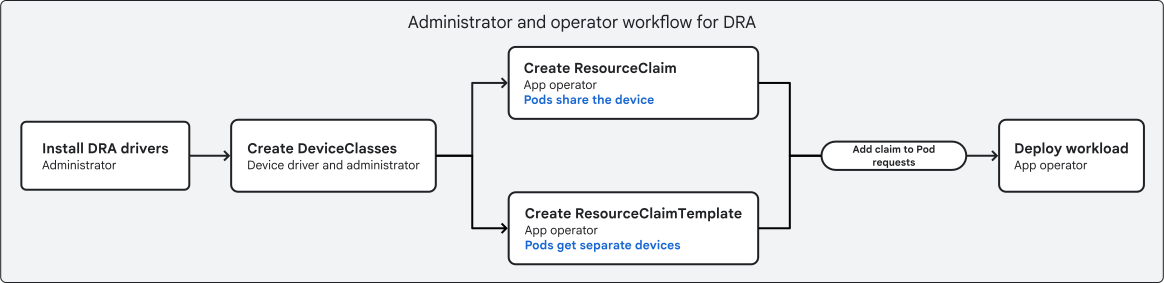
在這張圖表中,叢集管理員和應用程式操作員會執行下列操作:
- 叢集管理員會在節點中安裝支援 DRA 的裝置驅動程式。
- 叢集管理員會建立 DeviceClass,篩選出符合特定需求的硬體,例如記憶體超過 40 GB 的所有 GPU。部分裝置可能也包含內建的 DeviceClass。
- 應用程式操作員會建立 ResourceClaimTemplates 或 ResourceClaims,要求裝置設定。各類型聲明的主要用途如下:
- ResourceClaim 可讓多個 Pod 共用同一部裝置。
- ResourceClaimTemplate 會自動產生各 Pod 的 ResourceClaim,讓多個 Pod 存取不同的類似裝置。
- 應用程式運算子會將 ResourceClaimTemplates 或 ResourceClaims 新增至工作負載資訊清單。
- 應用程式操作員部署工作負載。
部署參照 ResourceClaimTemplate 或 ResourceClaim 的工作負載時,Kubernetes 會執行下列排程步驟:
- 如果工作負載參照 ResourceClaimTemplate,Kubernetes 會為每個工作負載執行個體建立新的
ResourceClaim物件 (例如 Deployment 中的每個副本)。 - Kubernetes 排程器會使用叢集中的 ResourceSlice,將可用的合格裝置分配給每個 Pod 的 ResourceClaim。
- 排程器會將每個 Pod 放在可存取裝置的節點上,這些裝置已分配給 Pod 的 ResourceClaim。
- 目的地節點上的
kubelet會呼叫節點上的 DRA 驅動程式,將分配的硬體附加至 Pod,以滿足其資源要求。
ResourceClaim 和 ResourceClaimTemplate 的使用時機
您可以使用 ResourceClaims 或 ResourceClaimTemplates,向 Kubernetes 指出您需要符合特定條件的裝置。當 Pod 參照 ResourceClaim 時,Kubernetes 會將裝置分配給 Kubernetes API 伺服器中對應的 ResourceClaim API 資源。無論您是否已建立 ResourceClaim,或 Kubernetes 是否從 ResourceClaimTemplate 建立 ResourceClaim,都會發生這種分配情形。
如果您建立 ResourceClaim,然後在多個 Pod 中參照該 ResourceClaim,則所有這些 Pod 都可以存取 Kubernetes 為該 ResourceClaim 分配的裝置。舉例來說,如果您在具有多個副本的 Deployment 資訊清單中參照特定 ResourceClaim,就可能發生這種共用存取權的情況。不過,如果分配的裝置未設定為可供多個程序共用,跨 Pod 共用裝置存取權可能會導致非預期的行為。
如要為 Pod 分配獨立裝置,可以使用 ResourceClaimTemplate,這是 Kubernetes 用來自動建立個別 ResourceClaim 的範本。舉例來說,如果您在具有多個副本的 Deployment 中參照 ResourceClaimTemplate,Kubernetes 會為每個複製的 Pod 建立個別的 ResourceClaim。因此,每個 Pod 都會取得自己的已分配裝置,而非與其他 Pod 共用裝置存取權。這些自動生成 ResourceClaim 會繫結至對應 Pod 的生命週期,並在 Pod 終止時刪除。如果獨立 Pod 需要存取類似的裝置設定,請使用 ResourceClaimTemplate,分別為每個 Pod 分配裝置。
下表說明手動建立 ResourceClaim,以及讓 Kubernetes 透過 ResourceClaimTemplate 建立 ResourceClaim 的差異:
| 手動建立的 ResourceClaim | 自動建立的 ResourceClaim |
|---|---|
| 由您管理 | 由 Kubernetes 管理 |
| 從多個 Pod 存取相同裝置 | 可從單一 Pod 存取裝置 |
| 獨立於 Pod 之外,存在於叢集中 | 繫結至對應 Pod 的生命週期 |
| 適合需要共用特定裝置的多個工作負載 | 適合需要獨立裝置存取權的多項工作負載 |
DRA 與手動分配裝置的比較
DRA 可讓您以類似動態佈建 PersistentVolume 的方式,分配連接的裝置。Kubernetes 也支援使用裝置外掛程式分配裝置。這個方法包含下列步驟:
- 叢集管理員會建立附加裝置 (例如 GPU) 的節點。
- 叢集管理員會將特定節點及其附加裝置的相關資訊,傳達給工作負載操作人員。
- 工作負載運算子會在工作負載資訊清單中要求裝置,如下所示:
- 使用
nodeSelector欄位,選取具有所需裝置設定 (例如 GPU 模型) 的節點。 - 在 Pod 規格中使用
resources欄位,指定容器要使用的確切裝置數量。
- 使用
這種手動分配方法需要應用程式運算子和叢集管理員溝通,瞭解哪些特定節點或節點集區具有特定裝置設定。他們必須協調工作負載要求,以符合節點上的裝置,否則部署作業會失敗。相較之下,DRA 可讓您使用運算式,根據屬性彈性篩選裝置,且工作負載運算子不需要知道叢集中節點的確切設定。
下表比較 DRA 與裝置外掛程式:
| DRA | 手動分配 |
|---|---|
| 使用 CEL 運算式彈性選取裝置 | 使用選取器和資源要求選取特定節點 |
| Kubernetes 決定的排程 | 運算子使用節點選取器排定決策 |
| 裝置篩選功能與工作負載建立作業分開 | 裝置篩選作業必須在工作負載資訊清單中完成 |
| 由平台管理員集中管理裝置篩選和需求導向類別 | 使用應用程式運算子篩選隔離裝置 |
| 應用程式操作員不需要知道節點容量、節點標籤資訊,或每個節點的附加裝置型號 | 應用程式營運商必須知道哪些節點有特定型號,以及連接特定裝置的數量。 |
DRA 和基礎架構自動調度資源
如要自動調整 Standard 模式節點集區中的節點數量,請使用叢集自動配置器。您可以在任何手動建立的節點集區中啟用叢集自動配置器,包括具有 DRA 驅動程式的節點集區。
對於使用 DRA 的節點集區,裝置使用率會影響叢集自動配置器在節點集區中新增及移除節點的方式。為計算節點集區中的裝置使用率,叢集自動配置器會考量下列因素:
- 資源集區中的所有裝置都必須位於特定節點本機。如果 ResourceSlice 擁有一組附加至多個節點的裝置,叢集自動配置器會忽略這些裝置。
- 節點集區中的所有裝置都一樣重要,而且完全相同。
- DRA 裝置的優先順序高於 CPU 或記憶體。在 DRA 節點集區中,叢集自動配置器會忽略 CPU 和記憶體用量。
因此,DRA 節點集區的縮減行為可能與其他節點集區不同。
支援 DRA 的 GKE 裝置
下表說明在 GKE 中,可透過 DRA 分配給工作負載的裝置:
| 支援 DRA 的裝置 | |
|---|---|
| GPU | 您所在地區提供的任何 GPU 類型。詳情請參閱「GPU 位置」。 |
| 網路介面 | 安裝代管 DRANET 驅動程式,即可使用多種網路介面,例如支援 RDMA 的介面。詳情請參閱「使用 GKE 代管的 DRANET 分配網路資源」。 |
限制
使用 DRA 時,請注意下列限制:
作業模式:DRA 僅適用於標準模式叢集。
加速器類型:GKE 中的 DRA 僅支援 GPU。
GPU:
- 您無法使用分時 GPU、多實體 GPU 或多程序服務 (MPS)。
- 如果節點使用 DRA GPU 驅動程式,您就無法透過代管的 NVIDIA Data Center GPU Manager (DCGM) 指標套件,將 DCGM 指標傳送至 Cloud Monitoring。
- DRA 的 GPU 驅動程式由 NVIDIA 擁有,而非 GKE。詳情請參閱 NVIDIA 說明文件。
網路介面: 請參閱「使用 GKE 管理的 DRANET 分配網路資源」一文中的「限制」。
自動調度資源:
- 對於您安裝的第三方 DRA 驅動程式,叢集自動配置器會要求節點集區至少有一個節點。為避免使用第三方驅動程式的節點集區縮減至零個節點,請將節點數量下限設為至少
1。 - 叢集自動配置器可能無法與第三方 DRA 驅動程式正常運作。如果使用第三方驅動程式,請確認驅動程式只會發布特定節點本機裝置的資訊。
- 對於使用靜態 ResourceClaim 在 Pod 之間共用裝置存取權的自動調度資源節點集區中的 DaemonSet,自動調度資源最多支援 128 個 DaemonSet Pod。如要避開這項限制,請採取下列任一做法:
- 設定節點數量上限,防止節點集區擴充至超過 128 個節點。
- 使用 ResourceClaim 中的
adminAccess欄位 (Beta 版),讓 DaemonSet 存取使用中的裝置。
- 如果 Pod 參照 ResourceClaim,且 PriorityClass 將先占政策設為
PreemptLowerPriority,自動調度資源延遲時間可能會增加。PreemptLowerPriority是 PriorityClass 的預設先占政策,因此請務必在 PriorityClass 中將preemptionPolicy欄位明確設為Never。詳情請參閱「非先占 PriorityClass」。
- 對於您安裝的第三方 DRA 驅動程式,叢集自動配置器會要求節點集區至少有一個節點。為避免使用第三方驅動程式的節點集區縮減至零個節點,請將節點數量下限設為至少
瞭解及使用 DRA 的建議技能
本節提供建議,協助平台管理員或應用程式操作員使用 DRA 將裝置分配給工作負載。DRA 大幅改變了在 GKE 和 Kubernetes 中要求附加裝置的方法。如要運用更進階的用途,例如跨裝置備用方案或精細的裝置篩選和選取功能,請參考下列指南:
瞭解 CEL:使用 DRA 時,您可以在資源分配要求和 DeviceClass 中,透過 CEL 運算式執行精細的裝置篩選。下列資源或許有助於學習 CEL:
瞭解 GKE 中的 ComputeClass:您可以搭配 DRA 使用 ComputeClass,滿足業務需求,例如佈建 Spot VM 來執行要求高成本效益 GPU 的推論工作負載。下列資源可協助您瞭解 ComputeClasses: