


In diesem Leitfaden wird gezeigt, wie Sie die Speicheranforderungen Ihrer Cloud-Arbeitslast ermitteln, wie die verfügbaren Speicheroptionen in Google Cloudgenutzt werden können und wie Sie eine Speicherstrategie für einen optimalen technischen und geschäftlichen Wert entwickeln.
Informationen zum Auswählen von Speicherdiensten für KI- und ML-Arbeitslasten finden Sie unter Übersicht über Speicherdienste für KI- und ML-Arbeitslasten in AI Hypercomputer.
Übersicht über den Designprozess
Wenn Sie als Cloud-Architekt den Speicher für eine Cloud-Arbeitslast planen, müssen Sie zuerst die funktionalen Eigenschaften der Arbeitslast, Sicherheitseinschränkungen, Anforderungen an die Ausfallsicherheit, Leistungserwartungen und Kostenziele berücksichtigen. Als Nächstes müssen Sie die verfügbaren Speicherdienste und -funktionen inGoogle Cloudprüfen. Schließlich wählen Sie je nach Ihren Anforderungen und den verfügbaren Optionen die benötigten Speicherdienste und -Features aus. Das folgende Diagramm zeigt diesen dreistufigen Prozess:
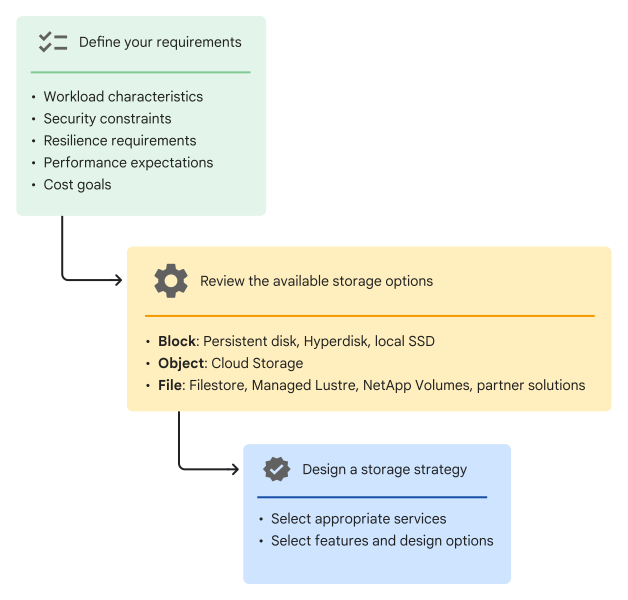
Anforderungen definieren
Verwenden Sie die Fragebögen in diesem Abschnitt, um die wichtigsten Speicheranforderungen der Arbeitslast zu definieren, die Sie in Google Cloudbereitstellen möchten.
Richtlinien für das Definieren von Speicheranforderungen
Beim Beantworten der Fragebögen sind folgende Leitlinien zu beachten:
Anforderungen detailliert definieren
Wenn Ihre Anwendung beispielsweise NFS-basierten Dateispeicher (Network File System) benötigt, ermitteln Sie die erforderliche NFS-Version.
Künftige Anforderungen berücksichtigen
Beispielsweise kann es sein, dass eine aktuelle Bereitstellung für Nutzer in asiatischen Ländern später auf Unternehmen anderer Kontinente ausgeweitet werden soll. In diesem Fall sollten Sie bereits alle speicherbezogenen behördlichen Anforderungen der neuen Geschäftsgebiete berücksichtigen.
Cloudspezifische Möglichkeiten und Anforderungen berücksichtigen
Nutzen Sie die cloudspezifischen Möglichkeiten.
Zur Optimierung der Speicherkosten für in Cloud Storage gespeicherte Daten können Sie beispielsweise die Speicherdauer mithilfe von Datenaufbewahrungsrichtlinien und Lebenszykluskonfigurationen steuern.
Berücksichtigen Sie cloudspezifische Anforderungen.
Beispielsweise können die lokalen Daten in einem einzelnen Rechenzentrum vorhanden sein und Sie müssen die migrierten Daten möglicherweise aus Redundanzgründen an zweiGoogle Cloud -Standorten replizieren.
Fragebögen
Die folgenden Fragebögen sind nicht als fertige Checklisten für die Planung zu verstehen. Verwenden Sie sie als Ausgangspunkt, um alle Speicheranforderungen der Arbeitslast, die Sie in Google Cloudbereitstellen möchten, systematisch zu analysieren.
Eigenschaften der Arbeitslast bewerten
Welche Art von Daten müssen Sie speichern?
Beispiele
- Inhalt der statischen Website
- Sicherungen und Archive zur Notfallwiederherstellung
- Audit-Logs für die Compliance
- Große Datenobjekte, die Nutzer direkt herunterladen
- Transaktionsdaten
- Unstrukturierte und heterogene Daten
Wie viel Kapazität benötigen Sie? Berücksichtigen Sie Ihre aktuellen und zukünftigen Anforderungen.
Soll die Kapazität mit der Nutzung automatisch skaliert werden?
Welche Zugriffsanforderungen gelten? Sollten die Daten beispielsweise von außerhalb von Google Cloudzugänglich sein?
Was sind die erwarteten Lese-/Schreibmuster?
Beispiele
- Häufige Schreib- und Lesevorgänge
- Häufige Schreibvorgänge, aber gelegentliche Lesevorgänge
- Gelegentliche Schreib- und Lesevorgänge
- Gelegentliche Schreibvorgänge, aber häufige Lesevorgänge
Erfordert die Arbeitslast dateibasierten Zugriff, zum Beispiel mit NFS?
Sollen mehrere Clients gleichzeitig Daten lesen oder schreiben?
Sicherheitsbeschränkungen ermitteln
Welche Anforderungen gelten für die Datenverschlüsselung? Verwenden Sie beispielsweise Schlüssel, die Sie selbst steuern?
Gibt es Anforderungen an die Datenausfallsicherheit?
Anforderungen an die Datenausfallsicherheit definieren
- Benötigt Ihre Arbeitslast Caching oder temporären Speicher mit niedriger Latenz?
- Müssen Sie die Daten in der Cloud aus Gründen der Redundanz replizieren?
- Benötigen Sie strikte Lese-/Schreibkonsistenz für replizierte Datasets?
Leistungserwartungen festlegen
Wie hoch ist der erforderliche E/A-Rate?
Welchen Grad an Lese- und Schreibdurchsatz benötigt Ihre Anwendung?
Für welche Umgebungen ist Speicher erforderlich? Für eine bestimmte Arbeitslast benötigen Sie möglicherweise einen Hochleistungsspeicher für die Produktionsumgebung, können aber für die Nicht-Produktionsumgebung eine Option mit geringerer Leistung auswählen.
Speicheroptionen prüfen
Google Cloud bietet Speicherdienste für alle wichtigen Speicherformate: Block, Datei und Objekt. Prüfen Sie die Features, Designoptionen und relativen Vorteile der Dienste für jedes Speicherformat und evaluieren Sie sie.
Übersicht
Blockspeicher
Die Daten, die Sie im Blockspeicher speichern, werden in Einheiten unterteilt, die als jeweils separater Block mit einer eindeutigen Adresse gespeichert werden. Anwendungen greifen dann auf Daten durch Verweis auf die entsprechenden Blockadressen zu. Der Blockspeicher ist für Arbeitslasten mit hoher IOPS-Anzahl, z. B. für die Transaktionsverarbeitung, optimiert. Er ist mit dem lokalen Storage Area Network (SAN) und DAS-Systemen (Directly Attached Storage) vergleichbar.
Die Blockspeicheroptionen in Google Cloud sind Teil des Compute Engine-Dienstes.
| Option | Überblick |
|---|---|
| Persistent Disk | Dedizierte Festplattenlaufwerke (HDDs) und Solid-State-Laufwerke (SSDs) für Unternehmens- und Datenbankanwendungen, die in Compute Engine-VMs und Google Kubernetes Engine-Clustern (GKE) bereitgestellt werden. |
| Google Cloud-Hyperdisk | Schneller und redundanter Netzwerkspeicher für Compute Engine-VMs und GKE-Cluster mit dynamisch erweiterbarer Kapazität und konfigurierbarer Leistung. |
| Local SSD | Sitzungsspezifischer, lokal angehängter Blockspeicher für Hochleistungsanwendungen. |
Dateispeicher
Daten werden wie bei einem lokalen NAS-Speicher (Network Attached Storage) in einer Hierarchie von Dateien organisiert und dargestellt. Dateisysteme können auf Clients mit Protokollen wie NFS und Server Message Block (SMB) bereitgestellt werden. Anwendungen greifen dabei über den entsprechenden Dateinamen und den Verzeichnispfad auf Daten zu.
Google Cloud bietet eine Reihe vollständig verwalteter Lösungen für die Dateispeicherung.
| Lösung | Übersicht |
|---|---|
| Filestore |
Dateibasierter Speicher mit NFS-Dateiservern für Compute Engine-VMs und GKE-Cluster. |
| Google Cloud Managed Lustre |
Paralleles Dateisystem mit niedriger Latenz für KI, Hochleistungs-Computing (HPC) und datenintensive Anwendungen. |
| Google Cloud NetApp Volumes | Dateibasierter Speicher mit NFS-, SMB- oder Blockspeicherprotokollen. |
Objektspeicher
Die Daten werden als Objekte in einer flachen Hierarchie von Buckets gespeichert. Jedem Objekt wird eine global eindeutige ID zugewiesen. Objekte können vom System zugewiesene sowie benutzerdefinierte Metadaten haben, mit denen sich Daten organisieren und verwalten lassen. Anwendungen greifen auf Daten mithilfe von REST APIs oder Clientbibliotheken über den Verweis auf Objekt-IDs zu.
Cloud Storage bietet einen kostengünstigen, hochverfügbaren und hochskalierbaren Objektspeicher für verschiedene Datentypen. Die in Cloud Storage gespeicherten Daten können von jedem Standort innerhalb und außerhalb von Google Cloudaufgerufen werden. Die optionale Redundanz über Regionen hinweg sorgt für Hochverfügbarkeit und Zuverlässigkeit. Sie können die Speicherklasse auswählen, die Ihren Anforderungen an die Datenaufbewahrung und die Zugriffshäufigkeit entspricht.
Vergleichsanalyse
In der folgenden Tabelle sind die wichtigsten Funktionen der Speicherdienste inGoogle Cloudaufgeführt.
| Persistent Disk | Hyperdisk | Lokale SSD | Filestore | Managed Lustre | NetApp Volumes | Cloud Storage | |
|---|---|---|---|---|---|---|---|
| Kapazitätslimit |
64 TiB pro Laufwerk und 257 TiB pro VM. Aktuelle Spezifikationen: Dokumentation zu Persistent Disk |
64 TiB pro Laufwerk, 512 TiB pro VM und 5 PiB pro Speicherpool. Google Cloud Hyperdisk Exapools sind Hyperdisk-Pools mit höherer Kapazität. Aktuelle Spezifikationen: Hyperdisk-Dokumentation |
375 GiB pro Laufwerk und 12.000 GiB pro VM. Titanium SSD-Laufwerke unterstützen bis zu 6 TiB pro Laufwerk und 84.000 GiB pro VM. Aktuelle Spezifikationen: Dokumentation zu lokalen SSDs |
100 TiB pro Instanz, je nach Dienststufe. | 80,1 PiB pro Instanz, je nach Leistungsstufe. |
20 PiB pro Speicherpool und 20 PiB pro Volume. Aktuelle Spezifikationen: NetApp Volumes-Dokumentation |
5 TiB pro Objekt, ohne Limit pro Bucket (außer Rapid Bucket). Aktuelle Spezifikationen: Cloud Storage-Dokumentation |
|
Skalierung |
|
|
Nicht skalierbar | Hoch- und Herunterskalieren (zonale und regionale Stufen) | Hochskalieren | Hoch- und Herunterskalieren | Automatische Skalierung nach Nutzung |
| Freigabe |
Unterstützt | Unterstützt | Kann nicht freigegeben werden | Kann auf mehreren Compute Engine-VMs, Remote-Clients und GKE-Clustern bereitgestellt werden | Kann auf mehreren Compute Engine-VMs und in mehreren GKE-Clustern bereitgestellt werden | Kann auf mehreren Compute Engine-VMs, Remote-Clients und GKE-Clustern bereitgestellt werden |
|
| Optionen für Verschlüsselungsschlüssel |
|
|
Google-owned and Google-managed encryption keys |
|
|
|
|
| Persistenz |
Lebensdauer des Laufwerks | Lebensdauer des Laufwerks | Sitzungsspezifisch (Daten gehen verloren, wenn die VM beendet oder gelöscht wird) | Lebensdauer der Filestore-Instanz | Lebensdauer der Managed Lustre-Instanz | Lebensdauer des Volumes | Lebensdauer des Buckets |
| Verfügbarkeit |
|
|
Zonal |
|
Zonal |
|
|
| Leistung |
Lineare Skalierung anhand der Laufwerksgröße und der CPU-Anzahl | Nichtflüchtiger Speicher mit dynamischer Skalierung | Scratch-Hochleistungsspeicher | Zonal und regional: Benutzerdefinierte Leistung | Skalierung basierend auf der ausgewählten Leistungsstufe. | Skalierbare Leistung Erwartungen hängen vom Service Level ab. |
|
| Verwaltung |
Manuell formatieren und bereitstellen | Manuell formatieren und bereitstellen | Manuell formatieren, streifen und bereitstellen | Vollständig verwaltet | Vollständig verwaltet | Vollständig verwaltet | Vollständig verwaltet |
In der folgenden Tabelle sind die Arbeitslasttypen aufgeführt, für die die einzelnen Speicheroptionen von Google Cloudgeeignet sind:
| Speicheroption | Arbeitslasttypen |
|---|---|
| Hyperdisk oder Persistent Disk |
|
| Lokale SSD |
|
| Filestore |
|
| Managed Lustre |
|
| NetApp Volumes |
|
| Cloud Storage |
|
Speicheroption auswählen
Für das Auswählen einer Speicheroption sind zwei Schritte erforderlich:
- Sie ermitteln, welche Speicherdienste Sie benötigen.
- Sie wählen die erforderlichen Features und Designoptionen in einem bestimmten Dienst aus.
Beispiele für dienstspezifische Features und Designoptionen
Persistent Disk
- Region und Zone der Bereitstellung
- Regionale Replikation
- Typ, Größe und IOPS des Laufwerks (für extrem nichtflüchtige Speicher)
- Verschlüsselungsschlüssel: Google-owned and Google-managed encryption keysoder kundenverwaltet
- Zeitplan für Snapshots
Hyperdisk
- Region und Zone der Bereitstellung
- Typ, Größe und bereitgestellte IOPS oder Durchsatz des Laufwerks
- Verschlüsselungsschlüssel: Google-owned and Google-managed encryption keysoder kundenverwaltet
- Replikation: synchron oder asynchron
- Zeitplan für Snapshots
Filestore
- Region und Zone der Bereitstellung
- Instanzstufe
- Kapazität
- IP-Bereich: automatisch zugewiesen oder benutzerdefiniert
- Zugriffssteuerung
Managed Lustre
- Bereitstellungszone
- Kapazitäts- und Leistungsstufe
- Verschlüsselungsschlüssel: Google-owned and Google-managed encryption keysoder kundenverwaltet
NetApp Volumes
- Bereitstellungsregion
- Service Level für den Speicherpool
- Pool- und Volume-Kapazität
- Volume-Protokoll
- Regeln für den Volume-Export
Cloud Storage
- Standort: multiregional, Dual-Region, einzelne Region, einzelne Zone
- Speicherklasse: Standard, Nearline, Coldline, Archive oder Rapid
- Zugriffssteuerung: einheitlich oder detailliert
- Verschlüsselungsschlüssel: Google-owned and Google-managed encryption keys, kundenverwaltet oder vom Kunden bereitgestellt
- Aufbewahrungsrichtlinien
Speicherempfehlungen
Verwenden Sie die folgenden Empfehlungen als Ausgangspunkt für die Auswahl der Speicherdienste und Features, die Ihren Anforderungen entsprechen. Anleitungen speziell für KI- und ML-Arbeitslasten finden Sie unter Übersicht über Speicherdienste für KI- und ML-Arbeitslasten in AI Hypercomputer.
Verwenden Sie für KI-, ML- und HPC-Anwendungen, die ein paralleles Dateisystem benötigen, Managed Lustre.
Wählen Sie für Anwendungen, die dateibasierten Zugriff benötigen, basierend auf Ihren Anforderungen für Zugriffsprotokoll, Verfügbarkeit und Leistung einen geeigneten Dateispeicherdienst aus.
Zugriffsprotokoll Empfehlung NFS - Wenn Sie regionale Verfügbarkeit und konfigurierbare hohe Leistung benötigen, verwenden Sie Filestore Regional oder NetApp Volumes Flex Unified.
- Wenn zonale Verfügbarkeit ausreicht:
- Wenn Sie die Leistung unabhängig von der Kapazität konfigurieren möchten, verwenden Sie Filestore Zonal oder NetApp Volumes Flex Unified.
- Wenn Sie eine Leistung benötigen, die mit der Kapazität skaliert, verwenden Sie Filestore Zonal oder NetApp Volumes Standard, Premium oder Extreme.
Weitere Informationen finden Sie unter Filestore-Dienststufen und NetApp Volumes-Dienststufen.
KMU Verwenden Sie NetApp Volumes. Verwenden Sie für Arbeitslasten, die primären Speicher mit hoher Leistung benötigen, je nach Ihren Anforderungen Hyperdisk, lokale SSDs oder Persistent Disk.
Anforderung Empfehlung Schnelle Scratch Disk oder Cache Verwenden Sie lokale SSD-Laufwerke (sitzungsspezifisch). Blockspeicher mit unabhängig skalierbarer Leistung und Kapazität Verwenden Sie Hyperdisk, den von Google empfohlenen langlebigen Blockspeicher, der für die neuesten Maschinenserien erforderlich ist. Wählen Sie einen geeigneten Laufwerkstyp entsprechend Ihren Anforderungen aus:
- Arbeitslasten für allgemeine Zwecke:
hyperdisk-balanced - Arbeitslasten mit hohem E/A-Wert, z. B. Hochleistungsdatenbanken:
hyperdisk-extreme - Analysen mit horizontaler Skalierung, Datenlaufwerke für kostenempfindliche Anwendungen und kalter Speicher:
hyperdisk-throughput - ML-Arbeitslasten, die einen hohen Durchsatz für mehrere VMs im Lesemodus erfordern:
hyperdisk-mlim Lesemodus - Mehrere VMs mit gleichzeitigem Schreibzugriff auf dasselbe Laufwerk:
hyperdisk-balanced-high-availability(über zwei Zonen in einer Region) oderhyperdisk-balancedoderhyperdisk-extreme(innerhalb einer einzelnen Zone) im Modus für mehrere Autoren
Weitere Informationen finden Sie unter Informationen zu Hyperdisk.
Blockspeicher mit skalierbarer Kapazität für VMs älterer Generationen Verwenden Sie Persistent Disk. Wählen Sie einen geeigneten Laufwerkstyp entsprechend Ihren Anforderungen aus:
- Sequenzielle IOPS:
pd-standard - IOPS-intensive Arbeitslasten:
pd-extremeoderpd-ssd - Ausgewogenheit zwischen Leistung und Kosten:
pd-balanced
Weitere Informationen finden Sie unter Nichtflüchtiger Speicher.
- Wählen Sie je nach Redundanzanforderungen zwischen zonalen und regionalen Laufwerken aus.
Anforderung Empfehlung Redundanz innerhalb einer einzelnen Zone in einer Region Verwenden Sie Hyperdisk oder zonale Persistent Disks. Redundanz für mehrere Zonen innerhalb einer Region Verwenden Sie Google Cloud Hyperdisk Balanced High Availability oder regionale Persistent Disks.
- Arbeitslasten für allgemeine Zwecke:
Verwenden Sie Cloud Storage, wenn Sie einen großen, global verfügbaren Speicher benötigen.
Wählen Sie je nach Datenzugriffshäufigkeit und Speicherdauer eine geeignete Cloud Storage-Klasse aus.
Anforderung Empfehlung Die Zugriffshäufigkeit variiert oder die Datenaufbewahrungsdauer ist unbekannt oder ist nicht vorhersehbar. Verwenden Sie das Feature Autoclass, um Objekte in einem Bucket basierend auf dem Zugriffsmuster jedes Objekts automatisch auf die entsprechenden Speicherklassen zu übertragen. Zonaler Speicher für Arbeitslasten, die eine Latenz von weniger als einer Millisekunde und einen hohen Durchsatz erfordern, z. B. KI- und ML-Training, Prüfpunkte, Inferenz und Analysen. Verwenden Sie einen Rapid-Bucket mit der Speicherklasse Rapid. Speicher für Daten, auf die häufig zugegriffen wird, z. B. für Datenanalysen mit hohem Durchsatz, Data Lakes, Websites, gestreamte Videos und mobile Apps. Verwenden Sie die Speicherklasse Standard.
Verwenden Sie Cloud CDN, um häufig aufgerufene Daten im Cache zu speichern und von Standorten aus bereitzustellen, die sich in der Nähe der Clients befinden.
Bei leselastigen Arbeitslasten mit seltenen Datenänderungen und häufigen Lesevorgängen (z. B. ML-Training, Inferenz und Analysen) können Sie die Leseleistung verbessern und die Kosten für die Datenübertragung senken, indem Sie Rapid Cache verwenden.
Kostengünstiger Speicher für selten aufgerufene Daten, die mindestens 30 Tage gespeichert werden können, z. B. Sicherungen und Longtail-Multimedia-Inhalte. Verwenden Sie die Speicherklasse Nearline. Kostengünstiger Speicher für selten aufgerufene Daten, die mindestens 90 Tage gespeichert werden können, z. B. für die Notfallwiederherstellung. Verwenden Sie die Speicherklasse Coldline. Kostengünstigster Speicher für selten aufgerufene Daten, die mindestens 365 Tage gespeichert werden können, z. B. für zur Einhaltung behördlicher Auflagen angelegte Archive. Verwenden Sie die Speicherklasse Archive. Eine detaillierte Vergleichsanalyse finden Sie unter Cloud Storage-Klassen.
Datenübertragungsoptionen
Nachdem Sie die entsprechenden Google Cloud -Speicherdienste ausgewählt haben, müssen Sie Ihre Daten zu Google Cloudübertragen, um Arbeitslasten bereitzustellen und auszuführen. Die zu übertragenden Daten können lokal oder auf anderen Cloud-Plattformen vorhanden sein.
Sie können die folgenden Methoden verwenden, um Daten an Google Cloudzu übertragen:
- Daten online übertragen mit Storage Transfer Service: Automatisieren Sie die Übertragung großer Datenmengen zwischen Objekt- und Dateispeichersystemen, einschließlich Cloud Storage, Amazon S3, Azure-Speicherdiensten und lokalen Datenquellen.
- Daten offline mit Transfer Appliance übertragen: Übertragen und laden Sie große Datenmengen offline in Google Cloud , wenn keine Netzwerkverbindung und Bandbreite verfügbar, eingeschränkt oder teuer sind.
- Daten in Cloud Storage hochladen: Laden Sie Daten online in Cloud Storage-Buckets hoch. Verwenden Sie dazu die Google Cloud Console, die Google Cloud CLI, die Cloud Storage API oder Clientbibliotheken.
Berücksichtigen Sie bei der Auswahl einer Datenübertragungsmethode Faktoren wie Datengröße, Zeitbeschränkungen, Bandbreitenverfügbarkeit, Kostenziele sowie Sicherheits- und Compliance-Anforderungen. Informationen zum Planen und Implementieren von Datenübertragungen zu Google Cloudfinden Sie unter Optionen für die Datenübertragung.
Nächste Schritte
- Speicherkosten mit dem Google Cloud -Preisrechner schätzen
- Erfahren Sie mehr über Best Practices zum Erstellen einer Cloud-Topologie, die für Sicherheit, Robustheit, Kosten und Leistung optimiert ist.
- Weitere Referenzarchitekturen, Diagramme und Best Practices finden Sie im Cloud-Architekturcenter.
Beitragende
Autor: Kumar Dhanagopal | Cross-product Solution Developer
Weitere Beitragende:
- Brennan Doyle | Solutions Architect
- Dean Hildebrand Technical Director, Office of the CTO
- Geoffrey Noer | Group Product Manager
- Jack Zhou | Technical Writer
- Jason Wu | Director, Product Management
- Jeff Allen | Solutions Architect
- Samantha He | Technical Writer
- Sean Derrington | Group Product Manager, Storage