


Dieses Dokument enthält eine Referenzarchitektur für die Bereitstellung von hochverfügbaren Microsoft SQL Server-Datenbanken in Google Cloud mithilfe einer Always On-Verfügbarkeitsgruppe. Das Dokument enthält auch Designüberlegungen für Hochverfügbarkeit und Notfallwiederherstellung (DR), Bereitstellungsoptionen, Automatisierungsempfehlungen sowie Anleitungen für Backup und DR-Vorgänge. Dieses Dokument richtet sich an technische Fachkräfte, die Google Cloud als Plattform für die Ausführung von SQL Server-Datenbanken in Betracht ziehen. Dabei werden Grundkenntnisse zu Compute Engine und SQL Server vorausgesetzt.
Google Cloud bietet kostengünstige, zuverlässige, sichere und leistungsstarke Lösungen für die Ausführung von SQL Server-Datenbanken. Eine Übersicht über die unterstützten SQL Server-Lösungen in Google Cloudfinden Sie unter SQL Server auf Google Cloud.
Wenn Sie eine SQL Server-Bereitstellung, die nicht für die Entwicklung vorgesehen ist, in Google Cloudbetreiben möchten, verwenden Sie eine der folgenden Lizenzierungsoptionen:
Eigene Lizenzen verwenden (Bring your own License, BYOL): Sie können Ihre vorhandenen Microsoft SQL Server-Lizenzen in Google Cloudverwenden. Sie müssen entweder Knoten für einzelne Mandanten oder Software Assurance mit License Mobility verwenden.
On-Demand-Lizenzen verwenden: Verwenden Sie vordefinierte SQL Server-Images in Google Cloud und zahlen Sie eine Gebühr, die die Computing-Kosten und die Microsoft-Lizenzkosten enthält. Google übernimmt die Microsoft-Lizenzvereinbarungen und die Abrechnung.
Der Abschnitt Bereitstellung dieses Dokuments enthält Ressourcen, die Sie bei der Bereitstellung dieser Referenzarchitektur unterstützen.
Architektur
Das folgende Diagramm zeigt eine Referenzarchitektur für eine SQL Server-Bereitstellung mit Hochverfügbarkeit in Google Cloud:
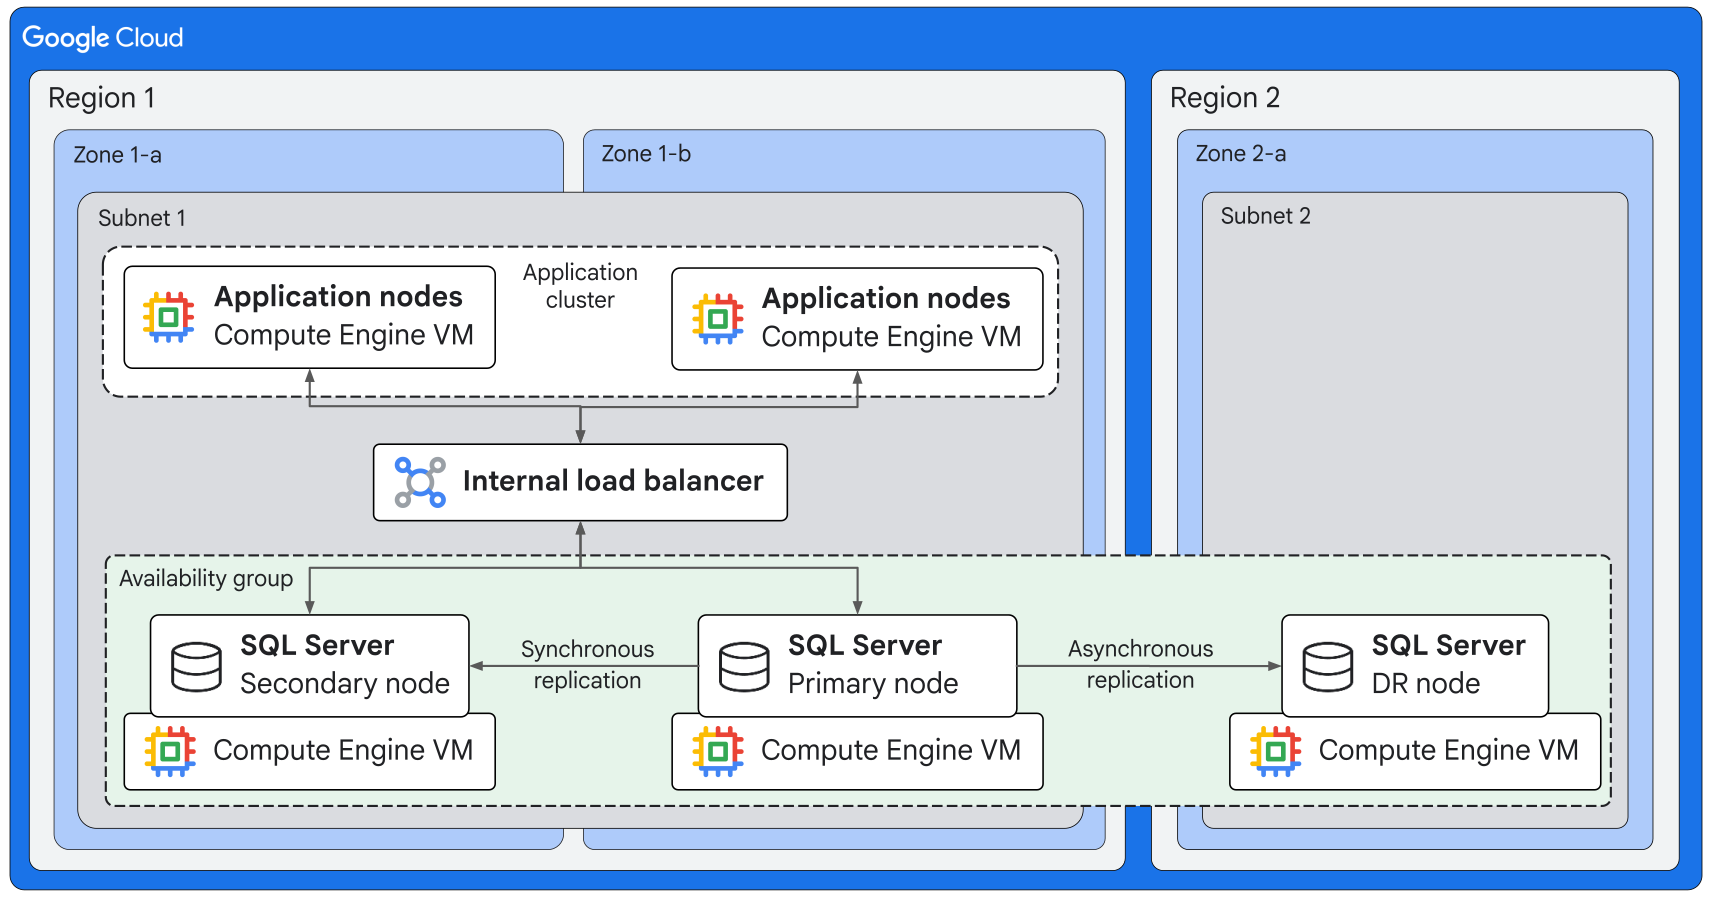
Die vorherige Architektur zeigt eine Always On-Verfügbarkeitsgruppe mit drei Knoten in einem Windows Server Failover Cluster (WSFC). Jeder Knoten ist eine Compute Engine-VM, auf der SQL Server ausgeführt wird.
Eine Always On-Verfügbarkeitsgruppe ist ein branchenübliches Bereitstellungsmuster, um Zuverlässigkeitsziele für geschäftskritische SQL Server-Datenbanken zu erreichen. AlwaysOn-Verfügbarkeitsgruppen bieten lokale Hochverfügbarkeit (Failover innerhalb einer Region) und regionsübergreifendes Failover für die Notfallwiederherstellung. Dieses Bereitstellungsmuster ist eine unternehmensgerechte Alternative zur Datenbankspiegelung. Eine Always On-Verfügbarkeitsgruppe bietet die folgenden Vorteile:
- Keine speziellen Infrastrukturkomponenten erforderlich: SQL Server verwaltet die Replikation über alle konfigurierten Datenbankreplikate hinweg.
- Höchste SLA-Konfiguration für SQL Server: Recovery Time Objective (RTO) von weniger als einer Minute und Recovery Point Objective (RPO) von nahezu null.
- Möglichkeit, Lesezugriff-Arbeitslasten auf sekundäre Replikate auszulagern: Skalieren Sie Ihre Bereitstellung effizient für Analysen und andere gängige Anwendungsfälle.
- Knoten in zusätzlichen Regionen für die Notfallwiederherstellung: Stellen Sie ein primäres Replikat und bis zu acht sekundäre Replikate bereit.
- Bereitstellbar unter Windows und Linux: Sie können ein Drittanbietertool wie Pacemaker als Cluster-Manager für Linux-Bereitstellungen verwenden.
In der vorherigen Architektur befinden sich die primären und sekundären SQL Server-Knoten in separaten Zonen innerhalb einer Region. Der DR-Knoten befindet sich in einer geografisch entfernten Region. Daten vom primären Knoten werden synchron auf den sekundären Knoten und asynchron auf den DR-Knoten repliziert.
Sie können einen der folgenden Ansätze verwenden, um Traffic von der Anwendungsebene auf die primären und sekundären Datenbankknoten innerhalb einer Region zu verteilen:
- Ein interner Load Balancer, wie im Architekturdiagramm dargestellt.
- Ein Distributed Network Name (DNN)-Listener und ein DNS-Server.
Verwendete Produkte
Die Architektur verwendet die folgenden Produkte und Komponenten von Google Cloud und Microsoft.
Google Cloud Produkte
- Compute Engine: Ein sicherer und anpassbarer Computing-Dienst, mit dem Sie virtuelle Maschinen in der Infrastruktur von Google erstellen und ausführen können.
- Google Cloud Hyperdisk: Ein Netzwerkspeicherdienst, mit dem Sie Blockspeichervolumes mit konfigurierbarer und vorhersehbarer Leistung bereitstellen und dynamisch skalieren können.
- Virtual Private Cloud (VPC): Ein virtuelles System, das globale, skalierbare Netzwerkfunktionen für Ihre Arbeitslasten in Google Cloud bietet. VPC umfasst VPC-Netzwerk-Peering, Private Service Connect, Zugriff auf private Dienste und freigegebene VPC.
- Cloud Load Balancing: Ein Portfolio von leistungsstarken, skalierbaren, globalen und regionalen Load-Balancern
Microsoft-Produkte und -Komponenten
Die folgenden Komponenten sind auf den SQL Server-Knoten enthalten oder aktiviert:
- Windows Server (Version 2019 oder höher).
- WSFC: Eine Gruppe von SQL Server-Instanzen, die auf mehreren Windows Server-Clusterknoten oder in mehreren Subnetzen installiert sind.
- Always On-Verfügbarkeitsgruppe: Eine HA- und DR-Alternative auf Unternehmensniveau zur Datenbankspiegelung.
- Verfügbarkeitsgruppen-Listener: Ein virtueller Netzwerkname (VNN), über den Clients auf eine Datenbank in einem primären oder sekundären Replikat einer Always On-Verfügbarkeitsgruppe zugreifen können. Clients müssen den Namen der physischen Instanz der Replikate nicht kennen. Da der Listener den Traffic weiterleitet, muss der Verbindungsstring des Clients nach einem Failover nicht geändert werden.
Die folgenden zusätzlichen Komponenten sind für die Bereitstellung dieser Architektur erforderlich:
- Active Directory Domain Services: Ein Windows Server-Verzeichnisdienst zum Verwalten von Ressourcen, die in einer Domain gemeinsam genutzt werden, z. B. Computer, Rollen und Nutzer.
- DNS: Ein Server, der Domainnamen in die entsprechenden IP-Adressen auflöst.
- Quorumzeuge: Dies kann eine SMB-Dateifreigabe (Server Message Block) oder ein lokal angehängtes freigegebenes Laufwerk sein.
Designaspekte
In diesem Abschnitt werden Designfaktoren, Best Practices und Designempfehlungen beschrieben, die Sie berücksichtigen sollten, wenn Sie diese Referenzarchitektur verwenden, um eine Topologie zu entwickeln, die Ihren Anforderungen an Zuverlässigkeit, operative Effizienz, Sicherheit, Kosten und Leistung entspricht.
Zuverlässigkeit
In diesem Abschnitt werden Designüberlegungen und Empfehlungen zum Erstellen und Betreiben einer zuverlässigen Infrastruktur für Ihre SQL Server-Bereitstellung inGoogle Cloudbeschrieben.
HA- und DR-Strategie auswählen
Wenn Sie zuverlässige SQL Server-Datenbanken in Google Cloudbereitstellen möchten, benötigen Sie eine Strategie, die die robuste Infrastruktur von Google Cloud mit den Hochverfügbarkeits- und Notfallwiederherstellungsfunktionen von SQL Server kombiniert. Diese Kombination schützt Ihre Datenbanken vor Ausfällen, von zonalen Ausfällen bis hin zu regionalen Katastrophen.
Berücksichtigen Sie beim Entwerfen der HA- und DR-Strategie für Ihre SQL Server-Bereitstellung die folgenden Faktoren:
- RPO: Wie viel Datenverlust ist im Falle eines Ausfalls akzeptabel?
- Wenn Sie ein niedriges RPO (Datenverlust nahe null) erreichen möchten, verwenden Sie eine Always On-Verfügbarkeitsgruppe mit synchroner Replikation.
- Wenn Sie einen gewissen Datenverlust tolerieren können, verwenden Sie einen der folgenden Ansätze: asynchrone Replikation, Backup- und DR-Dienst, Sicherung in einem Cloud Storage-Bucket oder Protokollversand.
- RTO: Wie schnell muss die Datenbank nach einem Ausfall wieder betriebsbereit sein?
- Verwenden Sie eine Always On-Verfügbarkeitsgruppe, um ein niedriges RTO zu erreichen.
- Wenn eine gewisse Ausfallzeit akzeptabel ist, stellen Sie die Datenbanken aus Sicherungen wieder her oder verwenden Sie den Protokollversand mit manuellem Failover.
- Budget: Berücksichtigen Sie die Vor- und Nachteile in Bezug auf Kosten und Zuverlässigkeit.
- Hohe Kosten, aber zuverlässig: Verwenden Sie eine Always On-Verfügbarkeitsgruppe mit asynchroner Replikation auf zusätzliche Knoten in einer DR-Region. Planen Sie redundante Infrastruktur und Lizenzen ein.
- Mittlere Kosten: Implementieren Sie die asynchrone Laufwerksreplikation in eine andere Region oder verwenden Sie Backup und DR.
- Niedrige Kosten, aber lange Wiederherstellungszeit: Sichern Sie die Datenbanken in einem multiregionalen Cloud Storage-Bucket.
- Arten von Ausfällen: Welche Arten von Ausfällen müssen Sie bewältigen?
- Zur Bewältigung von Ausfällen auf Hardware-, Instanz- und Zonenebene können Sie Verfügbarkeitsgruppen verwenden.
- Zur Wiederherstellung nach standortweiten Ausfällen oder Katastrophen benötigen Sie eine geografisch verteilte DR-Lösung wie Logversand oder Always On-Verfügbarkeitsgruppen mit asynchroner Datenbankreplikation.
- Geschäftskritisch: Wie wichtig ist die Anwendung für Ihr Unternehmen?
- Für geschäftskritische Anwendungen ist eine Strategie erforderlich, die ein Höchstmaß an Verfügbarkeit, minimalen Datenverlust und eine schnelle Wiederherstellung bietet.
- Für weniger kritische Systeme sollten Sie eine Strategie in Betracht ziehen, die eine akzeptable Ausfallzeit oder einen gewissen Datenverlust zulässt.
Verwenden Sie den folgenden Fragebogen, um eine optimale Zuverlässigkeitsstrategie für Ihre SQL Server-Datenbank auszuwählen. Die Strategieoptionen reichen von einer Always On-Verfügbarkeitsgruppe, die nahezu keinen Datenverlust verursacht, bis hin zu einer kostengünstigen externen Sicherung.
- Erfüllen Offsite-Sicherungen Ihre RPO- und RTO-Anforderungen?
- Ja: Verwenden Sie externe Sicherungen oder Logversand.
- Nein: Fahren Sie mit der nächsten Frage fort.
- Ist Ihr RTO oder RPO kleiner als eine Minute?
- Ja (RPO nahe null): Verwenden Sie eine SQL Server-AlwaysOn-Verfügbarkeitsgruppe mit einem DR-Datenbankreplikat.
- Nein: Fahren Sie mit der nächsten Frage fort.
- Wie lautet Ihr RTO?
- Weniger als fünf Minuten: Verwenden Sie eine SQL Server-AlwaysOn-Verfügbarkeitsgruppe mit einem asynchronen Laufwerksreplikat.
- Eine Stunde oder länger: Fahre mit der nächsten Frage fort.
- Wie hoch ist Ihr RPO?
- Weniger als zwei Stunden: Verwenden Sie eine SQL Server-AlwaysOn-Verfügbarkeitsgruppe mit Backup und DR.
- Acht Stunden oder mehr: Verwenden Sie Offsite-Sicherungen oder Logversand.
Geeignete Sicherungsoptionen auswählen
Wenn Ihre Zuverlässigkeitsstrategie Datenbanksicherungen umfasst, wählen Sie eine Sicherungsmethode aus, die Ihren Anforderungen entspricht. Google Cloud bietet die folgenden flexiblen und unternehmensgerechten Optionen zum Sichern von SQL Server-Datenbanken:
- Direkte Sicherung in einem Cloud Storage-Bucket:
Schreiben Sie Datenbanksicherungen direkt in Cloud Storage, indem Sie den Befehl
BACKUP TO
URL
und den S3-Connector in SQL Server (Version 2022 oder höher) verwenden. In Produktionsumgebungen können Sie einen HMAC-Zugriffsschlüssel (Hash-based Message Authentication Code) verwenden. Diese Sicherungsoption bietet kostengünstigen Schutz für Datenbanken und Logs, ohne dass ein Zwischenspeicher erforderlich ist. - Compute Engine-Instant Snapshots: Erfassen Sie gleichzeitige Snapshots auf mehreren Laufwerken (z. B. auf Google Cloud Hyperdisk Balanced-Laufwerken) in weniger als einer Sekunde. Verwenden Sie dazu Transact-SQL-Vorgänge (T-SQL) zum Einfrieren und Auftauen in Kombination mit Compute Engine-Konsistenzgruppen. Diese Option ermöglicht leistungsstarke Sicherungen auf VM-Ebene für Datenbanken mit mehreren Laufwerken und erfordert fast kein Einfrieren von Schreibvorgängen.
- Backup und DR: Orchestrieren Sie anwendungskonsistente Snapshots mithilfe von Microsoft VSS-Anbietern und Konsistenzgruppen. Diese Sicherungsoption eignet sich, wenn Sie eine detaillierte Wiederherstellung zu einem bestimmten Zeitpunkt (Point-in-Time Recovery, PITR) für mehrere Datenbanken benötigen und die Möglichkeit haben möchten, Logs zu verwenden, um Datenbanken vorwärts zu rollen.
- Google Cloud NetApp Volumes: Erstellen Sie mit der ONTAP-Speicher-Engine sofortige Snapshots und asynchrone Sicherungen in Remote-Vaults. Wir empfehlen NetApp Volumes für latenzempfindliche Unternehmensanwendungen, die eine schnelle Ransomware-Abwehr und platzsparende Klone erfordern.
Für Multi-Cloud- und Hybrid-Bereitstellungen, die einheitliche Datenschutzrichtlinien erfordern, können Sie ein Sicherungsprodukt eines Drittanbieters wie Veeam, Veritas NetBackup oder Cohesity auswählen.
Vorgänge
Um die Hochverfügbarkeit und optimale Leistung von SQL Server-Datenbanken zu gewährleisten, die auf Compute Engine-VMs bereitgestellt werden, richten Sie ein umfassendes Monitoring- und Benachrichtigungssystem mit Cloud Monitoring und Cloud Logging ein.
- Verfolgen Sie kontinuierlich Messwerte für wichtige Ressourcen wie CPU-Auslastung und Arbeitsspeicherlast. Richten Sie Baseline-Benachrichtigungen ein, um eine Überlastung von Ressourcen zu erkennen, bevor die Abfrageleistung beeinträchtigt wird.
- Um zu verhindern, dass Schreibvorgänge in der Datenbank angehalten werden, sollten Sie die Speicherplatznutzung kontinuierlich im Blick behalten. Überwachen Sie den allgemeinen Dienststatus und richten Sie Benachrichtigungen ein, um informiert zu werden, wenn Datenbanken unerwartet beendet werden.
- Verfolgen Sie bei Hochverfügbarkeitsbereitstellungen alle ungeplanten Failover und sorgen Sie für vollständige Transparenz bei automatisierten Notfallwiederherstellungsereignissen.
- Neben Telemetriedaten auf Systemebene bietet Google Cloud eine umfangreiche Suite datenbankspezifischer Messwerte wie Verbindungslimits für aktive Nutzer, Replikationsverzögerung und Transaktionsraten. Behalten Sie diese Messwerte im Blick, um die Verfügbarkeit und Leistung Ihrer SQL Server-Datenbanken zu überwachen.
- Wenn Sie Fehler auf Anwendungsebene wie Deadlocks, Datenbankbeschädigungen und Agent-Jobfehler direkt aus den SQL Server-Fehlerlogs erfassen möchten, richten Sie in Logging benutzerdefinierte logbasierte Benachrichtigungen ein.
Sicherheit
In diesem Abschnitt werden Überlegungen und Empfehlungen zum Entwerfen einer SQL Server-Bereitstellung in Google Cloud beschrieben, die die Sicherheitsanforderungen Ihrer Arbeitslast erfüllt.
Netzwerksicherheit und -isolation
- Um zu verhindern, dass die Datenbanken extern zugänglich sind, stellen Sie die SQL Server-Instanzen mit privaten IP-Adressen in einer VPC bereit. Verwenden Sie den Zugriff auf private Dienste, um Traffic intern weiterzuleiten. So wird sichergestellt, dass Ihr Datenbank-Traffic nie über das öffentliche Internet geleitet wird.
- Schränken Sie den Zugriff auf die Datenbanken weiter ein, indem Sie strenge VPC-Firewallregeln konfigurieren, die nur Traffic von autorisierten Anwendungssubnetzen oder bestimmten CIDR-Blöcken zulassen.
- Um Daten bei der Übertragung vor Abhören und Abfangen zu schützen, sollten Sie eine verschlüsselte Verbindung implementieren, indem Sie TLS/SSL für alle Datenbankverbindungen erzwingen.
Verschlüsselung und Schlüsselkontrolle
- Standardmäßig verwendet Google Cloud von Google verwaltete AES-256-Schlüssel, um alle inaktiven Daten auf Datenbanklaufwerken, in temporären Dateien und in Sicherungen automatisch zu verschlüsseln. Zur Einhaltung von Compliance-Anforderungen können Sie die Verschlüsselung auf Datenbankebene mit der Transparent Data Encryption (TDE) von SQL Server implementieren.
- Um die Datenhoheit zu gewährleisten, können Sie kundenverwaltete Verschlüsselungsschlüssel (CMEK) im Cloud Key Management Service verwenden. Mit CMEKs haben Sie die volle kryptografische Kontrolle. Sie verwalten die Schlüssellebenszyklen, legen automatische Rotationspläne fest und können den Zugriff auf die Datenbank und ihre Sicherungen bei Bedarf sofort widerrufen.
Authentifizierung und Autorisierung
- Binden Sie Ihre Datenbank in Microsoft Active Directory ein oder zentralisieren Sie die Identitätsverwaltung für Ihre SQL Server-Datenbanken und andereGoogle Cloud -Ressourcen mithilfe von Identity and Access Management (IAM).
- Nachdem Identitäten eingerichtet wurden, wenden Sie das Prinzip der geringsten Berechtigung an, damit Nutzer und Anwendungsdienstkonten nur die Berechtigungen haben, die für die Ausführung ihrer Funktionen erforderlich sind. Identitäten detaillierten SQL Server-Datenbankrollen zuordnen.
Kostenoptimierung
Dieser Abschnitt enthält Anleitungen zur Optimierung der Kosten für die Einrichtung und den Betrieb einer SQL Server-Bereitstellung, die Sie mithilfe dieser Referenzarchitektur erstellen. Die Kostenoptimierung trägt dazu bei, dass die Bereitstellung die Zuverlässigkeits- und Leistungsanforderungen Ihrer Arbeitslast im Rahmen Ihrer Budgetbeschränkungen erfüllt.
Beachten Sie die folgenden Empfehlungen:
- Gleichzeitiges Multithreading (SMT) deaktivieren: Wenn Sie SMT deaktivieren, können Sie die Anzahl der Kerne, die für Lizenzierungszwecke gemeldet werden, um 50 % reduzieren. Wenn Sie Ihre CPUs um 20 % überdimensionieren und dann SMT deaktivieren, können Sie erhebliche Einsparungen bei den Lizenzkosten erzielen, ohne die Leistung zu beeinträchtigen. Weitere Informationen finden Sie unter Anzahl der Threads pro Kern festlegen.
- SQL Server Standard Edition verwenden: Je nach Ihren Anforderungen an Hochverfügbarkeit und Notfallwiederherstellung können Sie die Lizenzkosten senken, indem Sie die SQL Server Standard Edition anstelle der Enterprise Edition verwenden. Weitere Informationen finden Sie unter Versionen und unterstützte Funktionen von SQL Server.
- Speicher optimieren: Google Cloud Hyperdisk bietet verschiedene Laufwerksoptionen, die Sie je nach den Anforderungen Ihrer SQL Server-Bereitstellung auswählen können. Hyperdisk Balanced bietet ein ausgewogenes Verhältnis zwischen Kosten und Leistung. Sie können den Durchsatz und die Eingabe-/Ausgabevorgänge pro Sekunde (IOPS) unabhängig voneinander skalieren, sodass Ihre Infrastrukturausgaben genau den Anforderungen der Arbeitslast entsprechen. Weitere Informationen finden Sie im Abschnitt Geeigneten Speicherlaufwerkstyp auswählen.
Leistungsoptimierung
In diesem Abschnitt werden Überlegungen zum Design und Empfehlungen für eine SQL Server-Bereitstellung beschrieben, die Ihre Leistungsanforderungen erfüllt.
Wenn Sie SQL Server auf Compute Engine-VMs bereitstellen, haben Sie die volle Kontrolle über die Datenbank und die zugrunde liegende Infrastruktur. Die Leistung Ihrer Arbeitslast hängt von der gewählten Infrastruktur ab. Um Leistung, Kosten und Zuverlässigkeit in Einklang zu bringen, müssen Sie fundierte Entscheidungen über die VM-Maschinenfamilie und den Laufwerkstyp für die Datenbankknoten treffen.
Geeignete VM-Familie auswählen
Die Maschinenfamilie, die Sie für die Compute Engine-VMs auswählen, bestimmt die Verarbeitungsleistung (vCPU) und den Arbeitsspeicher (RAM), die für Ihre SQL Server-Knoten verfügbar sind. Diese Ressourcen wirken sich auf die Leistung Ihrer Datenbanken aus.
Wählen Sie eine VM-Familie aus, die Ihren primären Leistungsengpass behebt. Wenn Ihre SQL Server-Datenbank beispielsweise ständig eine hohe CPU-Auslastung aufweist, wählen Sie einen Maschinentyp aus der computing-optimierten Maschinenfamilie aus. Wenn Ihre SQL Server-Datenbank langsame Lesevorgänge von der Festplatte aufweist, wählen Sie einen speicheroptimierten Maschinentyp aus.
In der folgenden Tabelle werden die von Compute Engine bereitgestellten VM-Maschinenfamilien, der primäre Anwendungsfall für jede Maschinenfamilie und die Auswirkungen auf die Leistung von SQL Server-Datenbanken verglichen:
| Maschinenfamilie und -serie | Primärer Anwendungsfall | Auswirkungen auf die SQL Server-Leistung |
|---|---|---|
| Für allgemeine Zwecke (N4-Maschinenreihe) | Ausgewogenes Preis-Leistungs-Verhältnis | Verwenden Sie diese Maschinenfamilie als Ausgangspunkt für die meisten Arbeitslasten. Die N4-Maschinenserie bietet ein optimales Verhältnis von CPU und Arbeitsspeicher für Datenbanken mit gemischter Nutzung, Webanwendungen und Entwicklungs- oder Testumgebungen. |
| Computing-optimiert (C3- oder C4-Maschinenserie) | Höchste Leistung pro Kern | Verwenden Sie diese Maschinenfamilie für CPU-gebundene Arbeitslasten. Verwenden Sie für Datenbanken, die komplexe Abfragen ausführen, große Datenmengen verarbeiten oder eine hohe Anzahl von OLTP-Vorgängen (Online Transaction Processing) verarbeiten, die C3- und C4-Maschinenserien. Maschinentypen aus diesen Serien tragen dazu bei, die Ausführungszeit von Abfragen erheblich zu verkürzen. |
| Speicheroptimiert (Maschinenreihe M3 oder M4) | Großes Verhältnis von Arbeitsspeicher zu vCPUs | Diese Maschinenfamilie eignet sich ideal für speicherintensive Anwendungen. SQL Server speichert Daten und Ausführungspläne im Arbeitsspeicher, was eine höhere Leistung als das Lesen von Laufwerken bietet. Bei sehr großen Datenbanken oder Data Warehouses für die Online-Analyseverarbeitung (OLAP) werden bei den Abfragen in der Regel große Tabellen und Datasets gescannt. In solchen Fällen kann ein größerer Arbeitsspeicher die Leistung verbessern. |
Weitere Informationen finden Sie im Leitfaden zu Ressourcen und Vergleichen für Maschinenfamilien.
Geeigneten Speicherlaufwerkstyp auswählen
Die Laufwerksleistung ist ein wichtiger Faktor für die Reaktionsfähigkeit der Datenbank, die wiederum für die Anwendungsleistung entscheidend ist. Für die von Google Cloudangebotenen Laufwerkstypen werden die Leistungsmerkmale anhand der folgenden Messwerte angegeben:
- IOPS: Die Anzahl der Lese- und Schreibanfragen, die ein Laufwerk pro Sekunde verarbeiten kann. IOPS sind entscheidend für OLTP-Arbeitslasten, die viele kleine, zufällige Lese- und Schreibvorgänge umfassen, z. B. das Aktualisieren von Kundendatensätzen oder das Verarbeiten von Bestellungen.
- Durchsatz: Die Gesamtmenge an Daten, die pro Sekunde auf das Laufwerk oder vom Laufwerk verschoben werden kann. Der Durchsatz ist für OLAP-Arbeitslasten, bei denen große Datenmengen gescannt werden, wie das Ausführen von Berichten, Data Warehousing oder das Erstellen von Sicherungen, von entscheidender Bedeutung.
In der folgenden Tabelle werden die Google Cloud -Laufwerkstypen verglichen, aus denen Sie auswählen können:
| Laufwerkstyp | Leistungsmerkmale | Eignung für Arbeitslasten |
|---|---|---|
Nichtflüchtiger SSD-Speicher (pd-ssd) |
Mittlere bis hohe Leistung je nach VM-Maschinentyp und Laufwerksgröße | Arbeitslasten, bei denen die Leistung mit der Größe des Laufwerks und den vCPUs der VM skaliert werden muss. Weitere Informationen finden Sie unter Übersicht über die Leistung von Persistent Disk. |
| Hyperdisk abgestimmt | Hohe Leistung mit konfigurierbaren IOPS und Durchsatz | SQL Server-Produktionsdaten und -Logdateien. Mit Hyperdisk Balanced können Sie IOPS und Durchsatz unabhängig von der Laufwerksgröße und basierend auf den Anforderungen der Arbeitslast konfigurieren. |
| Google Cloud Hyperdisk Extreme | Sehr hohe Leistung mit konfigurierbaren IOPS | Exklusive, geschäftskritische OLTP-Arbeitslasten, die maximale IOPS und die niedrigste Latenz erfordern, z. B. große Finanz- oder E-Commerce-Systeme. |
| Lokale SSD | Höchste IOPS und höchster Durchsatz im Vergleich zu den anderen Laufwerkstypen | Temporäre Daten, die nicht die Langlebigkeit nichtflüchtiger Speicher benötigen. Für Daten wie die Systemdatenbank tempdb und die Windows-Auslagerungsdatei bieten lokale SSDs die niedrigste Latenz, da sie physisch mit den VMs verbunden sind. |
Infrastruktur an Leistungsanforderungen anpassen
Wählen Sie VM-Maschinentypen und Laufwerkstypen basierend auf den Leistungsanforderungen Ihrer Arbeitslast aus. In der folgenden Tabelle werden Infrastrukturkonfigurationen für verschiedene Arbeitslastszenarien empfohlen:
| Szenario | Leistungsanforderungen | Empfohlener Maschinentyp und empfohlene Laufwerkskonfiguration |
|---|---|---|
| E-Commerce-Datenbank mit hohem Transaktionsvolumen für OLTP | Hohe IOPS-Werte für Tausende von kleinen, gleichzeitigen Lese- und Schreibvorgängen |
VM-Maschinentyp: Wählen Sie einen computing-optimierten Maschinentyp (z. B. aus der C4-Maschinenserie) für die effiziente Verarbeitung von Transaktionen aus. Daten- und Protokolllaufwerke: Verwenden Sie Hyperdisk Balanced-Laufwerke. Stellen Sie eine hohe Anzahl von IOPS bereit, um die Transaktionsanforderungen zu erfüllen. Verwenden Sie separate Laufwerke für Daten und Logs.
|
| Data Warehouse des Unternehmens für OLAP | Hoher Durchsatz zum Scannen und Aggregieren von Terabyte an Daten für Berichte |
VM-Maschinentyp: Wählen Sie einen speicheroptimierten Maschinentyp aus (z. B. aus der M4-Maschinenserie), damit Sie so viel wie möglich des großen Datasets im Cache speichern können. Datenlaufwerk: Verwenden Sie Hyperdisk Balanced-Laufwerke. Stellen Sie einen hohen Durchsatz bereit, um große Datenscans zu beschleunigen. |
| Entwicklungs- oder Staging-Server | Kosteneffizienz statt Spitzenleistung | VM-Maschinentyp: Wählen Sie einen Maschinentyp für allgemeine Zwecke mit einer kleinen Maschinengröße aus der E2- oder N4-Maschinenserie aus. Laufwerke: Verwenden Sie für alle Datenbankdateien abgestimmten nichtflüchtigen Speicher ( |
Bereitstellung
Verwenden Sie eine der folgenden Ressourcen, um diese Referenzarchitektur bereitzustellen:
- Infrastruktur als Code (IaC): Verwenden Sie eine Terraform-Konfiguration, um SQL Server-Cluster in Google Cloudbereitzustellen. Die Konfiguration umfasst eine PowerShell-DSC (Desired State Configuration) und Bash-Skripts zum Konfigurieren der erforderlichen Komponenten. Sie können den Code herunterladen und entsprechend Ihren Konfigurationsanforderungen ändern.
- Geführter Workflow: Stellen Sie SQL Server in einer Konfiguration mit einem einzelnen Knoten oder in einer Clusterkonfiguration mithilfe von Workload Manager bereit.
- Anleitung: Folgen Sie der detaillierten Anleitung, um SQL Server AlwaysOn-Verfügbarkeitsgruppen mit synchronem Commit mithilfe eines internen Load Balancers zu konfigurieren.
Nächste Schritte
- Lizenzierungs- und Image-Optionen für SQL Server in Google Cloud
- Leitfaden zur Planung der Notfallwiederherstellung ansehen.
- Informationen zur Notfallwiederherstellung für Microsoft SQL Server
- Microsoft SQL Server für die multiregionale Notfallwiederherstellung bereitstellen
- Laufwerke zwischen Compute Engine-Instanzen freigeben
- Weitere Referenzarchitekturen, Diagramme und Best Practices finden Sie im Cloud-Architekturcenter.
Beitragende
Autor*innen:
- Tom Niedzielak | Staff Systems Development Engineer
- Sung Baek | Software Engineer
Weiterer Mitwirkender: Kumar Dhanagopal | Cross-Product Solution Developer