


Questo documento fornisce un'architettura di riferimento che puoi utilizzare per progettare l'infrastruttura per un'applicazione di AI generativa con retrieval-augmented generation (RAG) utilizzando Gemini Enterprise e Gemini Enterprise Agent Platform. Questa architettura di riferimento mostra come utilizzare i servizi gestiti ed eseguire il deployment di un singolo agente AI per facilitare un flusso di dati RAG end-to-end. Gemini Enterprise funge da piattaforma unificata per l'orchestrazione degli agenti in tutta l'azienda. Agent Platform accelera lo sviluppo e il deployment di agenti personalizzati e fornisce datastore gestiti per facilitare il recupero efficiente per la RAG.
Il pubblico di destinazione di questo documento include architetti, sviluppatori e amministratori di applicazioni di AI generativa. Il documento presuppone che tu abbia una conoscenza di base dei concetti di AI, machine learning (ML) e modelli linguistici di grandi dimensioni (LLM). Questo documento non fornisce indicazioni su come progettare e sviluppare un'applicazione di AI generativa. Per informazioni su come progettare un'applicazione, consulta Sviluppa un'applicazione di AI generativa.
Architettura
Il seguente diagramma mostra una visualizzazione di alto livello dell'architettura presentata in questo documento:

L'architettura nel diagramma precedente ha due sottosistemi: importazione dati e distribuzione.
- Il sottosistema di acquisizione dei dati acquisisce e prepara i dati da fonti esterne per l'utilizzo in RAG. Il sottosistema genera embedding per i dati importati e li utilizza per creare e gestire un indice vettoriale ricercabile in un datastore gestito.
- Il sottosistema di gestione contiene i servizi di frontend e backend dell'applicazione di AI generativa.
- Il servizio di frontend gestisce il flusso di query-risposta con gli utenti dell'applicazione e inoltra le query al servizio di backend.
- Il servizio di backend utilizza Gemini Enterprise e Agent Platform per creare e fare il deployment dell'agente AI per orchestrare il processo RAG. Questo processo utilizza i dati vettoriali indicizzati per generare risposte contestualmente fondate e conformi ai filtri di sicurezza dell'AI responsabile.
Il seguente diagramma mostra una visualizzazione dettagliata dell'architettura:
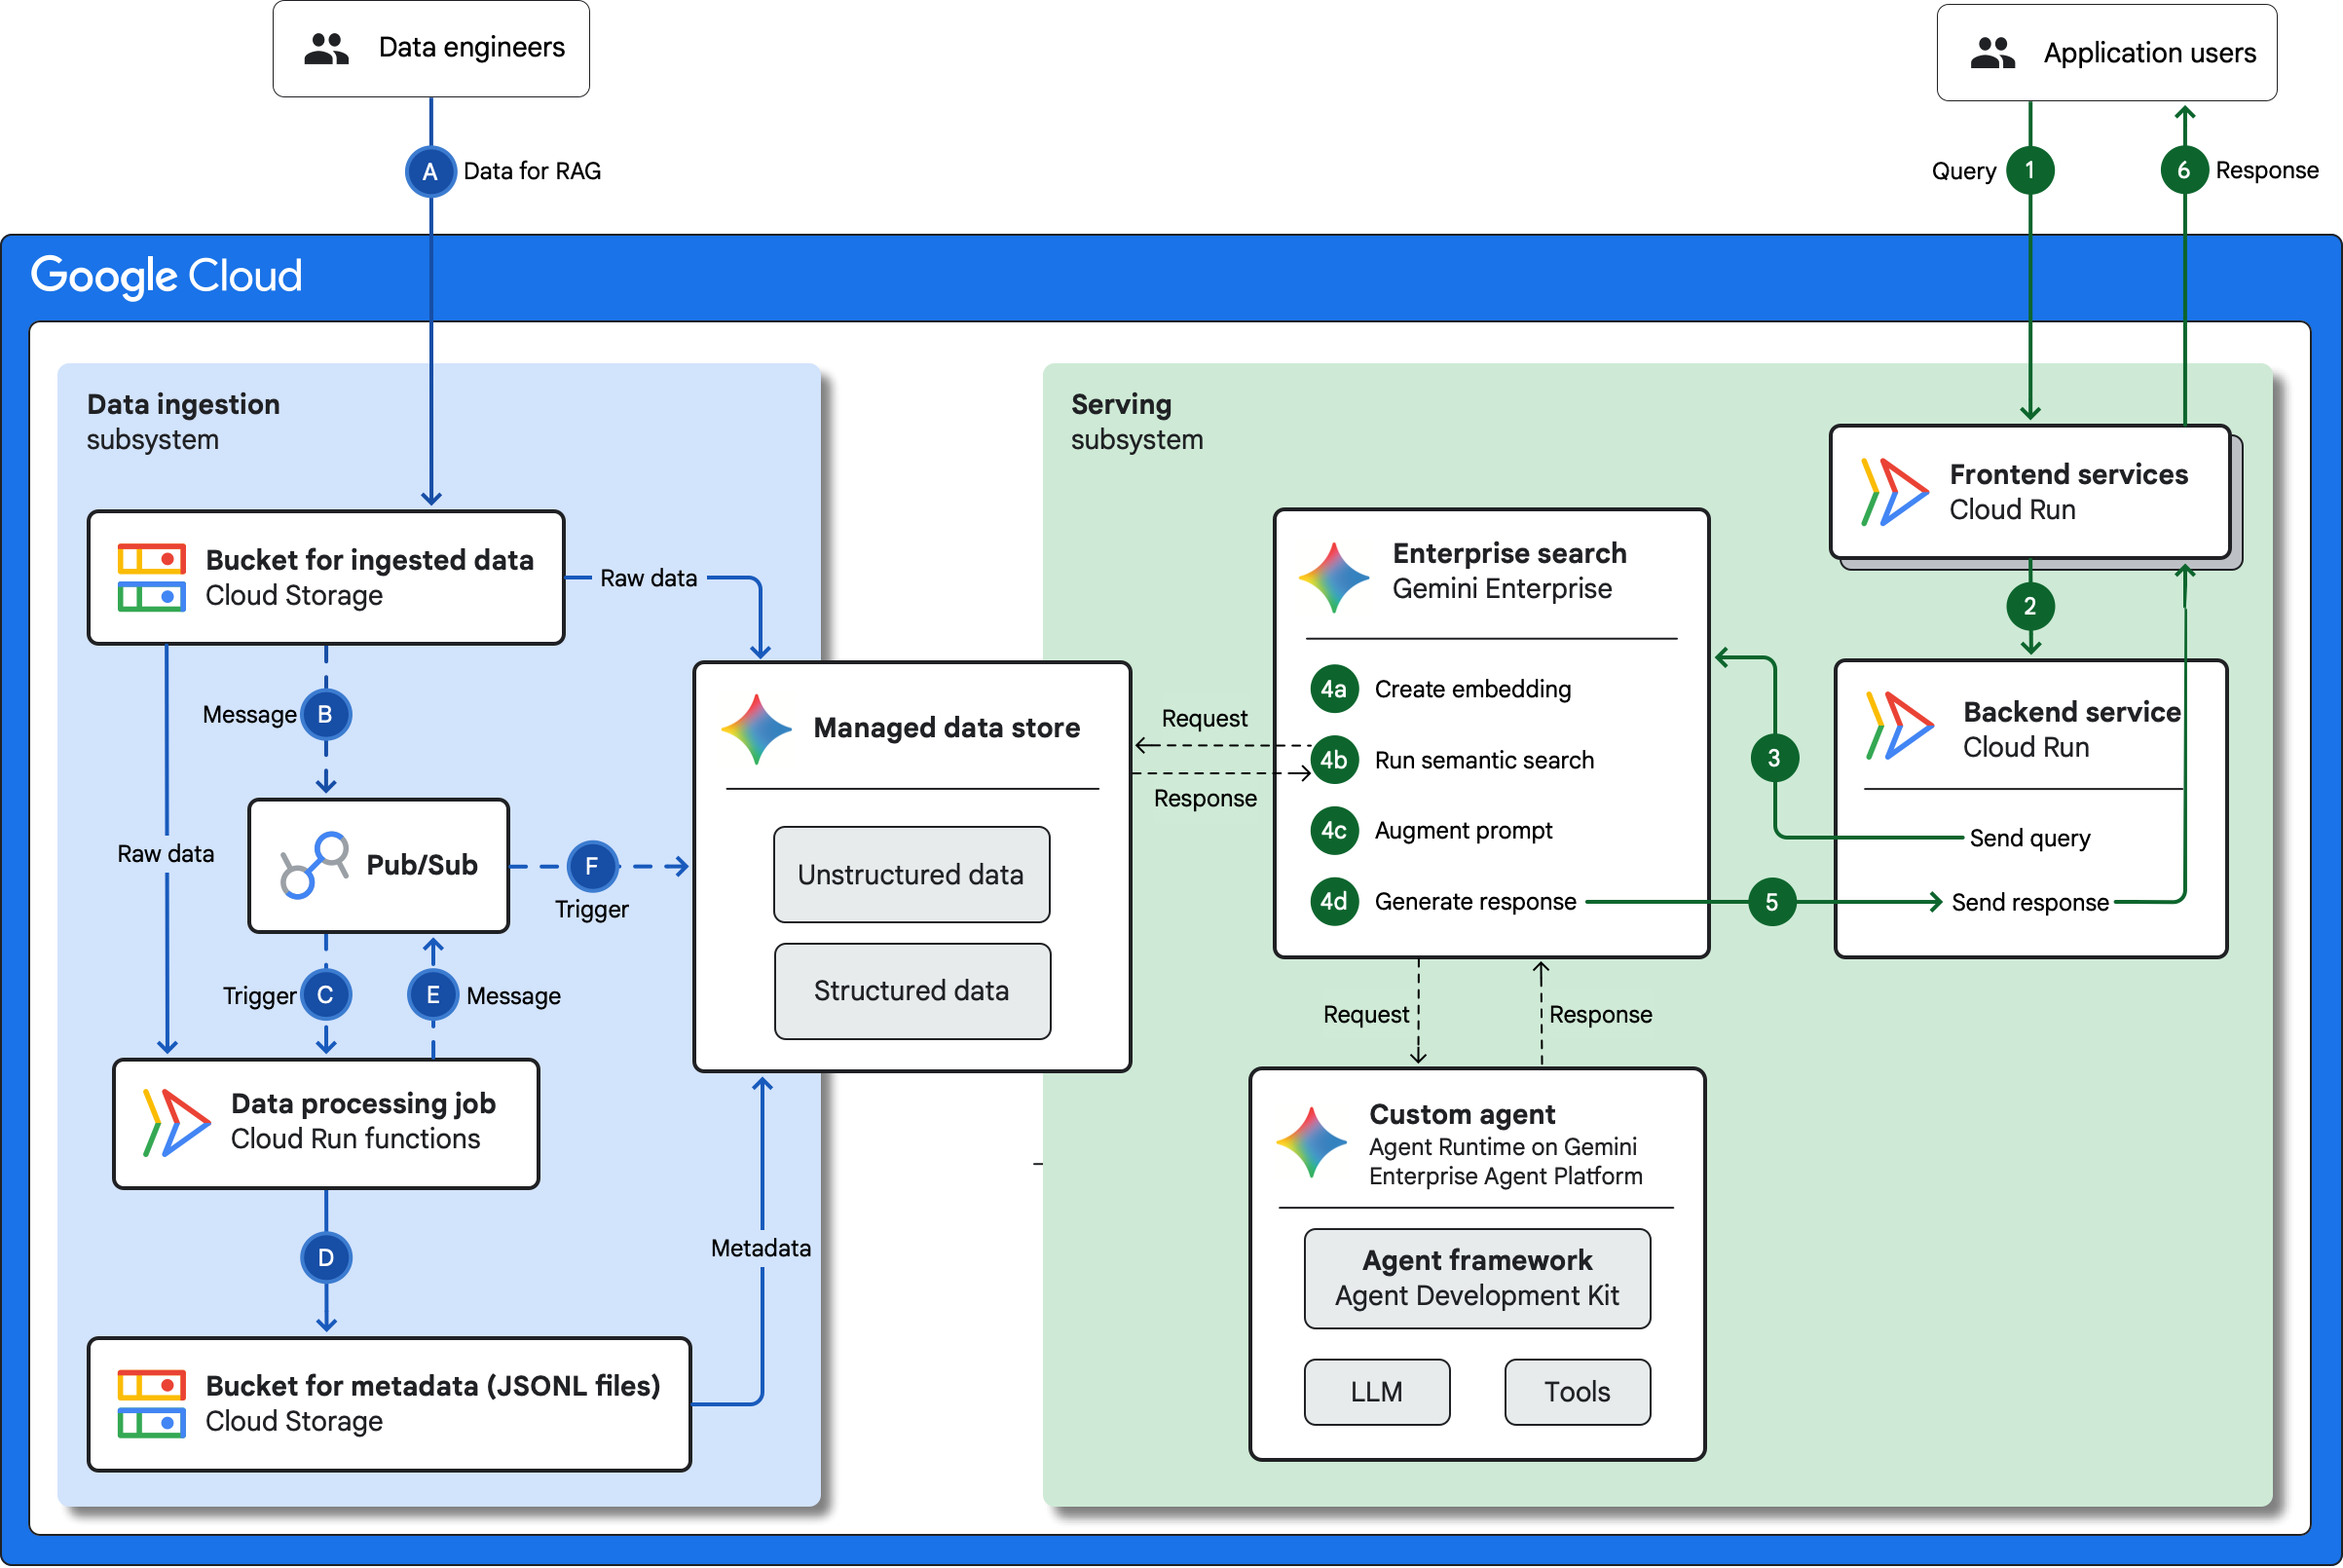
Le sezioni seguenti descrivono il flusso di dati all'interno di ogni sottosistema del diagramma dell'architettura precedente.
Sottosistema di acquisizione dei dati
Il sottosistema di importazione dati acquisisce i dati da origini esterne e li prepara per la RAG. Di seguito sono riportati i passaggi del flusso di importazione e preparazione dei dati:
- I data engineer caricano i dati da origini esterne in un bucket Cloud Storage. Le origini esterne potrebbero essere applicazioni, database o servizi di streaming.
- Al termine, Cloud Storage pubblica un messaggio in un argomento Pub/Sub.
- L'argomento Pub/Sub attiva un job di elaborazione da eseguire in Cloud Run Functions.
- Cloud Run Functions elabora i dati non elaborati generando e archiviando i metadati come file JSON Lines (JSONL). I file JSONL vengono archiviati in un bucket Cloud Storage separato.
- Al termine, Cloud Run Functions pubblica un messaggio in un argomento Pub/Sub.
- L'argomento Pub/Sub attiva una funzione Cloud Run downstream che chiama il
metodo
documents.importdell'API Discovery Engine per avviare un job di importazione nel datastore gestito all'interno di Gemini Enterprise. Il job di importazione estrae i dati e i metadati non elaborati importati dai bucket Cloud Storage, quindi analizza e suddivide i dati per un recupero efficiente durante la pubblicazione. Gemini Enterprise genera automaticamente i vector embedding senza alcuna configurazione necessaria.
Sottosistema di pubblicazione
Il sottosistema di gestione gestisce il flusso di query-risposta tra l'applicazione di AI generativa e i suoi utenti. Di seguito sono riportati i passaggi del flusso di pubblicazione:
- Un utente dell'applicazione invia una query tramite uno dei servizi frontend Cloud Run. Puoi personalizzare questi servizi per esperienze diverse, ad esempio un'interfaccia utente di un chatbot, una pagina di ricerca o un'applicazione mobile.
- Il servizio di frontend riceve la query e la inoltra a un servizio di backend Cloud Run centralizzato. Questo backend fornisce un singolo endpoint unificato per supportare tutti i diversi client frontend. Il servizio di backend esegue anche la pre-elaborazione necessaria, che può includere la creazione di filtri per la query di ricerca. Questo approccio mantiene la logica trasparente per i frontend.
- Il servizio di backend invia la richiesta preparata a Gemini Enterprise utilizzando l'endpoint API Gemini Enterprise per avviare il workflow RAG.
- Per elaborare la query, Gemini Enterprise utilizza la ricerca a livello aziendale e l'agente personalizzato per eseguire le seguenti attività:
- Crea un embedding della query dell'utente.
- Esegui una ricerca semantica sui dati indicizzati nel datastore gestito per trovare le informazioni più pertinenti.
- Arricchisci la query originale con i dati recuperati dal datastore gestito per creare un prompt dettagliato e contestuale.
- Generare una risposta finale basata sul prompt migliorato.
- Gemini Enterprise invia la risposta generata al servizio di backend Cloud Run.
- Il servizio di backend restituisce la risposta finale al servizio di frontend che ha inviato la richiesta originale. Il servizio frontend presenta la risposta all'utente dell'applicazione.
Prodotti utilizzati
Questa architettura di riferimento utilizza i seguenti prodotti Google Cloud :
- Gemini Enterprise: una piattaforma sicura completamente gestita per eseguire il deployment e gestire gli agenti AI all'interno di un'azienda.
- Gemini Enterprise Agent Platform: una piattaforma completa che ti consente di creare, scalare, gestire e ottimizzare agenti AI di livello enterprise.
- Agent Runtime su Gemini Enterprise Agent Platform: una piattaforma che ti consente di eseguire, gestire e scalare gli agenti AI in produzione.
- Cloud Run: una piattaforma di serverless computing che ti consente di eseguire container direttamente sull'infrastruttura scalabile di Google.
- Cloud Run Functions: una piattaforma di serverless computing che ti consente di eseguire funzioni con un unico scopo direttamente in Google Cloud.
- Pub/Sub: un servizio di messaggistica asincrono e scalabile che disaccoppia i servizi che producono messaggi dai servizi che li elaborano.
- Cloud Storage: un archivio di oggetti a basso costo e senza limiti per diversi tipi di dati. I dati sono accessibili dall'interno e dall'esterno di Google Cloude vengono replicati in più località per la ridondanza.
Casi d'uso
Questa architettura è progettata per scenari aziendali in cui l'applicazione di AI generativa deve accedere alle informazioni più aggiornate e richiede una comprensione profonda e contestuale per fornire risposte accurate.
L'architettura include un sottosistema di importazione dati personalizzato per soddisfare due requisiti aziendali chiave:
- Disponibilità dei dati in tempo reale: la pipeline basata su eventi elabora i nuovi dati non appena sono disponibili nella tua organizzazione, ad esempio una nuova guida ai prodotti o un report aggiornato. La pipeline rende inoltre le informazioni disponibili nel datastore gestito. Questo design aiuta a mitigare l'obsolescenza delle informazioni perché contribuisce a ridurre al minimo il ritardo tra la disponibilità e l'utilizzo dei dati.
- Ricerca contestuale arricchita: il job di elaborazione personalizzato consente alla tua organizzazione di applicare la propria logica di business per arricchire i dati con metadati preziosi. La funzione Cloud Run può taggare ogni documento con attributi specifici come linea di prodotti, autore, località o tipo di documento. Questi metadati dettagliati aiutano l'agente a restringere la ricerca e a fornire risposte più precise e consapevoli del contesto.
La RAG è una tecnica efficace per migliorare la qualità dell'output generato da un LLM. Questa sezione fornisce esempi di casi d'uso per i quali puoi utilizzare applicazioni di AI generativa compatibili con RAG.
Suggerimenti personalizzati sui prodotti
Un sito di acquisti online potrebbe utilizzare un chatbot basato su LLM per aiutare i clienti a trovare prodotti o ricevere assistenza relativa agli acquisti. Le domande di un utente possono essere migliorate utilizzando i dati storici sul comportamento di acquisto dell'utente e sui modelli di interazione con il sito web. I dati potrebbero includere recensioni e feedback degli utenti archiviati in un datastore non strutturato o metriche relative alla ricerca archiviate in un data warehouse di analisi dei dati web. La domanda migliorata può quindi essere elaborata dall'LLM per generare risposte personalizzate che l'utente potrebbe trovare più interessanti e accattivanti.
Sistemi di assistenza clinica
I medici negli ospedali devono esaminare e sintetizzare le informazioni sanitarie dei pazienti per prendere decisioni di cura informate. Un'applicazione di AI generativa che utilizza un foundation model medico come MedGemma può aiutare i medici a riassumere le note cliniche e a esaminare il contesto medico. Le risposte generate dall'applicazione possono essere basate su cartelle cliniche storiche dei pazienti contestualizzando i prompt con i dati del database della cartella clinica elettronica (EHR) dell'ospedale o di una knowledge base esterna come PubMed.
Ricerca legale efficiente
La ricerca legale basata sull'AI generativa consente agli avvocati di eseguire rapidamente query su grandi volumi di statuti e giurisprudenza per identificare precedenti legali pertinenti o riassumere concetti legali complessi. I risultati di questa ricerca possono essere migliorati integrando i prompt di un avvocato con i dati recuperati dal corpus proprietario di contratti, comunicazioni legali passate e registri interni dei casi dello studio legale. Questo approccio di progettazione aiuta a generare risposte pertinenti al dominio legale in cui l'avvocato è specializzato.
Alternative di progettazione
Questa sezione presenta approcci di progettazione alternativi che puoi prendere in considerazione per la tua applicazione di AI generativa compatibile con RAG in Google Cloud.
Alternative all'infrastruttura AI
Per un elenco di guide all'architettura per progettare ed eseguire il deployment di applicazioni di AI generativa con RAG in Google Cloud, consulta AI generativa con RAG.
Opzioni di hosting delle applicazioni
Nell'architettura mostrata in questo documento, Cloud Run è l'host per l'applicazione di AI generativa e il trattamento dati. Cloud Run è una piattaforma incentrata sugli sviluppatori e completamente gestita. Puoi anche eseguire il deployment della tua applicazione in Agent Runtime su Gemini Enterprise Agent Platform, cluster Google Kubernetes Engine (GKE) o in VM Compute Engine.
Per scegliere un host dell'applicazione, considera i seguenti compromessi tra flessibilità di configurazione e impegno di gestione:
- Con l'opzione serverless Cloud Run, esegui il deployment dei tuoi servizi personalizzati in un ambiente gestito preconfigurato. Per ospitare i servizi di frontend e la logica di backend personalizzata per la pre-elaborazione delle richieste, questa architettura richiede la possibilità di eseguire il deployment di applicazioni personalizzate.
- Con l'opzione Agent Runtime, utilizzi una piattaforma completamente gestita progettata per l'erogazione degli agenti. Agent Runtime riduce l'overhead di gestione e fornisce una stretta integrazione con Gemini Enterprise.
- Con le VM di Compute Engine e i container GKE, sei tu a dover gestire le risorse di computing sottostanti, ma hai una maggiore flessibilità e un maggiore controllo della configurazione.
Per saperne di più sulla scelta di un servizio di hosting di applicazioni appropriato, consulta i seguenti documenti:
Altre opzioni di infrastruttura
Per informazioni su altre opzioni di infrastruttura, modelli supportati e tecniche di grounding che puoi utilizzare per le applicazioni di AI generativa inGoogle Cloud, consulta Scegli modelli e infrastruttura per la tua applicazione di AI generativa.
Considerazioni sulla progettazione
Questa sezione fornisce indicazioni per aiutarti a sviluppare un'architettura di AI generativa compatibile con RAG in Google Cloud che soddisfi i tuoi requisiti specifici di sicurezza e conformità, affidabilità, costi e prestazioni. Le indicazioni riportate in questa sezione non sono esaustive. A seconda dei requisiti specifici della tua applicazione di AI generativa e dei prodotti e delle funzionalità Google Cloud che utilizzi, potresti dover considerare ulteriori fattori di progettazione e compromessi.
Per una panoramica dei principi e dei suggerimenti di architettura specifici per i workload di AI e ML in Google Cloud, consulta la prospettiva di AI e ML nel Well-Architected Framework.
Sicurezza, privacy e conformità
Questa sezione descrive le considerazioni e i suggerimenti per la progettazione di una topologia in Google Cloud che soddisfi i requisiti di sicurezza e conformità del tuo workload.
Per i principi e i suggerimenti di sicurezza specifici per i workload di AI e ML, consulta Prospettiva di AI e ML: sicurezza nel Well-Architected Framework.
Agent Platform
La piattaforma agente supporta Google Cloud controlli di sicurezza che puoi utilizzare per soddisfare i tuoi requisiti di residenza dei dati, crittografia dei dati, sicurezza di rete e Access Transparency. Per maggiori informazioni, consulta la seguente documentazione:
- Controlli di sicurezza per i servizi di machine learning
- Controlli di sicurezza per l'AI generativa
- Agent Platform e conservazione dei dati pari a zero
- Abilita Access Transparency per Gemini Enterprise
- Controlli di conformità e sicurezza per Gemini Enterprise
- Conformità di Gemini Enterprise
- Eliminazione dei dati su Google Cloud.
I modelli di AI generativa potrebbero produrre risposte dannose, soprattutto quando vengono richiesti esplicitamente questi tipi di risposte. Per migliorare la sicurezza e mitigare il potenziale uso improprio, puoi configurare i filtri dei contenuti in modo che fungano da barriere alle risposte dannose. Per saperne di più, consulta Filtri di sicurezza e dei contenuti.
Cloud Run
Per impostazione predefinita, Cloud Run cripta i dati utilizzandoGoogle-owned and Google-managed encryption keys. Per proteggere i container utilizzando chiavi che controlli, puoi utilizzare le chiavi di crittografia gestite dal cliente (CMEK). Per saperne di più, consulta Utilizzo delle chiavi di crittografia gestite dal cliente.
Per assicurarti che venga eseguito il deployment in Cloud Run solo delle immagini container autorizzate, puoi utilizzare Autorizzazione binaria.
Cloud Run ti aiuta a soddisfare i requisiti di residenza dei dati. Le tue funzioni Cloud Run vengono eseguite all'interno della regione selezionata.
Cloud Storage
Per impostazione predefinita, Cloud Storage cripta i dati archiviati utilizzando Google-owned and Google-managed encryption keys. Se necessario, puoi utilizzare le CMEK o le tue chiavi che gestisci utilizzando un metodo di gestione esterno, come le chiavi di crittografia fornite dal cliente (CSEK). Per saperne di più, consulta Opzioni di crittografia dei dati.
Cloud Storage supporta due metodi per concedere agli utenti l'accesso ai tuoi bucket e oggetti: Identity and Access Management (IAM) ed elenchi di controllo dell'accesso (ACL). Nella maggior parte dei casi, ti consigliamo di utilizzare IAM, che ti consente di concedere autorizzazioni a livello di bucket e di progetto. Per saperne di più, consulta Panoramica del controllo dell'accesso.
I dati che carichi nel sottosistema di importazione dati tramite Cloud Storage potrebbero includere dati sensibili. Puoi utilizzare Sensitive Data Protection per rilevare, classificare e anonimizzare i dati sensibili. Per saperne di più, consulta Utilizzo di Sensitive Data Protection con Cloud Storage.
Cloud Storage ti aiuta a soddisfare i requisiti di residenza dei dati. Cloud Storage archivia o replica i dati all'interno della regione che specifichi.
Pub/Sub
Per impostazione predefinita, Pub/Sub cripta tutti i messaggi, inclusi quelli at-rest e in transito, utilizzandoGoogle-owned and Google-managed encryption keys. Pub/Sub supporta l'utilizzo di CMEK per la crittografia dei messaggi a livello di applicazione. Per saperne di più, consulta Configura la crittografia dei messaggi.
Se hai requisiti di residenza dei dati, per assicurarti che i dati dei messaggi siano archiviati in località specifiche, puoi configurare le policy di archiviazione dei messaggi.
Affidabilità
Questa sezione descrive le considerazioni e i suggerimenti di progettazione per creare e gestire un'infrastruttura affidabile per il tuo deployment in Google Cloud.
Per i principi e i suggerimenti di affidabilità specifici per i workload di AI e ML, consulta Prospettiva di AI e ML: affidabilità nel Well-Architected Framework.
Agent Platform
Agent Platform supporta la residenza dei dati at-rest. Agent Platform archivia i dati di origine, inclusi i dati per RAG nel datastore gestito, nellaGoogle Cloud località che hai selezionato. Questa separazione dell'elaborazione dall'archiviazione è un aspetto fondamentale del modo in cui la piattaforma offre sia un'elevata affidabilità sia la conformità.
Cloud Run
Cloud Run è un servizio regionale che distribuisce e bilancia automaticamente il carico delle istanze di servizio stateless in più zone all'interno di una regione. In caso di interruzione di una zona, i servizi Cloud Run e Cloud Run Functions continuano a essere eseguiti senza interruzioni. Per la resilienza alle interruzioni a livello di regione, puoi eseguire il deployment dei servizi Cloud Run in più regioni dietro un bilanciatore del carico delle applicazioni esterno globale. Per saperne di più, consulta Gestisci il traffico da più regioni.
Nel sottosistema di importazione dati, le funzioni Cloud Run basate su eventi potrebbero riscontrare errori temporanei o ricevere eventi duplicati a causa della distribuzione "at least once". Per gestire questi scenari in modo affidabile, prendi in considerazione le seguenti best practice:
- Progetta funzioni idempotenti in modo che la rielaborazione di un evento produca lo stesso risultato senza creare record duplicati.
- Configura i tentativi di ripetizione delle funzioni basate su eventi con backoff esponenziale sul trigger Pub/Sub per eseguire il ripristino in caso di errori downstream temporanei.
- Configura un argomento messaggi non recapitabili Pub/Sub per isolare i messaggi che non vengono elaborati ripetutamente per l'ispezione e la riproduzione separate.
Cloud Storage
Puoi creare bucket Cloud Storage in uno dei tre tipi di località: regionale, a due regioni o multiregionale. Per i dati nei bucket regionali, Cloud Storage li replica in modo sincrono in più zone all'interno di una regione. Per una maggiore disponibilità, puoi utilizzare bucket a due regioni o multiregionali, in cui Cloud Storage replica i dati in modo asincrono tra le regioni. Assicurati che la tua scelta sia in linea con i requisiti di conformità.
Ottimizzazione dei costi
Questa sezione fornisce indicazioni per ottimizzare i costi di configurazione e gestione di una topologia Google Cloud creata utilizzando questa architettura di riferimento.
Per i principi e i suggerimenti di ottimizzazione dei costi specifici per i workload di AI e ML, consulta Prospettiva di AI e ML: ottimizzazione dei costi nel Well-Architected Framework.
Agent Platform
Il modello di AI sottostante richiamato dall'agente può influire direttamente sul costo di utilizzo dell'agente. I prezzi vengono calcolati in base al numero di token di input e output per ogni richiesta. Per saperne di più, consulta Quote e limiti di sistema dell'AI generativa su Agent Platform e il Calcolatore prezzi diGoogle Cloud .
Per informazioni su come ridurre al minimo il numero di token per ridurre i costi, consulta la panoramica della memorizzazione nella cache del contesto.
Cloud Run
Per ottimizzare il costo dei servizi Cloud Run e delle funzioni Cloud Run, tieni presente i seguenti suggerimenti:
- Impostazioni di fatturazione: scegli un'impostazione di fatturazione appropriata in base al tuo pattern di traffico. Utilizza la fatturazione basata sulle richieste (impostazione predefinita) per workload sporadici o con picchi, come Cloud Run Functions basate su eventi nella pipeline di importazione dati, in modo da pagare per la CPU e la memoria solo durante l'elaborazione delle richieste. Per i servizi Cloud Run con traffico costante e prevedibile, prendi in considerazione la fatturazione basata sulle istanze, che elimina la tariffa per richiesta e addebita una tariffa di computing al secondo inferiore.
- CPU, memoria e contemporaneità: inizia con le allocazioni predefinite di CPU e memoria e regola il limite di CPU e il limite di memoria in base all'utilizzo monitorato. Ottimizza il numero massimo di richieste in parallelo per istanza in modo che un numero inferiore di istanze possa gestire le richieste di I/O in parallelo (ad esempio l'attesa delle risposte del modello o dell'API).
- Limiti di scalabilità delle istanze: configura il numero massimo di istanze per limitare i costi di scalabilità durante picchi di traffico imprevisti e bilancia il numero minimo di istanze in base ai requisiti di latenza di avvio a freddo.
- Sconti per impegno di utilizzo: se puoi prevedere i requisiti di computing dei tuoi workload Cloud Run, puoi ridurre i costi con gli sconti per impegno di utilizzo di Cloud Run.
Per saperne di più, consulta le best practice per i servizi Cloud Run ottimizzati in termini di costi.
Cloud Storage
Per il bucket Cloud Storage che utilizzi per caricare i dati nel sottosistema di importazione dati, scegli una classe di archiviazione appropriata in base ai requisiti di conservazione dei dati e di frequenza di accesso dei tuoi workload. Ad esempio, puoi scegliere la classe di archiviazione Standard Storage e utilizzare Gestione del ciclo di vita degli oggetti per controllare i costi di archiviazione. Gestione del ciclo di vita degli oggetti esegue automaticamente il downgrade degli oggetti a una classe di archiviazione a costo inferiore o li elimina in base alle condizioni impostate.
Ottimizzazione delle prestazioni
Questa sezione descrive le considerazioni e i suggerimenti per la progettazione di una topologia in Google Cloud che soddisfi i requisiti di prestazioni dei tuoi workload.
Per i principi e i suggerimenti di ottimizzazione delle prestazioni specifici per i workload di AI e ML, consulta Prospettiva di AI e ML: ottimizzazione delle prestazioni nel Well-Architected Framework.
Gemini Enterprise
Per ridurre la latenza durante la pubblicazione, trasmetti le risposte in streaming inviando le risposte del modello prima che l'agente generi l'output completo. In questo modo, l'output viene elaborato in tempo reale e puoi aggiornare immediatamente l'interfaccia utente ed eseguire altre attività contemporaneamente. Lo streaming migliora la reattività percepita e crea un'esperienza utente più interattiva. Per saperne di più, consulta Visualizza i risultati di ricerca utilizzando StreamAssist.
Quando crei e registri agenti Agent Development Kit (ADK) personalizzati su Agent Runtime, riduci al minimo gli hop sequenziali tra più agenti, i round trip degli strumenti e i passaggi di riepilogo ridondanti per ridurre la latenza dei turni end-to-end. Per saperne di più, consulta Best practice per prestazioni e affidabilità.
Cloud Run
Regola le allocazioni di CPU e memoria per i servizi Cloud Run e Cloud Run Functions in base ai requisiti di prestazioni del workload. Per ridurre la latenza dell'avvio a freddo durante lo scale up da zero, attiva il boost della CPU all'avvio per fornire temporaneamente CPU aggiuntiva durante l'avvio dell'istanza container oppure configura il numero minimo di istanze per mantenere le istanze in uso. Per saperne di più, consulta Configura i limiti della CPU per i servizi e Configura i limiti di memoria per i servizi.
Cloud Storage
Per caricare file di grandi dimensioni, puoi utilizzare un metodo chiamato caricamenti compositi paralleli. Con questa strategia, il file di grandi dimensioni viene suddiviso in blocchi. Carichi i blocchi in Cloud Storage in parallelo, quindi Cloud Storage riassembla i dati in Google Cloud. I caricamenti compositi paralleli possono essere più veloci delle normali operazioni di caricamento se disponi di larghezza di banda di rete e velocità del disco sufficienti. Tuttavia, questa strategia presenta alcune limitazioni e implicazioni in termini di costi. Per saperne di più, consulta Caricamenti compositi paralleli.
Deployment
Per eseguire il deployment di questa architettura di riferimento, utilizza l'esempio Terraform disponibile su GitHub. Per saperne di più, consulta Infrastruttura RAG per applicazioni di AI generativa che utilizzano Gemini Enterprise e Agent Platform.
Passaggi successivi
- Scopri come Gemini Enterprise suddivide i documenti per RAG.
- Scopri come ospitare app di AI e agenti su Cloud Run.
- Scopri di più sulle best practice per l'AI responsabile e sui filtri di sicurezza di Agent Platform.
- Scopri le strategie di prompting per gli LLM.
- Per una panoramica dei principi e dei suggerimenti di architettura specifici per i workload di AI e ML in Google Cloud, consulta la prospettiva di AI e ML nel Well-Architected Framework.
- Per ulteriori architetture di riferimento, diagrammi e best practice, esplora Cloud Architecture Center.
Collaboratori
Autore: Samantha He | Technical Writer
Altri collaboratori:
- Deepak Michael | Networking Specialist Customer Engineer
- Kumar Dhanagopal | Cross-Product Solution Developer
- Mark Schlagenhauf | Technical Writer, Networking
- Victor Moreno | Product Manager, Cloud Networking
- Yehia Elshater | Field Solutions Architect, AI generativa, Google Cloud
- Paarth Mahajan | Network Specialist, Google Cloud