


Dokumen ini menyediakan arsitektur referensi yang dapat Anda gunakan untuk mendesain infrastruktur aplikasi AI generatif dengan retrieval-augmented generation (RAG) menggunakan Gemini Enterprise dan Gemini Enterprise Agent Platform. Arsitektur referensi ini menunjukkan cara menggunakan layanan terkelola dan men-deploy satu agen AI untuk memfasilitasi aliran data RAG menyeluruh. Gemini Enterprise berfungsi sebagai platform terpadu untuk orkestrasi agen di seluruh perusahaan. Agent Platform mempercepat pengembangan dan deployment agen kustom serta menyediakan datastore terkelola untuk memfasilitasi pengambilan yang efisien untuk RAG.
Audiens yang dituju untuk dokumen ini mencakup arsitek, developer, dan administrator aplikasi AI generatif. Dokumen ini mengasumsikan bahwa Anda memiliki pemahaman dasar tentang konsep AI, machine learning (ML), dan model bahasa besar (LLM). Dokumen ini tidak memberikan panduan tentang cara mendesain dan mengembangkan aplikasi AI generatif. Untuk mengetahui informasi tentang cara mendesain aplikasi, lihat Mengembangkan aplikasi AI generatif.
Arsitektur
Diagram berikut menunjukkan tampilan tingkat tinggi dari arsitektur yang disajikan dalam dokumen ini:

Arsitektur dalam diagram sebelumnya memiliki dua subsistem: penyerapan data dan penyajian.
- Subsistem penyerapan data menyerap dan menyiapkan data dari sumber eksternal untuk digunakan dalam RAG. Subsistem ini menghasilkan embedding untuk data yang diserap dan menggunakannya untuk membangun dan memelihara indeks vektor yang dapat ditelusuri di datastore terkelola.
- Subsistem penyajian berisi layanan frontend dan layanan backend aplikasi AI generatif.
- Layanan frontend menangani alur kueri-respons dengan pengguna aplikasi dan meneruskan kueri ke layanan backend.
- Layanan backend menggunakan Gemini Enterprise dan Agent Platform untuk membangun dan men-deploy agen AI Anda guna mengatur proses RAG. Proses ini menggunakan data vektor yang diindeks untuk menghasilkan respons yang didasarkan pada konteks dan mematuhi filter keamanan Responsible AI.
Diagram berikut menunjukkan tampilan mendetail arsitektur:
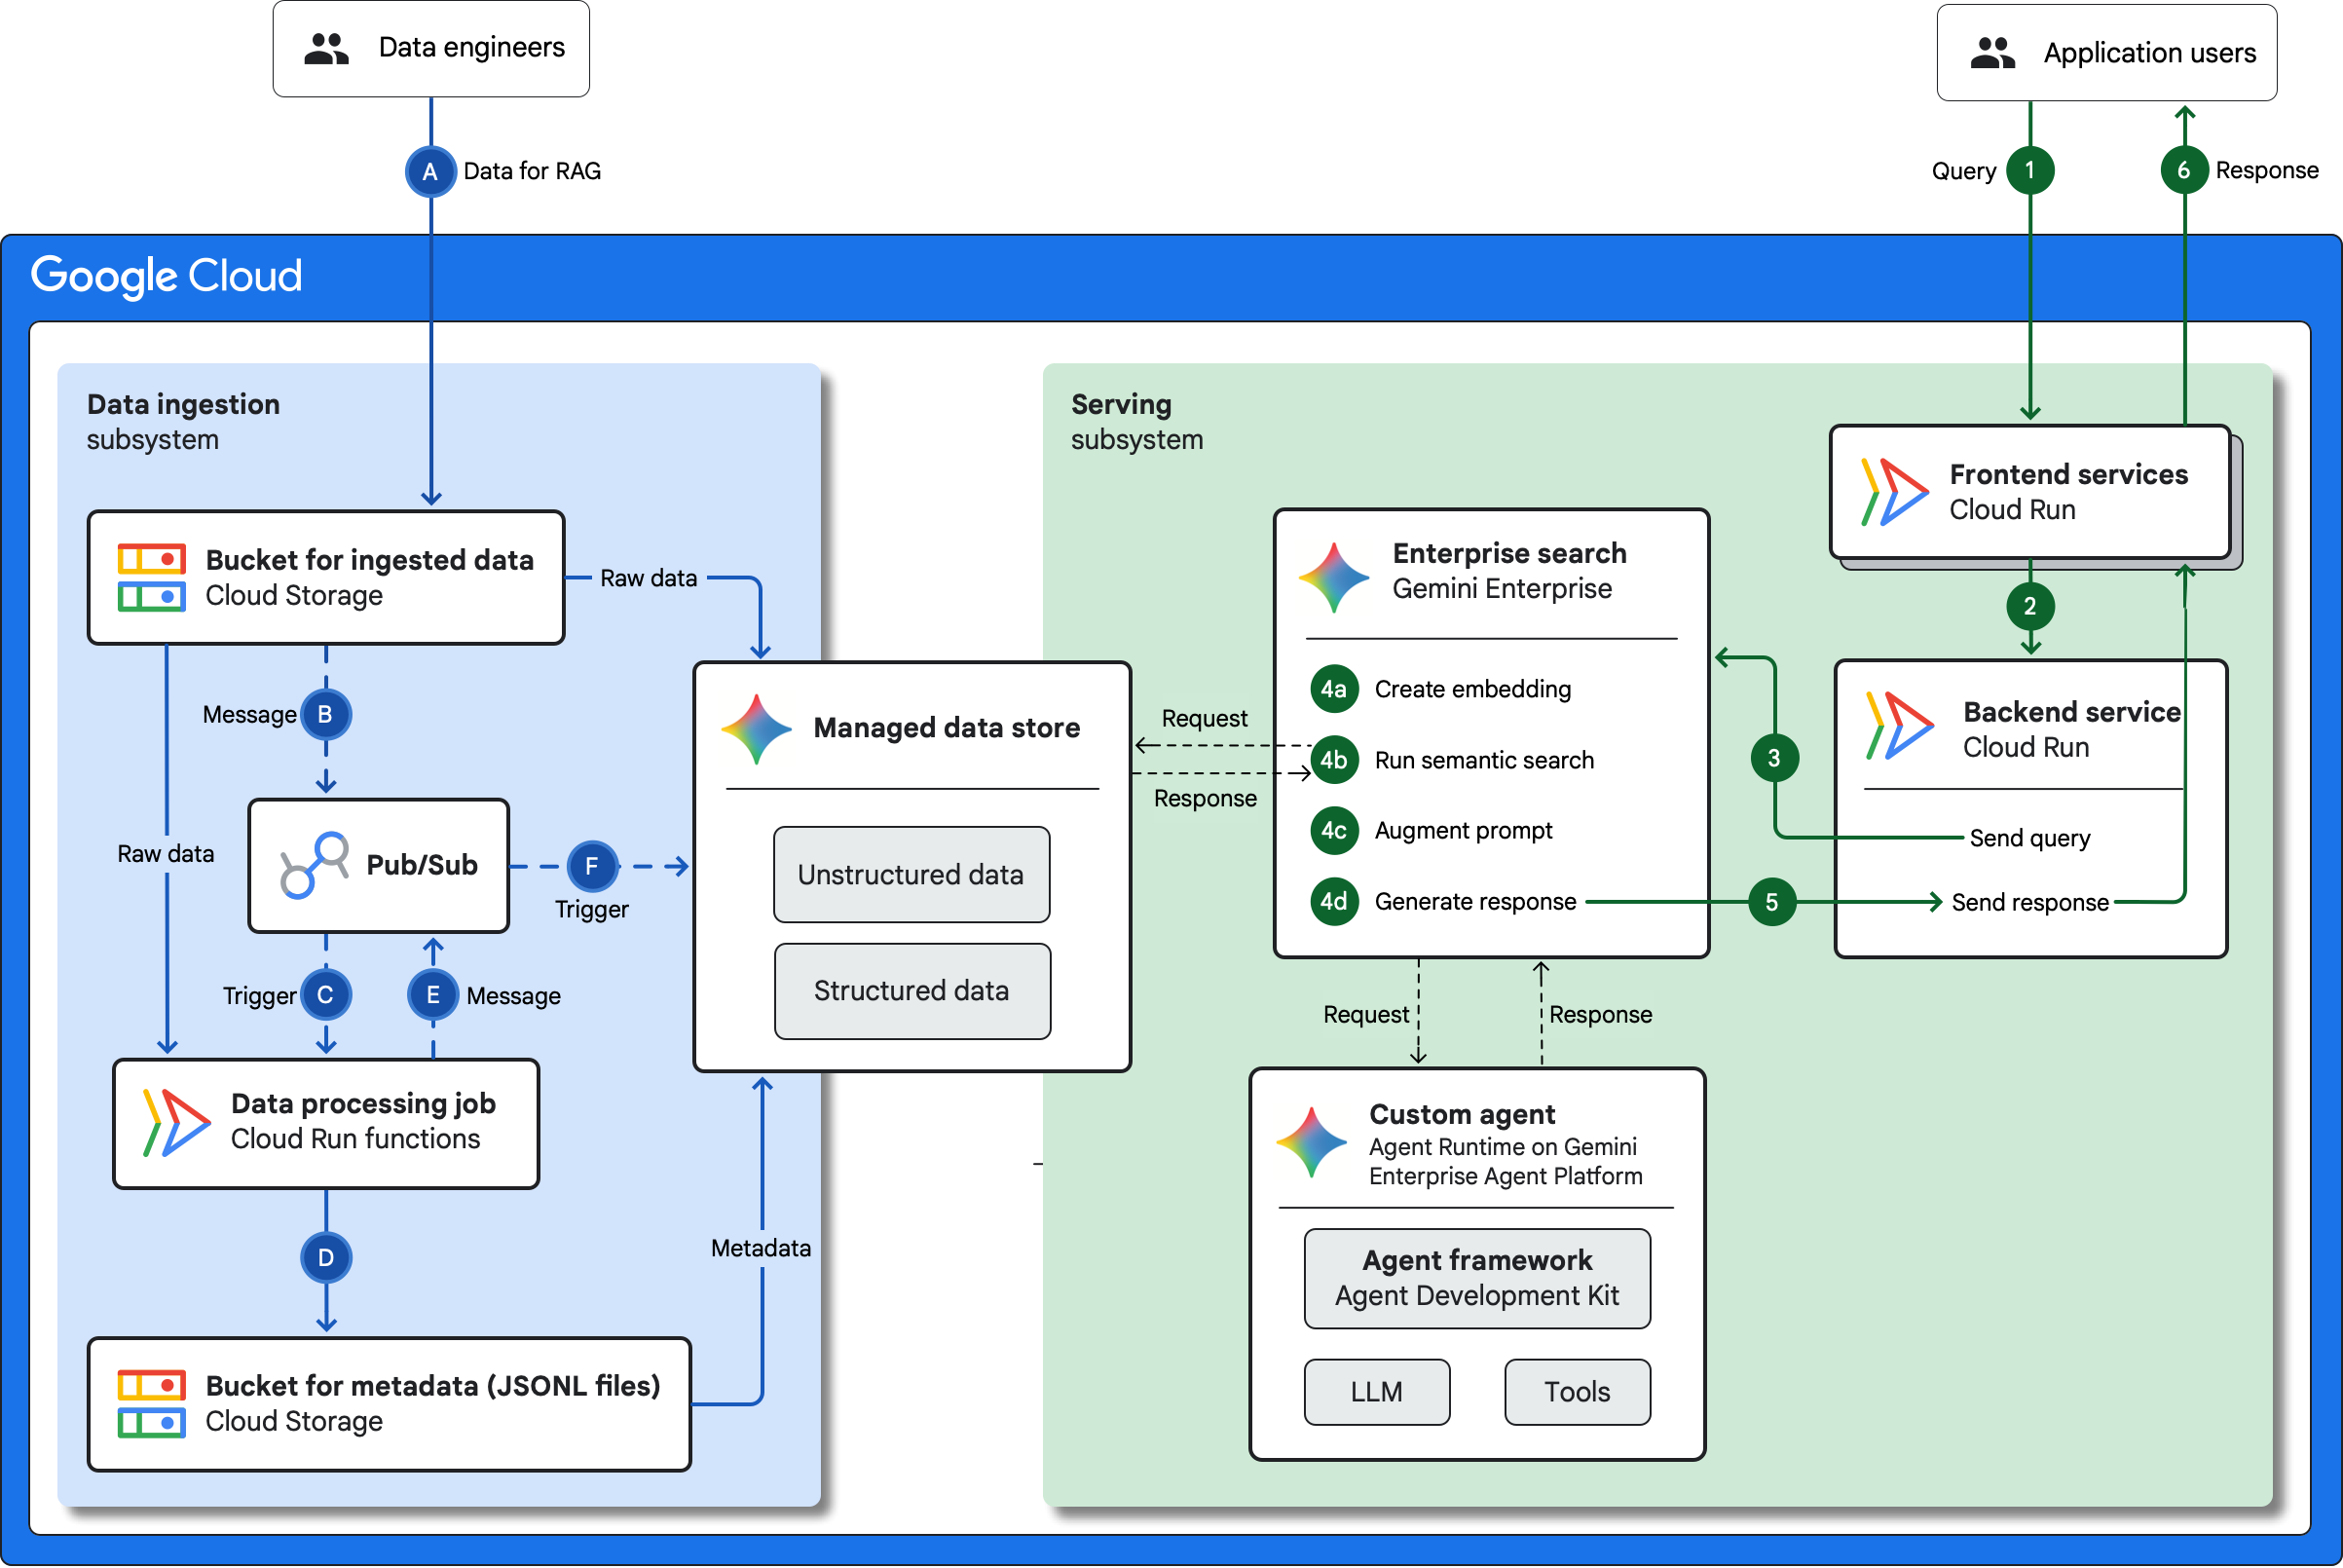
Bagian berikut menjelaskan aliran data dalam setiap subsistem dari diagram arsitektur sebelumnya.
Subsistem penyerapan data
Subsistem penyerapan data menyerap data dari sumber eksternal dan menyiapkan data untuk RAG. Berikut adalah langkah-langkah dalam alur penyerapan dan persiapan data:
- Data engineer mengupload data dari sumber eksternal ke bucket Cloud Storage. Sumber eksternal dapat berupa aplikasi, database, atau layanan streaming.
- Setelah selesai, Cloud Storage akan memublikasikan pesan ke topik Pub/Sub.
- Topik Pub/Sub memicu tugas pemrosesan untuk dijalankan di Cloud Run Functions.
- Cloud Run Functions memproses data mentah dengan membuat dan menyimpan metadata sebagai file JSON Lines (JSONL). File JSONL disimpan di bucket Cloud Storage terpisah.
- Setelah selesai, fungsi Cloud Run memublikasikan pesan ke topik Pub/Sub.
- Topik Pub/Sub memicu fungsi Cloud Run downstream yang memanggil
metode
documents.importDiscovery Engine API untuk memulai tugas impor di penyimpanan data terkelola dalam Gemini Enterprise. Tugas impor mengambil data dan metadata mentah yang diserap dari bucket Cloud Storage, lalu mengurai dan membagi data untuk pengambilan yang efisien selama inferensi. Gemini Enterprise otomatis menghasilkan embedding vektor tanpa memerlukan konfigurasi apa pun.
Subsistem inferensi
Subsistem inferensi menangani aliran kueri-respons antara aplikasi AI generatif dan penggunanya. Berikut adalah langkah-langkah dalam alur inferensi:
- Pengguna aplikasi mengirim kueri melalui salah satu layanan frontend Cloud Run. Anda dapat menyesuaikan layanan ini untuk berbagai pengalaman, seperti UI chatbot, halaman penelusuran, atau aplikasi seluler.
- Layanan frontend menerima kueri, lalu meneruskan kueri ke layanan backend Cloud Run terpusat. Backend ini menyediakan satu endpoint terpadu untuk mendukung semua klien frontend yang berbeda. Layanan backend juga melakukan pra-pemrosesan yang diperlukan, yang dapat mencakup pembuatan filter untuk kueri penelusuran. Pendekatan ini membuat logika tetap transparan bagi frontend.
- Layanan backend mengirimkan permintaan yang telah disiapkan ke Gemini Enterprise menggunakan endpoint API Gemini Enterprise untuk memulai alur kerja RAG.
- Untuk memproses kueri, Gemini Enterprise menggunakan penelusuran Enterprise dan agen kustom untuk
melakukan tugas-tugas berikut:
- Membuat embedding kueri pengguna.
- Melakukan penelusuran semantik pada data yang diindeks di datastore terkelola untuk menemukan informasi yang paling relevan.
- Perluas kueri asli dengan data yang diambil dari datastore terkelola untuk membuat perintah yang mendetail dan kontekstual.
- Menghasilkan respons akhir yang didasarkan pada perintah yang telah diaugmentasi.
- Gemini Enterprise mengirimkan respons yang dihasilkan ke layanan backend Cloud Run.
- Layanan backend menampilkan respons akhir ke layanan frontend yang mengirim permintaan asli. Layanan frontend menampilkan jawaban kepada pengguna aplikasi.
Produk yang digunakan
Arsitektur referensi ini menggunakan produk Google Cloud berikut:
- Gemini Enterprise: Platform aman yang terkelola sepenuhnya untuk men-deploy dan mengelola agen AI dalam perusahaan.
- Gemini Enterprise Agent Platform: Platform komprehensif yang memungkinkan Anda membangun, menskalakan, mengatur, dan mengoptimalkan agen AI tingkat perusahaan.
- Agent Runtime di Gemini Enterprise Agent Platform: Platform yang memungkinkan Anda menjalankan, mengelola, dan menskalakan agen AI dalam produksi.
- Cloud Run: Platform komputasi serverless yang memungkinkan Anda menjalankan container langsung di atas infrastruktur Google yang skalabel.
- Cloud Run Functions: Platform komputasi serverless yang memungkinkan Anda menjalankan fungsi bertujuan tunggal langsung di Google Cloud.
- Pub/Sub: Layanan pesan asinkron dan skalabel yang memisahkan layanan yang menghasilkan pesan dari layanan yang memproses pesan tersebut.
- Cloud Storage: Penyimpanan objek berbiaya rendah dan tanpa batas untuk beragam jenis data. Data dapat diakses dari dalam dan luar Google Cloud, serta direplikasi di berbagai lokasi untuk redundansi.
Kasus penggunaan
Arsitektur ini dirancang untuk skenario perusahaan tempat aplikasi AI generatif Anda memerlukan akses ke informasi terbaru dan pemahaman kontekstual yang mendalam untuk memberikan respons yang akurat.
Arsitektur ini mencakup subsistem penyerapan data kustom untuk memenuhi dua persyaratan utama perusahaan:
- Ketersediaan data real-time: Pipeline berbasis peristiwa memproses data baru segera setelah tersedia di organisasi Anda—misalnya, panduan produk baru atau laporan yang diperbarui. Pipeline ini juga menyediakan informasi di datastore terkelola Anda. Desain ini membantu mengurangi keusangan informasi karena membantu meminimalkan penundaan antara ketersediaan dan penggunaan data.
- Penelusuran kontekstual yang diperkaya: Tugas pemrosesan kustom memungkinkan organisasi Anda menerapkan logika bisnisnya sendiri untuk memperkaya data dengan metadata yang berharga. Fungsi Cloud Run dapat memberi tag pada setiap dokumen dengan atribut tertentu seperti lini produk, penulis, lokasi, atau jenis dokumen. Metadata yang lengkap ini membantu agen mempersempit penelusuran dan memberikan jawaban yang lebih akurat dan sesuai konteks.
RAG adalah teknik yang efektif untuk meningkatkan kualitas output yang dihasilkan dari LLM. Bagian ini memberikan contoh kasus penggunaan yang dapat Anda gunakan untuk aplikasi AI generatif berkemampuan RAG.
Rekomendasi produk yang dipersonalisasi
Situs belanja online mungkin menggunakan chatbot yang didukung LLM untuk membantu pelanggan menemukan produk atau mendapatkan bantuan terkait belanja. Pertanyaan dari pengguna dapat ditambah dengan menggunakan data historis tentang perilaku pembelian dan pola interaksi situs pengguna. Data tersebut dapat mencakup ulasan dan masukan pengguna yang disimpan di penyimpanan data tidak terstruktur atau metrik terkait penelusuran yang disimpan di data warehouse analisis web. Pertanyaan yang telah diaugmentasi kemudian dapat diproses oleh LLM untuk menghasilkan respons yang dipersonalisasi yang mungkin lebih menarik dan meyakinkan bagi pengguna.
Sistem bantuan klinis
Tenaga klinis di rumah sakit perlu meninjau dan menyintesis informasi kesehatan pasien untuk membuat keputusan perawatan yang tepat. Aplikasi AI generatif yang menggunakan model dasar medis seperti MedGemma dapat membantu tenaga klinis meringkas catatan klinis dan meninjau konteks medis. Respons yang dihasilkan aplikasi dapat didasarkan pada catatan kesehatan pasien historis dengan mengontekstualisasikan perintah dengan data dari database rekam medis elektronik (EHR) rumah sakit atau dari pusat informasi eksternal seperti PubMed.
Riset hukum yang efisien
Riset hukum yang didukung AI generatif memungkinkan pengacara mengkueri sejumlah besar undang-undang dan yurisprudensi dengan cepat untuk mengidentifikasi preseden hukum yang relevan atau meringkas konsep hukum yang kompleks. Output riset tersebut dapat ditingkatkan dengan menambahkan perintah pengacara dengan data yang diambil dari korpus kontrak milik firma hukum, komunikasi hukum sebelumnya, dan catatan kasus internal. Pendekatan desain ini membantu menghasilkan respons yang relevan dengan domain hukum yang menjadi spesialisasi pengacara tersebut.
Alternatif desain
Bagian ini menyajikan pendekatan desain alternatif yang dapat Anda pertimbangkan untuk aplikasi AI generatif berkemampuan RAG di Google Cloud.
Alternatif infrastruktur AI
Untuk mengetahui daftar panduan arsitektur guna mendesain dan men-deploy aplikasi AI generatif dengan RAG di Google Cloud, lihat AI Generatif dengan RAG.
Opsi hosting aplikasi
Dalam arsitektur yang ditampilkan dalam dokumen ini, Cloud Run adalah host untuk aplikasi AI generatif dan pemrosesan data. Cloud Run adalah platform yang berfokus pada developer dan terkelola sepenuhnya. Anda juga dapat men-deploy aplikasi ke Agent Runtime di Gemini Enterprise Agent Platform, cluster Google Kubernetes Engine (GKE), atau ke VM Compute Engine.
Untuk memilih host aplikasi, pertimbangkan konsekuensi berikut antara fleksibilitas konfigurasi dan upaya pengelolaan:
- Dengan opsi Cloud Run serverless, Anda men-deploy layanan kustom ke lingkungan terkelola yang telah dikonfigurasi sebelumnya. Untuk menghosting layanan frontend dan logika backend kustom untuk pra-pemrosesan permintaan, arsitektur ini memerlukan kemampuan untuk men-deploy aplikasi kustom.
- Dengan opsi Agent Runtime, Anda menggunakan platform yang terkelola sepenuhnya yang dirancang untuk penyaluran agen. Agent Runtime mengurangi overhead pengelolaan dan menyediakan integrasi yang erat dengan Gemini Enterprise.
- Dengan VM Compute Engine dan container GKE, Anda bertanggung jawab untuk mengelola resource komputasi yang mendasarinya, tetapi Anda memiliki fleksibilitas dan kontrol konfigurasi yang lebih besar.
Untuk mengetahui informasi selengkapnya tentang cara memilih layanan hosting aplikasi yang sesuai, lihat dokumen berikut:
Opsi infrastruktur lainnya
Untuk mengetahui informasi tentang opsi infrastruktur lainnya, model yang didukung, dan teknik grounding yang dapat Anda gunakan untuk aplikasi AI generatif di Google Cloud, lihat Memilih model dan infrastruktur untuk aplikasi AI generatif Anda.
Pertimbangan desain
Bagian ini memberikan panduan untuk membantu Anda mengembangkan arsitektur AI generatif yang mendukung RAG di Google Cloud yang memenuhi persyaratan spesifik Anda terkait keamanan dan kepatuhan, keandalan, biaya, serta performa. Panduan di bagian ini tidak lengkap. Bergantung pada persyaratan spesifik aplikasi AI generatif Anda serta produk dan fitur Google Cloud yang Anda gunakan, Anda mungkin perlu mempertimbangkan faktor desain dan kompromi tambahan.
Untuk ringkasan prinsip dan rekomendasi arsitektur yang khusus untuk workload AI dan ML di Google Cloud, lihat Perspektif AI dan ML dalam Well-Architected Framework.
Keamanan, privasi, dan kepatuhan
Bagian ini menjelaskan pertimbangan dan rekomendasi desain untuk merancang topologi di Google Cloud yang memenuhi persyaratan keamanan dan kepatuhan workload Anda.
Untuk prinsip dan rekomendasi keamanan yang khusus untuk workload AI dan ML, lihat Perspektif AI dan ML: Keamanan dalam Well-Architected Framework.
Agent Platform
Agent Platform mendukung Google Cloud kontrol keamanan yang dapat Anda gunakan untuk memenuhi persyaratan terkait residensi data, enkripsi data, keamanan jaringan, dan transparansi akses. Untuk informasi selengkapnya, lihat dokumentasi berikut:
- Kontrol keamanan untuk layanan machine learning
- Kontrol keamanan untuk AI Generatif
- Agent Platform dan retensi data nol
- Mengaktifkan transparansi akses untuk Gemini Enterprise
- Kontrol kepatuhan dan keamanan untuk Gemini Enterprise
- Kepatuhan Gemini Enterprise
- Penghapusan data di Google Cloud.
Model AI generatif mungkin menghasilkan respons yang berbahaya, terutama jika diminta secara eksplisit untuk memberikan respons tersebut. Untuk meningkatkan keamanan dan memitigasi potensi penyalahgunaan, Anda dapat mengonfigurasi filter konten untuk bertindak sebagai penghalang respons yang berbahaya. Untuk mengetahui informasi selengkapnya, lihat Filter keamanan dan konten.
Cloud Run
Secara default, Cloud Run mengenkripsi data menggunakan Google-owned and Google-managed encryption keys. Untuk melindungi container dengan menggunakan kunci yang Anda kontrol, Anda dapat menggunakan kunci enkripsi yang dikelola pelanggan (CMEK). Untuk informasi selengkapnya, lihat Menggunakan kunci enkripsi yang dikelola pelanggan.
Untuk memastikan bahwa hanya image container resmi yang di-deploy ke Cloud Run, Anda dapat menggunakan Otorisasi Biner.
Cloud Run membantu Anda memenuhi persyaratan residensi data. Fungsi Cloud Run Anda berjalan dalam region yang dipilih.
Cloud Storage
Secara default, Cloud Storage mengenkripsi data yang disimpannya menggunakan Google-owned and Google-managed encryption keys. Jika diperlukan, Anda dapat menggunakan CMEK atau kunci Anda sendiri yang Anda kelola menggunakan metode pengelolaan eksternal seperti kunci enkripsi yang disediakan pelanggan (CSEK). Untuk mengetahui informasi selengkapnya, lihat Opsi enkripsi data.
Cloud Storage mendukung dua metode untuk memberi pengguna akses ke bucket dan objek Anda: Identity and Access Management (IAM) dan daftar kontrol akses (ACL). Dalam sebagian besar kasus, sebaiknya gunakan IAM, yang memungkinkan Anda memberikan izin di level bucket dan project. Untuk informasi selengkapnya, lihat Ringkasan kontrol akses.
Data yang Anda muat ke dalam subsistem penyerapan data melalui Cloud Storage mungkin mencakup data sensitif. Anda dapat menggunakan Sensitive Data Protection untuk menemukan, mengklasifikasikan, dan melakukan de-identifikasi data sensitif. Untuk mengetahui informasi selengkapnya, lihat Menggunakan Sensitive Data Protection dengan Cloud Storage.
Cloud Storage membantu Anda memenuhi persyaratan residensi data. Cloud Storage menyimpan atau mereplikasi data dalam region yang Anda tentukan.
Pub/Sub
Secara default, Pub/Sub mengenkripsi semua pesan, yang mencakup pesan dalam penyimpanan dan dalam pengiriman, menggunakanGoogle-owned and Google-managed encryption keys. Pub/Sub mendukung penggunaan CMEK untuk enkripsi pesan di lapisan aplikasi. Untuk mengetahui informasi selengkapnya, lihat Mengonfigurasi enkripsi pesan.
Jika Anda memiliki persyaratan residensi data, untuk memastikan bahwa data pesan disimpan di lokasi tertentu, Anda dapat mengonfigurasi kebijakan penyimpanan pesan.
Keandalan
Bagian ini menjelaskan pertimbangan dan rekomendasi desain untuk membangun dan mengoperasikan infrastruktur yang andal untuk deployment Anda di Google Cloud.
Untuk prinsip dan rekomendasi keandalan yang khusus untuk workload AI dan ML, lihat Perspektif AI dan ML: Keandalan dalam Well-Architected Framework.
Agent Platform
Agent Platform mendukung residensi data dalam penyimpanan. Agent Platform menyimpan data sumber Anda, yang mencakup data untuk RAG di datastore terkelola, dalamGoogle Cloud lokasi yang telah Anda pilih. Pemisahan pemrosesan dari penyimpanan ini adalah aspek mendasar dari cara platform memberikan keandalan dan kepatuhan yang tinggi.
Cloud Run
Cloud Run adalah layanan regional yang secara otomatis mendistribusikan dan melakukan load balancing pada instance layanan stateless di beberapa zona dalam suatu region. Jika terjadi pemadaman layanan zona, layanan Cloud Run dan Cloud Run Functions akan terus berjalan tanpa gangguan. Untuk ketahanan terhadap pemadaman layanan regional, Anda dapat men-deploy layanan Cloud Run di beberapa region di belakang Load Balancer Aplikasi eksternal global. Untuk mengetahui informasi selengkapnya, lihat Menyajikan traffic dari beberapa region.
Dalam subsistem penyerapan data, fungsi Cloud Run berbasis peristiwa mungkin mengalami kegagalan sementara atau menerima peristiwa duplikat karena pengiriman minimal satu kali. Untuk menangani skenario ini dengan andal, pertimbangkan praktik terbaik berikut:
- Desain fungsi idempoten sehingga pemrosesan ulang peristiwa menghasilkan hasil yang sama tanpa membuat data duplikat.
- Konfigurasikan percobaan ulang fungsi berbasis peristiwa dengan backoff eksponensial pada pemicu Pub/Sub untuk memulihkan dari error downstream sementara.
- Konfigurasikan topik yang dihentikan pengirimannya Pub/Sub untuk mengisolasi pesan yang berulang kali gagal diproses untuk pemeriksaan dan pemutaran ulang terpisah.
Cloud Storage
Anda dapat membuat bucket Cloud Storage di salah satu dari tiga jenis lokasi: regional, dual-region, atau multi-region. Untuk data dalam bucket regional, Cloud Storage mereplikasi data tersebut secara sinkron di beberapa zona dalam satu region. Untuk ketersediaan yang lebih tinggi, Anda dapat menggunakan bucket dual-region atau multi-region, tempat Cloud Storage mereplikasi data secara asinkron di seluruh region. Pastikan pilihan Anda sesuai dengan persyaratan kepatuhan Anda.
Pengoptimalan biaya
Bagian ini berisi panduan untuk mengoptimalkan biaya penyiapan dan pengoperasian topologi Google Cloud yang Anda bangun menggunakan arsitektur referensi ini.
Untuk prinsip dan rekomendasi pengoptimalan biaya yang khusus untuk workload AI dan ML, lihat Perspektif AI dan ML: Pengoptimalan biaya dalam Well-Architected Framework.
Agent Platform
Model AI pokok yang dipanggil agen dapat secara langsung memengaruhi biaya penggunaan agen tersebut. Harga dihitung berdasarkan jumlah token input dan output untuk setiap permintaan. Untuk mengetahui informasi selengkapnya, lihat Kuota dan batas sistem AI Generatif di Agent Platform dan kalkulator hargaGoogle Cloud .
Untuk mengetahui informasi tentang cara meminimalkan jumlah token untuk mengurangi biaya, lihat Ringkasan cache konteks.
Cloud Run
Untuk mengoptimalkan biaya layanan Cloud Run dan fungsi Cloud Run, pertimbangkan rekomendasi berikut:
- Setelan penagihan: Pilih setelan penagihan yang sesuai berdasarkan pola traffic Anda. Gunakan penagihan berbasis permintaan (default) untuk workload yang sporadis atau tidak stabil—seperti Cloud Run Functions berbasis peristiwa dalam pipeline penyerapan data—sehingga Anda hanya membayar CPU dan memori saat permintaan diproses. Untuk layanan Cloud Run dengan traffic yang stabil dan dapat diprediksi, pertimbangkan penagihan berbasis instance, yang menghilangkan biaya per permintaan dan mengenakan tarif komputasi per detik yang lebih rendah.
- CPU, memori, dan konkurensi: Mulailah dengan alokasi CPU dan memori default, lalu sesuaikan batas CPU dan batas memori berdasarkan pemakaian yang dipantau. Sesuaikan permintaan serentak maksimum per instance sehingga lebih sedikit instance yang dapat menangani permintaan terikat I/O serentak (seperti menunggu respons model atau API).
- Batas penskalaan instance: Konfigurasikan instance maksimum untuk membatasi biaya penskalaan selama lonjakan traffic yang tidak terduga, dan seimbangkan instance minimum dengan persyaratan latensi cold-start.
- Diskon abonemen: Jika Anda dapat memprediksi persyaratan komputasi workload Cloud Run, Anda dapat mengurangi biaya dengan diskon abonemen Cloud Run.
Untuk mengetahui informasi selengkapnya, lihat Praktik terbaik untuk layanan Cloud Run yang dioptimalkan biaya.
Cloud Storage
Untuk bucket Cloud Storage yang Anda gunakan untuk memuat data ke subsistem penyerapan data, pilih kelas penyimpanan yang sesuai berdasarkan persyaratan retensi data dan frekuensi akses workload Anda. Misalnya, Anda dapat memilih kelas Standard Storage, dan menggunakan Object Lifecycle Management untuk mengontrol biaya penyimpanan. Object Lifecycle Management secara otomatis mendowngrade objek ke kelas penyimpanan yang lebih murah atau menghapus objek berdasarkan kondisi yang Anda tetapkan.
Pengoptimalan performa
Bagian ini menjelaskan pertimbangan dan rekomendasi desain untuk merancang topologi di Google Cloud yang memenuhi persyaratan performa workload Anda.
Untuk mengetahui prinsip dan rekomendasi pengoptimalan performa yang khusus untuk workload AI dan ML, lihat Perspektif AI dan ML: Pengoptimalan performa dalam Well-Architected Framework.
Gemini Enterprise
Untuk mengurangi latensi selama inferensi, lakukan streaming respons dengan mengirimkan respons model sebelum agen menghasilkan output lengkap. Hal ini memungkinkan pemrosesan output secara real-time, dan Anda dapat segera memperbarui antarmuka pengguna serta melakukan tugas serentak lainnya. Streaming meningkatkan responsivitas yang dirasakan dan menciptakan pengalaman pengguna yang lebih interaktif. Untuk mengetahui informasi selengkapnya, lihat Mendapatkan hasil penelusuran menggunakan StreamAssist.
Saat Anda membangun dan mendaftarkan agen Agent Development Kit (ADK) kustom di Agent Runtime, minimalkan hop multi-agen berurutan, perjalanan bolak-balik alat, dan penerusan ringkasan yang redundan untuk mengurangi latensi giliran end-to-end. Untuk mengetahui informasi selengkapnya, lihat Praktik terbaik untuk performa dan keandalan.
Cloud Run
Sesuaikan alokasi CPU dan memori untuk layanan Cloud Run dan Cloud Run Functions berdasarkan persyaratan performa workload. Untuk mengurangi latensi cold start saat melakukan penskalaan dari nol, aktifkan penguatan CPU saat startup untuk menyediakan CPU tambahan untuk sementara selama startup instance container, atau konfigurasikan instance minimum agar instance tetap aktif. Untuk mengetahui informasi selengkapnya, lihat Mengonfigurasi batas CPU untuk layanan dan Mengonfigurasi batas memori untuk layanan.
Cloud Storage
Untuk mengupload file besar, Anda dapat menggunakan metode yang disebut upload gabungan paralel. Dengan strategi ini, file besar dibagi menjadi beberapa bagian. Anda mengupload potongan ke Cloud Storage secara paralel, lalu Cloud Storage akan menyusun ulang data di Google Cloud. Upload komposit paralel dapat lebih cepat daripada operasi upload reguler jika Anda memiliki bandwidth jaringan dan kecepatan disk yang memadai. Namun, strategi ini memiliki beberapa keterbatasan dan implikasi biaya. Untuk mengetahui informasi selengkapnya, lihat Upload komposit paralel.
Deployment
Untuk men-deploy arsitektur referensi ini, gunakan contoh Terraform yang tersedia di GitHub. Untuk mengetahui informasi selengkapnya, lihat Infrastruktur RAG untuk Aplikasi AI Generatif menggunakan Gemini Enterprise dan Agent Platform.
Langkah berikutnya
- Pelajari cara Gemini Enterprise membagi dokumen untuk RAG.
- Pelajari cara menghosting aplikasi dan agen AI di Cloud Run.
- Pelajari praktik terbaik responsible AI dan filter keamanan Agent Platform.
- Pelajari strategi perintah untuk LLM.
- Untuk ringkasan prinsip dan rekomendasi arsitektur yang khusus untuk workload AI dan ML di Google Cloud, lihat Perspektif AI dan ML dalam Well-Architected Framework.
- Untuk mengetahui lebih banyak tentang arsitektur referensi, diagram, dan praktik terbaik lainnya, jelajahi Pusat Arsitektur Cloud.
Kontributor
Penulis: Samantha He | Technical Writer
Kontributor lainnya:
- Deepak Michael | Networking Specialist Customer Engineer
- Kumar Dhanagopal | Developer Solusi Lintas Produk
- Mark Schlagenhauf | Technical Writer, Networking
- Victor Moreno | Product Manager, Cloud Networking
- Yehia Elshater | Field Solutions Architect, Generative AI, Google Cloud
- Paarth Mahajan | Network Specialist, Google Cloud