


Questo documento fornisce un'architettura di riferimento che puoi utilizzare per progettare l'infrastruttura per eseguire un'applicazione di intelligenza artificiale (AI) generativa con Retrieval-Augmented Generation (RAG). Il pubblico di destinazione di questo documento include sviluppatori e amministratori di applicazioni di AI generativa e architetti cloud. Il documento presuppone una conoscenza di base dei concetti di AI, machine learning (ML) e modelli linguistici di grandi dimensioni (LLM). Questo documento non fornisce indicazioni su come progettare e sviluppare un'applicazione di AI generativa.
Architettura
Il seguente diagramma mostra una visualizzazione di alto livello di un'architettura per un'applicazione di AI generativa compatibile con RAG in Google Cloud:

L'architettura contiene i seguenti componenti interconnessi:
- Sottosistema di acquisizione dei dati
- Il sottosistema di importazione dati prepara ed elabora i dati esterni utilizzati per abilitare la funzionalità RAG. Interagisce con gli altri sottosistemi dell'architettura tramite il livello del database.
- Sottosistema di pubblicazione
- Il sottosistema di gestione gestisce il flusso di richiesta-risposta tra l'applicazione di AI generativa e i suoi utenti. Interagisce con il sottosistema di importazione dei dati tramite il livello del database.
- Sottosistema di valutazione della qualità
- Il sottosistema di valutazione della qualità valuta la qualità delle risposte generate dal sottosistema di gestione. Interagisce direttamente con il sottosistema di pubblicazione e con il sottosistema di importazione dati tramite il livello del database.
- Database
Tutti i sottosistemi dell'architettura interagiscono con i database. I database archiviano i seguenti dati:
- Prompt
- Vector embedding dei dati utilizzati per RAG
- Configurazioni delle funzioni serverless nei sottosistemi di importazione dati e valutazione della qualità
Il seguente diagramma mostra una visualizzazione dettagliata dell'architettura:
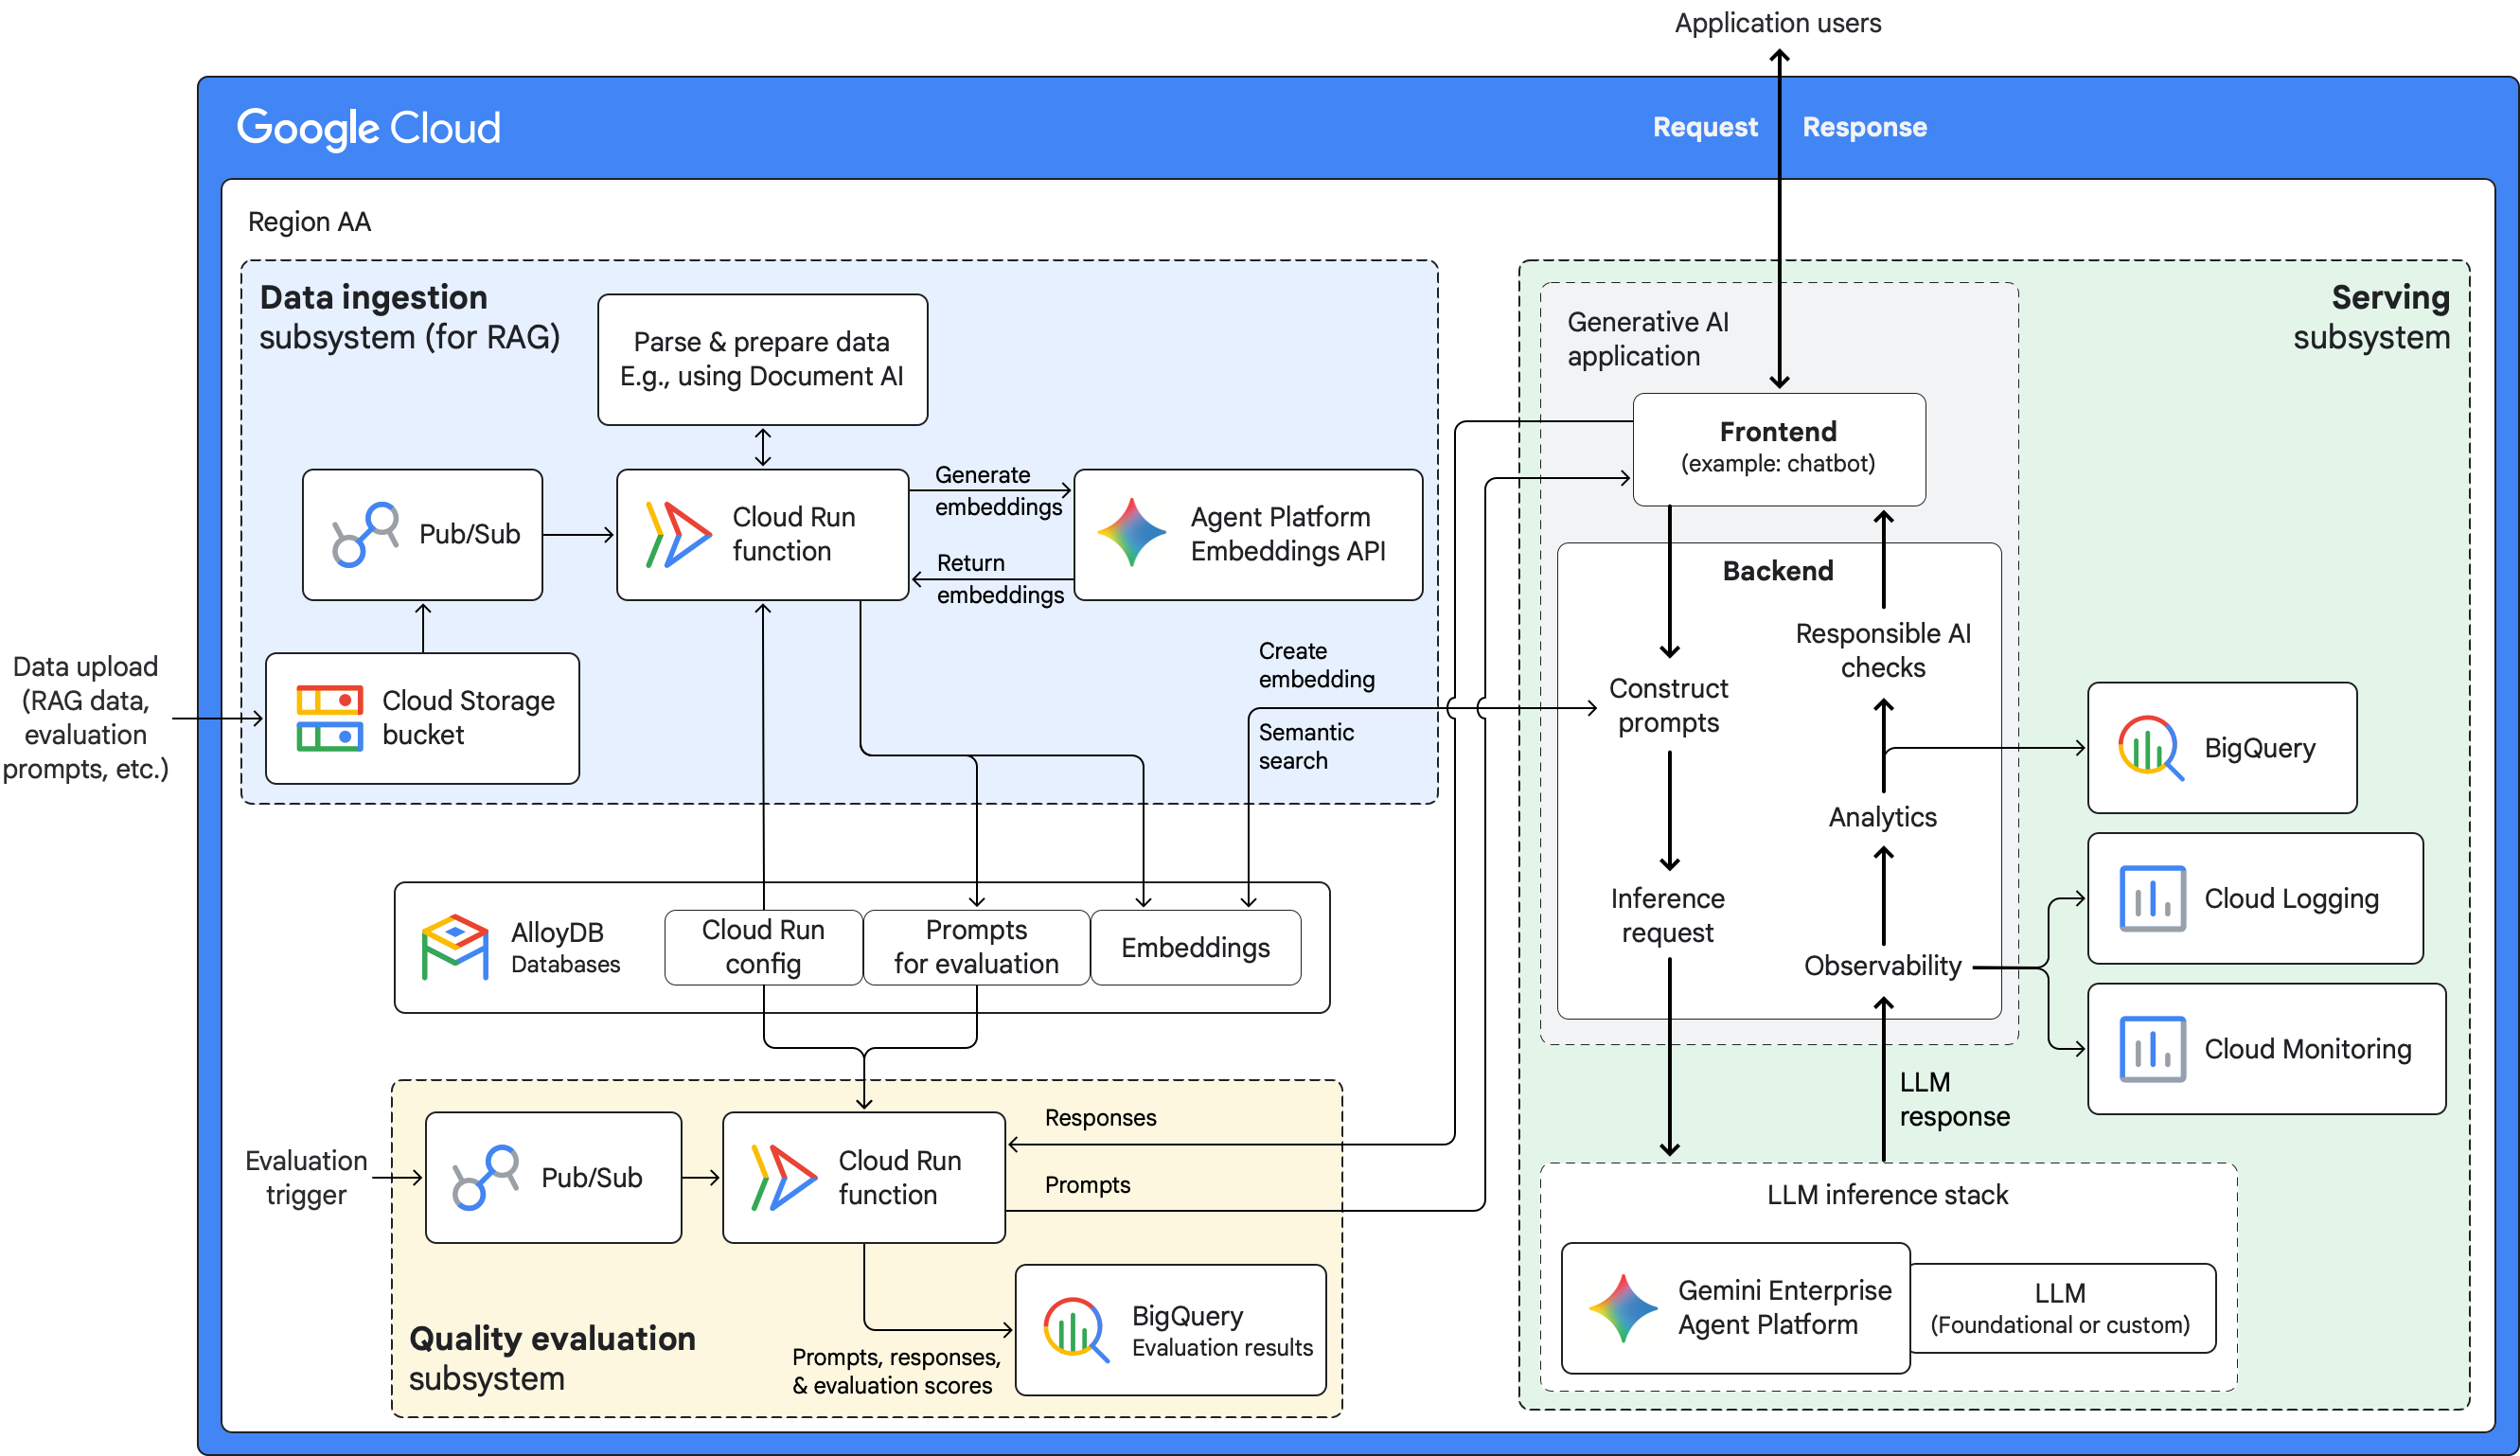
Le sezioni seguenti forniscono descrizioni dettagliate dei componenti e del flusso di dati all'interno di ogni sottosistema dell'architettura.
Sottosistema di acquisizione dei dati
Il sottosistema di importazione dati acquisisce i dati da origini esterne come file, database e servizi di streaming. I dati caricati includono prompt per la valutazione della qualità. Il sottosistema di importazione dati fornisce la funzionalità RAG nell'architettura. Il seguente diagramma mostra i dettagli del sottosistema di importazione dati nell'architettura:
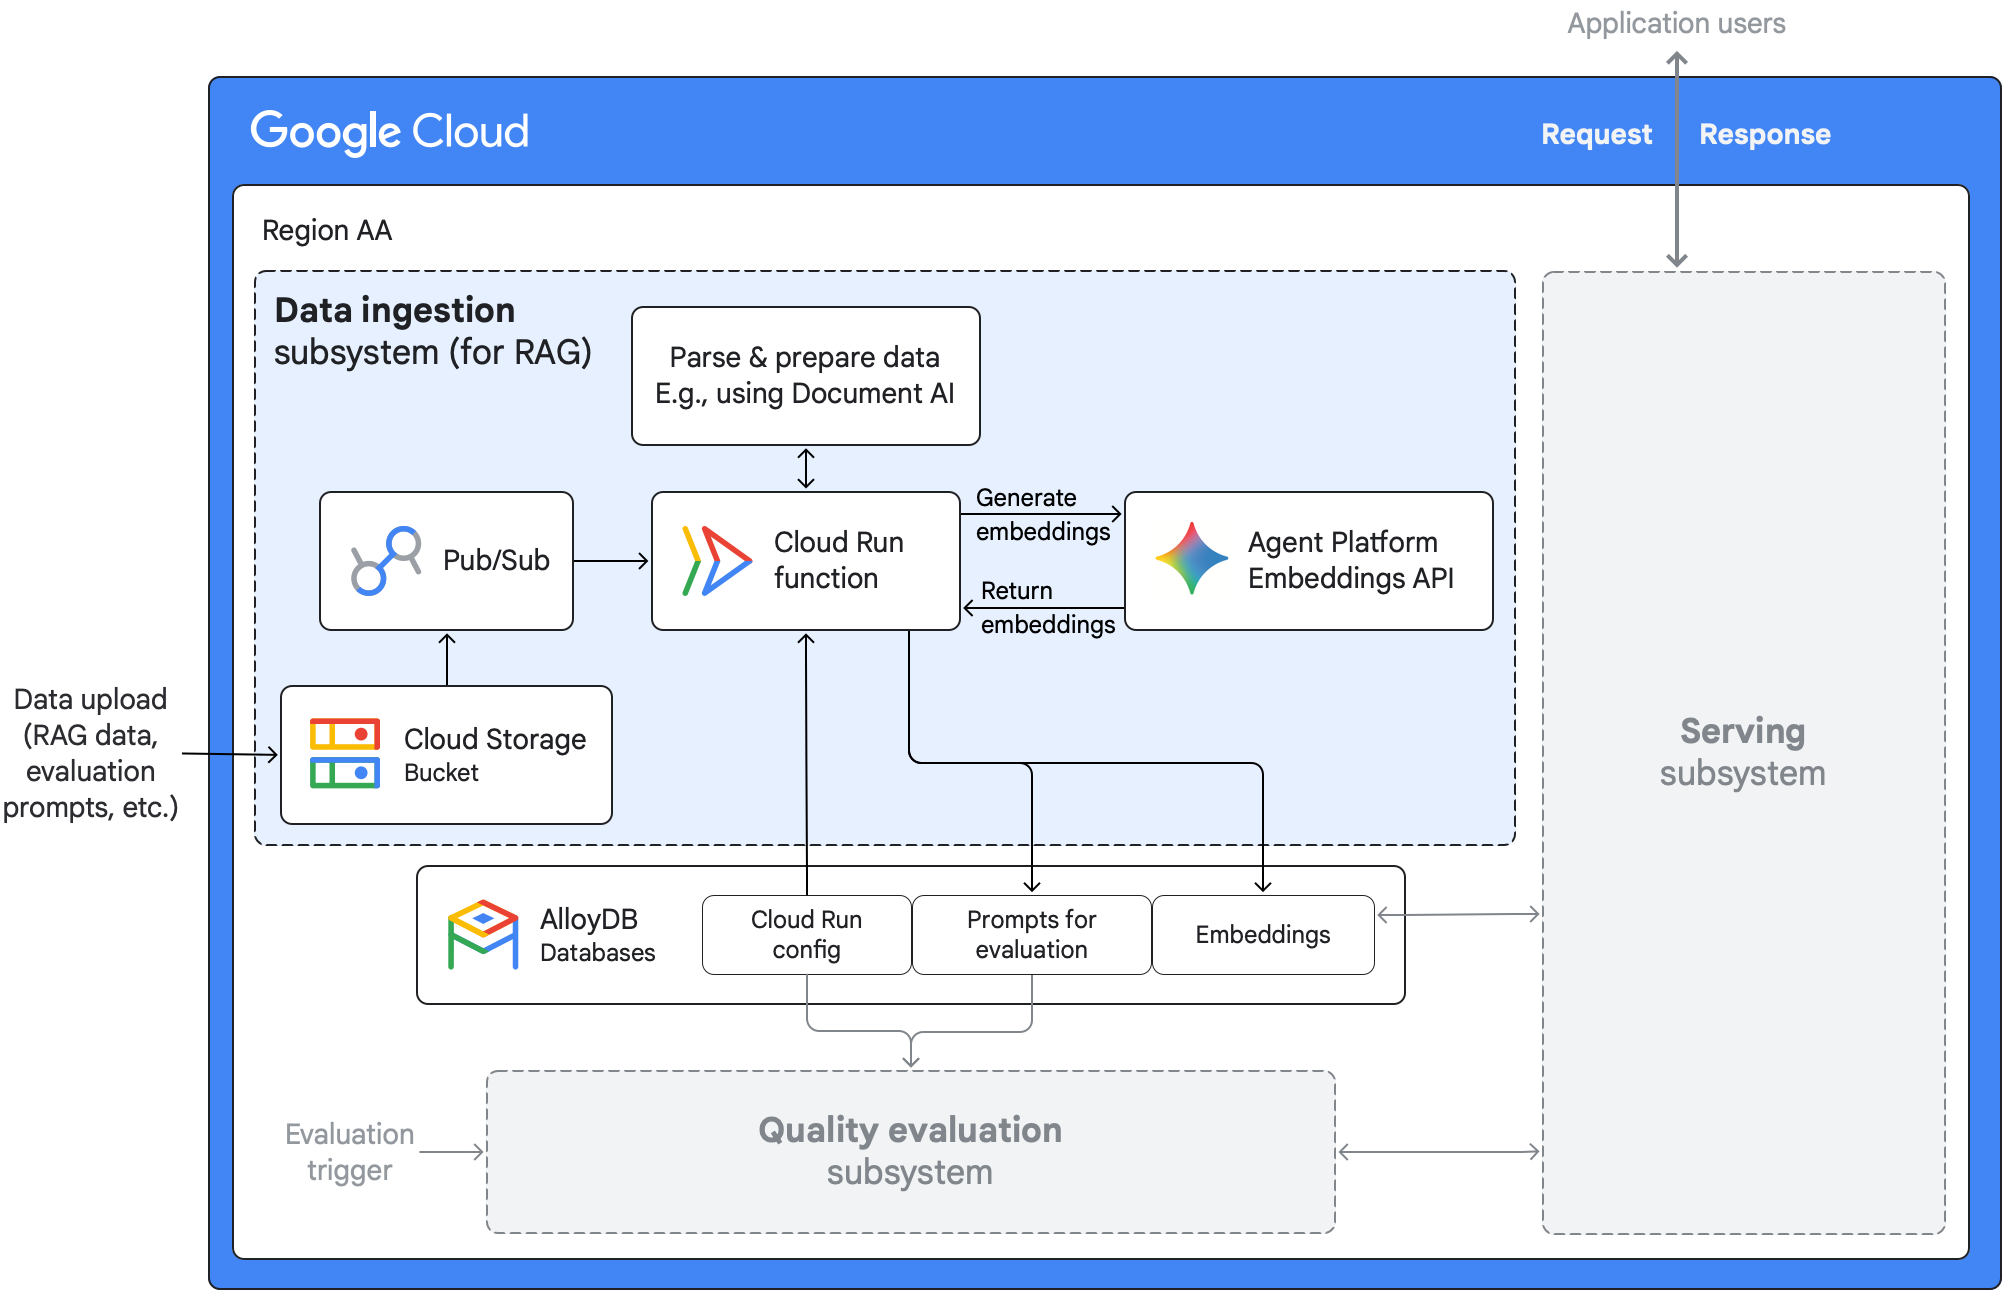
Di seguito sono riportati i passaggi del flusso di importazione dei dati:
- I dati sono caricati su un bucket Cloud Storage. Le origini dati possono essere applicazioni, database o servizi di streaming.
- Quando i dati vengono caricati su Cloud Storage, viene pubblicato un messaggio in un argomento Pub/Sub.
- Pub/Sub attiva una funzione Cloud Run per elaborare i dati caricati.
- La funzione viene avviata utilizzando i dati di configurazione archiviati in un database AlloyDB per PostgreSQL.
- La funzione analizza i dati non elaborati, li formatta come richiesto e poi li suddivide in blocchi.
La funzione utilizza un modello di embedding appropriato su Gemini Enterprise Agent Platform per creare vector embedding dei dati importati.
La funzione archivia gli embedding in un database AlloyDB con l'estensione
vectorcompatibile conpgvectorabilitata. Come descritto nella sezione seguente, quando il sottosistema di pubblicazione elabora le richieste degli utenti, utilizza gli embedding nel database vettoriale per recuperare i dati pertinenti specifici del dominio.
Sottosistema di pubblicazione
Il sottosistema di gestione gestisce il flusso di richiesta-risposta tra l'applicazione di AI generativa e i suoi utenti. Il seguente diagramma mostra i dettagli del sottosistema di distribuzione nell'architettura:
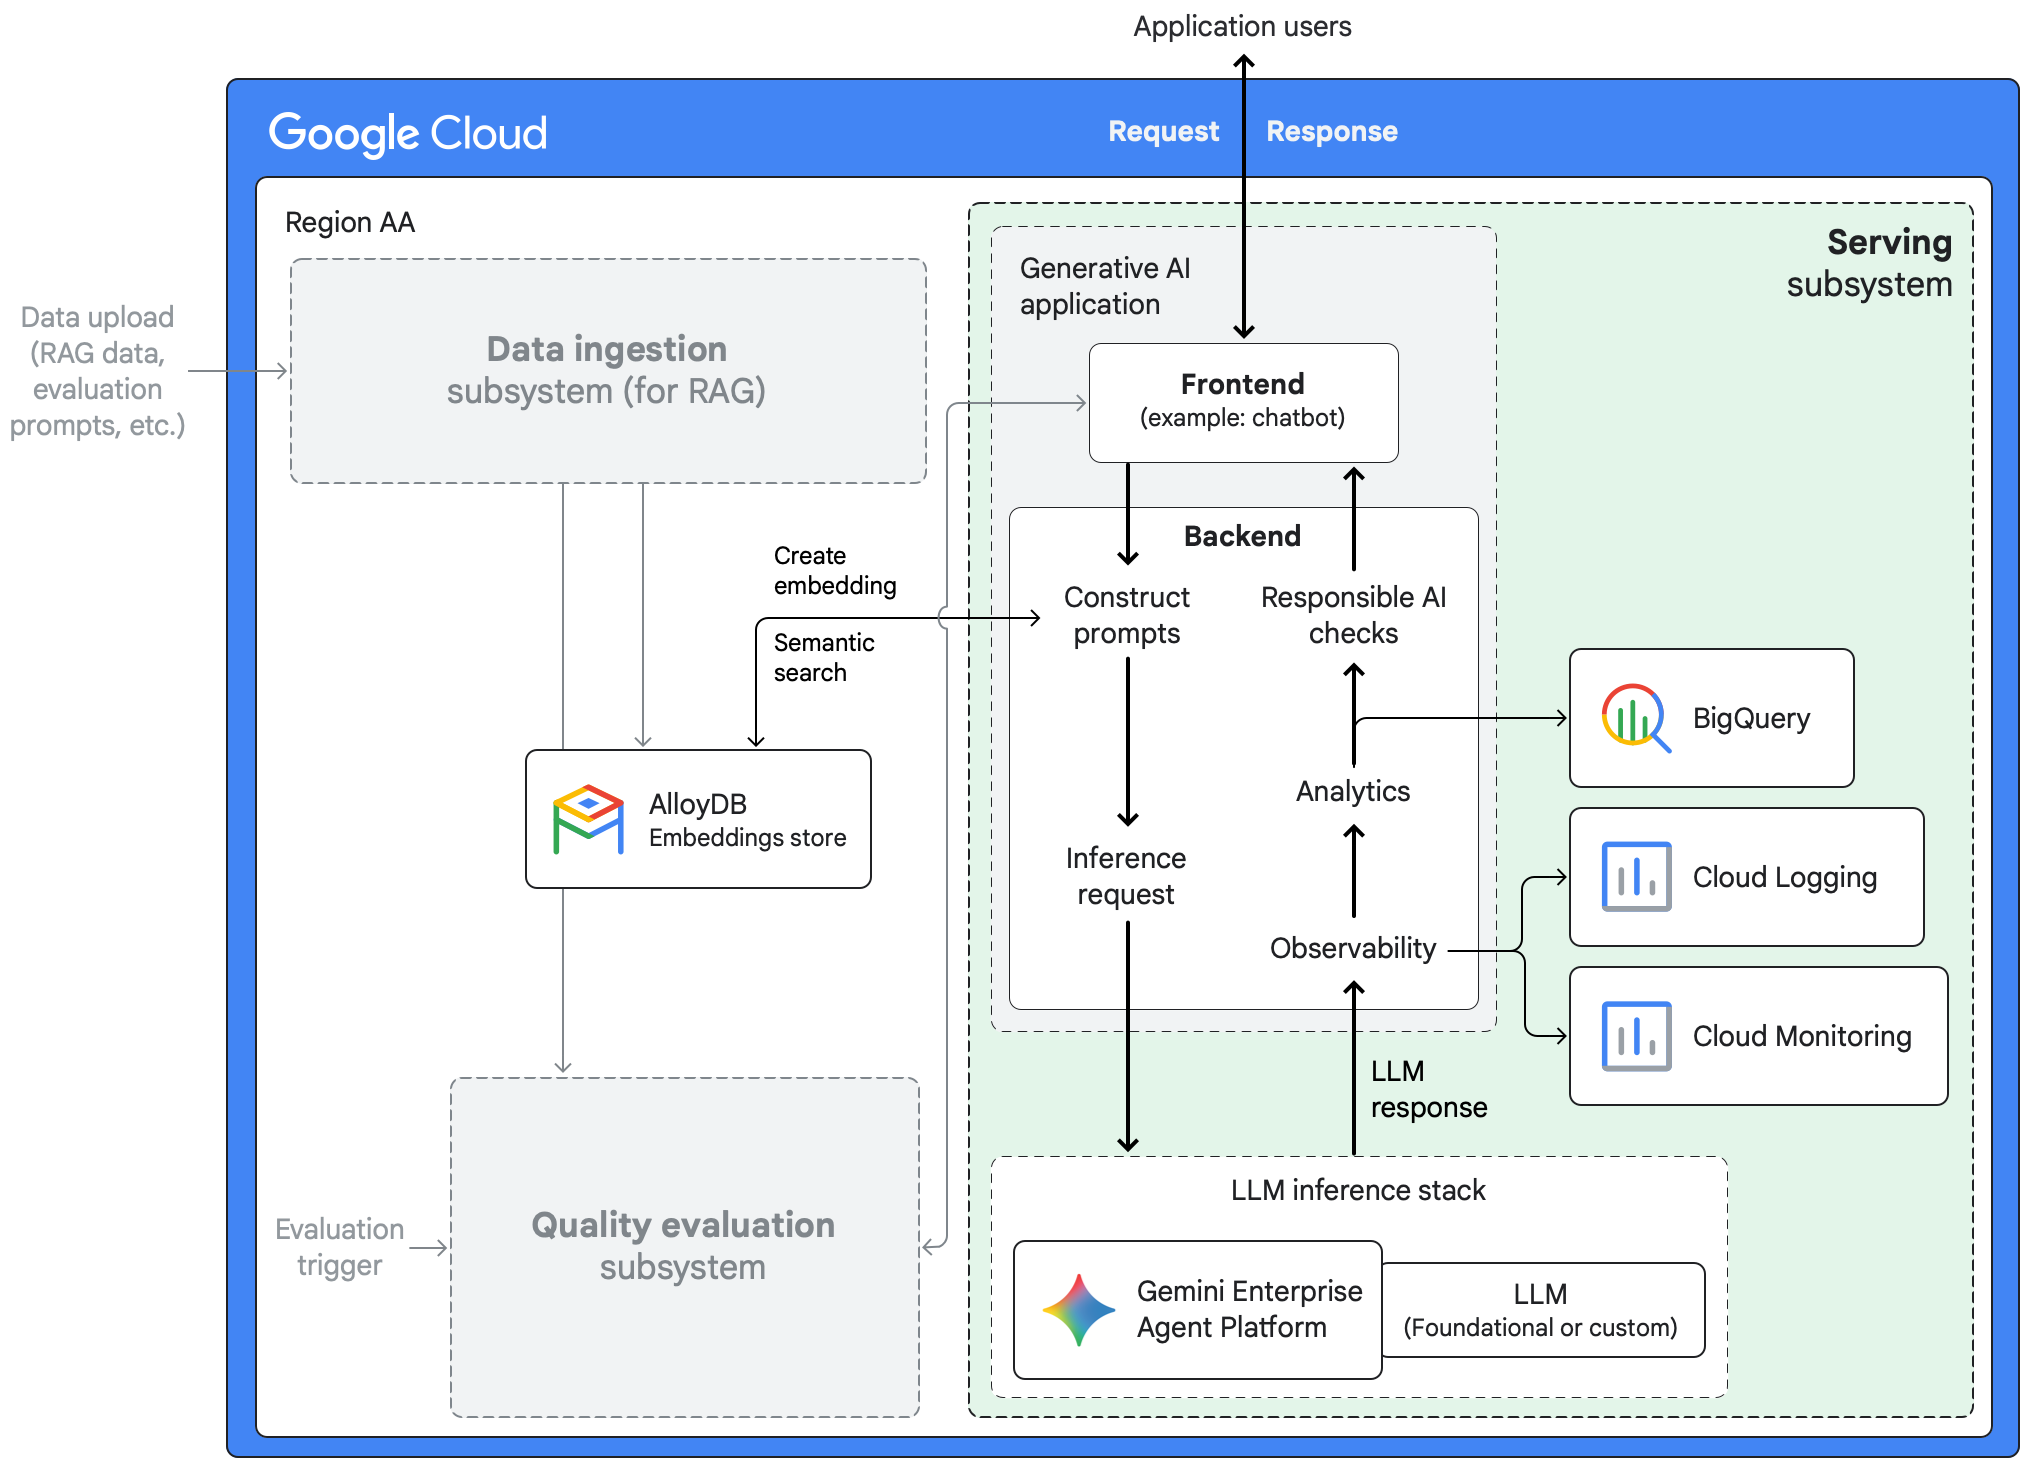
Di seguito sono riportati i passaggi del flusso di richiesta-risposta nel sottosistema di pubblicazione:
- Gli utenti inviano richieste all'applicazione di AI generativa tramite un frontend (ad esempio un chatbot o un'app mobile).
L'applicazione di AI generativa converte la richiesta in linguaggio naturale in embedding.
L'applicazione completa la parte di recupero dell'approccio RAG:
- L'applicazione esegue una ricerca semantica dell'embedding nel vector store AlloyDB gestito dal sottosistema di importazione dati. La ricerca semantica aiuta a trovare gli embedding in base all'intent di un prompt anziché ai suoi contenuti testuali.
- L'applicazione combina la richiesta originale con i dati non elaborati recuperati in base all'embedding corrispondente per creare un prompt contestualizzato.
L'applicazione invia il prompt contestualizzato a uno stack di inferenza LLM eseguito su Agent Platform.
Lo stack di inferenza LLM utilizza un LLM di AI generativa, che può essere un LLM di base o un LLM personalizzato, e genera una risposta limitata al contesto fornito.
- L'applicazione può archiviare i log dell'attività di richiesta-risposta in Cloud Logging. Puoi visualizzare e utilizzare i log per il monitoraggio utilizzando Cloud Monitoring. Google non accede ai dati di log né li utilizza.
- L'applicazione carica le risposte in BigQuery per l'analisi offline.
L'applicazione filtra le risposte utilizzando i filtri di AI responsabile.
L'applicazione invia le risposte filtrate agli utenti tramite il frontend.
Sottosistema di valutazione della qualità
Il seguente diagramma mostra i dettagli del sottosistema di valutazione della qualità nell'architettura:

Quando il sottosistema di valutazione della qualità riceve una richiesta, esegue le seguenti operazioni:
- Pub/Sub attiva una funzione Cloud Run.
- La funzione viene avviata utilizzando i dati di configurazione archiviati in un database AlloyDB.
- La funzione estrae i prompt di valutazione da un database AlloyDB. I prompt sono stati precedentemente caricati nel database dal sottosistema di importazione dati.
La funzione utilizza i prompt di valutazione per valutare la qualità delle risposte generate dal sottosistema di pubblicazione.
L'output di questa valutazione è costituito da punteggi di valutazione per metriche come l'accuratezza oggettiva e la pertinenza.
La funzione carica i punteggi di valutazione, i prompt e le risposte valutati in BigQuery per analisi future.
Prodotti utilizzati
Di seguito è riportato un riepilogo di tutti i prodotti Google Cloud utilizzati dall'architettura precedente:
- Gemini Enterprise Agent Platform: una piattaforma completa che ti consente di creare, scalare, gestire e ottimizzare agenti AI di livello enterprise.
- Cloud Run Functions: una piattaforma di serverless computing che ti consente di eseguire funzioni con un unico scopo direttamente in Google Cloud.
- BigQuery: un data warehouse aziendale che ti aiuta a gestire e analizzare i tuoi dati con funzionalità integrate come machine learning, analisi geospaziale e business intelligence.
- Cloud Storage: un archivio di oggetti a basso costo e senza limiti per diversi tipi di dati. I dati sono accessibili dall'interno e dall'esterno di Google Cloude vengono replicati in più località per la ridondanza.
- AlloyDB per PostgreSQL: un servizio di database completamente gestito e compatibile con PostgreSQL, progettato per i carichi di lavoro più impegnativi, tra cui l'elaborazione analitica e transazionale ibrida.
- Pub/Sub: un servizio di messaggistica asincrono e scalabile che disaccoppia i servizi che producono messaggi dai servizi che li elaborano.
- Cloud Logging: un sistema di gestione dei log in tempo reale con archiviazione, ricerca, analisi e avvisi.
- Cloud Monitoring: un servizio che fornisce visibilità su prestazioni, disponibilità e integrità delle tue applicazioni e dell'infrastruttura.
Casi d'uso
La RAG è una tecnica efficace per migliorare la qualità dell'output generato da un LLM. Questa sezione fornisce esempi di casi d'uso per i quali puoi utilizzare applicazioni di AI generativa compatibili con RAG.
Suggerimenti personalizzati sui prodotti
Un sito di acquisti online potrebbe utilizzare un chatbot basato su LLM per aiutare i clienti a trovare prodotti o ricevere assistenza relativa agli acquisti. Le domande di un utente possono essere migliorate utilizzando i dati storici sul comportamento di acquisto dell'utente e sui modelli di interazione con il sito web. I dati potrebbero includere recensioni e feedback degli utenti archiviati in un datastore non strutturato o metriche relative alla ricerca archiviate in un data warehouse di analisi dei dati web. La domanda migliorata può quindi essere elaborata dall'LLM per generare risposte personalizzate che l'utente potrebbe trovare più interessanti e accattivanti.
Sistemi di assistenza clinica
I medici negli ospedali devono esaminare e sintetizzare le informazioni sanitarie dei pazienti per prendere decisioni di cura informate. Un'applicazione di AI generativa che utilizza un foundation model medico come MedGemma può aiutare i medici a riassumere le note cliniche e a esaminare il contesto medico. Le risposte generate dall'applicazione possono essere basate su cartelle cliniche storiche dei pazienti contestualizzando i prompt con i dati del database della cartella clinica elettronica (EHR) dell'ospedale o di una knowledge base esterna come PubMed.
Ricerca legale efficiente
La ricerca legale basata sull'AI generativa consente agli avvocati di eseguire rapidamente query su grandi volumi di statuti e giurisprudenza per identificare precedenti legali pertinenti o riassumere concetti legali complessi. I risultati di questa ricerca possono essere migliorati integrando i prompt di un avvocato con i dati recuperati dal corpus proprietario di contratti, comunicazioni legali passate e registri interni dei casi dello studio legale. Questo approccio di progettazione aiuta a generare risposte pertinenti al dominio legale in cui l'avvocato è specializzato.
Alternative di progettazione
Questa sezione presenta approcci di progettazione alternativi che puoi prendere in considerazione per la tua applicazione di AI generativa compatibile con RAG in Google Cloud.
Framework RAG gestito
Per orchestrare workflow LLM con aggiunta del contesto senza creare una pipeline di importazione e recupero personalizzata, puoi utilizzare RAG Engine su Gemini Enterprise Agent Platform. Il motore RAG gestisce l'importazione dati, il chunking, la generazione di embedding, l'indicizzazione e il recupero per i workload RAG.
Vector Search completamente gestito
Se hai bisogno di un'architettura che utilizzi un prodotto di ricerca vettoriale completamente gestito, puoi utilizzare Agent Platform e Vector Search, che fornisce un'infrastruttura di gestione ottimizzata per la ricerca vettoriale su larga scala. Per ulteriori informazioni, consulta Infrastruttura RAG per l'AI generativa che utilizza Agent Platform e Vector Search.
Strumenti e modelli open source
Se vuoi creare ed eseguire rapidamente il deployment di applicazioni di AI generativa compatibili con RAG utilizzando strumenti e modelli open source Ray, Hugging Face e LangChain, consulta Infrastruttura RAG per l'AI generativa utilizzando GKE e Cloud SQL.
Considerazioni sulla progettazione
Questa sezione fornisce indicazioni per aiutarti a sviluppare un'architettura di AI generativa compatibile con RAG in Google Cloud che soddisfi i tuoi requisiti specifici di sicurezza e conformità, affidabilità, costi e prestazioni. Le indicazioni riportate in questa sezione non sono esaustive. A seconda dei requisiti specifici della tua applicazione di AI generativa e dei prodotti e delle funzionalità Google Cloud che utilizzi, potresti dover considerare ulteriori fattori di progettazione e compromessi.
Sicurezza e conformità
Questa sezione descrive i fattori da considerare quando progetti e crei un'applicazione di AI generativa compatibile con RAG in Google Cloud che soddisfi i tuoi requisiti di sicurezza e conformità.
Considerazioni sulla sicurezza di Agent Platform
Per assicurarti che le configurazioni e l'utilizzo della piattaforma Agent soddisfino i tuoi requisiti di sicurezza, tieni conto dei seguenti fattori di progettazione e suggerimenti:
Controlli di sicurezza: Agent Platform supporta Google Cloud controlli di sicurezza che puoi utilizzare per soddisfare i tuoi requisiti di residenza dei dati, crittografia dei dati, sicurezza di rete e Access Transparency. Per saperne di più, consulta Controlli di sicurezza per i servizi di machine learning e Controlli di sicurezza per l'AI generativa.
Screening di prompt e risposte: per eseguire lo screening dei prompt RAG e delle risposte del modello per prompt injection, tentativi di jailbreak, contenuti dannosi e fughe di dati sensibili, utilizza i modelli e i filtri di Model Armor.
Crittografia dei dati di Cloud Run Functions
Per proteggere i tuoi dati utilizzando una chiave che controlli, puoi utilizzare le chiavi di crittografia gestite dal cliente (CMEK).
Considerazioni sulla sicurezza di AlloyDB
Per assicurarti che la configurazione di AlloyDB soddisfi i tuoi requisiti di sicurezza, tieni presente i seguenti suggerimenti:
- Crittografia dei dati: per impostazione predefinita, i dati archiviati in AlloyDB vengono criptati utilizzandoGoogle-owned and Google-managed encryption keys. Se devi utilizzare chiavi di crittografia che controlli e gestisci, puoi utilizzare le CMEK. Per saperne di più, consulta Informazioni su CMEK.
- Controllo della rete: per mitigare il rischio di esfiltrazione di dati dai database AlloyDB, puoi creare un perimetro di servizio utilizzando i Controlli di servizio VPC.
- Sicurezza della connessione: per impostazione predefinita, un'istanza AlloyDB accetta solo connessioni che utilizzano SSL. Per proteggere ulteriormente le connessioni ai tuoi database AlloyDB, puoi utilizzare il connettore proxy di autenticazione AlloyDB. Il connettore Auth Proxy fornisce l'autorizzazione della connessione basata su Identity and Access Management (IAM) e utilizza una connessione TLS 1.3 con un algoritmo di crittografia AES a 256 bit per verificare le identità di client e server e criptare il traffico di dati. Per saperne di più, consulta Informazioni sul proxy di autenticazione AlloyDB. Per le connessioni create utilizzando Java, Python, Go o Node.js, utilizza il connettore di linguaggio appropriato anziché il connettore proxy di autenticazione.
- Residenza dei dati: AlloyDB ti aiuta a soddisfare i requisiti di residenza dei dati. I dati vengono archiviati o replicati all'interno delle regioni specificate.
Considerazioni sulla sicurezza di BigQuery
Per assicurarti che la configurazione di BigQuery soddisfi i tuoi requisiti di sicurezza, tieni presente i seguenti suggerimenti:
- Governance dei dati: BigQuery offre molte funzionalità che puoi utilizzare per controllare l'accesso ai dati, proteggere i dati sensibili e contribuire a garantire l'accuratezza e la coerenza dei dati. Per saperne di più, consulta Introduzione alla governance dei dati in BigQuery.
- Residenza dei dati: BigQuery ti aiuta a soddisfare i requisiti di residenza dei dati. I dati vengono archiviati nella regione specificata.
Considerazioni sulla sicurezza di Cloud Storage
Per assicurarti che la configurazione di Cloud Storage soddisfi i tuoi requisiti di sicurezza, tieni presente i seguenti suggerimenti:
- Crittografia dei dati: per impostazione predefinita, i dati archiviati in Cloud Storage vengono criptati utilizzando Google-owned and Google-managed encryption keys. Se necessario, puoi utilizzare le CMEK o le tue chiavi, che gestisci utilizzando un metodo di gestione esterno, ad esempio le chiavi di crittografia fornite dal cliente (CSEK). Per saperne di più, consulta Opzioni di crittografia dei dati.
- Controllo degli accessi: Cloud Storage supporta due metodi per concedere agli utenti l'accesso ai bucket e agli oggetti: IAM ed elenchi di controllo dell'accesso (ACL). Nella maggior parte dei casi, utilizza IAM, che ti consente di concedere autorizzazioni a livello di bucket e di progetto. Per saperne di più, consulta Panoramica del controllo dell'accesso.
- Protezione dei dati: i dati che carichi nel sottosistema di importazione dati tramite Cloud Storage potrebbero includere dati sensibili. Per proteggere questi dati, puoi utilizzare Sensitive Data Protection per individuarli, classificarli e anonimizzarli. Per saperne di più, consulta Utilizzo di Sensitive Data Protection con Cloud Storage.
- Residenza dei dati: Cloud Storage ti aiuta a soddisfare i requisiti di residenza dei dati. I dati vengono archiviati o replicati all'interno delle regioni che specifichi.
Considerazioni sulla sicurezza di Pub/Sub
Per assicurarti che la configurazione di Pub/Sub soddisfi i tuoi requisiti di sicurezza, tieni presente i seguenti suggerimenti:
- Crittografia dei dati: per impostazione predefinita, Pub/Sub cripta tutti i messaggi, sia at-rest che in transito, utilizzando Google-owned and Google-managed encryption keys. Pub/Sub supporta l'utilizzo di CMEK per la crittografia dei messaggi a livello di applicazione. Per saperne di più, consulta Configura la crittografia dei messaggi.
- Residenza dei dati: se hai requisiti di residenza dei dati, per garantire che i dati dei messaggi vengano archiviati in località specifiche, puoi configurare policy di archiviazione dei messaggi.
Considerazioni sulla sicurezza di Cloud Logging
Per assicurarti che la configurazione di Cloud Logging soddisfi i tuoi requisiti di sicurezza, tieni conto dei seguenti fattori di progettazione e suggerimenti:
- Audit delle attività amministrative: gli audit log delle attività di amministrazione sono attivati per impostazione predefinita per tutti i servizi Google Cloud utilizzati in questa architettura di riferimento. Questi log registrano le chiamate API o altre azioni che modificano la configurazione o i metadati delle risorse Google Cloud .
- Controllo dell'accesso ai dati: gli audit log per l'accesso ai dati sono abilitati per impostazione predefinita per BigQuery. Per gli altri servizi utilizzati in questa architettura, puoi attivare i log di controllo dell'accesso ai dati. I log ti consentono di monitorare le chiamate API che leggono la configurazione o i metadati delle risorse o le richieste degli utenti di creare, modificare o leggere i dati delle risorse forniti dagli utenti.
- Residenza dei dati: per soddisfare i requisiti di residenza dei dati, puoi configurare Cloud Logging in modo che archivi i dati di log nella regione che specifichi. Per saperne di più, consulta Assegna una regione ai log.
Per i principi e i suggerimenti di sicurezza specifici per i workload di AI e ML, consulta Prospettiva di AI e ML: sicurezza nel framework Well-Architected.
Affidabilità
Questa sezione descrive i fattori di progettazione da considerare per creare e gestire un'infrastruttura affidabile per un'applicazione di AI generativa compatibile con RAG inGoogle Cloud.
Considerazioni sull'affidabilità di Cloud Run Functions
Per assicurarti che l'implementazione di Cloud Run Functions soddisfi i tuoi requisiti di affidabilità, tieni conto dei seguenti fattori di progettazione e suggerimenti:
- Ridondanza a livello di zona: Cloud Run Functions viene eseguito in più zone all'interno di una regione per fornire resilienza integrata contro le interruzioni a livello di zona.
- Gestione degli errori: per gestire in sicurezza eventi duplicati o errori temporanei, scrivi funzioni idempotenti e configura i tentativi di esecuzione delle funzioni basate su eventi. Per isolare i messaggi che non vengono elaborati ripetutamente, configura un argomento messaggi non recapitabili Pub/Sub.
Considerazioni sull'affidabilità di AlloyDB
Per assicurarti che la configurazione di AlloyDB soddisfi i tuoi requisiti di affidabilità, tieni presente i seguenti fattori di progettazione e suggerimenti:
- Alta affidabilità: per impostazione predefinita, i cluster AlloyDB offrono l'alta affidabilità (HA) con failover automatico. L'istanza principale ha nodi ridondanti che si trovano in due zone diverse all'interno di una regione. Questa ridondanza contribuisce a garantire che i cluster siano resilienti alle interruzioni della zona.
- Disaster recovery: per pianificare il ripristino in caso di interruzioni a livello di regione, puoi utilizzare la replica tra regioni.
Considerazioni sull'affidabilità di BigQuery
I dati caricati in BigQuery vengono archiviati in modo sincrono in due zone all'interno della regione specificata. Questa ridondanza contribuisce a garantire che i tuoi dati non vadano persi in caso di interruzione di una zona. Per saperne di più sulle funzionalità di affidabilità di BigQuery, consulta Informazioni sull'affidabilità.
Considerazioni sull'affidabilità di Cloud Storage
Puoi creare bucket Cloud Storage in uno dei seguenti tipi di località: singola regione, a due regioni o multiregionale. I dati archiviati nei bucket regionali vengono replicati in modo sincrono in più zone all'interno di una regione. Per una maggiore disponibilità, puoi utilizzare bucket a due regioni o multiregionali, in cui i dati vengono replicati in modo asincrono tra le regioni.
Considerazioni sull'affidabilità di Pub/Sub
Per assicurarti che la configurazione di Pub/Sub soddisfi i tuoi requisiti di affidabilità, tieni presente i seguenti suggerimenti:
- Controllo della frequenza: per gestire i picchi temporanei nel traffico dei messaggi, puoi configurare il controllo di flusso nelle impostazioni del publisher.
- Gestione degli errori: per gestire le pubblicazioni non riuscite, modifica le variabili di richiesta di ripetizione in base alle esigenze. Per saperne di più, consulta Ripeti le richieste.
Per saperne di più sulle considerazioni specifiche per le regioni, consulta Area geografica e regioni.
Per i principi e i suggerimenti di affidabilità specifici per i workload di AI e ML, consulta Prospettiva di AI e ML: affidabilità nel Well-Architected Framework.
Ottimizzazione dei costi
Questa sezione fornisce indicazioni per aiutarti a ottimizzare i costi di configurazione e funzionamento di un'applicazione di AI generativa compatibile con RAG in Google Cloud.
Memorizzazione nella cache del contesto di Agent Platform
Per ridurre i costi dei token di input quando le richieste RAG ripetute condividono istruzioni di sistema di grandi dimensioni o il contesto recuperato, utilizza la memorizzazione nella cache del contesto.
Considerazioni sui costi di AlloyDB
Per ottimizzare il costo di AlloyDB, tieni presente i seguenti suggerimenti:
- Disponibilità dell'istanza: per impostazione predefinita, un'istanza principale di un cluster AlloyDB è ad alta affidabilità (HA). L'istanza ha un nodo attivo e un nodo in standby. Se il nodo attivo non funziona, AlloyDB esegue automaticamente il failover al nodo in standby. Se non hai bisogno dell'alta affidabilità per i database, puoi ridurre i costi impostando l'istanza principale del cluster come istanza di base. Un'istanza di base non è resiliente alle interruzioni della zona e ha tempi di inattività più lunghi durante le operazioni di manutenzione. Per saperne di più, consulta Riduci i costi utilizzando le istanze di base.
- Ottimizzazione delle tariffe: se riesci a prevedere i requisiti di CPU e memoria della tua istanza AlloyDB, puoi risparmiare ottenendo sconti per l'utilizzo impegnato. Per saperne di più, consulta Sconti per impegno di utilizzo di AlloyDB.
Considerazioni sui costi di BigQuery
BigQuery ti consente di stimare il costo delle query prima di eseguirle. Per ottimizzare i costi delle query, devi ottimizzare lo spazio di archiviazione e il calcolo delle query. Per saperne di più, consulta Stima e controllo dei costi.
Considerazioni sui costi di Cloud Storage
Per il bucket Cloud Storage che utilizzi per caricare i dati nel sottosistema di importazione dei dati, scegli una classe di archiviazione appropriata in base ai requisiti di conservazione dei dati e di frequenza di accesso dei tuoi workload. Ad esempio, per controllare i costi di archiviazione, puoi scegliere la classe di archiviazione Standard e utilizzare Gestione del ciclo di vita degli oggetti. Questo approccio ti consente di eseguire automaticamente il downgrade degli oggetti a una classe di archiviazione con costi inferiori o di eliminarli in base alle condizioni che hai impostato.
Considerazioni sui costi di Cloud Logging
Per controllare il costo di archiviazione dei log, tieni presente i seguenti suggerimenti:
- Riduci il volume dei log escludendo o filtrando le voci di log non necessarie. Per saperne di più, consulta Filtri dei sink di log.
- Riduci il periodo di conservazione delle voci di log. Per saperne di più, consulta Configura la conservazione personalizzata.
Per i principi e i suggerimenti di ottimizzazione dei costi specifici per i workload di AI e ML, consulta Prospettiva di AI e ML: ottimizzazione dei costi nel Well-Architected Framework.
Prestazioni
Questa sezione descrive i fattori da considerare quando progetti e crei un'applicazione di AI generativa compatibile con RAG in Google Cloud che soddisfi i tuoi requisiti di prestazioni.
Latenza di Cloud Run Functions
Per ridurre la latenza dell'avvio a freddo dopo periodi di inattività, configura un numero minimo di istanze.
Considerazioni sulle prestazioni di AlloyDB
Per assicurarti che la configurazione di AlloyDB soddisfi i tuoi requisiti di prestazioni, tieni presente i seguenti suggerimenti:
- Indicizzazione vettoriale e motore colonnare: per accelerare le query di somiglianza vettoriale nei workload RAG, crea un indice Approximate Nearest Neighbor (ANN) come ScaNN o HNSW. Per saperne di più, consulta Scegli una strategia di indicizzazione. Per velocizzare ulteriormente le scansioni vettoriali e le query filtrate, consulta Accelera la ricerca vettoriale con il motore colonnare.
- Analisi delle prestazioni delle query: per aiutarti ad analizzare e migliorare le prestazioni delle query dei database, AlloyDB fornisce uno strumento Query Insights. Puoi utilizzare questo strumento per monitorare le prestazioni e rintracciare l'origine di una query problematica. Per saperne di più, consulta Informazioni su Query Insights.
- Monitoraggio delle istanze: per ottenere una panoramica dello stato e delle prestazioni dei tuoi database e visualizzare metriche dettagliate come le connessioni di picco e il ritardo di replica massimo, puoi utilizzare la dashboard di Insight di sistema. Per saperne di più, consulta Monitora un'istanza utilizzando la dashboard Insight sul sistema AlloyDB.
- Scalabilità in lettura: per ridurre il carico sull'istanza AlloyDB principale e fare lo scale out della capacità per gestire le richieste di lettura, puoi aggiungere istanze del pool di lettura al cluster. Per maggiori informazioni, consulta Che cos'è un'istanza AlloyDB?.
Considerazioni sulle prestazioni di BigQuery
Per assicurarti che l'utilizzo di BigQuery soddisfi i tuoi requisiti di prestazioni, tieni presente i seguenti suggerimenti:
- Insight sulle prestazioni delle query: BigQuery fornisce un grafico di esecuzione delle query che puoi utilizzare per analizzare le prestazioni delle query e ottenere insight sulle prestazioni per problemi come la contesa degli slot e l'insufficienza della quota di shuffling. Per saperne di più, consulta Ottieni insight sulle prestazioni delle query.
- Ottimizzazione del calcolo delle query: dopo aver risolto i problemi identificati tramite gli insight sulle prestazioni delle query, puoi ottimizzare ulteriormente le query utilizzando tecniche come la riduzione del volume dei dati di input e output. Per saperne di più, consulta Ottimizza il calcolo delle query.
Considerazioni sulle prestazioni di Cloud Storage
Per caricare file di grandi dimensioni, puoi utilizzare un metodo chiamato caricamenti compositi paralleli. Con questa strategia, il file di grandi dimensioni viene suddiviso in blocchi. I blocchi vengono caricati in Cloud Storage in parallelo, quindi i dati vengono ricomposti nel cloud. Quando la larghezza di banda della rete e la velocità del disco non sono fattori limitanti, i caricamenti compositi paralleli possono essere più veloci delle normali operazioni di caricamento. Tuttavia, questa strategia presenta alcune limitazioni e implicazioni in termini di costi. Per saperne di più, consulta Caricamenti compositi paralleli.
Per i principi e i suggerimenti di ottimizzazione delle prestazioni specifici per i workload di AI e ML, consulta Prospettiva di AI e ML: ottimizzazione delle prestazioni nel Well-Architected Framework.
Deployment
Per iniziare e sperimentare la creazione di un'infrastruttura su Google Cloud per applicazioni di AI generativa compatibili con RAG, utilizza il codice campione disponibile su GitHub. Questo codice esegue il deployment di un'applicazione di chat basata su Python su Cloud Run e utilizza un database Cloud SQL completamente gestito per Vector Search.
Passaggi successivi
- Applicazione RAG agentica AlloyDB con MCP Toolbox
- Infrastruttura RAG per l'AI generativa che utilizza Agent Platform e Vector Search
- Infrastruttura RAG per l'AI generativa che utilizza GKE e Cloud SQL
- Infrastruttura RAG per l'AI generativa che utilizza Gemini Enterprise e Agent Platform
- Infrastruttura GraphRAG per l'AI generativa che utilizza Agent Platform e Spanner Graph
- Per una panoramica dei principi e dei suggerimenti di architettura specifici per i workload di AI e ML in Google Cloud, consulta la prospettiva di AI e ML nel Well-Architected Framework.
- Per ulteriori architetture di riferimento, diagrammi e best practice, esplora Cloud Architecture Center.
Collaboratori
Autore: Kumar Dhanagopal | Cross-Product Solution Developer
Altri collaboratori:
- Andrew Brook | Engineering Director
- Anna Berenberg | Engineering Fellow
- Assaf Namer | Principal Cloud Security Architect
- Balachandar Krishnamoorthy | Principal Software Engineer
- Daniel Lees | Cloud Security Architect
- Derek Downey | Developer Relations Engineer
- Eran Lewis | Senior Product Manager
- Geoffrey Anderson | Product Manager
- Gleb Otochkin | Cloud Advocate, Databases
- Hamsa Buvaraghan | AI Product Manager
- Irina Sigler | Product Manager
- Jack Wotherspoon | Developer Advocate
- Jason Davenport | Developer Advocate
- Jordan Totten | Customer Engineer
- Julia Wiesinger | Product Manager
- Kara Greenfield | Customer Engineer
- Kurtis Van Gent | Staff Software Engineer
- Per Jacobsson | Software Engineer
- Pranav Nambiar | Director
- Richard Hendricks | Personale dell'Architecture Center
- Safiuddin Khaja | Cloud Engineer
- Sandy Ghai | Group Product Manager
- Vladimir Vuskovic | Product Management Director
- Steren Giannini | Group Product Manager
- Wietse Venema | Developer Relations Engineer