


Ce document fournit une architecture de référence que vous pouvez utiliser pour concevoir l'infrastructure permettant d'exécuter une application d'intelligence artificielle générative (IA) avec une génération augmentée par récupération (RAG). Ce document s'adresse aux développeurs et administrateurs d'applications d'IA générative et d'architectes cloud. Dans ce document, nous partons du principe que vous possédez des connaissances de base sur les concepts d'IA, de machine learning (ML) et de grand modèle de langage (LLM). Ce document ne fournit pas de conseils sur la conception et le développement d'une application d'IA générative.
Architecture
Le schéma suivant montre une vue d'ensemble d'une architecture pour une application d'IA générative compatible avec RAG dans Google Cloud :

L'architecture contient les composants interconnectés suivants :
- Sous-système d'ingestion de données
- Le sous-système d'ingestion de données prépare et traite les données externes utilisées pour activer la fonctionnalité RAG. Il interagit avec les autres sous-systèmes de l'architecture via la couche de base de données.
- Sous-système de mise en service
- Le sous-système de mise en service gère le flux de requêtes/réponses entre l'application d'IA générative et ses utilisateurs. Il interagit avec le sous-système d'ingestion de données via la couche de base de données.
- Sous-système d'évaluation de la qualité
- Le sous-système d'évaluation de la qualité évalue la qualité des réponses générées par le sous-système de mise en service. Il interagit directement avec le sous-système de mise en service ainsi qu'avec le sous-système d'ingestion de données via la couche de base de données.
- Bases de données
Tous les sous-systèmes de l'architecture interagissent avec les bases de données. Les bases de données stockent les données suivantes :
- Prompts
- Embeddings vectoriels des données utilisées pour la fonction RAG
- Configurations des fonctions sans serveur dans les sous-systèmes d'ingestion de données et d'évaluation de la qualité
Le diagramme suivant présente une vue détaillée de l'architecture :
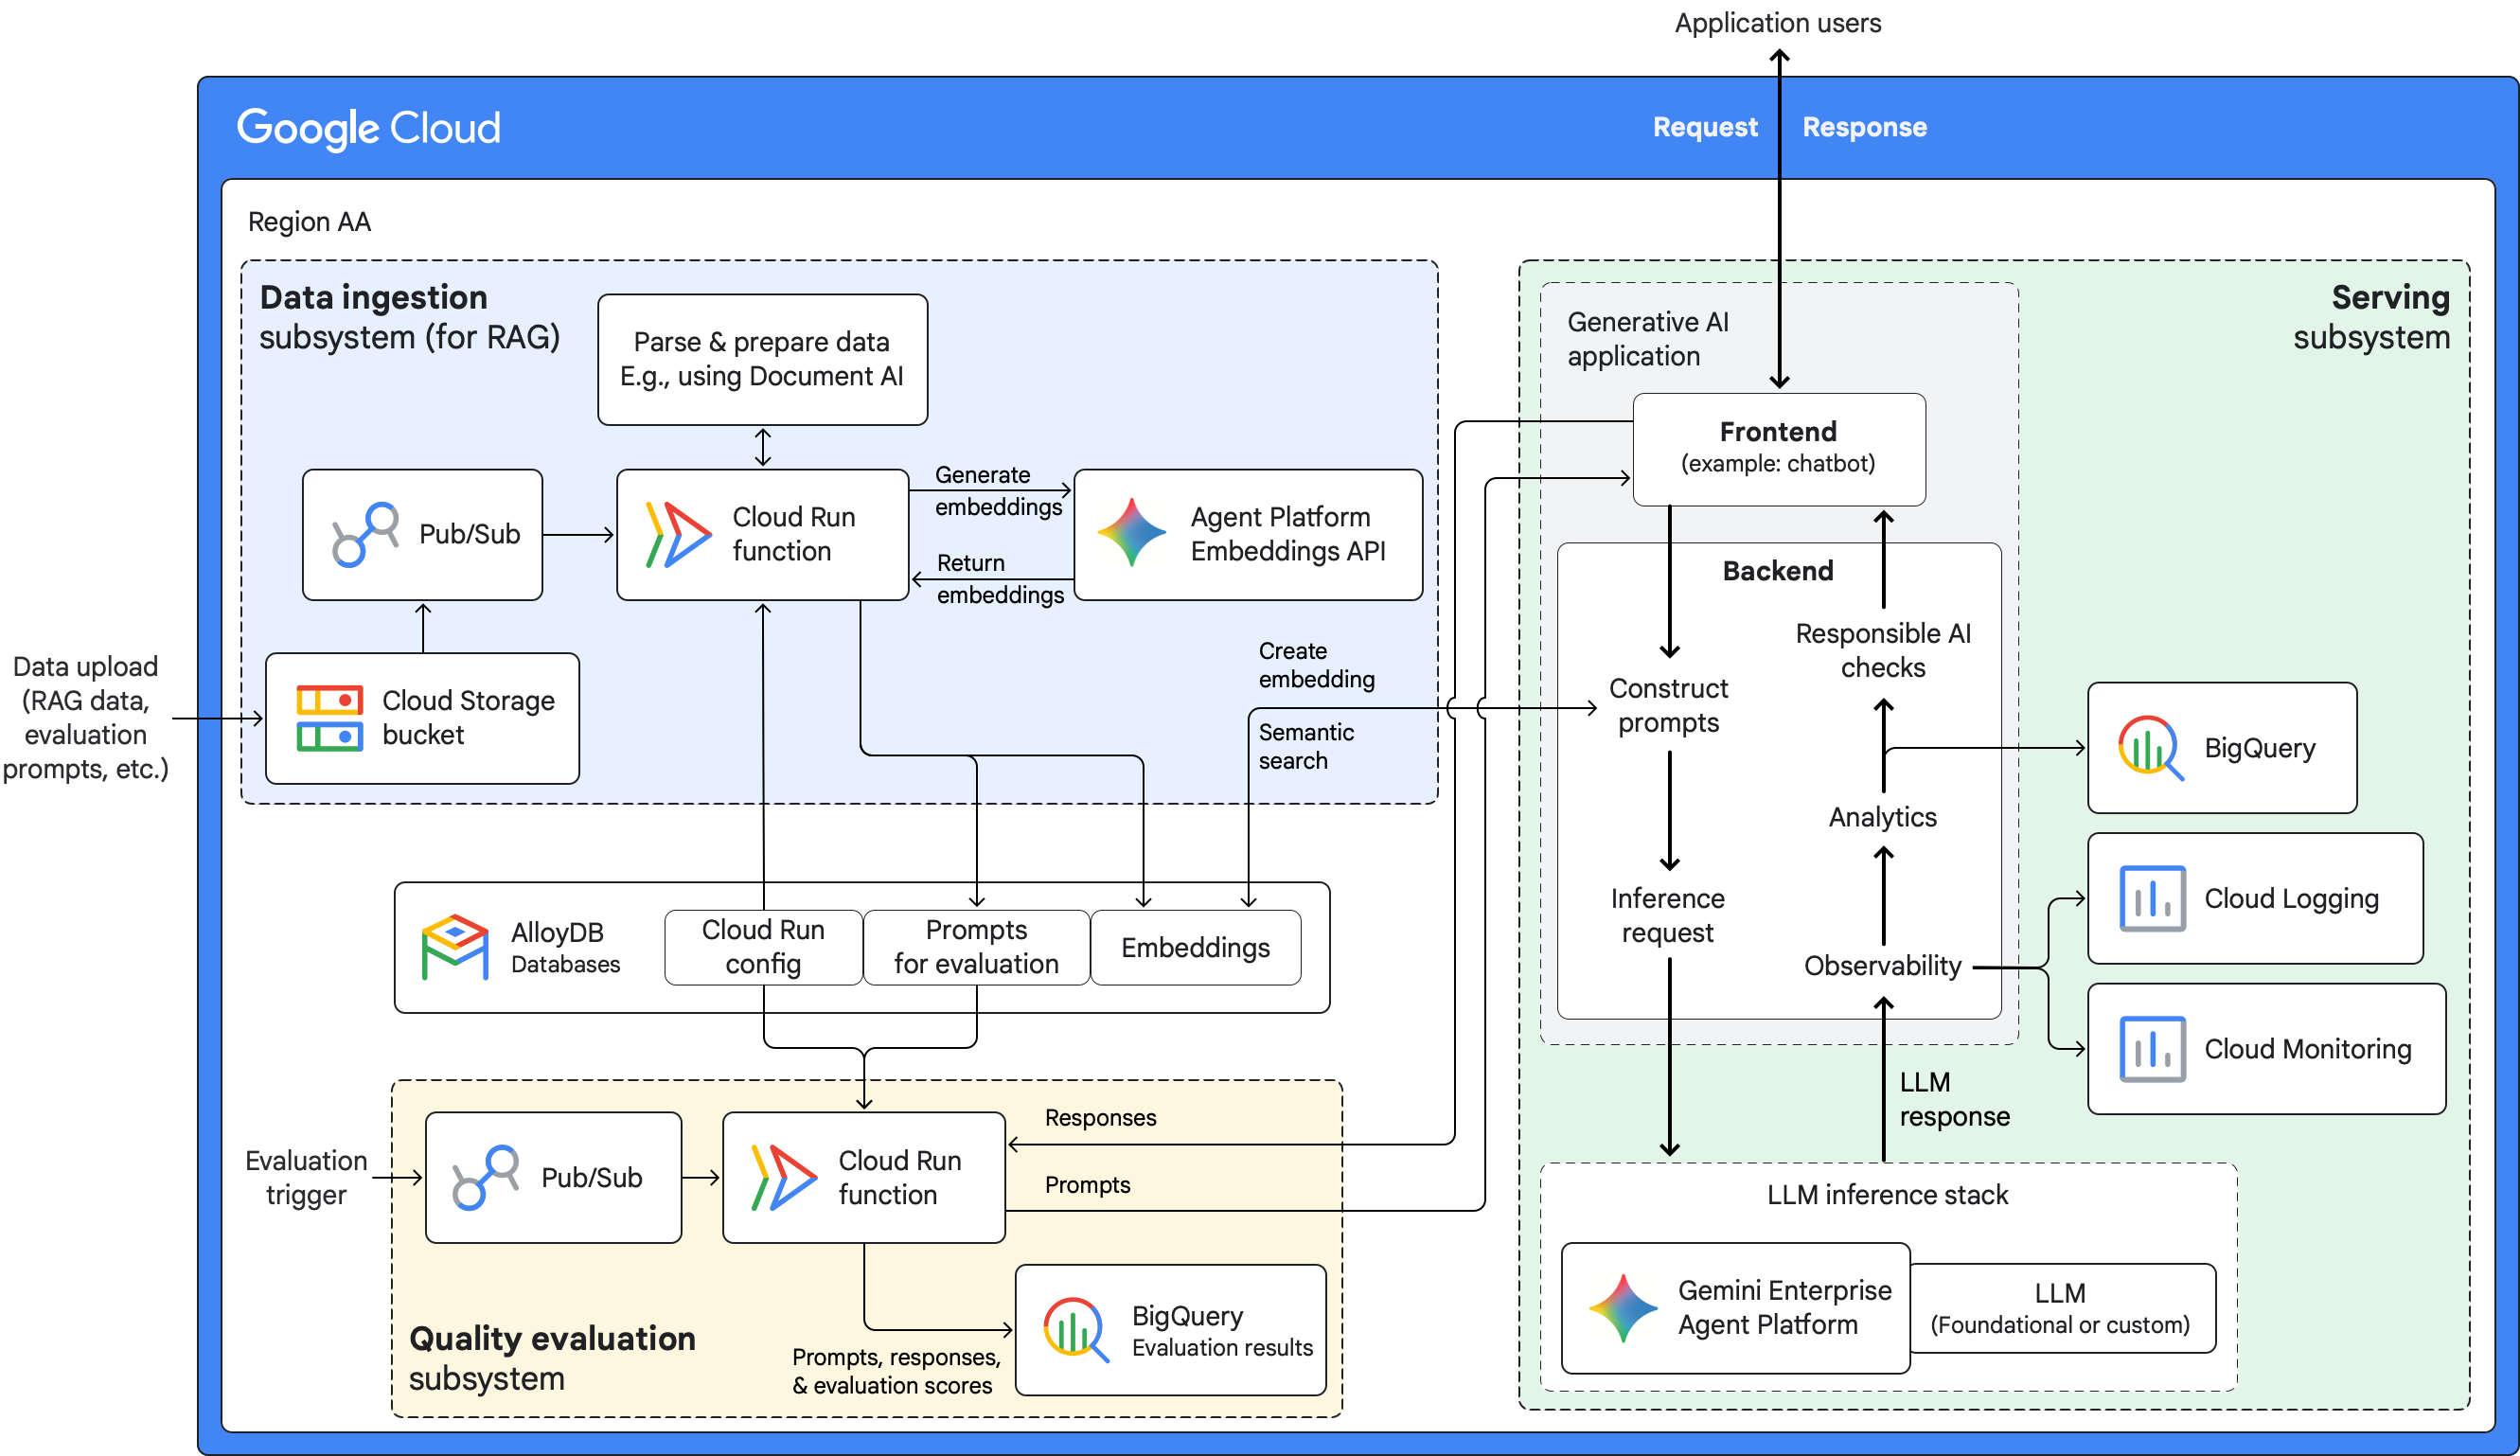
Les sections suivantes fournissent des descriptions détaillées des composants et du flux de données dans chaque sous-système de l'architecture.
Sous-système d'ingestion de données
Le sous-système d'ingestion de données ingère des données issues de sources externes telles que des fichiers, des bases de données et des services de streaming. Les données importées incluent des requêtes d'évaluation de la qualité. Le sous-système d'ingestion de données fournit la fonctionnalité RAG dans l'architecture. Le schéma suivant montre les détails du sous-système d'ingestion de données dans l'architecture :
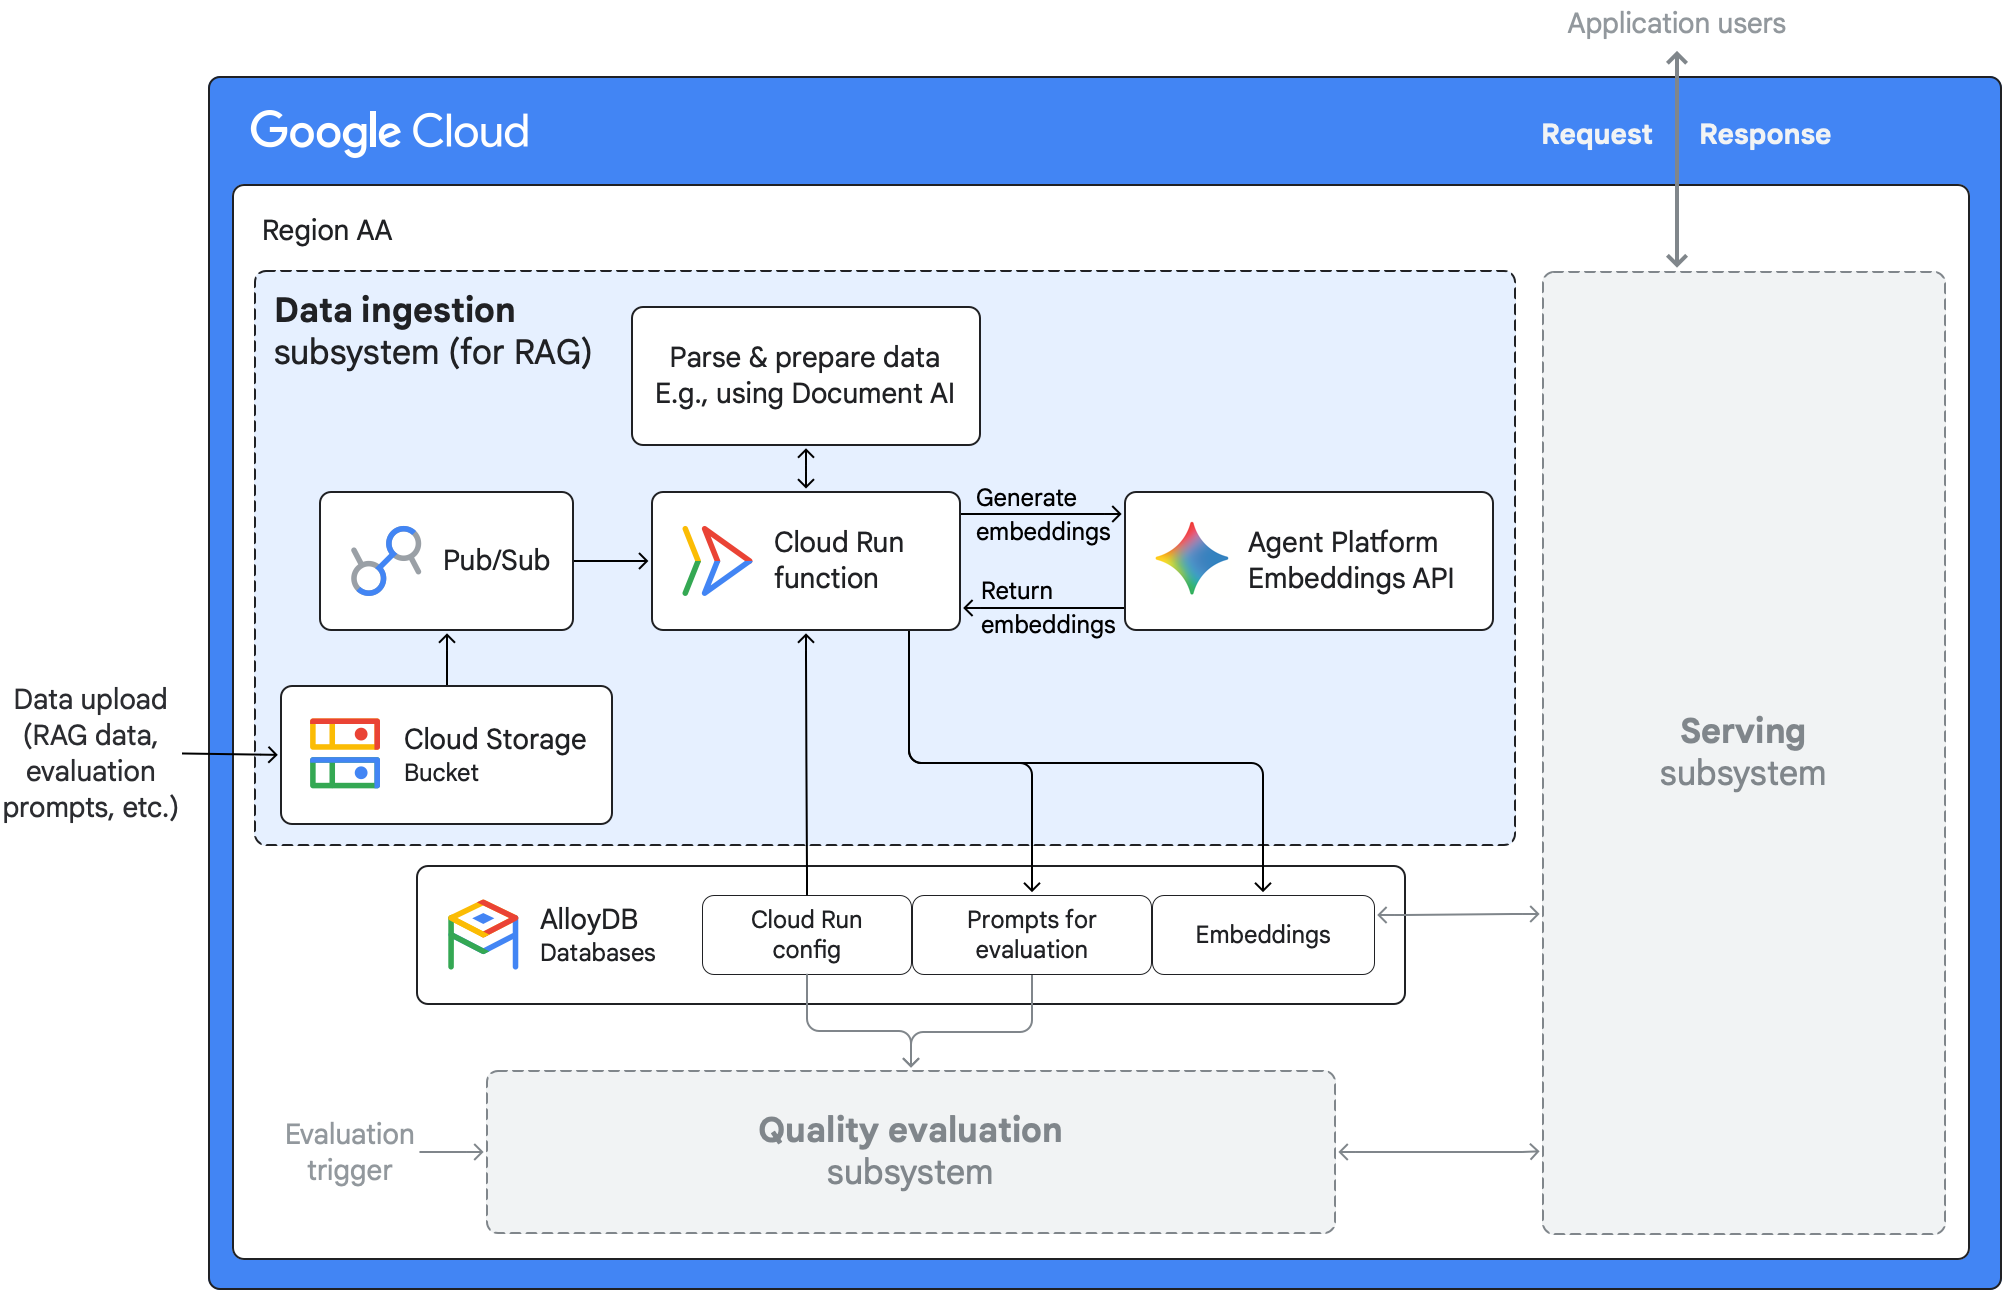
Voici les étapes du flux d'ingestion de données :
- Les données sont importées dans un bucket Cloud Storage. Les sources de données peuvent être des applications, des bases de données ou des services de streaming.
- Lorsque des données sont importées dans Cloud Storage, un message est publié dans un sujet Pub/Sub.
- Pub/Sub déclenche une fonction Cloud Run pour traiter les données importées.
- La fonction est lancée en utilisant les données de configuration stockées dans une base de données AlloyDB pour PostgreSQL.
- La fonction analyse les données brutes, les formate comme requis, puis les divise en fragments.
La fonction utilise un modèle d'embedding approprié sur Gemini Enterprise Agent Platform pour créer des embeddings vectoriels des données ingérées.
.La fonction stocke les embeddings dans une base de données AlloyDB sur laquelle l'extension
vectorcompatible avecpgvectorest activée. Comme décrit dans la section suivante, lorsque le sous-système de mise en service traite les requêtes des utilisateurs, il utilise les embeddings dans la base de données vectorielles pour récupérer les données spécifiques au domaine pertinentes.
Sous-système de mise en service
Le sous-système de mise en service gère le flux de requêtes/réponses entre l'application d'IA générative et ses utilisateurs. Le schéma suivant montre les détails du sous-système de mise en service dans l'architecture :
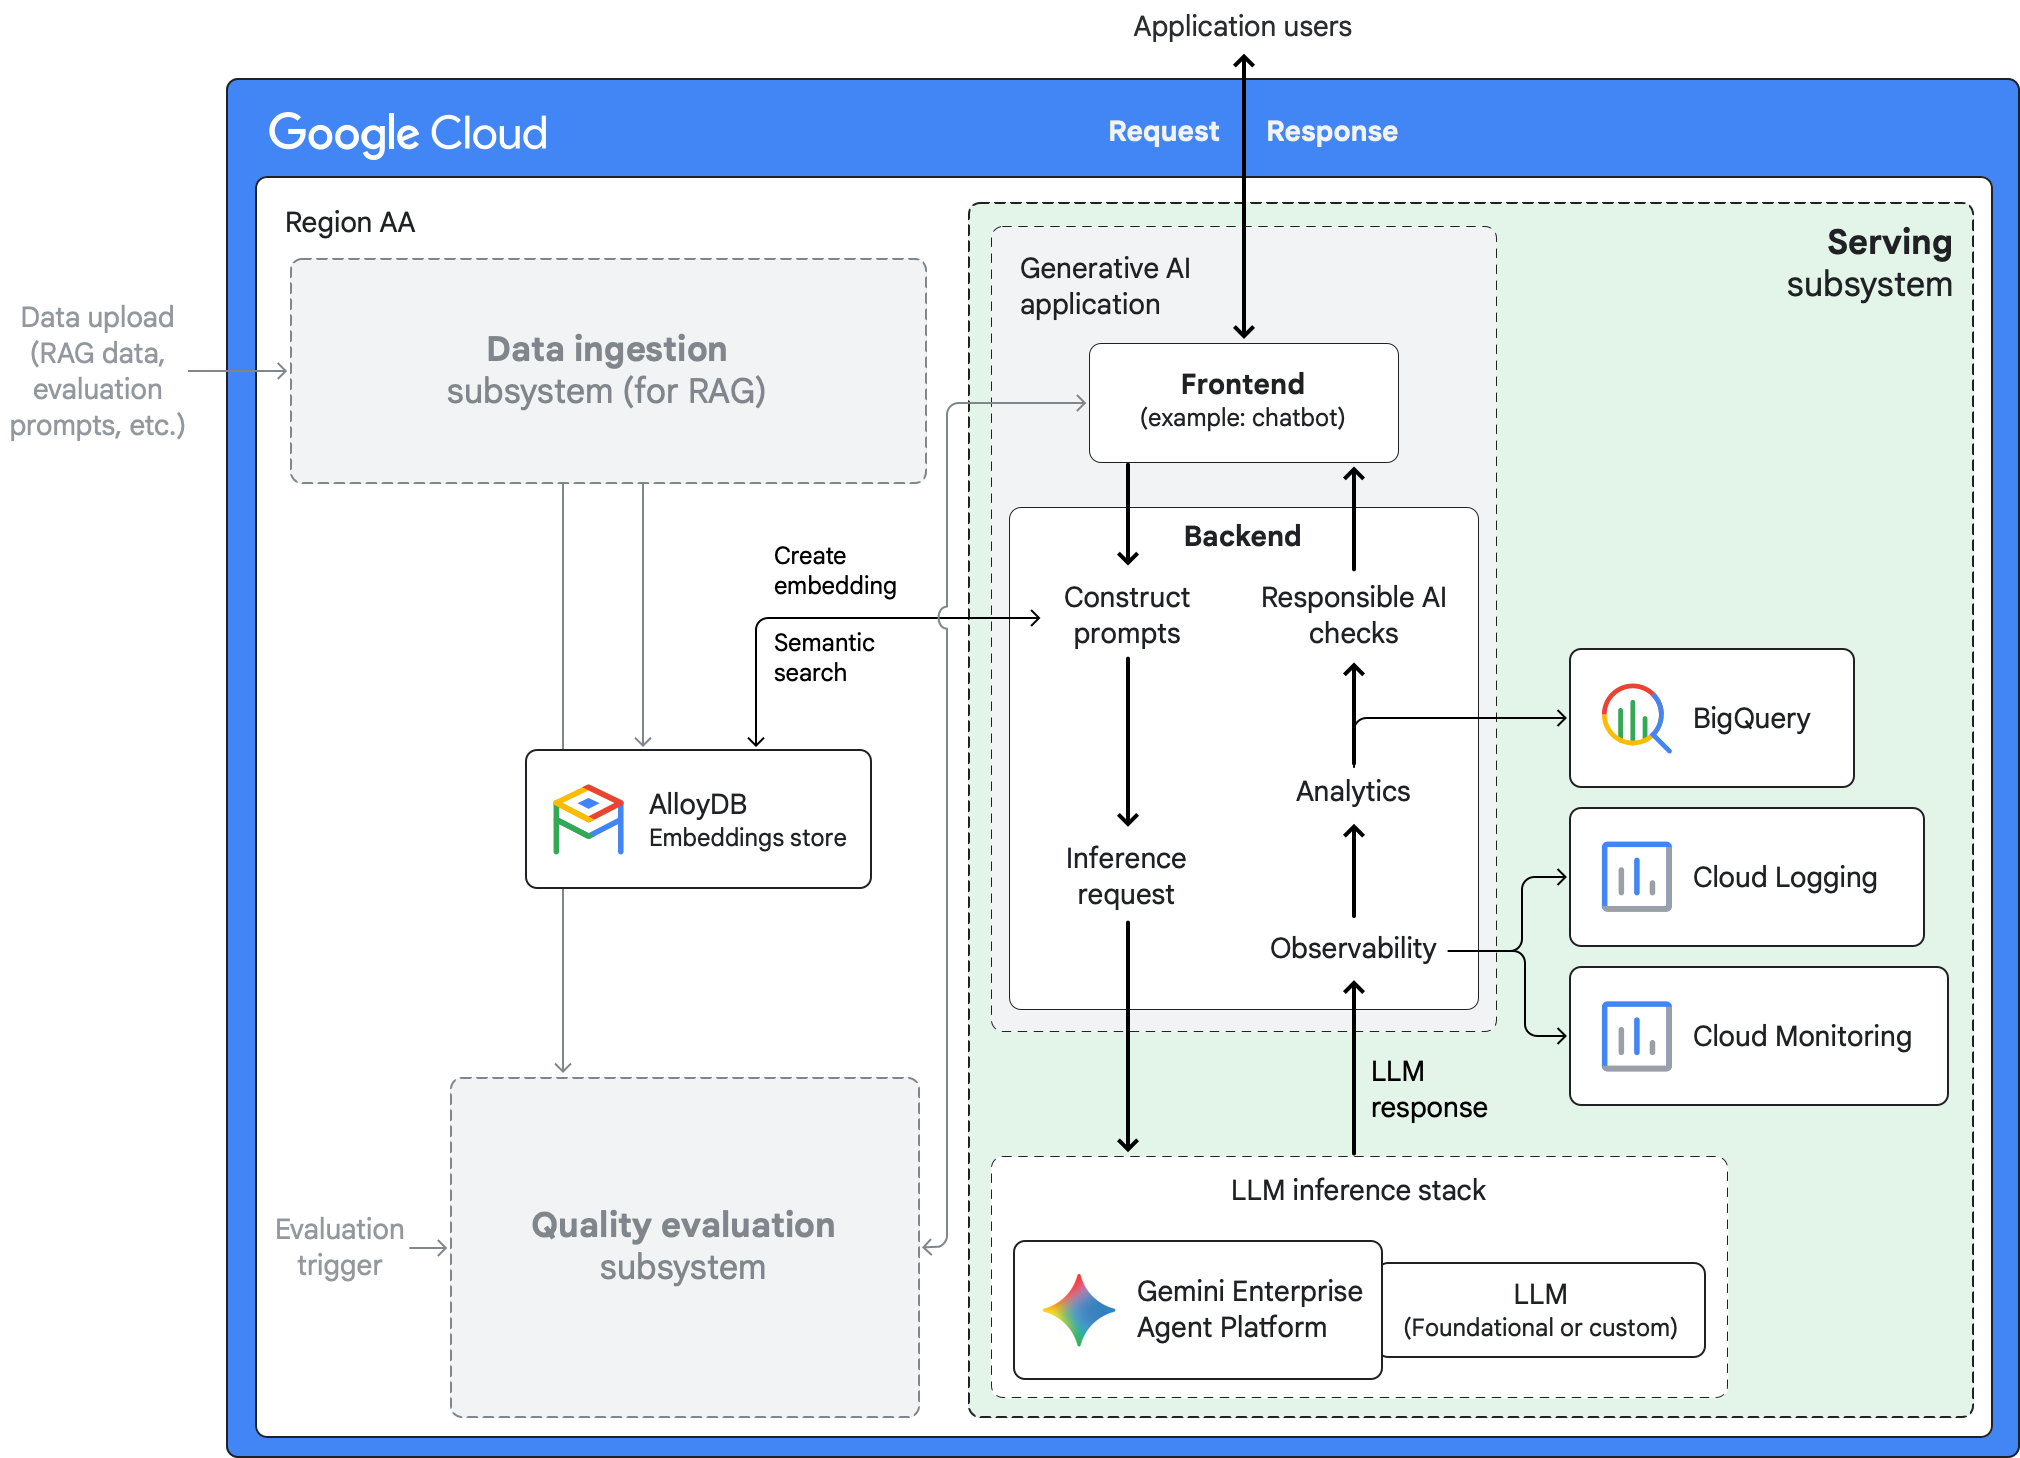
Voici les étapes du flux de requêtes-réponses dans le sous-système de mise en service :
- Les utilisateurs envoient des requêtes à l'application d'IA générative via une interface (par exemple, un chatbot ou une application mobile).
L'application d'IA générative convertit la requête en langage naturel en embeddings vectoriels.
L'application termine la partie récupération de l'approche RAG :
- L'application effectue une recherche sémantique de l'embedding dans le magasin de vecteurs AlloyDB géré par le sous-système d'ingestion de données. La recherche sémantique permet de trouver des embeddings basés sur l'intent d'un prompt plutôt que sur son contenu textuel.
- L'application combine le prompt d'origine avec les données brutes récupérées en fonction de l'embedding correspondant pour créer un prompt contextualisé.
L'application envoie la requête contextualisée à une pile d'inférence LLM qui est exécutée sur Agent Platform.
La pile d'inférence LLM utilise un LLM d'IA générative, qui peut être un LLM de base ou un LLM personnalisé, et génère une réponse limitée au contexte fourni.
- L'application peut stocker des journaux de l'activité requêtes-réponses dans Cloud Logging. Vous pouvez consulter et utiliser les journaux pour la surveillance à l'aide de Cloud Monitoring. Google n'accède pas à ces données et ne les utilise pas.
- L'application charge les réponses dans BigQuery pour effectuer des analyses hors connexion.
L'application examine les réponses à l'aide de filtres d'IA responsable.
L'application envoie les réponses sélectionnées aux utilisateurs dans l'interface.
Sous-système d'évaluation de la qualité
Le schéma suivant montre les détails du sous-système d'évaluation de la qualité de l'architecture :

Lorsque le sous-système d'évaluation de la qualité reçoit une requête, il effectue les opérations suivantes :
- Pub/Sub déclenche une fonction Cloud Run.
- La fonction est lancée à l'aide des données de configuration stockées dans une base de données AlloyDB.
- La fonction extrait les requêtes d'évaluation d'une base de données AlloyDB. Les requêtes ont été précédemment importées dans la base de données par le sous-système d'ingestion de données.
La fonction utilise les requêtes d'évaluation pour évaluer la qualité des réponses générées par le sous-système de mise en service.
La sortie de cette évaluation prend la forme de scores d'évaluation pour des métriques comme la justesse factuelle et la pertinence.
La fonction charge les scores d'évaluation, ainsi que les requêtes et les réponses évaluées dans BigQuery pour une analyse ultérieure.
Produits utilisés
Voici un récapitulatif de tous les produits Google Cloud utilisés par l'architecture précédente :
- Gemini Enterprise Agent Platform : plate-forme complète qui vous permet de créer, de faire évoluer, de gérer et d'optimiser des agents IA de niveau entreprise.
- Fonctions Cloud Run : plate-forme de calcul sans serveur qui vous permet d'exécuter des fonctions à usage unique directement dans Google Cloud.
- BigQuery : entrepôt de données d'entreprise qui vous aide à gérer et analyser vos données grâce à des fonctionnalités intégrées telles que le machine learning, l'analyse géospatiale et l'informatique décisionnelle.
- Cloud Storage : store d'objets économique et sans limite pour tout type de données. Les données sont accessibles depuis et en dehors de Google Cloud, et sont répliquées sur plusieurs emplacements à des fins de redondance.
- AlloyDB pour PostgreSQL : service de base de données entièrement géré compatible avec PostgreSQL, conçu pour vos charges de travail les plus exigeantes, y compris le traitement hybride transactionnel et analytique.
- Pub/Sub : service de messagerie asynchrone et évolutif qui dissocie les services qui produisent des messages des services qui traitent ces messages.
- Cloud Logging : système de gestion des journaux en temps réel avec stockage, recherche, analyse et alertes.
- Cloud Monitoring : service qui offre une visibilité sur les performances, la disponibilité et l'état de vos applications et de votre infrastructure.
Cas d'utilisation
La génération augmentée de récupération (RAG) est une technique efficace pour améliorer la qualité des résultats générés à partir d'un LLM. Cette section fournit des exemples de cas d'utilisation pour lesquels vous pouvez utiliser des applications d'IA générative compatibles avec la fonction RAG.
Recommandations de produits personnalisées
Un site de shopping en ligne peut utiliser un chatbot basé sur un LLM pour aider les clients à trouver des produits ou à obtenir de l'aide sur leur expérience d'achat. Il est possible d'augmenter les questions d'un utilisateur en utilisant les données historiques sur le comportement d'achat de l'utilisateur et les schémas d'interaction sur le site Web. Les données peuvent inclure des avis et des commentaires d'utilisateurs stockés dans un datastore non structuré, ou des métriques liées à la recherche qui sont stockées dans un entrepôt de données d'analyse d'audience Web. La question augmentée peut ensuite être traitée par le LLM pour générer des réponses personnalisées que l'utilisateur pourrait trouver plus attrayantes et plus convaincantes.
Systèmes d'assistance clinique
Les cliniciens hospitaliers doivent examiner et synthétiser les informations de santé des patients pour prendre des décisions de soins éclairées. Une application d'IA générative qui utilise un modèle de fondation médical tel que MedGemma peut aider les cliniciens à résumer des notes cliniques et à examiner le contexte médical. Les réponses générées par l'application peuvent s'appuyer sur l'historique des dossiers des patients en contextualisant les requêtes avec les données de la base de données des dossiers médicaux électroniques (DME) de l'hôpital ou d'une base de connaissances externe, telle que PubMed.
Recherches juridiques efficaces
La recherche juridique basée sur l'IA générative permet aux avocats d'interroger rapidement de grands volumes de lois et de cas juridiques afin d'identifier les précédents juridiques pertinents ou de résumer des concepts juridiques complexes. Les résultats de ces recherches peuvent être améliorés en augmentant les requêtes d'un avocat par des données extraites du corpus propriétaire du cabinet d'avocats, regroupant contrats, communications juridiques antérieures et dossiers internes. Cette approche de conception permet de générer des réponses adaptées au domaine juridique de spécialité de l'avocat.
Alternatives de conception
Cette section présente d'autres approches de conception que vous pouvez envisager pour votre application d'IA générative compatible RAG dans Google Cloud.
Framework RAG géré
Pour orchestrer des workflows de LLM augmentés par le contexte sans créer de pipeline d'ingestion et de récupération personnalisé, vous pouvez utiliser le moteur RAG sur Gemini Enterprise Agent Platform. Le moteur RAG gère l'ingestion des données, la segmentation, la génération d'embeddings, l'indexation et la récupération pour les charges de travail RAG.
Recherche vectorielle entièrement gérée
Si vous avez besoin d'une architecture qui utilise un produit de recherche vectorielle entièrement géré, vous pouvez utiliser Agent Platform et Vector Search, qui fournit une infrastructure de diffusion optimisée pour la recherche vectorielle à très grande échelle. Pour en savoir plus, consultez Infrastructure RAG pour l'IA générative à l'aide d'Agent Platform et de Vector Search.
Outils et modèles Open Source
Si vous souhaitez créer et déployer rapidement des applications d'IA générative compatibles avec RAG à l'aide d'outils et de modèles Open Source Ray, Hugging Face et LangChain, consultez Infrastructure RAG pour l'IA générative à l'aide de GKE et Cloud SQL.
Considérations de conception
Cette section fournit des conseils pour vous aider à développer dans Google Cloud une architecture d'IA générative compatible avec la fonction RAG qui répond à vos exigences spécifiques en termes de sécurité, de conformité, de fiabilité, de coût et de performances. Les conseils de cette section ne sont pas exhaustifs. En fonction des exigences spécifiques de votre application d'IA générative et des produits et fonctionnalités Google Cloud que vous utilisez, vous devrez peut-être prendre en compte des facteurs de conception et des compromis supplémentaires.
Sécurité et conformité
Cette section décrit les facteurs à prendre en compte lorsque vous concevez et créez une application d'IA générative exploitant le RAG dans Google Cloud , qui répond à vos exigences de sécurité et de conformité.
Points à noter concernant la sécurité d'Agent Platform
Pour vous assurer que les configurations et l'utilisation de votre plate-forme d'agents répondent à vos exigences de sécurité, tenez compte des facteurs de conception et des recommandations suivants :
Contrôles de sécurité : Agent Platform est compatible avec les contrôles de sécurité Google Cloud qui vous permettent de répondre à vos exigences en termes de résidence des données, de chiffrement des données, de sécurité réseau et de transparence des accès. Pour en savoir plus, consultez les pages Contrôles de sécurité pour les services de machine learning et Contrôles de sécurité pour l'IA générative.
Filtrage des prompts et des réponses : pour filtrer les prompts RAG et les réponses du modèle afin de détecter les injections de prompts, les tentatives de jailbreak, les contenus nuisibles et les fuites de données sensibles, utilisez les modèles et les filtres Model Armor.
Chiffrement des données des fonctions Cloud Run
Pour protéger vos données à l'aide d'une clé que vous contrôlez, vous pouvez utiliser des clés de chiffrement gérées par le client (CMEK).
Points à noter concernant la sécurité d'AlloyDB
Pour vous assurer que votre configuration AlloyDB répond à vos exigences de sécurité, tenez compte des recommandations suivantes :
- Chiffrement des données : par défaut, les données stockées dans AlloyDB sont chiffrées à l'aide deGoogle-owned and Google-managed encryption keys. Si vous devez utiliser des clés de chiffrement que vous contrôlez et gérez, vous pouvez utiliser des CMEK. Pour en savoir plus, consultez À propos des CMEK.
- Contrôle du réseau : pour limiter le risque d'exfiltration de données des bases de données AlloyDB, vous pouvez créer un périmètre de service à l'aide de VPC Service Controls.
- Sécurité de la connexion : par défaut, une instance AlloyDB n'accepte que les connexions utilisant SSL. Pour sécuriser davantage les connexions à vos bases de données AlloyDB, vous pouvez utiliser le connecteur du proxy d'authentification AlloyDB. Le connecteur du proxy d'authentification fournit une autorisation de connexion basée sur Identity and Access Management (IAM) et utilise une connexion TLS 1.3 avec un algorithme de chiffrement AES 256 bits pour valider les identités du client et du serveur, et chiffrer le trafic de données. Pour en savoir plus, consultez À propos du proxy d'authentification AlloyDB. Pour les connexions créées à l'aide de Java, Python, Go ou Node.js, utilisez le connecteur de langage approprié au lieu du connecteur de proxy d'authentification.
- Résidence des données : AlloyDB vous aide à répondre aux exigences de résidence des données. Les données sont stockées ou répliquées dans les régions que vous spécifiez.
Considérations de sécurité BigQuery
Pour vous assurer que votre configuration BigQuery répond à vos exigences de sécurité, tenez compte des recommandations suivantes :
- Gouvernance des données : BigQuery fournit de nombreuses fonctionnalités permettant de contrôler l'accès aux données, de protéger les données sensibles et d'assurer la précision et la cohérence des données. Pour en savoir plus, consultez la page Présentation de la gouvernance des données dans BigQuery.
- Résidence des données : BigQuery vous aide à respecter les exigences de résidence des données. Les données sont stockées dans la région que vous spécifiez.
Considérations de sécurité pour Cloud Storage
Pour vous assurer que votre configuration Cloud Storage répond à vos exigences de sécurité, tenez compte des recommandations suivantes :
- Chiffrement des données : par défaut, les données stockées dans Cloud Storage sont chiffrées à l'aide de Google-owned and Google-managed encryption keys. Si nécessaire, vous pouvez utiliser des clés CMEK ou vos propres clés que vous gérez à l'aide d'une méthode de gestion externe, telle que les clés de chiffrement fournies par le client (CSEK). Pour en savoir plus, consultez Options de chiffrement des données.
- Contrôle des accès : Cloud Storage propose deux systèmes pour autoriser des utilisateurs à accéder à vos buckets et objets : IAM et les listes de contrôle d'accès (LCA). Dans la plupart des cas, utilisez IAM, qui vous permet d'accorder des autorisations au niveau du bucket et du projet. Pour en savoir plus, consultez la page Présentation du contrôle des accès.
- Protection des données : les données que vous chargez dans le sous-système d'ingestion de données via Cloud Storage peuvent inclure des données sensibles. Pour protéger de telles données, vous pouvez utiliser Sensitive Data Protection pour assurer la découverte, le classement et l'anonymisation des données. Pour en savoir plus, consultez Utiliser Sensitive Data Protection avec Cloud Storage.
- Résidence des données : Cloud Storage vous aide à répondre aux exigences de résidence des données. Les données sont stockées ou répliquées dans les régions que vous spécifiez.
Considérations de sécurité pour Pub/Sub
Pour vous assurer que votre configuration Pub/Sub répond à vos exigences de sécurité, tenez compte des recommandations suivantes :
- Chiffrement des données : par défaut, Pub/Sub chiffre tous les messages, au repos et en transit, à l'aide de Google-owned and Google-managed encryption keys. Pub/Sub accepte l'utilisation de CMEK pour le chiffrement des messages au niveau de la couche d'application. Pour en savoir plus, consultez Configurer le chiffrement des messages.
- Résidence des données : si vous avez des exigences de résidence des données, vous pouvez configurer des règles de stockage des messages pour vous assurer que les données des messages sont stockées dans des emplacements spécifiques.
Considérations de sécurité pour Cloud Logging
Pour vous assurer que votre configuration Cloud Logging répond à vos exigences de sécurité, tenez compte des facteurs de conception et des recommandations suivants :
- Audit des activités d'administration : les journaux d'audit des activités d'administration sont activés par défaut pour tous les services Google Cloud utilisés dans cette architecture de référence. Ces journaux enregistrent les appels d'API ou d'autres actions qui modifient la configuration ou les métadonnées des ressources Google Cloud .
- Audit des accès aux données : les journaux d'audit des accès aux données sont activés par défaut pour BigQuery. Pour les autres services utilisés dans cette architecture, vous pouvez activer les journaux d'audit d'accès aux données. Ils vous permettent de suivre les appels d'API qui lisent la configuration ou les métadonnées des ressources, ou les requêtes utilisateur visant à créer, modifier ou lire des données de ressources fournies par l'utilisateur.
- Résidence des données : pour répondre aux exigences de résidence des données, vous pouvez configurer Cloud Logging de sorte qu'il stocke les données de journaux dans la région de votre choix. Pour en savoir plus, consultez Régionaliser vos journaux.
Pour connaître les principes et recommandations de sécurité spécifiques aux charges de travail d'IA et de ML, consultez Enjeux spécifiques à l'IA et au ML : sécurité dans le Well-Architected Framework.
Fiabilité
Cette section décrit les facteurs de conception à prendre en compte pour créer et exploiter une infrastructure fiable pour une application d'IA générative compatible RAG dansGoogle Cloud.
Considérations sur la fiabilité des fonctions Cloud Run
Pour vous assurer que votre implémentation de Cloud Run Functions répond à vos exigences de fiabilité, tenez compte des facteurs de conception et des recommandations suivants :
- Redondance zonale : les fonctions Cloud Run s'exécutent dans plusieurs zones d'une région pour offrir une résilience intégrée contre les pannes zonales.
- Gestion des échecs : pour gérer les événements en double ou les échecs temporaires de manière sécurisée, écrivez des fonctions idempotentes et configurez des nouvelles tentatives de fonction basées sur des événements. Pour isoler les messages dont le traitement échoue de manière répétée, configurez une file d'attente de lettres mortes Pub/Sub.
Considérations sur la fiabilité d'AlloyDB
Pour vous assurer que votre configuration AlloyDB répond à vos exigences de fiabilité, tenez compte des facteurs de conception et des recommandations suivants :
- Haute disponibilité : par défaut, les clusters AlloyDB offrent une haute disponibilité avec basculement automatique. L'instance principale comporte des nœuds redondants situés dans deux zones différentes d'une région. Cette redondance permet de garantir que les clusters sont résilients aux pannes zonales.
- Reprise après sinistre : pour planifier la reprise après une panne régionale, vous pouvez utiliser la réplication interrégionale.
Remarques concernant la fiabilité de BigQuery
Les données que vous chargez dans BigQuery sont stockées de manière synchrone dans deux zones de la région que vous spécifiez. Cette redondance permet de s'assurer que vos données ne sont pas perdues en cas de panne zonale. Pour en savoir plus sur les fonctionnalités de fiabilité dans BigQuery, consultez Comprendre la fiabilité.
Considérations sur la fiabilité de Cloud Storage
Vous pouvez créer des buckets Cloud Storage dans l'un des types d'emplacements suivants : régional, birégional ou multirégional. Les données stockées dans des buckets régionaux sont répliquées de manière synchrone dans plusieurs zones d'une même région. Pour une disponibilité plus élevée, vous pouvez utiliser des buckets birégionaux ou multirégionaux, dans lesquels les données sont répliquées de manière asynchrone entre les régions.
Points à prendre en compte concernant la fiabilité de Pub/Sub
Pour vous assurer que votre configuration Pub/Sub répond à vos exigences de fiabilité, tenez compte des recommandations suivantes :
- Contrôle du débit : pour gérer les pics temporaires de trafic de messages, vous pouvez configurer le contrôle de flux dans les paramètres de l'éditeur.
- Gestion des échecs : pour gérer les échecs de publication, ajustez les variables de requête de nouvelle tentative si nécessaire. Pour en savoir plus, consultez Réessayer d'exécuter des requêtes.
Pour en savoir plus sur les considérations spécifiques à la région, consultez la page Zones géographiques et régions.
Pour connaître les principes et recommandations de fiabilité spécifiques aux charges de travail d'IA et de ML, consultez Enjeux spécifiques à l'IA et au ML : fiabilité dans le Well-Architected Framework.
Optimisation des coûts
Cette section fournit des conseils pour vous aider à optimiser les coûts de configuration et de fonctionnement d'une application d'IA générative compatible RAG dans Google Cloud.
Mise en cache du contexte Agent Platform
Pour réduire les coûts des jetons d'entrée lorsque des requêtes RAG répétées partagent des instructions système volumineuses ou un contexte récupéré, utilisez la mise en cache de contexte.
Considérations sur les coûts d'AlloyDB
Pour optimiser le coût d'AlloyDB, tenez compte des recommandations suivantes :
- Disponibilité de l'instance : par défaut, une instance principale d'un cluster AlloyDB est disponibilité élevée. L'instance comporte un nœud actif et un nœud de secours. Si le nœud actif échoue, AlloyDB bascule automatiquement vers le nœud de secours. Si vous n'avez pas besoin de la haute disponibilité pour les bases de données, vous pouvez réduire les coûts en faisant de l'instance principale du cluster une instance de base. Une instance de base n'est pas résiliente face aux pannes zonales et présente un temps d'arrêt plus long lors des opérations de maintenance. Pour en savoir plus, consultez Réduire les coûts en utilisant des instances de base.
- Optimisation des tarifs : si vous pouvez prédire les besoins en processeur et en mémoire de votre instance AlloyDB, vous pouvez réaliser des économies en obtenant des remises sur engagement d'utilisation. Pour en savoir plus, consultez Remises sur engagement d'utilisation AlloyDB.
Remarques concernant les coûts BigQuery
BigQuery vous permet d'estimer le coût des requêtes avant de les exécuter. Pour optimiser les coûts des requêtes, vous devez optimiser le stockage et le calcul des requêtes. Pour en savoir plus, consultez Estimer et contrôler les coûts.
Considérations liées aux coûts de Cloud Storage
Pour le bucket Cloud Storage que vous utilisez pour charger des données dans le sous-système d'ingestion de données, choisissez une classe de stockage appropriée en fonction des exigences de conservation des données et de fréquence d'accès de vos charges de travail. Par exemple, pour contrôler les coûts de stockage, vous pouvez choisir la classe de stockage Standard et utiliser la gestion du cycle de vie des objets. Cette approche vous permet de déclasser automatiquement les objets vers une classe de stockage plus économique, ou bien de les supprimer en fonction des conditions que vous avez définies.
Considérations liées aux coûts de Cloud Logging
Pour contrôler le coût de stockage des journaux, tenez compte des recommandations suivantes :
- Réduisez le volume des journaux en excluant ou en filtrant les entrées de journal inutiles. Pour en savoir plus, consultez Filtres de récepteur de journaux.
- Réduisez la durée de conservation des entrées de journal. Pour en savoir plus, consultez Configurer une conservation personnalisée.
Pour connaître les principes et recommandations d'optimisation des coûts spécifiques aux charges de travail d'IA et de ML, consultez Perspective IA et ML : optimisation des coûts dans le framework d'architecture de référence.
Performances
Cette section décrit les facteurs à prendre en compte lorsque vous concevez et créez une application d'IA générative compatible RAG dans Google Cloud et répondant à vos exigences de performances.
Latence des fonctions Cloud Run
Pour réduire la latence de démarrage à froid après des périodes d'inactivité, configurez un nombre minimal d'instances.
Considérations sur les performances d'AlloyDB
Pour vous assurer que votre configuration AlloyDB répond à vos exigences de performances, tenez compte des recommandations suivantes :
- Indexation vectorielle et moteur de données en colonnes : pour accélérer les requêtes de similarité vectorielle dans les charges de travail RAG, créez un index de recherche approximative du voisin le plus proche (ANN) tel que ScaNN ou HNSW. Pour en savoir plus, consultez Choisir une stratégie d'indexation. Pour accélérer davantage les analyses vectorielles et les requêtes filtrées, consultez Accélérer la recherche vectorielle avec le moteur de données en colonnes.
- Analyse des performances des requêtes : pour vous aider à analyser et à améliorer les performances des requêtes des bases de données, AlloyDB fournit un outil Insights sur les requêtes. Cet outil vous permet de surveiller les performances et de suivre la source d'une requête problématique. Pour en savoir plus, consultez À propos des insights sur les requêtes.
- Surveillance des instances : pour obtenir un aperçu de l'état et des performances de vos bases de données, ainsi que pour afficher des métriques détaillées telles que les pics de connexion et le délai avant réplication maximal, vous pouvez utiliser le tableau de bord "Insights sur le système". Pour en savoir plus, consultez Surveiller une instance à l'aide du tableau de bord des insights système d'AlloyDB.
- Scaling des lectures : pour réduire la charge sur votre instance AlloyDB principale et effectuer un scaling horizontal de la capacité de gestion des requêtes de lecture, vous pouvez ajouter des instances de pool de lecture au cluster. Pour en savoir plus, consultez Qu'est-ce qu'une instance AlloyDB ?.
Considérations liées aux performances de BigQuery
Pour vous assurer que votre utilisation de BigQuery répond à vos exigences de performances, tenez compte des recommandations suivantes :
- Insights sur les performances des requêtes : BigQuery fournit un graphique d'exécution de requêtes que vous pouvez utiliser pour analyser les performances des requêtes et obtenir des insights sur les performances pour des problèmes tels que les conflits d'emplacements et le quota de brassage insuffisant. Pour en savoir plus, consultez Obtenir des insights sur les performances des requêtes.
- Optimisation du calcul des requêtes : une fois que vous avez résolu les problèmes identifiés via les insights sur les performances des requêtes, vous pouvez optimiser davantage les requêtes en utilisant des techniques telles que la réduction du volume de données d'entrée et de sortie. Pour en savoir plus, consultez la page Optimiser le calcul des requêtes.
Considérations sur les performances de Cloud Storage
Pour importer des fichiers volumineux, vous pouvez utiliser une méthode appelée importations composites parallèles. Grâce à cette stratégie, les fichiers volumineux sont divisés en fragments. Les fragments sont importés dans Cloud Storage en parallèle, puis les données sont recomposées dans le cloud. Lorsque la bande passante réseau et la vitesse du disque ne sont pas des facteurs limitants, les importations composites parallèles peuvent se révéler plus rapides que les opérations d'importation standards. Cependant, cette stratégie présente certaines limites et a des répercussions en termes de coûts. Pour en savoir plus, consultez la section Importations composites parallèles.
Pour connaître les principes et recommandations d'optimisation des performances spécifiques aux charges de travail d'IA et de ML, consultez Perspective de l'IA et du ML : optimisation des performances dans le Well-Architected Framework.
Déploiement
Pour commencer et tester la création d'une infrastructure sur Google Cloudpour les applications d'IA générative compatibles avec la fonction RAG, utilisez l'exemple de code disponible sur GitHub. Ce code déploie une application de chat basée sur Python sur Cloud Run et utilise une base de données Cloud SQL entièrement gérée pour la recherche vectorielle.
Étapes suivantes
- Application RAG agentique AlloyDB avec MCP Toolbox
- Infrastructure RAG pour l'IA générative à l'aide d'Agent Platform et de Vector Search
- Infrastructure RAG pour l'IA générative à l'aide de GKE et Cloud SQL
- Infrastructure RAG pour l'IA générative à l'aide de Gemini Enterprise et d'Agent Platform
- Infrastructure GraphRAG pour l'IA générative à l'aide d'Agent Platform et de Spanner Graph
- Pour obtenir un aperçu des principes et recommandations d'architecture spécifiques aux charges de travail d'IA et de ML dans Google Cloud, consultez la perspective IA et ML dans le Well-Architected Framework.
- Pour découvrir d'autres architectures de référence, schémas et bonnes pratiques, consultez le Centre d'architecture cloud.
Contributeurs
Auteur : Kumar Dhanagopal | Cross-product solution developer
Autres contributeurs :
- Andrew Brook | Directeur de l'ingénierie
- Anna Berenberg | Engineering Fellow
- Assaf Namer | Architecte principal de sécurité cloud
- Balachandar Krishnamoorthy | Ingénieur logiciel principal
- Daniel Lees | Architecte en sécurité cloud
- Derek Downey | Ingénieur relations avec les développeurs
- Eran Lewis | Responsable produit senior
- Geoffrey Anderson | Responsable produit
- Gleb Otochkin | Cloud Advocate, Bases de données
- Hamsa Buvaraghan | Responsable produit d'IA
- Irina Sigler | Responsable produit
- Jack Wotherspoon | Developer Advocate
- Jason Davenport | Developer Advocate
- Jordan Totten | Ingénieur client
- Julia Wiesinger | Responsable produit
- Kara Greenfield | Ingénieur client
- Kurtis Van Gent | Ingénieur logiciel
- Per Jacobsson | Ingénieur logiciel
- Pranav Nambiar | Directeur
- Richard Hendricks | Personnel Architecture Center
- Safiuddin Khaja | Ingénieur cloud
- Sandy Ghai | Responsable groupe de produits
- Vladimir Vuskovic | Directeur de la gestion des produits
- Steren Giannini | Responsable groupe de produits
- Wietse Venema | Ingénieur relations avec les développeurs