


Pour protéger vos données contre les pannes régionales et réduire la latence de lecture pour les utilisateurs répartis géographiquement, la réplication interrégionale AlloyDB pour PostgreSQL vous permet de créer des clusters et des instances secondaires à partir d'un cluster principal dans différentes régions. Ces clusters et instances secondaires fonctionnent comme des copies mises à jour en continu des ressources de votre cluster et de votre instance principaux.
Voici les principaux concepts abordés sur cette page :
Cluster principal. Cluster en lecture/écriture dans une seule région.
Cluster secondaire. Cluster en lecture seule situé dans une région différente de celle du cluster principal, qui effectue une réplication asynchrone à partir du cluster principal. En cas de défaillance d'un cluster principal AlloyDB, vous pouvez promouvoir un cluster secondaire en cluster principal.
Vous pouvez créer jusqu'à cinq clusters secondaires pour un cluster principal. Tous les clusters secondaires effectuent une réplication à partir d'un seul cluster principal. Si vous promouvez un cluster secondaire, il devient un cluster principal indépendant.
Instance secondaire. Un leader en lecture seule d'un cluster secondaire. Il est chargé de recevoir un flux de réplication d'un cluster principal. Le flux de réplication met à jour le volume de stockage dans la région secondaire en fonction du volume de stockage dans la région principale. Si un cluster secondaire est promu en cluster principal, l'instance secondaire devient l'instance principale.
Une instance secondaire peut être de base (zonale) ou à haute disponibilité (régionale).
Le schéma suivant illustre le fonctionnement de la réplication interrégionale :
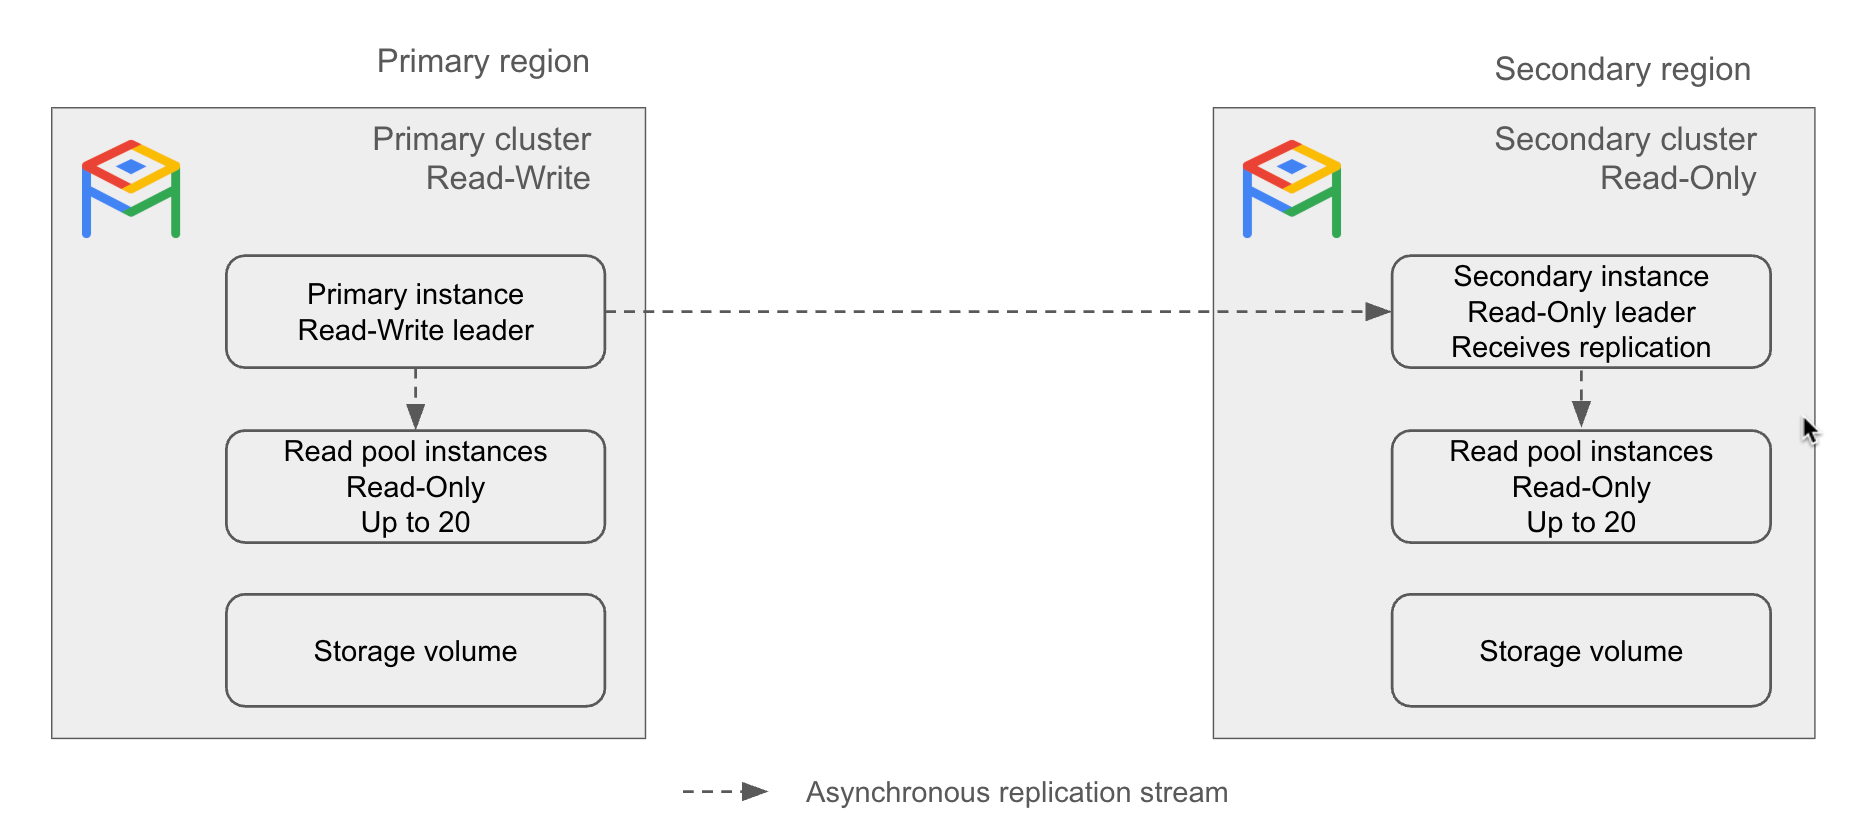
Figure 1 : Exemple d'architecture de réplication interrégionale AlloyDB.
Avantages
La réplication interrégionale sur AlloyDB présente les avantages suivants :
Reprise après sinistre. Si la région du cluster principal devient indisponible, vous pouvez promouvoir les ressources AlloyDB d'une autre région pour répondre aux requêtes.
Réduction des temps d'arrêt La prise en charge de la haute disponibilité sur les clusters secondaires réduit les temps d'arrêt lors des événements de maintenance ou des pannes non planifiées.
Données réparties géographiquement. La répartition géographique des données les rapproche de vous et réduit la latence en lecture.
Scaling en lecture amélioré : chaque instance répliquée interrégionale (ou cluster secondaire) peut accepter jusqu'à 20 nœuds de lecture, ce qui vous permet d'effectuer un scaling plus important de vos lectures.
Basculement sans perte de données Pour les configurations de réplication interrégionale, AlloyDB permet de basculer entre l'instance principale et l'instance secondaire sans aucune perte de données.
Utiliser la réplication interrégionale
L'utilisation de la réplication interrégionale AlloyDB implique les tâches suivantes :
Créez un cluster secondaire. Un cluster secondaire est une copie mise à jour en continu de votre cluster AlloyDB principal.
Afficher un cluster secondaire Une fois que vous avez créé un cluster secondaire, vous pouvez afficher ses détails sur la page Clusters de la console Google Cloud .
Ajoutez des instances de pool de lecture. Vous pouvez ajouter des instances de pool de lecture à un cluster secondaire. Si vous souhaitez effectuer un scaling horizontal de votre capacité de lecture, vous pouvez ajouter jusqu'à 20 nœuds de lecture à votre cluster secondaire.
Promouvoir un cluster secondaire Vous pouvez lire les données d'un cluster secondaire, mais vous ne pouvez pas y écrire tant que vous ne l'avez pas promu en cluster principal autonome complet. Lorsque vous promouvez un cluster secondaire, l'instance secondaire du cluster est également promue en tant qu'instance principale avec accès en lecture et écriture.
Le principal cas d'utilisation de la promotion d'un cluster secondaire est la reprise après sinistre. Si une panne régionale se produit dans la région de votre cluster principal, vous pouvez promouvoir votre cluster secondaire en cluster principal autonome et reprendre la diffusion de votre application.
Configurez des sauvegardes automatiques et continues. Par défaut, AlloyDB copie automatiquement les configurations de sauvegarde automatique et continue du cluster principal vers un cluster secondaire nouvellement créé. Si vous souhaitez utiliser des configurations de sauvegarde différentes pour votre cluster secondaire, vous pouvez modifier la configuration de sauvegarde lorsque vous créez un cluster secondaire.
Si votre cluster principal utilise le chiffrement par clé de chiffrement gérée par le client (CMEK) pour les sauvegardes, effectuez l'une des opérations suivantes lorsque vous créez un cluster secondaire :
- Fournissez les paramètres de chiffrement CMEK pour les sauvegardes du cluster secondaire.
- Désactivez les sauvegardes pour le cluster secondaire.
Pour en savoir plus sur le chiffrement de vos sauvegardes avec CMEK, consultez Utiliser CMEK.
Vous pouvez modifier les paramètres de sauvegarde automatique et continue du cluster secondaire après sa création.
Reprise après sinistre avancée
Pour les scénarios de reprise après sinistre avancés, AlloyDB est compatible avec la commutation et le basculement interrégional :
Effectuez un basculement interrégional. Le basculement interrégional (preview) est une fonctionnalité avancée de reprise après sinistre qui promeut un cluster secondaire en cluster principal tout en recréant automatiquement le cluster principal d'origine en tant que nouveau cluster secondaire. Cette fonctionnalité maintient votre topologie de réplication sans nécessiter la suppression ou la recréation manuelle du cluster une fois la panne résolue. Cela simplifie le retour à votre topologie d'origine après une reprise après sinistre.
Basculement sans perte de données La commutation vous permet d'inverser les rôles de vos clusters principal et secondaire sans aucune perte de données. Vous pouvez effectuer une commutation pour tester votre configuration de reprise après sinistre, effectuer un retour en arrière vers votre topologie d'origine après une panne ou migrer votre charge de travail. Une fois la commutation terminée, la direction de la réplication est inversée.
Si vous disposez de plusieurs clusters secondaires, le cluster secondaire qui reçoit la commande de permutation devient un cluster principal. L'ancien cluster principal devient un cluster secondaire, qui réplique à partir du nouveau cluster principal. Tous les autres clusters secondaires passent à la réplication à partir du nouveau cluster principal.
Il existe deux scénarios courants pour basculer vers votre cluster secondaire :
- Exercices de reprise après sinistre Vous pouvez tester vos processus de reprise après sinistre en basculant votre application vers une autre région sans perte de données pour simuler une panne régionale.
- Migration régionale. Effectuez une migration planifiée des ressources AlloyDB de leur région principale vers une autre région. Le basculement garantit que le cluster secondaire devient un cluster principal avec un objectif de point de récupération (RPO) de 0, ce qui garantit que la migration ne perd aucune donnée.