


Este princípio no pilar de confiabilidade do Google Cloud Framework Well-Architected fornece recomendações para ajudar você a realizar post-mortems eficazes após falhas e incidentes.
Esse princípio é relevante para a área de foco de aprendizado da confiabilidade.
Visão geral do princípio
Uma análise post-mortem é um registro escrito de um incidente, o impacto dele, as ações tomadas para mitigar ou resolver o incidente, as causas raiz e as ações de acompanhamento para evitar que o incidente ocorra novamente. O objetivo de uma análise post-mortem é aprender com os erros, não atribuir culpa.
O diagrama a seguir mostra o fluxo de trabalho de uma análise:
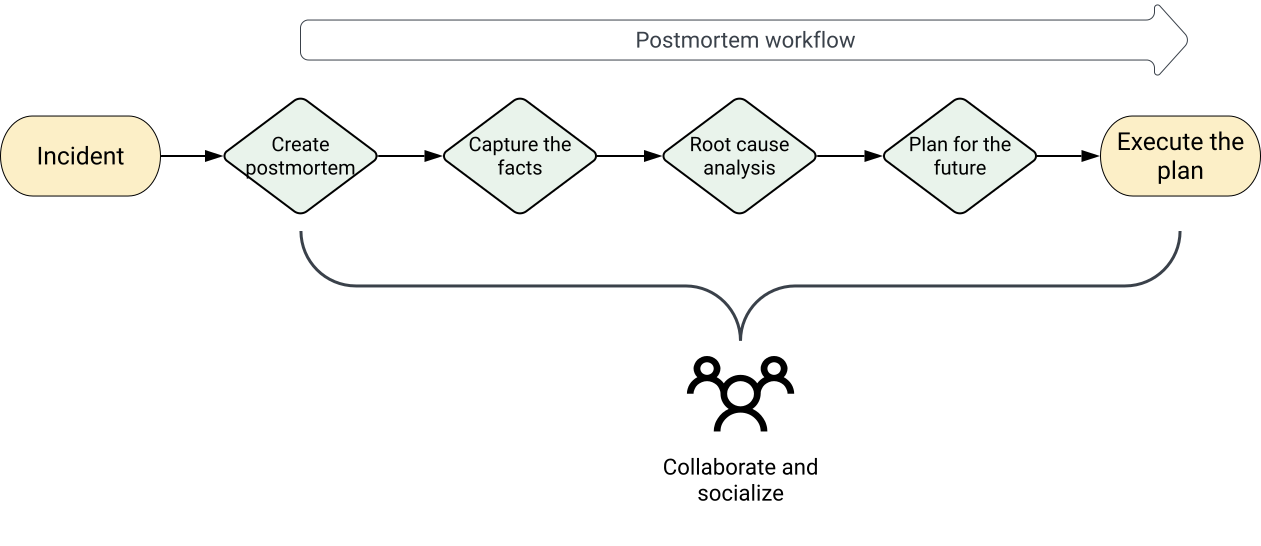
O fluxo de trabalho de uma análise post-mortem inclui as seguintes etapas:
- Criar post-mortem
- Capturar os fatos
- Identificar e analisar as causas raiz
- Planeje o futuro
- Execute o plano.
Realize análises de retrospectiva após eventos importantes e não importantes, como os seguintes:
- Inatividades ou degradações visíveis para o usuário além de um determinado limite.
- Perdas de dados de qualquer tipo.
- Intervenções de engenheiros de plantão, como uma reversão de versão ou redirecionamento de tráfego.
- Tempos de resolução acima de um limite definido.
- Falhas de monitoramento, que geralmente implicam na descoberta manual de incidentes.
Recomendações
Defina os critérios de post-mortem antes que um incidente ocorra para que todos saibam quando um post-mortem é necessário.
Para realizar análises post-mortem eficazes, considere as recomendações nas subseções a seguir.
Realizar análises post-mortem sem apontar culpados
As análises post-mortem eficazes se concentram em processos, ferramentas e tecnologias, e não culpam indivíduos ou equipes. O objetivo de uma análise post-mortem é melhorar sua tecnologia e o futuro, não encontrar quem é culpado. Todo mundo comete erros. O objetivo deve ser analisar os erros e aprender com eles.
Os exemplos a seguir mostram a diferença entre o feedback que atribui culpa e o feedback sem culpa:
- Feedback que atribui culpa: "Precisamos reescrever todo o sistema de back-end complicado! Ele tem quebrado semanalmente nos últimos três trimestres, e tenho certeza de que todos estamos cansados de consertar as coisas aos poucos. Sério, se eu receber mais um alerta, vou reescrever o código…"
- Feedback sem culpa: "Uma ação necessária para reescrever todo o sistema de back-end pode impedir que essas páginas continuem acontecendo. O manual de manutenção dessa versão é bastante longo e é muito difícil receber treinamento completo sobre ele. Tenho certeza de que nossos futuros engenheiros de plantão vão nos agradecer!"
O relatório de análise precisa ser legível para todos os públicos-alvo.
Para cada informação que você planeja incluir no relatório, avalie se ela é importante e necessária para ajudar o público a entender o que aconteceu. Você pode mover dados e explicações complementares para um apêndice do relatório. Os revisores que precisarem de mais informações podem solicitá-las.
Evite soluções complexas ou excessivamente projetadas
Antes de começar a buscar soluções para um problema, avalie a importância dele e a probabilidade de recorrência. Adicionar complexidade ao sistema para resolver problemas que provavelmente não vão ocorrer novamente pode aumentar a instabilidade.
Compartilhe a análise post-mortem com o maior número possível de pessoas
Para garantir que os problemas não fiquem sem solução, publique o resultado da análise para um público amplo e receba o apoio da gerência. O valor de uma análise post-mortem é proporcional ao aprendizado que ocorre após a análise. Quando mais pessoas aprendem com os incidentes, a probabilidade de falhas semelhantes recorrentes é reduzida.