


Este documento no Google Cloud Well-Architected Framework: perspectiva de serviços financeiros (FS) oferece uma visão geral dos princípios e recomendações para projetar, implantar e operar cargas de trabalho de FS confiáveis no Google Cloud. O documento explica como integrar práticas avançadas de confiabilidade e observabilidade aos seus blueprints de arquitetura. As recomendações neste documento estão alinhadas com o pilar de confiabilidade do Well-Architected Framework.
Para as instituições financeiras, uma infraestrutura confiável e resiliente é uma necessidade comercial e um imperativo regulatório. Para garantir que as cargas de trabalho de FS em Google Cloud sejam confiáveis, é preciso entender e mitigar possíveis pontos de falha, implantar recursos de forma redundante e planejar a recuperação. A resiliência operacional é um resultado da confiabilidade. É a capacidade de absorver, se adaptar e se recuperar de interrupções. A resiliência operacional ajuda as organizações de FS a atender a requisitos regulatórios rigorosos. Isso também ajuda a evitar danos intoleráveis aos clientes.
Os principais elementos de confiabilidade no Google Cloud são regiões, zonas e os vários escopos de localização de recursos de nuvem: zonal, regional, multirregional e global. É possível melhorar a disponibilidade usando serviços gerenciados, distribuindo recursos, implementando padrões de alta disponibilidade e automatizando processos.
Requisitos regulatórios
As organizações de FS operam sob mandatos de confiabilidade rigorosos de agências reguladoras, como o Federal Reserve System nos EUA, a Autoridade Bancária Europeia na UE e a Autoridade de Regulação Prudencial no Reino Unido. Em todo o mundo, os reguladores enfatizam a resiliência operacional, que é vital para a estabilidade financeira e a proteção do consumidor. A resiliência operacional é a capacidade de resistir a interrupções, se recuperar de maneira eficaz e manter serviços críticos. Isso exige uma abordagem harmonizada para gerenciar riscos tecnológicos e dependências de terceiros.
Os requisitos regulatórios na maioria das jurisdições têm os seguintes temas comuns:
- Cibersegurança e resiliência tecnológica: fortalecimento das defesas contra ameaças cibernéticas e garantia da resiliência dos sistemas de TI.
- Gerenciamento de riscos de terceiros: gerenciar os riscos associados à terceirização de serviços para provedores de tecnologia da informação e comunicação (TIC).
- Continuidade dos negócios e resposta a incidentes: planejamento robusto para manter as operações críticas durante interrupções e se recuperar de maneira eficaz.
- Proteção da estabilidade financeira: garantir a solidez e a estabilidade do sistema financeiro como um todo.
As recomendações de confiabilidade neste documento são mapeadas para os seguintes princípios fundamentais:
- Priorizar implantações multizona e multirregionais
- Eliminar pontos únicos de falha (SPOFs)
- Entender e gerenciar a disponibilidade agregada
- Implementar uma estratégia de DR robusta
- Aproveitar os serviços gerenciados
- Automatizar os processos de provisionamento e recuperação da infraestrutura
Priorizar implantações multizona e multirregionais
Para aplicativos de serviços financeiros críticos, recomendamos o uso de uma topologia multirregional distribuída em pelo menos duas regiões e em três zonas dentro de cada região. Essa abordagem é importante para a resiliência contra interrupções de zona e região. As regulamentações geralmente prescrevem essa abordagem, porque, se ocorrer uma falha em uma zona ou região, a maioria das jurisdições considera uma interrupção grave em uma segunda zona como uma consequência plausível. A lógica é que, quando um local falha, o outro pode receber uma quantidade excepcionalmente alta de tráfego extra.
Considere as seguintes recomendações para aumentar a resiliência contra falhas de zona e região:
- Dê preferência a recursos com um escopo de localização mais amplo. Sempre que possível, use recursos regionais em vez de zonais e use recursos multirregionais ou globais em vez de regionais. Essa abordagem ajuda a evitar a necessidade de restaurar operações usando backups.
- Em cada região, use três zonas em vez de duas. Para lidar com failovers, provisione uma capacidade um terço maior do que a estimativa.
- Minimize as etapas de recuperação manual implementando implantações ativo-ativo,
como nos exemplos a seguir:
- Bancos de dados distribuídos, como o Spanner, oferecem redundância e sincronização integradas entre regiões.
- O recurso de alta disponibilidade do Cloud SQL oferece uma topologia quase ativa-ativa, com réplicas de leitura em várias zonas. Ele fornece um objetivo de ponto de recuperação (RPO) entre regiões que é próximo de 0.
- Distribua o tráfego de usuários entre as regiões usando o Cloud DNS e implante um balanceador de carga regional em cada região. Um balanceador de carga global é outra opção que você pode considerar, dependendo dos seus requisitos e da importância. Para mais informações, consulte Benefícios e riscos do balanceamento de carga global para implantações multirregionais.
- Para armazenar dados, use serviços multirregionais, como o Spanner e o Cloud Storage.
Eliminar pontos únicos de falha
Distribua recursos em diferentes locais e use recursos redundantes para evitar que um único ponto de falha (SPOF, na sigla em inglês) afete toda a pilha de aplicativos.
Considere as seguintes recomendações para evitar SPOFs:
- Evite implantar apenas um servidor de aplicativos ou banco de dados.
- Garanta a recriação automática de VMs com falha usando grupos gerenciados de instâncias (MIGs).
- Distribua o tráfego de maneira uniforme entre os recursos disponíveis implementando o balanceamento de carga.
- Use configurações de alta disponibilidade para bancos de dados como o Cloud SQL.
- Melhore a disponibilidade de dados usando discos permanentes regionais com replicação síncrona.
Para mais informações, consulte Criar uma infraestrutura confiável para suas cargas de trabalho no Google Cloud.
Entender e gerenciar a disponibilidade agregada
A disponibilidade geral ou agregada de um sistema é afetada pela disponibilidade de cada nível ou componente do sistema. O número de níveis em uma pilha de aplicativos tem uma relação inversa com a disponibilidade agregada da pilha. Considere as seguintes recomendações para gerenciar a disponibilidade agregada:
Calcule a disponibilidade agregada de uma pilha de vários níveis usando a fórmula tier1_availability × tier2_availability × tierN_availability.
O diagrama a seguir mostra o cálculo da disponibilidade agregada para um sistema de vários níveis que consiste em quatro serviços:
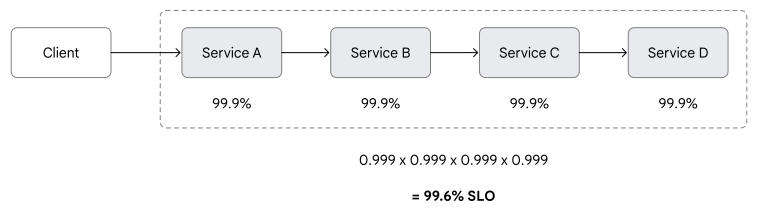
No diagrama anterior, o serviço em cada nível oferece 99,9% de disponibilidade, mas a disponibilidade agregada do sistema é menor, de 99,6% (0,999 × 0,999 × 0,999 × 0,999). Em geral, a disponibilidade agregada de uma pilha de vários níveis é menor que a disponibilidade do nível que fornece a menor disponibilidade.
Sempre que possível, escolha a paralelização em vez do encadeamento. Com serviços paralelizados, a disponibilidade de ponta a ponta é maior do que a disponibilidade de cada serviço individual.
O diagrama a seguir mostra dois serviços, A e B, que são implantados usando as abordagens de encadeamento e paralelização:
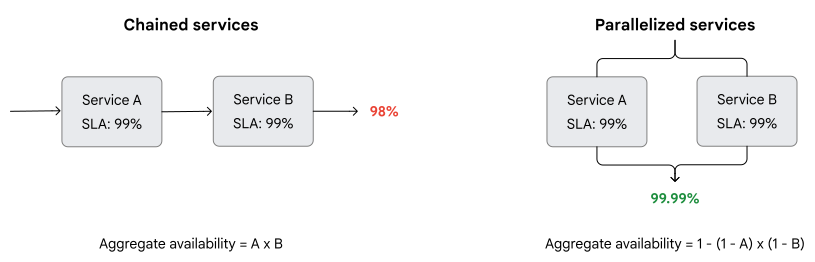
Nos exemplos anteriores, os dois serviços têm um SLA de 99%, o que resulta na seguinte disponibilidade agregada, dependendo da abordagem de implementação:
- Serviços encadeados geram uma disponibilidade agregada de apenas 98% (0,99 × 0,99).
- Os serviços paralelizados geram uma disponibilidade agregada maior de 99,99%, porque cada serviço é executado de forma independente e os serviços individuais não são afetados pela disponibilidade dos outros serviços. A fórmula para serviços paralelizados agregados é 1 − (1 − A) × (1 − B).
Escolha serviços do Google Cloud com SLAs de tempo de atividade que possam ajudar a atender ao nível necessário de tempo de atividade geral para sua pilha de aplicativos.
Ao projetar sua arquitetura, considere as vantagens e desvantagens entre disponibilidade, complexidade operacional, latência e custo. Aumentar o número de noves de disponibilidade geralmente custa mais, mas ajuda a atender aos requisitos regulatórios.
Por exemplo, 99,9% de disponibilidade (três noves) significa um tempo de inatividade potencial de 86 segundos em um dia de 24 horas. Por outro lado, 99% (dois noves) significa uma inatividade de 864 segundos no mesmo período, o que é 10 vezes mais inatividade do que com três noves de disponibilidade.
Para serviços financeiros críticos, as opções de arquitetura podem ser limitadas. No entanto, é fundamental identificar os requisitos de disponibilidade e calculá-la com precisão. Essa avaliação ajuda você a avaliar as implicações das suas decisões de design na arquitetura e no orçamento.
Implementar uma estratégia de DR robusta
Crie planos bem definidos para diferentes cenários de desastre, incluindo interrupções zonais e regionais. Uma estratégia de recuperação de desastres (DR) bem definida permite que você se recupere de uma interrupção e retome as operações normais com o mínimo de impacto.
DR e alta disponibilidade (HA) são conceitos diferentes. Com implantações na nuvem, em geral, a DR se aplica a implantações multirregionais, e a HA se aplica a implantações regionais. Esses arquétipos de implantação oferecem suporte a diferentes mecanismos de replicação.
- HA: muitos serviços gerenciados oferecem replicação síncrona entre zonas em uma única região por padrão. Esses serviços oferecem suporte a um objetivo de tempo de recuperação (RTO) e um objetivo de ponto de recuperação (RPO) de zero ou quase zero. Esse suporte permite criar uma topologia de implantação ativo-ativo que não tem SPOF.
- DR: para cargas de trabalho implantadas em duas ou mais regiões, se você não usar serviços multirregionais ou globais, será necessário definir uma estratégia de replicação. A estratégia de replicação normalmente é assíncrona. Avalie com cuidado como essa replicação afeta o RTO e o RPO de aplicativos críticos. Identifique as operações manuais ou semiautomatizadas necessárias para o failover.
Para instituições financeiras, a escolha da região de failover pode ser limitada por regulamentações sobre soberania de dados e residência de dados. Se você precisar de uma topologia ativo-ativo em duas regiões, recomendamos que escolha serviços multirregionais gerenciados, como o Spanner e o Cloud Storage, especialmente quando a replicação de dados for essencial.
Recomendações:
- Usar serviços de armazenamento multirregional gerenciados para dados.
- Crie snapshots de dados em discos permanentes e armazene-os em locais multirregionais.
- Ao usar recursos regionais ou zonais, configure a replicação de dados para outras regiões.
- Teste o plano de DR regularmente para garantir que ele seja eficaz.
- Esteja ciente do RTO e do RPO e da correlação deles com a tolerância ao impacto estipulada pelas regulamentações financeiras na sua jurisdição.
Para mais informações, consulte Como arquitetar a recuperação de desastres para interrupções da infraestrutura em nuvem.
Aproveitar os serviços gerenciados
Sempre que possível, use serviços gerenciados para aproveitar os recursos integrados de backups, alta disponibilidade e escalonabilidade. Considere as seguintes recomendações para usar serviços gerenciados:
- Usar serviços gerenciados no Google Cloud. Eles fornecem HA com suporte de SLAs. Eles também oferecem mecanismos de backup integrados e recursos de resiliência.
- Para o gerenciamento de dados, considere serviços como Cloud SQL, Cloud Storage e Spanner.
- Para hospedagem de computação e aplicativos, considere os grupos gerenciados de instâncias (MIGs) do Compute Engine e os clusters do Google Kubernetes Engine (GKE). Os MIGs regionais e os clusters regionais do GKE são resilientes a falhas temporárias de zonas.
- Para melhorar a resiliência contra interrupções de região, use serviços multirregionais gerenciados.
- Identifique a necessidade de planos de saída para serviços com características exclusivas e defina os planos necessários. Reguladores financeiros como a FCA, a PRA e a EBA exigem que as empresas tenham estratégias e planos de contingência para recuperação de dados e continuidade operacional se o relacionamento com um provedor de nuvem terminar. As empresas precisam avaliar a viabilidade de saída antes de firmar contratos de nuvem e manter a capacidade de mudar de provedor sem interrupção operacional.
- Verifique se os serviços escolhidos são compatíveis com a exportação de dados para um formato aberto, como CSV, Parquet e Avro. Verifique se os serviços são baseados em tecnologias abertas, como o suporte do GKE ao formato Open Container Initiative (OCI) ou ao serviço gerenciado para Apache Airflow.
Automatizar os processos de provisionamento e recuperação da infraestrutura
Automation ajuda a minimizar erros humanos e a reduzir o tempo e os recursos necessários para responder a incidentes. O uso da automação pode ajudar a garantir uma recuperação mais rápida de falhas e resultados mais consistentes. Considere as seguintes recomendações para automatizar o provisionamento e a recuperação de recursos:
- Minimize erros humanos usando ferramentas de infraestrutura como código (IaC), como o Terraform.
- Reduza a intervenção manual automatizando os processos de failover. As respostas automatizadas também podem ajudar a reduzir o impacto das falhas. Por exemplo, é possível usar o Eventarc ou o Workflows para acionar automaticamente ações corretivas em resposta a problemas observados nos registros de auditoria.
- Aumente a capacidade dos recursos de nuvem durante o failover usando o escalonamento automático.
- Aplique automaticamente políticas e proteções para requisitos regulatórios em toda a topologia de nuvem durante a implantação do serviço adotando a engenharia de plataforma.