


Questo pilastro del Google Cloud Well-Architected Framework fornisce consigli per ottimizzare le prestazioni dei workload inGoogle Cloud.
Questo documento è rivolto ad architetti, sviluppatori e amministratori che pianificano, progettano, eseguono il deployment e gestiscono i workload in Google Cloud.
I suggerimenti di questo pilastro possono aiutare la tua organizzazione a operare in modo efficiente, migliorare la soddisfazione del cliente, aumentare le entrate e ridurre i costi. Ad esempio, quando il tempo di elaborazione del backend di un'applicazione diminuisce, gli utenti riscontrano tempi di risposta più rapidi, il che può portare a una maggiore fidelizzazione degli utenti e a maggiori entrate.
Il processo di ottimizzazione delle prestazioni può comportare un compromesso tra prestazioni e costi. Tuttavia, l'ottimizzazione delle prestazioni a volte può aiutarti a ridurre i costi. Ad esempio, quando il carico aumenta, la scalabilità automatica può contribuire a fornire prestazioni prevedibili garantendo che le risorse di sistema non siano sovraccariche. La scalabilità automatica ti aiuta anche a ridurre i costi rimuovendo le risorse inutilizzate durante i periodi di carico ridotto.
L'ottimizzazione del rendimento è un processo continuo, non un'attività una tantum. Il seguente diagramma mostra le fasi del processo di ottimizzazione del rendimento:
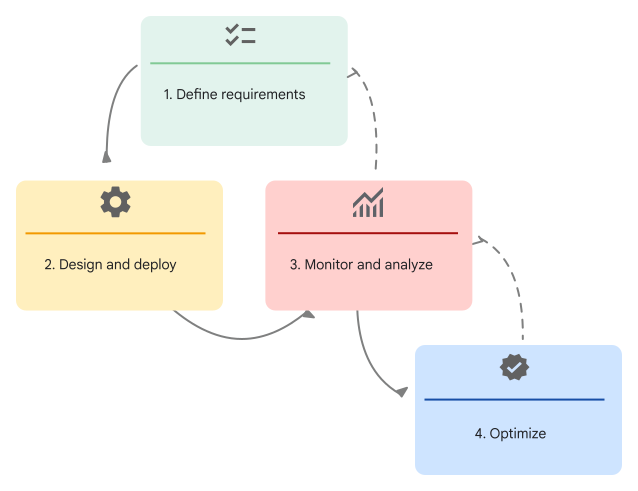
Il processo di ottimizzazione delle prestazioni è un ciclo continuo che include le seguenti fasi:
- Definisci i requisiti: definisci requisiti di prestazioni granulari per ogni livello dello stack dell'applicazione prima di progettare e sviluppare le tue applicazioni. Per pianificare l'allocazione delle risorse, considera le caratteristiche principali del workload e le aspettative di prestazioni.
- Progetta ed esegui il deployment: utilizza pattern di progettazione elastici e scalabili che possono aiutarti a soddisfare i tuoi requisiti di prestazioni.
- Monitoraggio e analisi: monitora continuamente le prestazioni utilizzando log, tracciamento, metriche e avvisi.
Ottimizza: valuta potenziali riprogettazioni man mano che le tue applicazioni si evolvono. Ridimensiona le risorse cloud e utilizza nuove funzionalità per soddisfare i requisiti di prestazioni in continua evoluzione.
Come mostrato nel diagramma precedente, continua il ciclo di monitoraggio, rivalutazione dei requisiti e modifica delle risorse cloud.
Per i principi e i suggerimenti di ottimizzazione delle prestazioni specifici per i workload di AI e ML, consulta Prospettiva di AI e ML: ottimizzazione delle prestazioni nel Well-Architected Framework.
Valuta i workload utilizzando una competenza dell'agente
Per consentire agli agenti AI di valutare i tuoi workload cloud in base ai principi e ai suggerimenti di questo pilastro, utilizza la skill google-cloud-waf-performance-optimization, disponibile nel repository Google Agent Skills su GitHub.
Per installare la skill, esegui questo comando nel client o nel terminale dell'agente:
npx skills add google/skills --skill google-cloud-waf-performance-optimization
Quando richiesto, specifica gli agenti AI per cui vuoi installare la skill e imposta l'ambito di installazione (progetto o globale).
Se hai già installato la skill, puoi aggiornarla all'ultima versione eseguendo questo comando:
npx skills update
Principi fondamentali
I consigli del pilastro dell'ottimizzazione delle prestazioni del Well-Architected Framework sono mappati ai seguenti principi fondamentali:
- Pianifica l'allocazione delle risorse
- Sfrutta l'elasticità
- Promuovi il design modulare
- Monitora e migliora costantemente il rendimento
Collaboratori
Autori:
- Daniel Lees | Cloud Security Architect
- Gary Harmson | Principal Architect
- Luis Urena | Developer Relations Engineer
- Zach Seils | Networking Specialist
Altri collaboratori:
- Filipe Gracio, PhD | Customer Engineer, AI/ML Specialist
- Jose Andrade | Customer Engineer, SRE Specialist
- Kumar Dhanagopal | Cross-Product Solution Developer
- Marwan Al Shawi | Partner Customer Engineer
- Nicolas Pintaux | Customer Engineer, Application Modernization Specialist
- Ryan Cox | Principal Architect
- Radhika Kanakam | Program Lead, Google Cloud Well-Architected Framework
- Samantha He | Technical Writer
- Wade Holmes | Global Solutions Director
Pianifica l'allocazione delle risorse
Questo principio del pilastro dell'ottimizzazione delle prestazioni del Google Cloud Well-Architected Framework fornisce consigli per aiutarti a pianificare le risorse per i tuoi workload inGoogle Cloud. Sottolinea l'importanza di definire requisiti granulari prima di progettare e sviluppare applicazioni per il deployment o la migrazione nel cloud.
Panoramica del principio
Per soddisfare i requisiti aziendali, è importante definire i requisiti di prestazioni per le tue applicazioni prima della progettazione e dello sviluppo. Definisci questi requisiti nel modo più granulare possibile per l'applicazione nel suo insieme e per ogni livello dello stack dell'applicazione. Ad esempio, nel livello di archiviazione, devi considerare il throughput e le operazioni di I/O al secondo (IOPS) necessarie per le applicazioni.
Fin dall'inizio, pianifica i design delle applicazioni tenendo conto delle prestazioni e della scalabilità. Considera fattori come il numero di utenti, il volume di dati e la potenziale crescita nel tempo.
I requisiti di prestazioni per ogni workload variano e dipendono dal tipo di workload. Ogni workload può contenere un mix di sistemi e servizi di componenti con insiemi univoci di caratteristiche di prestazioni. Ad esempio, un sistema responsabile dell'elaborazione batch periodica di set di dati di grandi dimensioni ha requisiti di prestazioni diversi rispetto a una soluzione di desktop virtuale interattiva. Le tue strategie di ottimizzazione devono soddisfare le esigenze specifiche di ogni workload.
Seleziona i servizi e le funzionalità in linea con gli obiettivi di rendimento di ogni workload. Per l'ottimizzazione del rendimento, non esiste una soluzione universale. Quando ottimizzi ogni workload, l'intero sistema può raggiungere prestazioni ed efficienza ottimali.
Tieni presente le seguenti caratteristiche del workload che possono influire sui tuoi requisiti di prestazioni:
- Archetipo di deployment: l'archetipo di deployment che selezioni per un'applicazione può influenzare la scelta di prodotti e funzionalità, che a loro volta determinano le prestazioni che puoi aspettarti dalla tua applicazione.
- Posizionamento delle risorse: quando selezioni una Google Cloud regione per le risorse della tua applicazione, ti consigliamo di dare priorità alla bassa latenza per gli utenti finali, di rispettare le normative sulla località dei dati e di garantire la disponibilità dei prodotti e dei servizi Google Cloud richiesti.
- Connettività di rete: scegli i servizi di networking che ottimizzano l'accesso ai dati e la distribuzione dei contenuti. Sfrutta la rete globale, i backbone ad alta velocità, le località di interconnessione e i servizi di memorizzazione nella cache di Google Cloud.
- Opzioni di hosting delle applicazioni: quando selezioni una piattaforma di hosting, devi valutare i vantaggi e gli svantaggi in termini di prestazioni di ogni opzione. Ad esempio, considera bare metal, macchine virtuali, container e piattaforme serverless.
- Strategia di archiviazione: scegli una strategia di archiviazione ottimale in base ai tuoi requisiti di prestazioni.
- Configurazioni delle risorse: il tipo di macchina, le IOPS e il throughput possono avere un impatto significativo sulle prestazioni. Inoltre, all'inizio della fase di progettazione, devi considerare le funzionalità di sicurezza appropriate e il loro impatto sulle risorse. Quando pianifichi le funzionalità di sicurezza, preparati ad accettare i necessari compromessi in termini di prestazioni per evitare effetti imprevisti.
Consigli
Per garantire un'allocazione ottimale delle risorse, prendi in considerazione i suggerimenti riportati nelle sezioni seguenti.
Configura e gestisci le quote
Assicurati che l'applicazione utilizzi solo le risorse necessarie, come memoria, spazio di archiviazione e potenza di elaborazione. Un'allocazione eccessiva può comportare spese non necessarie, mentre un'allocazione insufficiente potrebbe causare un peggioramento delle prestazioni.
Per consentire la scalabilità elastica e garantire la disponibilità di risorse adeguate, monitora regolarmente la capacità delle tue quote. Inoltre, monitora l'utilizzo delle quote per identificare potenziali vincoli di scalabilità o problemi di allocazione eccessiva, quindi prendi decisioni consapevoli sull'allocazione delle risorse.
Educate and promote awareness
Informa gli utenti sui requisiti di rendimento e fornisci risorse didattiche su tecniche efficaci di gestione del rendimento.
Per valutare i progressi e identificare le aree di miglioramento, documenta regolarmente le prestazioni target e quelle effettive. Esegui test di carico sull'applicazione per trovare potenziali punti di interruzione e capire come scalarla.
Monitora le metriche sul rendimento
Utilizza Cloud Monitoring per analizzare le tendenze nelle metriche sul rendimento, analizzare gli effetti degli esperimenti, definire avvisi per le metriche critiche ed eseguire analisi retrospettive.
Active Assist è un insieme di strumenti che possono fornire insight e suggerimenti per ottimizzare l'utilizzo delle risorse. Questi suggerimenti possono aiutarti ad adeguare l'allocazione delle risorse e a migliorare le prestazioni.
Sfrutta l'elasticità
Questo principio del pilastro dell'ottimizzazione delle prestazioni del Google Cloud Well-Architected Framework fornisce consigli per aiutarti a incorporare l'elasticità, ovvero la capacità di regolare le risorse in modo dinamico in base alle variazioni dei requisiti del workload.
L'elasticità consente ai diversi componenti di un sistema di scalare in modo indipendente. Questa scalabilità mirata può contribuire a migliorare le prestazioni e l'efficienza dei costi allocando le risorse esattamente dove sono necessarie, senza eseguire l'overprovisioning o l'underprovisioning delle risorse.
Panoramica del principio
I requisiti di prestazioni di un sistema influenzano direttamente quando e come il sistema esegue lo scale up o lo scale out. Devi valutare la capacità del sistema e determinare il carico che il sistema dovrebbe gestire in condizioni di base. Poi, devi determinare in che modo vuoi che il sistema risponda agli aumenti e alle diminuzioni del carico.
Quando il carico aumenta, il sistema deve fare lo scale out orizzontalmente, lo scale up verticalmente o entrambi. Per la scalabilità orizzontale, aggiungi nodi di replica per assicurarti che il sistema abbia una capacità complessiva sufficiente per soddisfare l'aumento della domanda. Per lo scale up, sostituisci i componenti esistenti dell'applicazione con componenti che contengono più capacità, più memoria e più spazio di archiviazione.
Quando il carico diminuisce, il sistema deve fare lo scale down (orizzontalmente, verticalmente o entrambi).
Definisci le circostanze in cui il sistema esegue lo scale up o lo scale down. Pianifica di fare lo scale up manuale dei sistemi per periodi noti di traffico elevato. Utilizza strumenti come la scalabilità automatica, che risponde agli aumenti o alle diminuzioni del carico.
Consigli
Per sfruttare l'elasticità, tieni presente i suggerimenti riportati nelle sezioni seguenti.
Pianifica i periodi di carico di picco
Devi pianificare un percorso di scalabilità efficiente per eventi noti, come i periodi previsti di aumento della domanda dei clienti.
Valuta la possibilità di fare lo scale up del sistema prima di periodi noti di traffico elevato. Ad esempio, se sei un'organizzazione di vendita al dettaglio, prevedi un aumento della domanda durante i saldi stagionali. Ti consigliamo di fare lo scale up o lo scale out dei tuoi sistemi manualmente prima di queste vendite per assicurarti che il tuo sistema possa gestire immediatamente l'aumento del carico o modificare immediatamente i limiti esistenti. In caso contrario, il sistema potrebbe impiegare diversi minuti per aggiungere risorse in risposta alle modifiche in tempo reale. La capacità della tua applicazione potrebbe non aumentare abbastanza rapidamente e causare ritardi per alcuni utenti.
Per eventi sconosciuti o imprevisti, come un improvviso aumento della domanda o del traffico, puoi utilizzare le funzionalità di scalabilità automatica per attivare la scalabilità elastica basata sulle metriche. Queste metriche possono includere l'utilizzo della CPU, la capacità di gestione del bilanciatore del carico, la latenza e persino metriche personalizzate definite in Cloud Monitoring.
Ad esempio, considera un'applicazione eseguita su un gruppo di istanze gestite di Compute Engine. Questa applicazione richiede che ogni istanza funzioni in modo ottimale fino a quando l'utilizzo medio della CPU non raggiunge il 75%. In questo esempio, potresti definire una policy di scalabilità automatica che crea più istanze quando l'utilizzo della CPU raggiunge la soglia. Queste istanze appena create aiutano ad assorbire il carico, il che contribuisce a garantire che l'utilizzo medio della CPU rimanga a un livello ottimale fino al raggiungimento del numero massimo di istanze configurate per il MIG. Quando la domanda diminuisce, la policy di scalabilità automatica rimuove le istanze non più necessarie.
Pianifica le prenotazioni degli slot delle risorse in BigQuery o modifica i limiti per le configurazioni di scalabilità automatica in Spanner utilizzando il gestore della scalabilità automatica.
Utilizza la scalabilità predittiva
Se i componenti del tuo sistema includono Compute Engine, devi valutare se la scalabilità automatica predittiva è adatta al tuo workload. La scalabilità automatica predittiva prevede il carico futuro in base alle tendenze storiche delle metriche, ad esempio l'utilizzo della CPU. Le previsioni vengono ricalcolate ogni pochi minuti, il che consente al gestore della scalabilità automatica di adattare rapidamente le sue previsioni alle variazioni più recenti del carico. Senza la scalabilità automatica predittiva, un gestore della scalabilità automatica può scalare un gruppo solo in modo reattivo, in base alle variazioni del carico osservate in tempo reale. La scalabilità automatica predittiva utilizza i dati in tempo reale e i dati storici per rispondere sia al carico attuale sia a quello previsto.
Implementa architetture serverless
Valuta la possibilità di implementare un'architettura serverless con servizi serverless intrinsecamente elastici, come i seguenti:
A differenza della scalabilità automatica in altri servizi che richiedono un'ottimizzazione delle regole (ad esempio Compute Engine), la scalabilità automatica serverless è istantanea e può fare lo scale down fino a zero risorse.
Utilizza la modalità Autopilot per Kubernetes
Per applicazioni complesse che richiedono un maggiore controllo su Kubernetes, prendi in considerazione la modalità Autopilot in Google Kubernetes Engine (GKE). La modalità Autopilot fornisce automazione e scalabilità per impostazione predefinita. GKE scala automaticamente i nodi e le risorse in base al traffico. GKE gestisce i nodi, ne crea di nuovi per le tue applicazioni e configura gli upgrade e le riparazioni automatici.
Promuovere la progettazione modulare
Questo principio del pilastro dell'ottimizzazione delle prestazioni del Google Cloud Well-Architected Framework fornisce consigli per aiutarti a promuovere un design modulare. Componenti modulari e interfacce chiare possono consentire una scalabilità flessibile, aggiornamenti indipendenti e la separazione dei componenti in futuro.
Panoramica del principio
Comprendere le dipendenze tra i componenti dell'applicazione e i componenti del sistema per progettare un sistema scalabile.
Il design modulare consente flessibilità e resilienza, indipendentemente dal fatto che sia stato eseguito il deployment iniziale di un'architettura monolitica o di microservizi. Scomponendo il sistema in moduli indipendenti e ben definiti con interfacce chiare, puoi scalare i singoli componenti per soddisfare esigenze specifiche.
La scalabilità mirata può aiutare a ottimizzare l'utilizzo delle risorse e a ridurre i costi nei seguenti modi:
- Esegue il provisioning solo delle risorse necessarie per ciascun componente e alloca meno risorse ai componenti meno impegnativi.
- Aggiunge più risorse durante i periodi di traffico elevato per mantenere l'esperienza utente.
- Rimuove le risorse sottoutilizzate senza compromettere le prestazioni.
La modularità migliora anche la manutenibilità. Le unità più piccole e autonome sono più facili da comprendere, eseguire il debug e aggiornare, il che può portare a cicli di sviluppo più rapidi e a un rischio ridotto.
Sebbene la modularità offra vantaggi significativi, devi valutare i potenziali compromessi in termini di prestazioni. La maggiore comunicazione tra i moduli può introdurre latenza e overhead. Cerca di trovare un equilibrio tra modularità e prestazioni. Un design altamente modulare potrebbe non essere adatto a tutti. Quando le prestazioni sono fondamentali, un approccio con un accoppiamento più stretto potrebbe essere appropriato. La progettazione del sistema è un processo iterativo in cui rivedi e perfezioni continuamente il tuo design modulare.
Consigli
Per promuovere i design modulari, tieni conto dei suggerimenti riportati nelle sezioni seguenti.
Progettazione per il basso accoppiamento
Progetta un'architettura a basso accoppiamento. I componenti indipendenti con dipendenze minime possono aiutarti a creare applicazioni scalabili e resilienti. Quando pianifichi i confini dei tuoi servizi, devi considerare i requisiti di disponibilità e scalabilità. Ad esempio, se un componente ha requisiti diversi da quelli degli altri componenti, puoi progettarlo come servizio autonomo. Implementa un piano per i failure controllati per i sottoprocessi o i servizi meno importanti che non influiscono sul tempo di risposta dei servizi principali.
Progetta per la concorrenza e il parallelismo
Progetta la tua applicazione in modo che supporti più attività contemporaneamente, ad esempio l'elaborazione di più richieste degli utenti o l'esecuzione di job in background mentre gli utenti interagiscono con il tuo sistema. Suddividi le attività di grandi dimensioni in blocchi più piccoli che possono essere elaborati contemporaneamente da più istanze di servizio. La concorrenza delle attività ti consente di utilizzare funzionalità come la scalabilità automatica per aumentare l'allocazione delle risorse in prodotti come i seguenti:
Modularità del bilanciamento per un'allocazione flessibile delle risorse
Se possibile, assicurati che ogni componente utilizzi solo le risorse necessarie (come memoria, spazio di archiviazione e potenza di elaborazione) per operazioni specifiche. L'allocazione eccessiva delle risorse può comportare costi non necessari, mentre l'allocazione insufficiente delle risorse può compromettere le prestazioni.
Utilizza interfacce ben definite
Assicurati che i componenti modulari comunichino in modo efficace tramite interfacce chiare e standardizzate (come API e code di messaggi) per ridurre l'overhead dei livelli di traduzione o del traffico estraneo.
Utilizza modelli stateless
Un modello stateless può aiutarti a garantire che ogni richiesta o interazione con il servizio possa essere gestita indipendentemente dalle richieste precedenti. Questo modello facilita la scalabilità e la recuperabilità, perché puoi aumentare, ridurre o riavviare il servizio senza perdere i dati necessari per le richieste o i processi in corso.
Scegli tecnologie complementari
Scegli tecnologie che si integrino con il design modulare. Valuta i linguaggi di programmazione, i framework e i database per il loro supporto della modularità.
Per maggiori informazioni, consulta le seguenti risorse:
Monitora e migliora costantemente le prestazioni
Questo principio del pilastro dell'ottimizzazione delle prestazioni del Google Cloud Well-Architected Framework fornisce consigli per aiutarti a monitorare e migliorare continuamente le prestazioni.
Dopo aver eseguito il deployment delle applicazioni, monitorane continuamente le prestazioni utilizzando log, tracciamento, metriche e avvisi. Man mano che le tue applicazioni crescono ed evolvono, puoi utilizzare le tendenze di questi punti dati per rivalutare i requisiti di prestazioni. Alla fine, potresti dover riprogettare parti delle tue applicazioni per mantenere o migliorare le loro prestazioni.
Panoramica del principio
Il processo di miglioramento continuo delle prestazioni richiede strumenti e strategie di monitoraggio efficaci. Gli strumenti di osservabilità di Cloud possono aiutarti a raccogliere indicatori chiave di prestazione (KPI) come latenza, throughput, tassi di errore e utilizzo delle risorse. Gli ambienti cloud offrono una varietà di metodi per condurre valutazioni granulari delle prestazioni nell'applicazione, nella rete e nell'esperienza dell'utente finale.
Il miglioramento delle prestazioni è un impegno continuo che richiede un approccio multidimensionale. I seguenti meccanismi e processi chiave possono aiutarti a migliorare il rendimento:
- Per fornire una direzione chiara e monitorare i progressi, definisci obiettivi di rendimento in linea con i tuoi obiettivi commerciali. Imposta obiettivi intelligenti: specifici, misurabili, attuabili, rilevanti e in un tempo definito.
- Per misurare le prestazioni e identificare le aree di miglioramento, raccogli le metriche dei KPI.
- Per monitorare continuamente i tuoi sistemi alla ricerca di problemi, utilizza i flussi di lavoro visualizzati negli strumenti di monitoraggio. Utilizza tecniche di mappatura dei processi dell'architettura per identificare ridondanze e inefficienze.
- Per creare una cultura di miglioramento continuo, offri formazione e programmi che supportino la crescita dei tuoi dipendenti.
- Per incoraggiare un miglioramento proattivo e continuo, incentiva i tuoi dipendenti e clienti a fornire feedback costanti sulle prestazioni della tua applicazione.
Consigli
Per monitorare e migliorare continuamente le prestazioni, prendi in considerazione i consigli riportati nelle sezioni seguenti.
Definisci obiettivi di rendimento e metriche chiari
Definisci obiettivi di rendimento chiari e in linea con i tuoi obiettivi commerciali. Ciò richiede una conoscenza approfondita dell'architettura della tua applicazione e dei requisiti di rendimento di ogni componente dell'applicazione.
In via prioritaria, ottimizza i componenti più critici che influenzano direttamente le funzioni aziendali principali e l'esperienza utente. Per garantire che questi componenti continuino a funzionare in modo efficiente e a soddisfare le tue esigenze aziendali, imposta target di rendimento specifici e misurabili. Questi target possono includere tempi di risposta, tassi di errore e soglie di utilizzo delle risorse.
Questo approccio proattivo può aiutarti a identificare e risolvere potenziali colli di bottiglia, ottimizzare l'allocazione delle risorse e, in ultima analisi, offrire un'esperienza fluida e ad alte prestazioni ai tuoi utenti.
Monitoraggio del rendimento
Monitora costantemente i tuoi sistemi cloud per rilevare problemi di prestazioni e configura avvisi per eventuali problemi potenziali. Il monitoraggio e gli avvisi possono aiutarti a rilevare e risolvere i problemi prima che influiscano sugli utenti. La profilazione delle applicazioni può aiutare a identificare i colli di bottiglia e a ottimizzare l'utilizzo delle risorse.
Puoi utilizzare strumenti che facilitano la risoluzione dei problemi e l'ottimizzazione della rete in modo efficace. Utilizza Google Cloud Observability per identificare le aree con un consumo elevato di CPU, memoria o rete. Queste funzionalità possono aiutare gli sviluppatori a migliorare l'efficienza, ridurre i costi e migliorare l'esperienza utente. Network Intelligence Center mostra visualizzazioni della topologia della tua infrastruttura di rete e può aiutarti a identificare i percorsi con latenza elevata.
Incentivare il miglioramento continuo
Crea una cultura di miglioramento continuo che possa giovare sia all'applicazione sia all'esperienza utente.
Offri ai tuoi dipendenti opportunità di formazione e sviluppo che migliorino le loro competenze e conoscenze nelle tecniche di prestazioni nei servizi cloud. Crea una community of practice (CoP) e offri programmi di mentoring e coaching per supportare la crescita dei dipendenti.
Per evitare una gestione del rendimento reattiva e incoraggiare una gestione del rendimento proattiva, incoraggia un feedback continuo da parte di dipendenti, clienti e stakeholder. Puoi valutare la possibilità di gamificare il processo monitorando i KPI sul rendimento e presentando queste metriche ai team con frequenza sotto forma di classifica.
Per comprendere il rendimento e la soddisfazione degli utenti nel tempo, ti consigliamo di misurare il feedback degli utenti in modo quantitativo e qualitativo. Il framework HEART può aiutarti ad acquisire il feedback degli utenti in cinque categorie:
- Soddisfazione
- Coinvolgimento
- Adozione
- Conservazione
- Successo dell'attività
Utilizzando un framework di questo tipo, puoi incentivare gli ingegneri con feedback basati sui dati, metriche incentrate sugli utenti, insight operativi e una chiara comprensione degli obiettivi.