


Ti consigliamo di progettare il mesh di dati in modo da supportare un'ampia gamma di casi d'uso per il consumo dei dati. In questo documento vengono descritti i casi d'uso più comuni di consumo dei dati in un'organizzazione. Il documento illustra anche quali informazioni i consumatori di dati devono considerare per determinare il prodotto di dati giusto per il loro caso d'uso e come scoprono e utilizzano i prodotti di dati. La comprensione di questi fattori può aiutare le organizzazioni a garantire di disporre delle indicazioni e degli strumenti giusti per supportare i consumer di dati.
Questo documento fa parte di una serie che descrive come implementare un mesh di dati su Google Cloud. Si presume che tu abbia letto e abbia familiarità con i concetti descritti in Architettura e funzioni in un mesh di dati e Crea un mesh di dati moderno e distribuito con Google Cloud.
La serie è composta dalle seguenti parti:
- Architettura e funzioni in un mesh di dati
- Progetta una piattaforma dati self-service per un mesh di dati
- Crea prodotti di dati in un mesh di dati
- Scopri e utilizza i prodotti di dati in un mesh di dati (questo documento)
La progettazione di un livello di consumo dei dati, in particolare il modo in cui i consumer basati su domini di dati utilizzano i prodotti di dati, dipende dai requisiti dei consumer di dati. Come prerequisito, si presuppone che i consumatori abbiano in mente un caso d'uso. Si presume che abbiano identificato i dati di cui hanno bisogno e che possano cercarli nel catalogo centrale dei prodotti dati. Se i dati non sono presenti nel catalogo o non sono nello stato preferito (ad esempio, se l'interfaccia non è appropriata o gli SLA sono insufficienti), il consumer deve contattare il producer di dati.
In alternativa, il consumer può contattare il centro di eccellenza (COE) per il mesh di dati per ricevere consigli su quale dominio è più adatto per produrre quel prodotto di dati. I consumer di dati possono anche chiedere come effettuare la richiesta. Se la tua organizzazione è di grandi dimensioni, dovrebbe essere previsto un processo per effettuare richieste di prodotti di dati in modalità self-service.
I consumer di dati utilizzano i prodotti di dati tramite le applicazioni che eseguono. Il tipo di insight richiesto determina la scelta del design dell'applicazione che utilizza i dati. Quando sviluppa il design dell'applicazione, il consumer di dati identifica anche l'utilizzo preferito dei prodotti di dati nell'applicazione. Stabiliscono la fiducia di cui hanno bisogno nell'affidabilità di questi dati. I consumer di dati possono quindi stabilire una visualizzazione sulle interfacce dei prodotti di dati e sugli SLA richiesti dall'applicazione.
Casi d'uso del consumo di dati
Per consentire ai consumer di dati di creare applicazioni di dati, le origini potrebbero essere uno o più prodotti di dati e, forse, i dati del dominio del consumer di dati. Come descritto in Crea prodotti di dati in un mesh di dati, i prodotti di dati analitici potrebbero essere realizzati a partire da prodotti di dati basati su vari repository di dati fisici.
Sebbene il consumo di dati possa avvenire all'interno dello stesso dominio, i pattern di consumo più comuni sono quelli che cercano il prodotto di dati giusto, indipendentemente dal dominio, come origine per l'applicazione. Quando il prodotto dati corretto esiste in un altro dominio, il pattern di consumo richiede di configurare il meccanismo successivo per l'accesso e l'utilizzo dei dati tra i domini. Il consumo di prodotti di dati creati in domini diversi dal dominio di consumo è discusso in Passaggi per il consumo dei dati.
Architettura
Il seguente diagramma mostra uno scenario di esempio in cui i consumer utilizzano i prodotti di dati tramite una serie di interfacce, tra cui set di dati autorizzati e API.
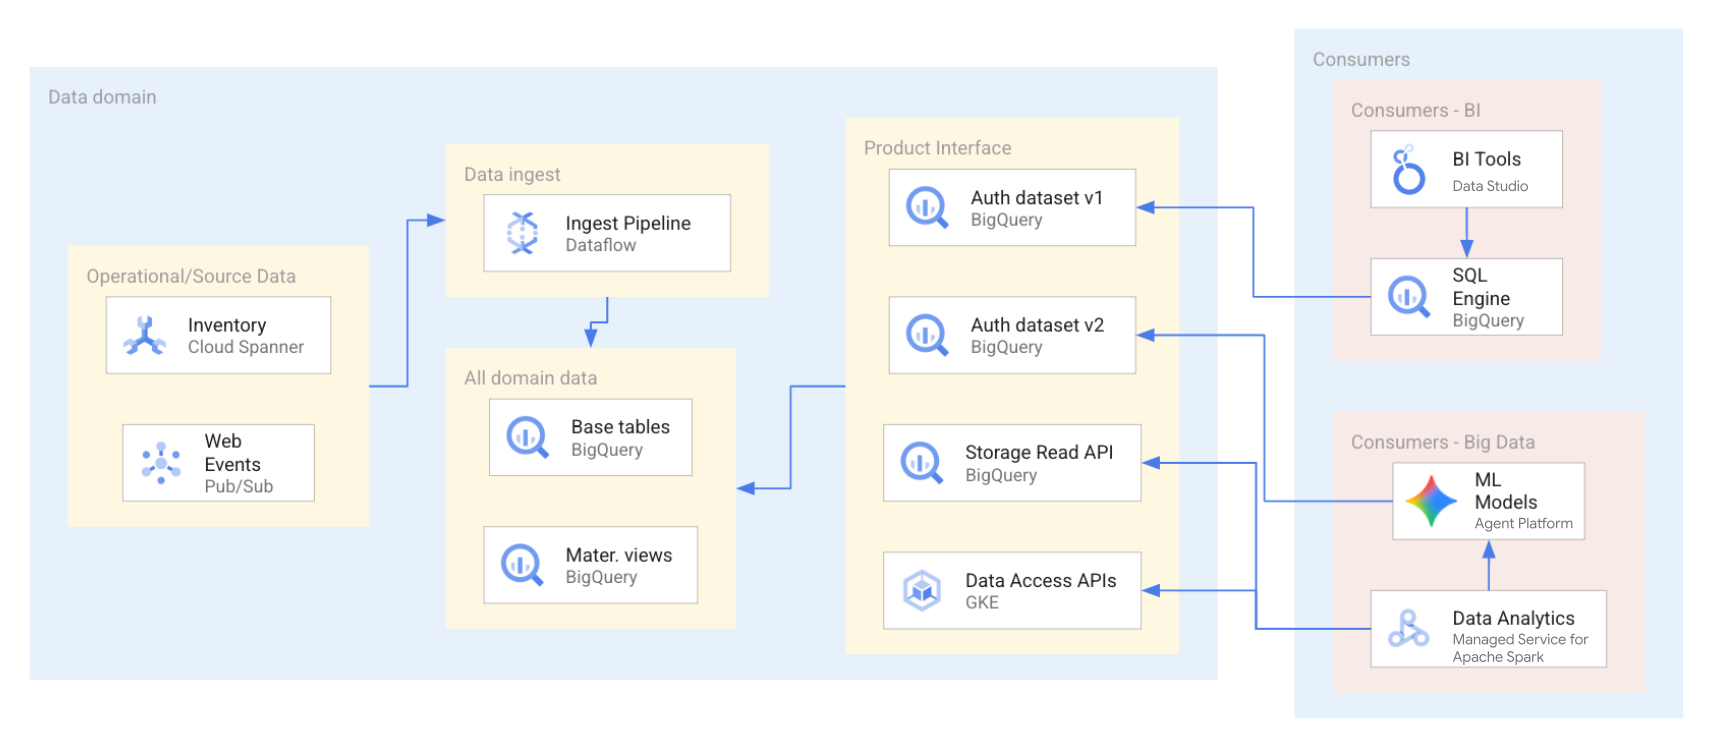
Come mostrato nel diagramma precedente, il producer di dati ha esposto quattro interfacce di prodotti di dati: due set di dati autorizzati di BigQuery, un set di dati di BigQuery esposto dall'API BigQuery Storage Read e API di accesso ai dati ospitate su Google Kubernetes Engine. Nell'utilizzo dei prodotti di dati, i consumer di dati utilizzano una serie di applicazioni che eseguono query o accedono direttamente alle risorse di dati all'interno dei prodotti di dati. In questo scenario, i consumer di dati accedono alle risorse di dati in uno dei due modi diversi in base ai loro requisiti specifici di accesso ai dati. Nel primo modo, Looker utilizza SQL di BigQuery per eseguire query su un set di dati autorizzato. Nel secondo modo, Managed Service for Apache Spark accede direttamente a un set di dati tramite l'API BigQuery, quindi elabora i dati importati per addestrare un modello di machine learning (ML).
L'utilizzo di un'applicazione di consumo dei dati potrebbe non generare sempre un report o una dashboard di business intelligence (BI). Il consumo di dati di un dominio può anche generare modelli di ML che arricchiscono ulteriormente i prodotti analitici, vengono utilizzati nell'analisi dei dati o fanno parte di processi operativi, ad esempio il rilevamento delle frodi.
Di seguito sono riportati alcuni casi d'uso tipici del consumo di prodotti di dati:
- Reporting di BI e analisi dei dati: in questo caso, le applicazioni di dati vengono create per utilizzare i dati di più prodotti di dati. Ad esempio, i consumer di dati del team di gestione dei rapporti con i clienti (CRM) devono accedere ai dati di più domini, come vendite, clienti e finanza. L'applicazione CRM sviluppata da questi consumer di dati potrebbe dover eseguire query su una vista autorizzata di BigQuery in un dominio ed estrarre dati da un'API di lettura di Cloud Storage in un altro dominio. Per i consumatori di dati, i fattori di ottimizzazione che influenzano la loro interfaccia di consumo preferita sono i costi di computing e qualsiasi trattamento dati aggiuntivo richiesto dopo l'esecuzione di query sul prodotto di dati. Nei casi d'uso di BI e analisi dei dati, le visualizzazioni autorizzate di BigQuery sono probabilmente quelle di uso comune.
- Casi d'uso di data science e addestramento dei modelli: in questo caso, il team che utilizza i dati utilizza i prodotti di dati di altri domini per arricchire il proprio prodotto di dati analitici, ad esempio un modello ML. Utilizzando Managed Service for Apache Spark per Spark, Google Cloud fornisce funzionalità di pre-elaborazione dei dati e feature engineering per consentire l'arricchimento dei dati prima di eseguire le attività di ML. Le considerazioni principali sono la disponibilità di quantità sufficienti di dati di addestramento a un costo ragionevole e la certezza che i dati di addestramento siano quelli appropriati. Per contenere i costi, le interfacce di consumo preferite saranno probabilmente le API di lettura diretta. È possibile che un team di consumo dei dati crei un modello ML come prodotto di dati e, a sua volta, diventi anche un nuovo team di produzione dei dati.
- Processi dell'operatore: il consumo fa parte del processo operativo all'interno del dominio di consumo dei dati. Ad esempio, un consumer di dati in un team che si occupa di frodi potrebbe utilizzare i dati delle transazioni provenienti da origini dati operative nel dominio del commerciante. Utilizzando un metodo di integrazione dei dati come Change Data Capture, questi dati sulle transazioni vengono intercettati quasi in tempo reale. Puoi quindi utilizzare Pub/Sub per definire uno schema per questi dati ed esporre queste informazioni come eventi. In questo caso, le interfacce appropriate sarebbero i dati esposti come argomenti Pub/Sub.
Passaggi per il consumo dei dati
I producer di dati documentano il loro prodotto di dati nel catalogo centrale, incluse le indicazioni su come utilizzare i dati. Per un'organizzazione con più domini, questo approccio alla documentazione crea un'architettura diversa dalla tradizionale pipeline ELT/ETL creata centralmente, in cui i processori creano output senza il confine dei domini aziendali. I consumer di dati in un mesh di dati devono disporre di un livello di rilevamento e consumo ben progettato per creare un ciclo di vita del consumo dei dati. Il livello deve includere quanto segue:
Passaggio 1: scopri i prodotti di dati tramite la ricerca dichiarativa e l'esplorazione delle specifiche dei prodotti di dati: i consumer di dati sono liberi di cercare qualsiasi prodotto di dati registrato dai producer di dati nel catalogo centrale. Per tutti i prodotti di dati, il tag del prodotto di dati specifica come effettuare richieste di accesso ai dati e la modalità di utilizzo dei dati dall'interfaccia del prodotto di dati richiesta. I campi nei tag dei prodotti di dati sono ricercabili utilizzando un'applicazione di ricerca. Le interfacce dei prodotti di dati implementano gli URI dei dati, il che significa che i dati non devono essere spostati in una zona di consumo separata per servire i consumatori. Nelle situazioni in cui non sono necessari dati in tempo reale, i consumer eseguono query sui prodotti di dati e creano report con i risultati generati.
Passaggio 2: esplorazione dei dati tramite accesso interattivo ai dati e prototipazione: i consumer di dati utilizzano strumenti interattivi come BigQuery Studio e i blocchi note Jupyter per interpretare e sperimentare con i dati al fine di perfezionare le query necessarie per l'utilizzo in produzione. Le query interattive consentono ai consumer di dati di esplorare nuove dimensioni dei dati e migliorare la correttezza degli insight generati negli scenari di produzione.
Passaggio 3: utilizzo del prodotto di dati tramite un'applicazione, con accesso e produzione programmatici:
- Report BI. I report e le dashboard in batch e quasi in tempo reale sono il gruppo più comune di casi d'uso di analisi richiesti dai consumer di dati. I report potrebbero richiedere l'accesso ai prodotti di dati incrociati per facilitare il processo decisionale. Ad esempio, una Customer Data Platform richiede l'esecuzione di query programmatiche sia sui prodotti di dati degli ordini sia su quelli del CRM in modo pianificato. I risultati di questo approccio forniscono una visione olistica dei clienti agli utenti aziendali che utilizzano i dati.
- Modello AI/ML per la previsione batch e in tempo reale. I data scientist utilizzano i principi MLOps comuni per creare e gestire modelli di ML che utilizzano i prodotti di dati resi disponibili dai team di prodotto di dati. I modelli ML forniscono funzionalità di inferenza in tempo reale per casi d'uso transazionali come il rilevamento delle frodi. Analogamente, con l'analisi esplorativa dei dati, i consumer di dati possono arricchire i dati di origine. Ad esempio, l'analisi esplorativa dei dati sulle campagne di vendita e di marketing mostra i segmenti di clienti demografici in cui si prevede che le vendite saranno più elevate e, di conseguenza, dove dovrebbero essere pubblicate le campagne.
Passaggi successivi
- Consulta un'implementazione di riferimento dell'architettura di mesh di dati.
- Scopri di più su BigQuery.
- Scopri di più su Gemini Enterprise Agent Platform.
- Scopri di più sulla data science su Managed Service for Apache Spark.
- Per ulteriori architetture di riferimento, diagrammi e best practice, esplora Cloud Architecture Center.