


במסמך הזה מתואר התאוששות מאסון (DR) ותכנון המשכיות עסקית בהקשר של אינטגרציה רציפה (CI) ופיתוח רציף (CD). בנוסף, הוא כולל הנחיות לזיהוי תלות ולצמצום שלהן כשמפתחים תוכנית מקיפה לשמירה על המשכיות עסקית (BCP). המסמך כולל שיטות מומלצות שאפשר ליישם ב-BCP, בלי קשר לכלים ולתהליכים שבהם אתם משתמשים. ההנחה במסמך הזה היא שאתם מכירים את היסודות של מחזור הפעולות והכנת תוכנה להפצה, CI/CD ו-DR.
צינורות CI/CD אחראים לפיתוח ולפריסה של אפליקציות קריטיות לעסק. לכן, כמו בתשתית האפליקציה, גם בתהליך CI/CD צריך לתכנן התאוששות מאסון והמשכיות עסקית. כשחושבים על DR ועל המשכיות עסקית עבור CI/CD, חשוב להבין כל שלב במחזור החיים של מסירת התוכנה והתפעול שלה, ואיך הם פועלים יחד כתהליך הוליסטי.
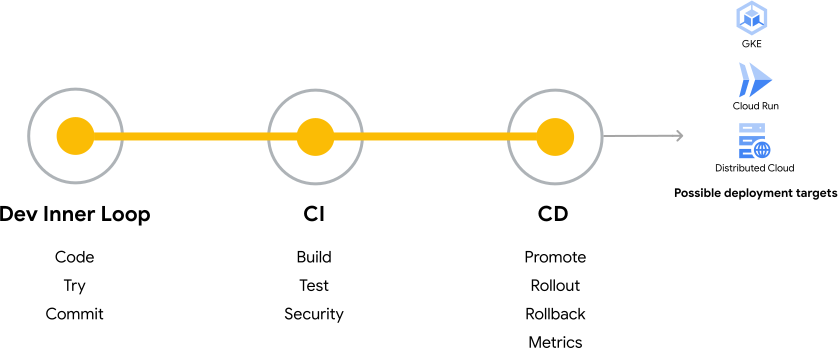
התרשים הבא הוא תצוגה פשוטה של מחזור הפיתוח והתפעול של תוכנה, שכולל את שלושת השלבים הבאים:
- לולאה פנימית של פיתוח: כתיבת קוד, ניסיון ושמירה
- אינטגרציה רציפה: בנייה, בדיקה ואבטחה
- פיתוח רציף (continuous delivery): קידום, השקה, חזרה למצב קודם ומדדים
בדיאגרמה הזו אפשר לראות גם ש-Google Kubernetes Engine (GKE), Cloud Run ו-Google Distributed Cloud הם יעדי פריסה אפשריים של מחזור פיתוח התוכנה והתפעול.
במהלך מחזור החיים של פיתוח ותפעול התוכנה, צריך לקחת בחשבון את ההשפעה של אסון על היכולת של הצוותים להפעיל ולתחזק אפליקציות קריטיות לעסק. כך תוכלו לקבוע את יעד משך ההתאוששות (RTO) ואת יעד נקודת ההתאוששות (RPO) של הכלים בשרשרת הכלים של CI/CD.
בנוסף, לרוב הארגונים יש צינורות עיבוד נתונים רבים ושונים של CI/CD לאפליקציות שונות ולמערכות תשתית שונות, ולכל צינור עיבוד נתונים יש דרישות ייחודיות לתכנון התאוששות מאסון והמשכיות עסקית. אסטרטגיית השחזור שתבחרו לצינור תלויה ב-RTO וב-RPO של הכלים שלכם. לדוגמה, חלק מהצינורות קריטיים יותר מאחרים, ולכן דרישות ה-RTO וה-RPO שלהם יהיו נמוכות יותר. חשוב לזהות את צינורות הנתונים הקריטיים לעסק בתוכנית להמשכיות עסקית, וגם להקדיש להם יותר תשומת לב כשמיישמים שיטות מומלצות לבדיקה ולהפעלה של תהליכי שחזור.
כל תהליך CI/CD ושרשרת הכלים שלו שונים, ולכן המטרה של המדריך הזה היא לעזור לכם לזהות נקודות כשל יחידות בתהליך ה-CI/CD ולפתח תוכנית מקיפה להמשכיות עסקית. בקטעים הבאים מוסבר איך:
- להבין מה צריך לעשות כדי להתאושש מאירוע DR שמשפיע על תהליך ה-CI/CD.
- קובעים את ה-RTO ואת ה-RPO של הכלים בתהליך ה-CI/CD.
- להבין את מצבי הכשל ואת יחסי התלות בתהליך ה-CI/CD.
- בוחרים אסטרטגיית שחזור מתאימה לכלים בשרשרת הכלים.
- הסבר על שיטות מומלצות כלליות להטמעה של תוכנית שחזור DR לתהליך CI/CD.
הסבר על תהליך המשכיות העסקית
יצירת תוכנית להמשכיות עסקית היא חיונית כדי להבטיח שהארגון יוכל להמשיך את הפעילות שלו במקרה של שיבושים ומצבי חירום. הוא עוזר לארגון לחזור במהירות למצב של פעילות רגילה בתהליך CI/CD.
בקטעים הבאים מפורטים השלבים שצריך לבצע כדי ליצור תוכנית יעילה להמשכיות עסקית. למרות שרבים מהשלבים האלה רלוונטיים באופן כללי לניהול תוכניות ול-DR, יש שלבים שרלוונטיים יותר לתכנון המשכיות עסקית לתהליך CI/CD. השלבים שרלוונטיים במיוחד לתכנון המשכיות עסקית עבור CI/CD מודגשים בקטעים הבאים, והם גם מהווים את הבסיס להנחיות בשאר המסמך הזה.
התחלה ותכנון
בשלב הראשוני הזה, הצוותים הטכניים והעסקיים עובדים יחד כדי ליצור את הבסיס לתהליך התכנון של שמירה על המשכיות עסקית ולתחזוקה השוטפת שלו. השלבים העיקריים בשלב הזה כוללים את הפעולות הבאות:
- קבלת הסכמה מההנהלה: חשוב לוודא שההנהלה הבכירה תומכת בפיתוח של תוכנית ההמשכיות העסקית ומקדמת אותו. הקצאת צוות ייעודי או אדם פרטי שאחראים על פיקוח על התוכנית.
- הקצאת משאבים: הקצאת התקציב, כוח האדם והמשאבים הדרושים לפיתוח ולהטמעה של תוכנית המשכיות העסקית.
- היקף ומטרות: מגדירים את ההיקף של תוכנית ה-BCP ואת המטרות שלה. קובעים אילו תהליכים עסקיים הם קריטיים וצריך לטפל בהם במסגרת התוכנית.
- הערכת סיכונים: זיהוי סיכונים ואיומים פוטנציאליים שעלולים לשבש את הפעילות העסקית, כמו אסונות טבע, פרצות אבטחה בסייבר או שיבושים בשרשרת האספקה.
- ניתוח ההשפעה: הערכה של ההשלכות הפוטנציאליות של הממצאים האלה לגבי הערכת הסיכונים על הפעילות העסקית, המצב הפיננסי, המוניטין ושביעות רצון הלקוחות.
ניתוח השפעות על העסק
בשלב הזה, הצוותים העסקיים והטכניים מנתחים את ההשפעה העסקית של שיבושים על הלקוחות והארגון, ונותנים עדיפות לשחזור של פונקציות עסקיות קריטיות. פונקציות עסקיות כאלה מבוצעות על ידי כלים שונים במהלך השלבים השונים של תהליך הבנייה והפריסה.
ניתוח ההשפעה על העסק הוא שלב חשוב בתהליך התכנון של המשכיות עסקית עבור CI/CD, במיוחד השלבים לזיהוי פונקציות עסקיות קריטיות ותלות בכלי. בנוסף, הבנת שרשרת הכלים של CI/CD – כולל התלות שלה ואיך היא פועלת במסגרת מחזור החיים של DevOps – היא אבן בניין בסיסית לפיתוח תוכנית להמשכיות עסקית לתהליך CI/CD.
השלבים העיקריים בשלב ניתוח ההשפעה העסקית כוללים את הפעולות הבאות:
- פונקציות קריטיות: קובעים את הפונקציות והתהליכים העסקיים העיקריים שצריך לתת להם עדיפות בתהליך השחזור. לדוגמה, אם קובעים שהפריסה של אפליקציות חשובה יותר מהרצת בדיקות יחידה, צריך לתת עדיפות לשחזור של תהליכים וכלים לפריסת אפליקציות.
- יחסי תלות: זיהוי יחסי תלות פנימיים וחיצוניים שיכולים להשפיע על השחזור של הפונקציות הקריטיות. תלות רלוונטית במיוחד כדי להבטיח את המשך הפעולה של תהליך ה-CI/CD באמצעות שרשרת הכלים שלו.
- RTO ו-RPO: הגדרת מגבלות קבילות לזמן השבתה ומגבלות לאובדן נתונים לכל פונקציה קריטית. יעדי ה-RTO וה-RPO האלה קשורים לחשיבות של פונקציה עסקית להמשך הפעילות, והם כוללים כלים ספציפיים שנדרשים כדי שהפונקציה העסקית תפעל בצורה חלקה.
פיתוח אסטרטגיה
בשלב הזה, הצוות הטכני מפתח אסטרטגיות לשחזור פונקציות עסקיות קריטיות, כמו שחזור פעולות ונתונים, ותקשורת עם ספקים ובעלי עניין. פיתוח אסטרטגיה הוא גם חלק חשוב בתכנון המשכיות עסקית לתהליך CI/CD, במיוחד בשלב של בחירת אסטרטגיות שחזור ברמה גבוהה לפונקציות קריטיות.
השלבים העיקריים בשלב פיתוח האסטרטגיה כוללים את הפעולות הבאות:
- אסטרטגיות התאוששות: פיתוח אסטרטגיות לשחזור פונקציות קריטיות. האסטרטגיות האלה עשויות לכלול מיקומים חלופיים, עבודה מרחוק או מערכות גיבוי. האסטרטגיות האלה קשורות ליעדי ה-RTO וה-RPO של כל פונקציה קריטית.
- יחסים עם ספקים: חשוב ליצור תוכניות תקשורת ותיאום עם ספקים מרכזיים כדי לשמור על שרשרת האספקה בזמן שיבושים.
- שחזור נתונים ו-IT: יצירת תוכניות לגיבוי נתונים, לשחזור מערכות IT ולאמצעי אבטחת סייבר.
- תוכנית תקשורת: צריך לפתח תוכנית תקשורת ברורה לבעלי עניין פנימיים וחיצוניים במהלך השיבוש ואחריו.
פיתוח תוכנית
בשלב הזה, הפעולה העיקרית היא תיעוד של תוכנית ההמשכיות העסקית. הצוות הטכני מתעד את הכלים, התהליכים, אסטרטגיות השחזור, ההסברים והנהלים לכל פונקציה קריטית. פיתוח התוכנית כולל גם כתיבת הוראות מפורטות לעובדים לפעולה בזמן שיבוש. במהלך ההטמעה והתחזוקה השוטפת, יכול להיות שיהיה צורך לבצע שינויים בתוכנית, ולכן צריך להתייחס לתוכנית כאל מסמך דינמי.
הטמעה
בשלב הזה, מטמיעים את התוכנית בארגון באמצעות תוכנית ההמשכיות העסקית (BCP) שיצר הצוות הטכני. ההטמעה כוללת הדרכת עובדים ובדיקה ראשונית של תוכנית ההמשכיות העסקית. ההטמעה כוללת גם שימוש בתוכנית אם מתרחשת הפרעה, כדי לשחזר פעולות רגילות. שלבי ההטמעה העיקריים כוללים את הפעולות הבאות:
- בדיקות והדרכות ראשוניות: אחרי שמתעדים את ה-BPC, בודקים אותו באמצעות סימולציות ותרגילים כדי לזהות פערים ולשפר את היעילות. הדרכת העובדים לגבי התפקידים ותחומי האחריות שלהם במהלך שיבוש.
- הפעלה: כשמתרחשת הפרעה, מתחילים את תוכנית המשכיות העסקית בהתאם לטריגרים ולנהלים שהוגדרו מראש.
- תקשורת: חשוב לעדכן את בעלי העניין לגבי המצב והמאמצים לשיפור המצב.
תחזוקה ובדיקה
השלב הזה הוא לא תהליך מוגדר שמתרחש רק פעם אחת – הוא מייצג מאמץ מתמשך שצריך להפוך לחלק רגיל מהפעולות שלכם ב-CI/CD. חשוב לבדוק, לבחון ולעדכן באופן קבוע את תוכנית המשכיות העסקית בארגון, כדי שהיא תישאר רלוונטית וניתנת ליישום אם יתרחשו שיבושים. השלבים העיקריים בתחזוקה ובבדיקה כוללים את הפעולות הבאות:
- עדכונים שוטפים: חשוב לבדוק ולעדכן את תוכנית המשכיות העסקית באופן תקופתי כדי שהיא תישאר עדכנית ויעילה. צריך לעדכן אותו בכל פעם שיש שינויים בכוח האדם, בטכנולוגיה או בתהליכים העסקיים.
- לקחים: אחרי כל שיבוש או בדיקה, מומלץ לערוך תחקיר כדי לזהות לקחים ותחומים לשיפור.
- עמידה בדרישות הרגולטוריות: התאמת התוכנית להמשכיות עסקית לתקנות ולסטנדרטים בתחום.
- הגברת המוּדעוּת של העובדים: חשוב להקפיד להסביר לעובדים על התוכנית העסקית להמשכיות ועל התפקידים שלהם בביצוע שלה.
יצירת תהליך של המשכיות עסקית ל-CI/CD
בקטע הזה מפורטות הנחיות ספציפיות ליצירת תוכנית להמשכיות עסקית שמתמקדת באופן ספציפי בשחזור של פעולות CI/CD. תהליך התכנון של המשכיות עסקית ל-CI/CD מתחיל בהבנה מעמיקה של שרשרת הכלים של CI/CD, ואיך היא משתלבת במחזור החיים של הכנת תוכנה להפצה ותפעול. אחרי שתבינו את זה, תוכלו לתכנן איך הארגון שלכם יחזור לפעילות של CI/CD אחרי שיבוש.
כדי לבנות תהליך חזק של המשכיות עסקית לתהליך CI/CD, צריך לבצע את השלבים העיקריים הבאים:
- הסבר על שרשרת הכלים
- זיהוי נתונים ותלות
- קביעת יעדי RTO ו-RPO
- בחירה של אסטרטגיה ברמה גבוהה להמשכיות עסקית
- תיעוד של תוכנית המשכיות העסקית והטמעה של שיטות מומלצות
- בדיקת תרחישי כשל ותחזוקת התוכנית
בקטעים הבאים מוסבר בהרחבה על כל אחד מהשלבים האלה.
הסבר על שרשרת הכלים
שרשראות של כלים ל-CI/CD מורכבות מכלים שונים רבים, והשילובים האפשריים של כלים יכולים להיראות אינסופיים. עם זאת, כדי לתכנן את המשכיות העסקית של CI/CD, חשוב להבין את שרשרת הכלים של CI/CD ואת התלות שלה. המטרה העיקרית של תהליך ה-CI/CD היא להעביר קוד למערכות ייצור לשימוש משתמשי הקצה. במהלך התהליך הזה נעשה שימוש במערכות ובמקורות נתונים רבים ושונים. כדי לפתח תוכנית להמשכיות עסקית, חשוב לדעת מהם מקורות הנתונים והתלות שלהם. כדי להתחיל ליצור את אסטרטגיית ה-DR, קודם צריך להבין את הכלים השונים שמשתתפים בתהליך ה-CI/CD.
כדי לעזור לכם להבין איך להעריך את שרשרת הכלים שלכם ולפתח תוכנית להמשכיות עסקית, במאמר הזה אנחנו משתמשים בדוגמה של אפליקציית Java ארגונית שפועלת ב-GKE. התרשים הבא מציג את השכבה הראשונה של הנתונים והמערכות בשרשרת הכלים. השכבה הראשונה הזו תהיה בשליטה ישירה שלכם ותכלול את הפריטים הבאים:
- המקור של האפליקציות
- כלים בפלטפורמת ה-CI/CD, כמו Cloud Build או Cloud Deploy
- חיבורים בסיסיים בין הכלים השונים
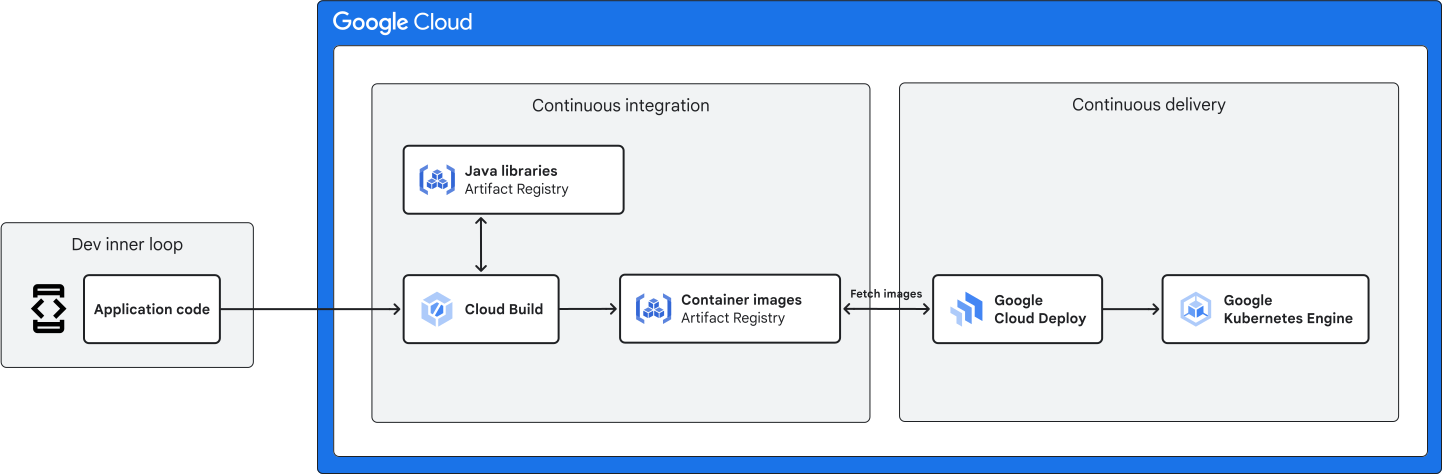
כפי שמוצג בתרשים, התהליך העיקרי של האפליקציה לדוגמה הוא:
- אירועים של פיתוח קוד בלולאה הפנימית של הפיתוח מפעילים את Cloud Build.
- Cloud Build מושך את קוד המקור של האפליקציה ממאגר בקרת המקור.
- Cloud Build מזהה את כל יחסי התלות הנדרשים שמצוינים בקובצי תצורת ה-build, כמו קובצי JAR של צד שלישי ממאגר Java ב-Artifact Registry. לאחר מכן, Cloud Build מושך את התלות האלה ממיקומי המקור שלהן.
- Cloud Build מריץ את ה-build ומבצע את האימות הנדרש, כמו ניתוח סטטי ובדיקת יחידות.
- אם גרסת ה-build נוצרת בהצלחה, Cloud Build יוצר את קובץ האימג' של הקונטיינר ומעביר אותו בדחיפה למאגר הקונטיינרים ב-Artifact Registry.
- מופעל צינור עיבוד נתונים לפריסה ב-Cloud Deploy, והצינור שולף את קובץ האימג' של הקונטיינר מהמאגר ופורס אותו לסביבת GKE.
כדי להבין את הכלים שבהם נעשה שימוש בתהליך ה-CI/CD, מומלץ ליצור תרשים שמציג את תהליך ה-CI/CD ואת הכלים שבהם נעשה שימוש בתהליך, בדומה לדוגמה שמופיעה במסמך הזה. אחר כך תוכלו להשתמש בדיאגרמה כדי ליצור טבלה שכוללת מידע חשוב על ה-toolchain של CI/CD, כמו השלב בתהליך, מטרת הכלי, הכלי עצמו והצוותים שמושפעים מכשל בכלי. בטבלה הזו מופיע מיפוי של הכלים בשרשרת הכלים, ומוצגים הכלים שמשמשים בשלבים ספציפיים בתהליך CI/CD. לכן, הטבלה יכולה לעזור לכם לקבל תצוגה כוללת של שרשרת הכלים ושל אופן הפעולה שלה.
בטבלאות הבאות מופיעה מיפוי של הדוגמה שהוזכרה קודם של אפליקציה ארגונית לכל כלי בתרשים. כדי לספק דוגמה מלאה יותר למיפוי של שרשרת כלים, הטבלאות האלה כוללות גם כלים אחרים שלא מוזכרים בתרשים, כמו כלי אבטחה או כלי בדיקה.
הטבלה הראשונה מתייחסת לכלים שמשמשים בשלב ה-CI בתהליך CI/CD:
| אינטגרציה רציפה (CI) | מקור | הכלים שבהם נעשה שימוש | משתמשים עיקריים | Usage |
|---|---|---|---|---|
| שלב: בקרת מקור |
|
|
|
|
| שלב: בנייה |
|
מפתחים |
|
|
| שלב: בדיקה |
|
מפתחים |
הפלטפורמה מאפשרת להריץ בדיקות יחידה ובדיקות אינטגרציה באופן עקבי לפי דרישה. |
|
| שלב: אבטחה |
|
|
סריקת הקוד לאיתור בעיות אבטחה. |
הטבלה השנייה מתמקדת בכלים שמשמשים בשלב ה-CD בתהליך CI/CD:
| פריסה רציפה | מקור | הכלים שבהם נעשה שימוש | משתמשים עיקריים | Usage |
|---|---|---|---|---|
| שלב: פריסה | קובצי הגדרת הפריסה |
|
אוטומציה של פריסות לקידום, אישור וניהול תנועה בפלטפורמה מאובטחת ועקבית. |
|
| שלב: בדיקה |
|
|
מפתחים |
בודקים את השילוב והביצועים כדי לוודא שהאיכות והשימושיות גבוהות. |
| שלב: רישום ביומן |
|
|
שומרים יומנים לצורך יכולת צפייה ופתרון בעיות. |
|
| שלב: מעקב | מעקב אחרי קובצי תצורה, כולל:
|
|
|
ככל שתמשיכו לעבוד על תוכנית ההמשכיות העסקית ותבינו טוב יותר את שרשרת הכלים של CI/CD, תוכלו לעדכן את הדיאגרמה ואת טבלת המיפוי.
זיהוי נתונים ויחסי תלות
אחרי שמשלימים את מלאי הבסיס ואת המיפוי של שרשרת הכלים של CI/CD, השלב הבא הוא לתעד את כל התלות במטא-נתונים או בהגדרות. כשמיישמים את תוכנית ההמשכיות העסקית, חשוב מאוד להבין את התלות בתוך שרשרת הכלים של CI/CD. בדרך כלל, התלויות נחלקות לשתי קטגוריות: תלויות פנימיות (מסדר ראשון) ותלויות חיצוניות (מסדר שני או שלישי).
יחסי תלות פנימיים
תלויות פנימיות הן מערכות ששרשרת הכלים שלכם משתמשת בהן, ואתם שולטים בהן ישירות. הצוותים שלכם בוחרים גם תלות פנימית. המערכות האלה כוללות את כלי ה-CI, את מאגר ניהול המפתחות ואת מערכת בקרת המקור. אפשר לחשוב על המערכות האלה כעל השכבה הבאה מתחת לשרשרת הכלים עצמה.
לדוגמה, בתרשים הבא אפשר לראות איך תלויות פנימיות משתלבות בשרשרת כלים. הדיאגרמה היא הרחבה של הדיאגרמה הקודמת של שרשרת הכלים בשכבה הראשונה של אפליקציית Java לדוגמה, והיא כוללת גם את התלות הפנימית של שרשרת הכלים: פרטי הכניסה לאפליקציה, הקובץ deploy.yaml והקובץ cloudbuild.yaml.
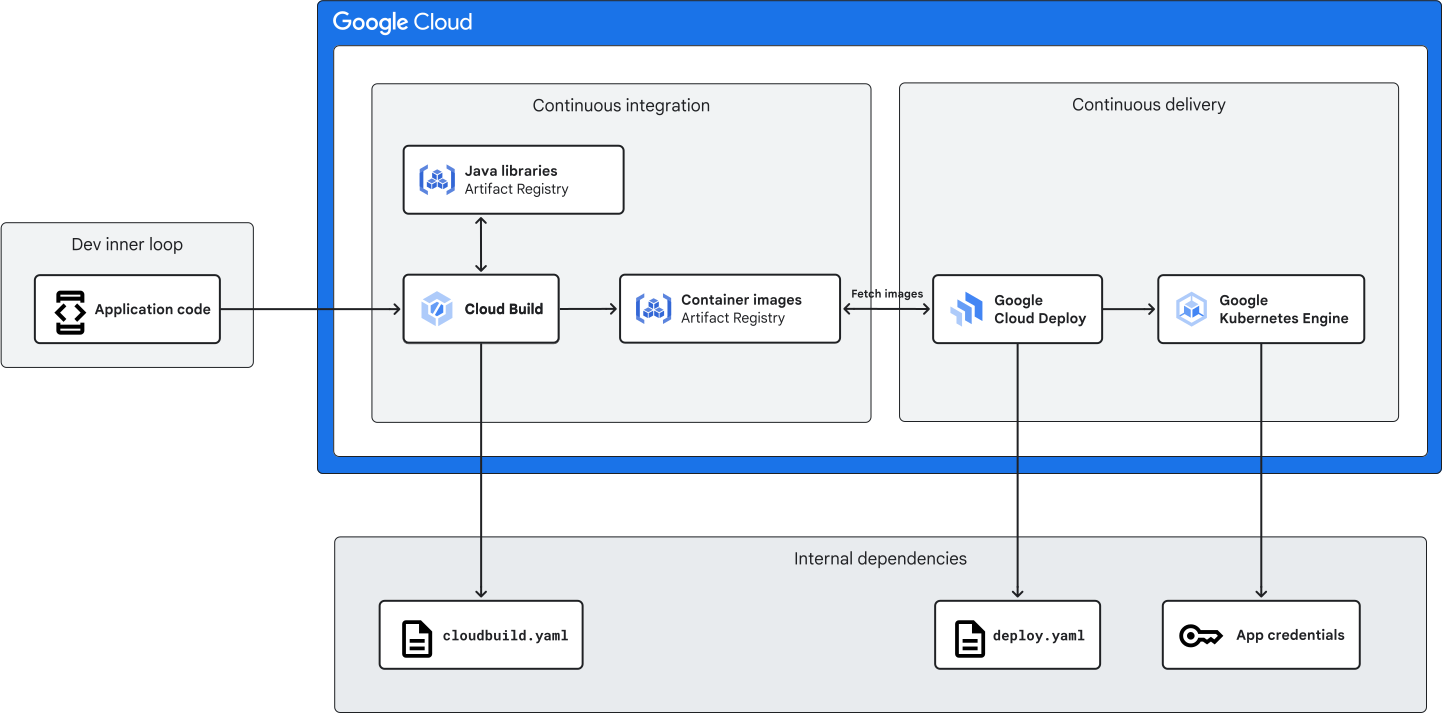
בתרשים אפשר לראות שכדי שהאפליקציה לדוגמה ב-Java תפעל בצורה תקינה, כלים כמו Cloud Build, Cloud Deploy ו-GKE צריכים גישה לתלות שאינה קשורה לשרשרת הכלים, כמו cloudbuild.yaml, deploy.yaml ופרטי הכניסה של האפליקציה. כשמנתחים את שרשרת הכלים של CI/CD, בודקים אם כלי יכול לפעול לבד או שהוא צריך לקרוא למשאב אחר.
כדאי לעיין בתלות הפנימית המתועדת של אפליקציית Java לדוגמה.
פרטי הכניסה מאוחסנים ב-Secret Manager, שלא נכלל בשרשרת הכלים, אבל הם נדרשים כדי שהאפליקציה תופעל בפריסה. לכן, פרטי הכניסה של האפליקציה כלולים כתלות ב-GKE. חשוב גם לכלול את הקבצים deploy.yaml ו-cloudbuild.yaml כתלות, למרות שהם מאוחסנים בבקרת המקור עם קוד האפליקציה, כי הם מגדירים את צינור ה-CI/CD של האפליקציה הזו.
ה-BCP של אפליקציית Java לדוגמה צריך להתייחס לתלות הזו בקבצים deploy.yaml ו-cloudbuild.yaml, כי הם יוצרים מחדש את צינור ה-CI/CD אחרי שהכלים מוצבים במהלך תהליך השחזור.
בנוסף, אם יש פגיעה בתלות הזו, הפונקציה הכוללת של צינור הנתונים תושפע גם אם הכלים עצמם עדיין פועלים.
יחסי תלות חיצוניים
תלויות חיצוניות הן מערכות חיצוניות ששרשרת הכלים שלכם מסתמכת עליהן כדי לפעול, והן לא בשליטה ישירה שלכם. תלויות חיצוניות נובעות מהכלים וממסגרות התכנות שבחרתם. אפשר לחשוב על תלות חיצונית כשכבה נוספת מתחת לתלות פנימית. דוגמאות לתלות חיצונית כוללות מאגרי npm או Maven ושירותי מעקב.
למרות שאין לכם שליטה על תלות חיצונית, אתם יכולים לשלב אותה ב-BCP שלכם. בתרשים הבא מוצג עדכון של אפליקציית Java לדוגמה, שכולל יחסי תלות חיצוניים בנוסף ליחסי התלות הפנימיים: ספריות Java ב-Maven Central וקובצי אימג' של Docker ב-Docker Hub. הספריות של Java משמשות את Artifact Registry, וקובצי האימג' של Docker משמשים את Cloud Build.
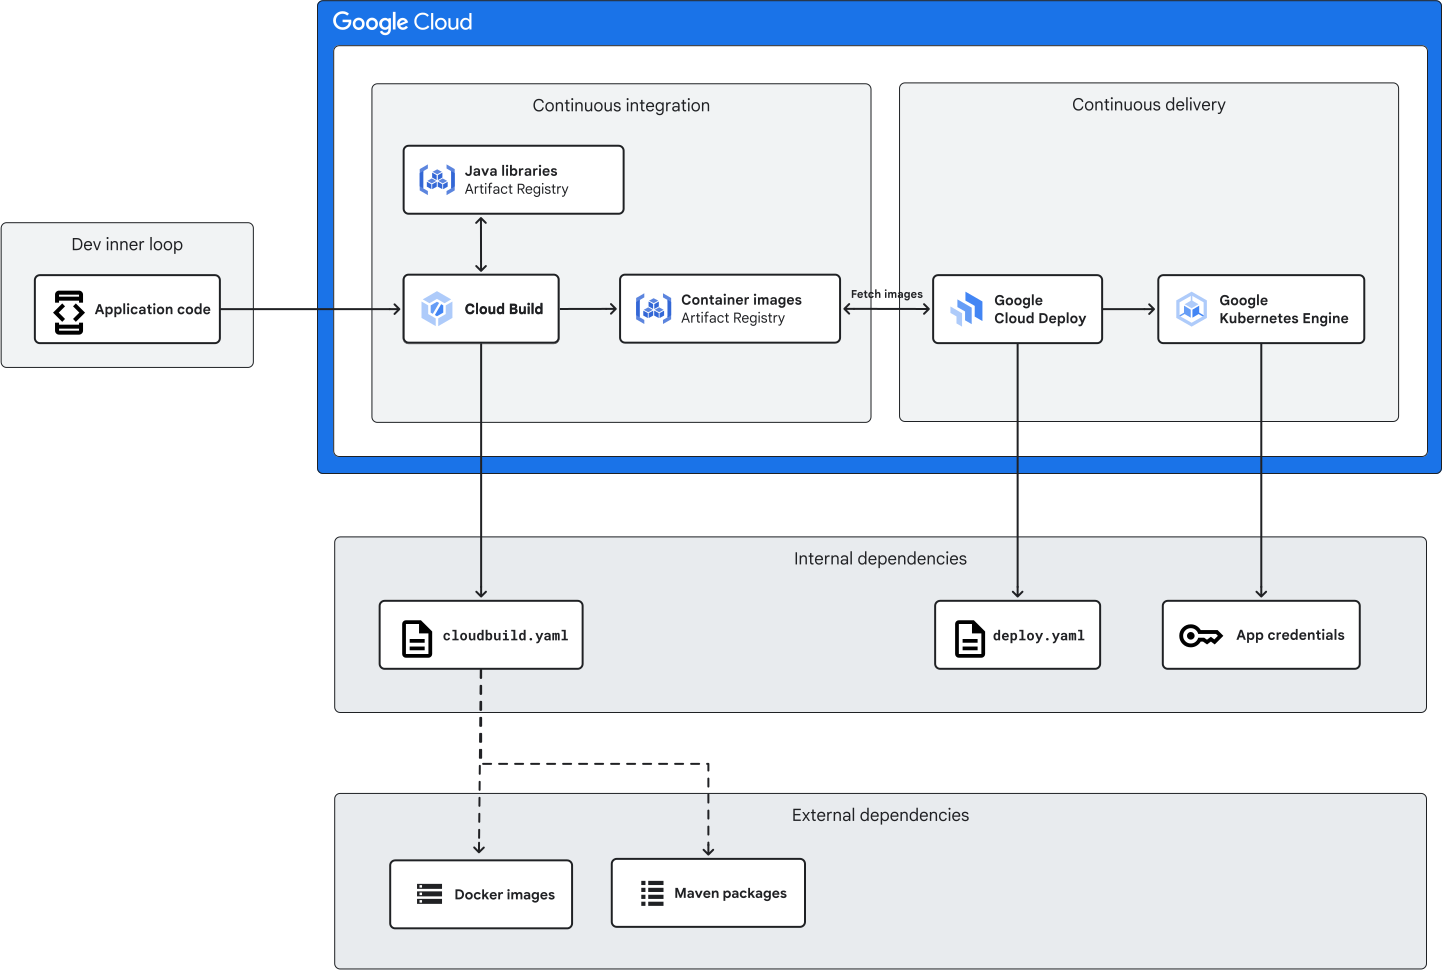
בתרשים אפשר לראות שתלויות חיצוניות יכולות להיות חשובות לתהליך CI/CD: גם Cloud Build וגם GKE מסתמכים על שני שירותים חיצוניים (Maven ו-Docker) כדי לפעול בהצלחה. כשמעריכים את שרשרת הכלים, צריך לתעד את התלות החיצונית של הכלים ואת ההליכים לטיפול בהפסקות זמניות של התלות.
בדוגמה של אפליקציית Java, אי אפשר לשלוט ישירות בספריות Java ובתמונות Docker, אבל עדיין אפשר לכלול אותן ואת תהליכי השחזור שלהן ב-BCP. לדוגמה, נניח שיש לכם ספריות Java ב-Maven. למרות שהספריות מאוחסנות במקור חיצוני, אפשר להגדיר תהליך להורדה ולרענון של ספריות Java באופן תקופתי במאגר Maven מקומי או ב-Artifact Registry. כך, תהליך השחזור לא יסתמך על הזמינות של המקור של הצד השלישי.
בנוסף, חשוב להבין שלתלות חיצוניות יכולות להיות יותר משכבה אחת. לדוגמה, אפשר להתייחס למערכות שמשמשות את התלויות הפנימיות שלכם כאל תלויות מסדר שני. יכול להיות שלתלויות מסדר שני יהיו תלויות משלהן, שאפשר להתייחס אליהן כתלויות מסדר שלישי. חשוב לדעת שאולי תצטרכו לתעד ולתת דין וחשבון על תלות חיצונית מסדר שני וסדר שלישי ב-BCP שלכם כדי לשחזר פעולות במהלך שיבוש.
קביעת יעדי RTO ו-RPO
אחרי שמבינים את שרשרת הכלים והתלות, מגדירים את יעדי ה-RTO וה-RPO של הכלים. כל אחד מהכלים בתהליך CI/CD מבצע פעולה שונה, שיכולה להשפיע על העסק בצורה שונה. לכן חשוב להתאים את העדיפות של יעדי ה-RTO וה-RPO של הפונקציה העסקית להשפעה שלה על העסק. לדוגמה, יצירת גרסאות חדשות של אפליקציות בשלב CI יכולה להיות פחות משמעותית מפריסת אפליקציות בשלב CD. לכן, יכול להיות שלכלי פריסה יהיו יעדי RTO ו-RPO ארוכים יותר מאשר לפונקציות אחרות.
בתרשים הבא, שמחולק לארבעה רבעים, מוצגת דוגמה כללית לאופן שבו אפשר לקבוע את יעדי ה-RTO וה-RPO לכל רכיב בשרשרת הכלים של CI/CD. שרשרת הכלים שממופה בתרשים הזה כוללת כלים כמו צינור IaC ומקורות נתוני בדיקה. הכלים לא הוזכרו בתרשימים הקודמים של אפליקציית Java, אבל הם נכללים כאן כדי לספק דוגמה מלאה יותר.
בתרשים מוצגים רבעים שמבוססים על רמת ההשפעה על מפתחים ועל פעולות. בתרשים, הרכיבים ממוקמים באופן הבא:
- השפעה מתונה על המפתחים, השפעה נמוכה על הפעולות: מקורות נתונים לבדיקה
- השפעה בינונית על מפתחים, השפעה בינונית על פעולות: Cloud Key Management Service, Cloud KMS
- השפעה בינונית על המפתחים, השפעה גבוהה על הפעולות: צינור פריסה
- השפעה גבוהה על המפתחים, השפעה נמוכה על הפעולות: לולאה פנימית של פיתוח
- השפעה גבוהה על מפתחים, השפעה בינונית על פעולות: צינור עיבוד נתונים של CI, צינור עיבוד נתונים של תשתית כקוד (IaC)
- השפעה רבה על מפתחים, השפעה רבה על פעולות: ניהול בקרת מקורות (SCM), Artifact Registry
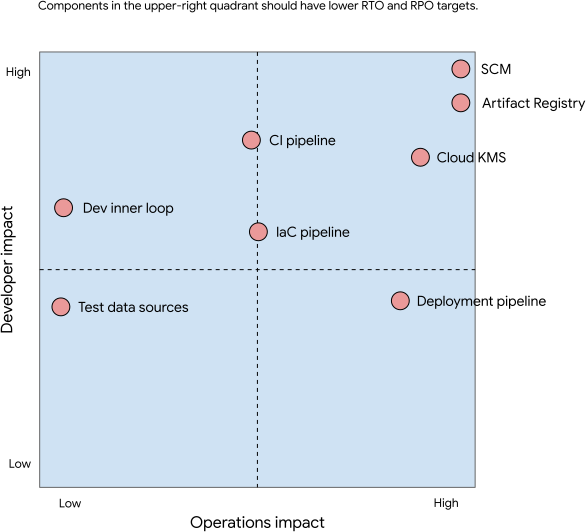
לרכיבים כמו ניהול בקרת מקור ו-Artifact Registry, שמשפיעים מאוד על המפתחים ועל הפעולות, יש את ההשפעה הגדולה ביותר על העסק. הרכיבים האלה צריכים להיות בעלי יעדי RTO ו-RPO נמוכים ככל האפשר. לרכיבים ברבעים האחרים יש עדיפות נמוכה יותר, מה שאומר שהיעדים של RTO ו-RPO יהיו גבוהים יותר. באופן כללי, צריך להגדיר את יעדי ה-RTO וה-RPO של רכיבי שרשרת הכלים בהתאם לכמות הנתונים או ההגדרות שאפשר לאבד בהשוואה לכמות הזמן שצריך כדי לשחזר את השירות עבור הרכיב הזה.
לדוגמה, אפשר לראות בגרף את המיקומים השונים של Artifact Registry ושל צינור ה-IaC. השוואה בין שני הכלים האלה מראה שהשבתה של Artifact Registry משפיעה על הפעילות העסקית יותר מהשבתה של צינור ה-IaC. מכיוון שהשבתה של Artifact Registry משפיעה באופן משמעותי על היכולת שלכם לפרוס את האפליקציה או לשנות את קנה המידה שלה באופן אוטומטי, יעדי ה-RTO וה-RPO שלה יהיו נמוכים יותר בהשוואה לכלים אחרים. לעומת זאת, מהגרף אפשר לראות שהשבתה של צינור IaC משפיעה פחות על הפעילות העסקית בהשוואה לכלים אחרים. במקרה כזה, צינור ה-IaC יכלול יעדי RTO ו-RPO גבוהים יותר, כי אפשר להשתמש בשיטות אחרות כדי לפרוס או לעדכן את התשתית במהלך הפסקת שירות.
בחירת אסטרטגיה ברמה גבוהה להמשכיות עסקית
תהליכי המשכיות עסקית לאפליקציות בייצור מסתמכים לרוב על אחת משלוש אסטרטגיות נפוצות להתאוששות מאסון. עם זאת, עבור CI/CD, אתם יכולים לבחור בין שתי אסטרטגיות ברמה גבוהה להמשכיות עסקית: פעילה/לא פעילה או גיבוי/שחזור. השיטה שתבחרו תהיה תלויה בדרישות ובתקציב שלכם. לכל אסטרטגיה יש יתרונות וחסרונות מבחינת מורכבות ועלות, ויש שיקולים שונים לתהליך CI/CD. בקטעים הבאים מפורטות שיטות הבידינג השונות והיתרונות והחסרונות שלהן.
בנוסף, כשמתרחשים אירועים שגורמים להפרעה בשירות, יכול להיות שהם ישפיעו על יותר מהטמעת ה-CI/CD שלכם. כדאי גם לקחת בחשבון את כל התשתית שאתם צריכים, כולל הרשת, המחשוב והאחסון. חשוב ליצור תוכנית DR לאבני הבניין האלה ולבדוק אותה באופן קבוע כדי לוודא שהיא יעילה.
פעיל/סביל
בשיטת הגיבוי הפעיל/סביל (או המתנה חמה), האפליקציות וצינור ה-CI/CD הסביל הם שיקופים. עם זאת, צינור הנתונים הפסיבי לא מטפל בפועל בעומס העבודה של הלקוח ובכל בנייה או פריסה, ולכן הוא במצב מצומצם. האסטרטגיה הזו מתאימה במיוחד לאפליקציות קריטיות לעסק שבהן אפשר לסבול תקופות השבתה קצרות.
בתרשים הבא מוצגת תצורה פעילה/פסיבית של אפליקציית Java לדוגמה שבה נעשה שימוש במסמך הזה. הצינור הפסיבי משכפל באופן מלא את שרשרת הכלים של האפליקציה באזור אחר.
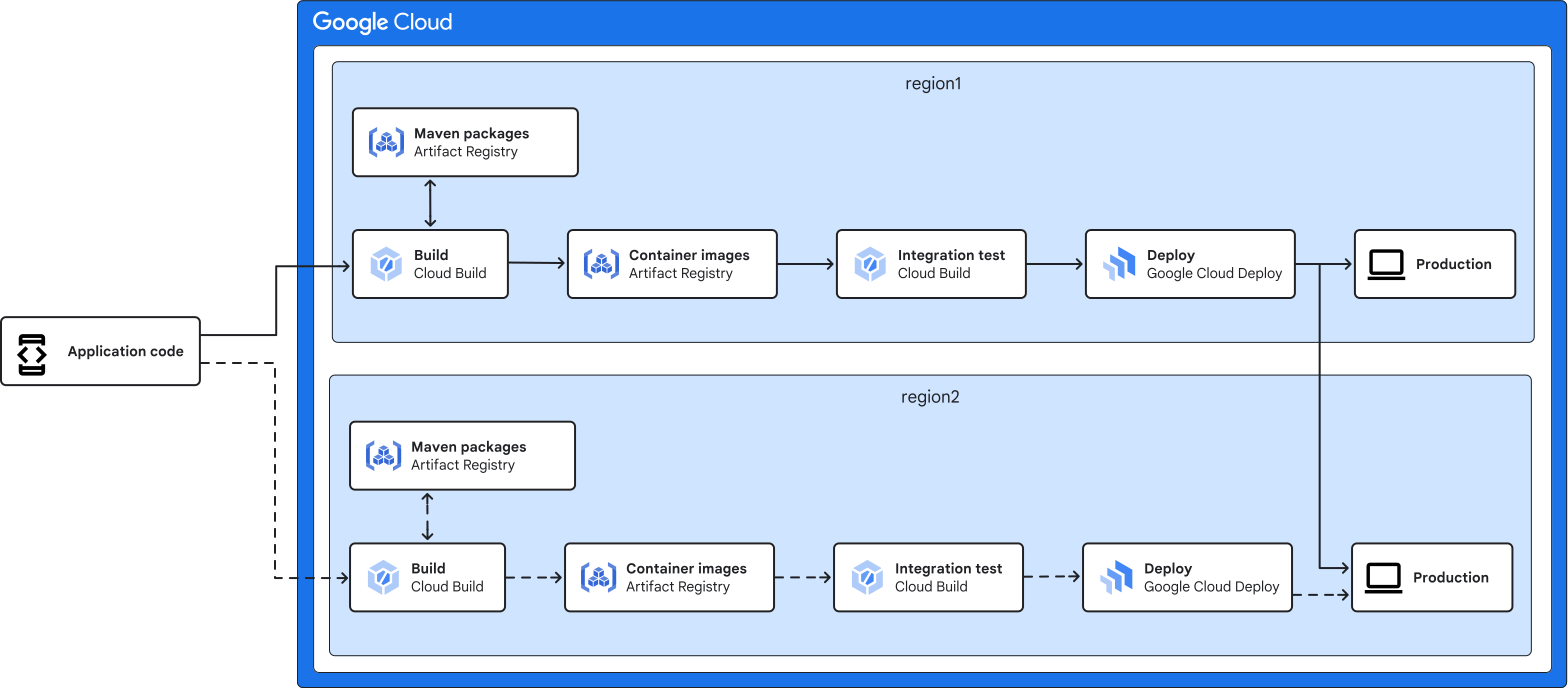
בדוגמה הזו, אזור 1 מארח את צינור ה-CI/CD הפעיל, ובאזור 2 יש את המקבילה הפסיבית. הקוד מתארח אצל ספק חיצוני של שירות Git, כמו GitHub או GitLab. אירוע במאגר (כמו מיזוג מבקשת משיכה) יכול להפעיל את צינור עיבוד הנתונים של CI/CD באזור 1 כדי לבצע בנייה, בדיקה ופריסה בסביבת הייצור הרב-אזורית.
אם מתרחשת בעיה קריטית בצינור של אזור 1, כמו הפסקת פעילות אזורית של מוצר, התוצאה יכולה להיות פריסות שנכשלו או בנייה לא מוצלחת. כדי לפתור את הבעיה במהירות, אפשר לעדכן את הטריגר למאגר Git ולעבור לצינור אזור 2, שיהפוך לצינור הפעיל. אחרי שהבעיה נפתרת באזור 1, אפשר להשאיר את צינור הנתונים באזור 1 במצב פסיבי.
היתרונות של שיטת הפעיל/סביל כוללים:
- זמן השבתה קצר: צינור הנתונים הפסיבי נפרס אבל הוא מצומצם, ולכן זמן ההשבתה מוגבל לזמן שנדרש להרחבת צינור הנתונים.
- סובלנות להגדרה לאובדן נתונים: עם האסטרטגיה הזו, צריך לסנכרן מעת לעת את ההגדרה ואת הארטיפקט. עם זאת, אפשר להגדיר את הסכום בהתאם לדרישות שלכם, וכך לצמצם את המורכבות.
חסרונות של השיטה הזו:
- עלות: עם תשתית כפולה, האסטרטגיה הזו מגדילה את העלות הכוללת של תשתית ה-CI/CD.
גיבוי/שחזור
באסטרטגיית הגיבוי והשחזור, יוצרים את פייפליין היתירות כשל רק כשצריך אותו במהלך התאוששות מאירוע. השיטה הזו מתאימה בעיקר לתרחישי שימוש עם עדיפות נמוכה יותר. בתרשים הבא מוצגת תצורת גיבוי ושחזור לאפליקציית Java לדוגמה. הגדרת הגיבוי משכפלת רק חלק מצינור עיבוד הנתונים של CI/CD של האפליקציה באזור אחר.
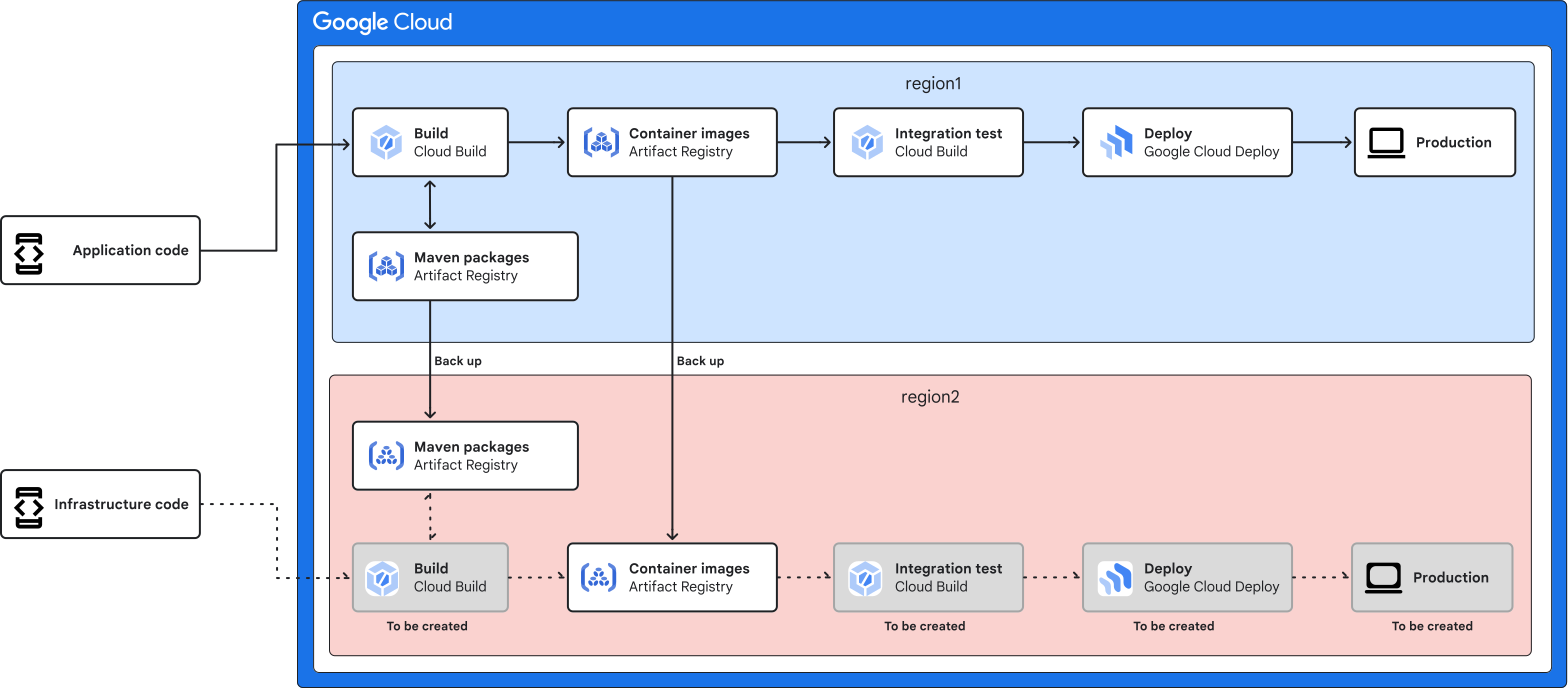
בדומה לדוגמה הקודמת, אזור 1 מארח את צינור עיבוד הנתונים הפעיל של CI/CD. במקום צינור פסיבי באזור 2, באזור 2 יש רק גיבויים של נתונים אזוריים נחוצים, כמו חבילות Maven וקובצי אימג' לקונטיינרים. אם מארחים את מאגרי המקור באזור 1, צריך גם לסנכרן את הנתונים למיקומי ה-DR.
באופן דומה, אם מתרחשת בעיה קריטית בצינור העיבוד באזור 1, כמו הפסקת זמנית של מוצר אזורי, אפשר לשחזר את ההטמעה של CI/CD באזור 2. אם קוד התשתית מאוחסן במאגר קוד התשתית, אפשר להריץ את סקריפט האוטומציה מהמאגר ולבנות מחדש את צינור ה-CI/CD באזור 2.
אם ההשבתה היא אירוע בקנה מידה גדול, יכול להיות שתתחרו עם לקוחות אחרים על משאבי הענן. אחת הדרכים לצמצם את הסיכון הזה היא להגדיר כמה אפשרויות למיקום DR. לדוגמה, אם צינור עיבוד הנתונים region1 נמצא ב-us-east1, אז אזור המעבר לגיבוי יכול להיות us-east4, us-central1 או us-west1.
היתרונות של אסטרטגיית הגיבוי והשחזור כוללים:
- עלות: העלות של האסטרטגיה הזו היא הכי נמוכה כי אתם פורסים את צינור הגיבוי רק בתרחישי DR.
חסרונות של השיטה הזו:
- זמן השבתה: יישום האסטרטגיה הזו לוקח יותר זמן כי יוצרים את פייפליין יתירות הכשל כשצריך. במקום צינור (pipeline) מוכן מראש, צריך ליצור ולהגדיר את השירותים במהלך שחזור האירוע. יכול להיות שגם משך זמן של תהליך build של פריט המידע שנוצר בתהליך פיתוח (artifact) והזמן שנדרש לאחזור יחסי תלות חיצוניים יהיו ארוכים משמעותית.
תיעוד של תוכנית המשכיות העסקית ויישום שיטות מומלצות
אחרי שממפים את שרשרת הכלים של CI/CD, מזהים את התלות שלה וקובעים את יעדי ה-RTO וה-RPO לפונקציות קריטיות, השלב הבא הוא לתעד את כל המידע הרלוונטי בתוכנית BCP כתובה. כשיוצרים את תוכנית המשכיות העסקית, חשוב לתעד את האסטרטגיות, התהליכים והנהלים לשחזור כל פונקציה קריטית. תהליך התיעוד הזה כולל כתיבת נהלים מפורטים לעובדים בתפקידים ספציפיים, כדי שיוכלו לפעול לפיהם בזמן שיבוש.
אחרי שמגדירים את תוכנית ההמשכיות העסקית, פורסים או מעדכנים את שרשרת הכלים של CI/CD באמצעות שיטות מומלצות כדי להשיג את יעדי ה-RTO וה-RPO. למרות ששרשראות של כלים ל-CI/CD יכולות להיות שונות מאוד, יש שני דפוסים מרכזיים של שיטות מומלצות שמשותפים לכל שרשרת כלים: הבנה מקיפה של התלות והטמעה של אוטומציה.
בנוגע לתלות, רוב תוכניות ההמשכיות העסקית מתייחסות למערכות ישירות בשליטה שלכם. עם זאת, חשוב לזכור שתלות חיצונית מסדר שני או שלישי יכולה להיות משמעותית באותה מידה, ולכן חשוב להטמיע שיטות מומלצות ואמצעי יתירות גם עבור התלויות הקריטיות האלה. ספריות ה-Java החיצוניות באפליקציה לדוגמה הן דוגמה לתלויות מסדר שלישי. אם אין לכם מאגר מקומי או גיבוי של הספריות האלה, יכול להיות שלא תוכלו ליצור את האפליקציה אם המקור החיצוני שממנו אתם שולפים את הספריות מנותק.
בנוגע לאוטומציה, כדאי לשלב את השיטות המומלצות בהטמעה באסטרטגיית ה-IaC הכוללת שלכם בענן. פתרון ה-IaC צריך להשתמש בכלים כמו Terraform כדי להקצות באופן אוטומטי את המשאבים הנדרשים להטמעה של CI/CD, וכדי להגדיר את התהליכים. שיטות עבודה מומלצות של IaC הן הליכי שחזור יעילים מאוד כי הן משולבות בפעילות השוטפת של צינורות ה-CI/CD. בנוסף, IaC מעודד אחסון של קובצי התצורה בבקרה על קוד המקור, מה שבתורו מעודד אימוץ של השיטות המומלצות לגיבויים.
אחרי שמטמיעים את כלי הפיתוח בהתאם לתוכנית להמשכיות עסקית ולשיטות המומלצות לניהול תלות ואוטומציה, יכול להיות שתהליך ה-CI/CD ואסטרטגיות השחזור ישתנו. חשוב לתעד את כל השינויים בשיטות, בתהליכים ובנהלים לשחזור שנובעים מבדיקת התוכנית להמשכיות עסקית ומיישום שיטות מומלצות.
בדיקת תרחישי כשל ותחזוקת התוכנית
חשוב מאוד לבדוק, לבחון ולעדכן את תוכנית ההמשכיות העסקית באופן שוטף. בדיקת תוכנית ה-BCP והנהלים לשחזור מוכיחה שהתוכנית עדיין תקפה ושיעדי ה-RPO וה-RTO המתועדים מקובלים. אבל מה שהכי חשוב הוא שביצוע בדיקות, עדכונים ותחזוקה באופן קבוע הופך את תוכנית ההמשכיות העסקית לחלק מהפעולות הרגילות. באמצעות Google Cloud, אפשר לבדוק תרחישי שחזור בעלות מינימלית. כדי לעזור לכם בבדיקות, מומלץ לבצע את הפעולות הבאות:
- אוטומציה של הקצאת משאבי תשתית באמצעות כלי IaC: אפשר להשתמש בכלים כמו Terraform כדי לבצע אוטומציה של הקצאת משאבי תשתית של CI/CD.
- מעקב אחר הבדיקות וניפוי באגים באמצעות Cloud Logging ו-Cloud Monitoring: Google Cloud Observability מספק כלים לרישום ביומן ולמעקב שאפשר לגשת אליהם באמצעות קריאות API. כך אפשר להגיב למדדים ולהפוך את הפריסה של תרחישי שחזור לאוטומטית. כשמתכננים בדיקות, חשוב לוודא שיש לכם מערכת מתאימה של מעקב והתראות שיכולה להפעיל פעולות שחזור מתאימות.
- ביצוע הבדיקות ב-BCP: לדוגמה, אפשר לבדוק אם ההרשאות וגישת המשתמש פועלות בסביבת ה-DR כמו שהן פועלות בסביבת הייצור. אתם יכולים לבצע בדיקות שילוב ובדיקות פונקציונליות בסביבת ה-DR. אפשר גם לבצע בדיקה שבה נתיב הגישה הרגיל אל Google Cloud לא פועל.
ב-Google, אנחנו בודקים באופן קבוע את תוכנית ה-BCP שלנו באמצעות תהליך שנקרא DiRT (בדיקת התאוששות מאסון). הבדיקה הזו עוזרת ל-Google לאמת את ההשפעות והאוטומציה, ולחשוף סיכונים שלא נלקחו בחשבון. שינויים באוטומציה וב-BCP שצריך להטמיע הם תוצאה חשובה של DiRT.
שיטות מומלצות
בקטע הזה נסביר על כמה שיטות מומלצות שאפשר להטמיע כדי להשיג את יעדי ה-RTO וה-RPO. השיטות המומלצות האלה חלות באופן כללי על DR ל-CI/CD, ולא על כלים ספציפיים. לא משנה איך תטמיעו את התוכנית, חשוב לבדוק אותה באופן קבוע כדי לוודא שהזמינות הגבוהה, ה-RTO וה-RPO עומדים בדרישות שלכם. במקרה של אירוע או אסון, מומלץ גם לבצע ניתוח רטרוספקטיבי של התהליך כדי לשפר אותו.
זמינות גבוהה
בכל כלי, מומלץ לפעול לפי השיטות המומלצות לזמינות גבוהה. יישום שיטות מומלצות לזמינות גבוהה מאפשר לכם לנקוט גישה פרואקטיבית יותר בתהליך CI/CD, כי השיטות האלה משפרות את העמידות של התהליך בפני כשלים. מומלץ להשתמש באסטרטגיות הפרואקטיביות האלה יחד עם אמצעי בקרה ותהליכים ריאקטיביים יותר לשחזור ולגיבוי.
ריכזנו כאן כמה שיטות מומלצות שיעזרו לכם להשיג זמינות גבוהה. עם זאת, כדאי לעיין במסמכי התיעוד המפורטים של כל כלי ב-CI/CD כדי לקבל שיטות מומלצות מפורטות יותר:
- שירותים מנוהלים: שימוש בשירותים מנוהלים מעביר את האחריות התפעולית אל Google Cloud.
- התאמה אוטומטית לעומס: כשניתן, מומלץ להשתמש בהתאמה אוטומטית לעומס. היבט מרכזי של שינוי גודל אוטומטי הוא שיצירת מופעי Worker מתבצעת באופן דינמי, כך שהשחזור של צמתים שנכשלו הוא אוטומטי.
- פריסות גלובליות ופריסות בכמה אזורים: במידת האפשר, כדאי להשתמש בפריסות גלובליות ובפריסות בכמה אזורים במקום בפריסות אזוריות. לדוגמה, אפשר להגדיר את Artifact Registry לאחסון במספר אזורים.
- יחסי תלות: חשוב להבין את כל יחסי התלות של כלי הפיתוח ולוודא שיחסי התלות האלה זמינים מאוד. לדוגמה, אפשר לשמור במטמון את כל הספריות של צד שלישי במאגר פריטי המידע שנוצרו בתהליך הפיתוח.
תהליכי גיבוי
כשמטמיעים DR עבור CI/CD, יש כלים ותהליכים שמתאימים יותר לאסטרטגיות של גיבוי ושחזור. השלב הראשון בבקרה תגובתית יעילה הוא גיבוש אסטרטגיית גיבוי מקיפה. גיבויים מאפשרים לשחזר את צינור ה-CI/CD עם הפרעה מינימלית במקרה של גורמים זדוניים או תרחישי אסון.
כנקודת התחלה, כדאי להטמיע את שלוש השיטות המומלצות הבאות. עם זאת, כדי לקבל מידע מפורט יותר על שיטות מומלצות לגיבוי, כדאי לעיין במסמכי העזרה של כל כלי בתהליך ה-CI/CD.
- בקרת מקור: אחסון של קובצי הגדרה וכל מה שמקודד, כמו סקריפטים של אוטומציה ומדיניות, בבקרת מקור. דוגמאות כוללות את הקבצים
cloudbuild.yamlו-Kubernetes YAML. - יתירות: מוודאים שאין נקודת כשל יחידה בכל הנוגע לגישה לערכי סוד כמו סיסמאות, אישורים ומפתחות API. דוגמאות לשיטות שכדאי להימנע מהן כוללות מצבים שבהם רק אדם אחד יודע את הסיסמה או שבהם מפתח ה-API מאוחסן רק בשרת יחיד באזור מסוים.
- גיבויים: מומלץ לוודא לעיתים קרובות שהגיבויים שלכם מלאים ומדויקים. שירותים מנוהלים כמו Backup for GKE יעזרו לכם לפשט את תהליך האימות.
הליכי שחזור
בנוסף, צריך להגדיר נהלי שחזור כדי להשלים את תהליכי הגיבוי. נוהלי השחזור שלכם, בשילוב עם גיבויים מלאים, יקבעו כמה מהר תוכלו להגיב לתרחישי אסון.
ניהול יחסי תלות
יכולות להיות הרבה תלויות בצינור CI/CD, והן יכולות להיות גם מקורות לבעיות. רשימה מלאה של יחסי התלות צריכה להיות מזוהה כמו שמתואר קודם במסמך הזה בקטע זיהוי נתונים ויחסי תלות. עם זאת, שני המקורות הנפוצים ביותר לתלות הם:
- ארטיפקטים של אפליקציות: לדוגמה, חבילות, ספריות ותמונות
- מערכות חיצוניות: לדוגמה, מערכות לניהול פניות לתמיכה ומערכות התראות
אחת הדרכים לצמצם את הסיכונים של תלות היא לאמץ את שיטת הספק. תהליך ה-Vendoring של חבילות אפליקציות או תמונות הוא תהליך של יצירה ואחסון של עותקים שלהן במאגר פרטי. השימוש ב-Vendoring מסיר את התלות במקורות חיצוניים לחבילות או לתמונות האלה, ויכול גם לעזור למנוע את החדרת התוכנות הזדוניות לשרשרת אספקת התוכנה.
אלה כמה מהיתרונות של יצירת עותק מקוד של צד שלישי (vendoring) של חבילות או תמונות של אפליקציות:
- אבטחה: שימוש ב-vendoring מסיר את התלות במקורות חיצוניים לחבילות או לתמונות של אפליקציות, ויכול לעזור למנוע מתקפות של החדרת תוכנות זדוניות.
- שליטה: על ידי יצירת עותק מקוד של צד שלישי (vendoring) של חבילות או תמונות משלהם, ארגונים יכולים לקבל יותר שליטה על המקור של החבילות והתמונות האלה.
- תאימות: שימוש בספקים יכול לעזור לארגונים לעמוד בדרישות של תקנות בתחום, כמו אישור של מודל מוכנות של אבטחת סייבר.
אם הצוות שלכם מחליט להשתמש בחבילות או בתמונות של אפליקציות של ספקים, צריך לבצע את השלבים העיקריים הבאים:
- מזהים את חבילות האפליקציות או התמונות שצריך להוסיף לספרייה.
- יוצרים מאגר פרטי לאחסון החבילות או התמונות של הספק.
- מורידים את החבילות או התמונות מהמקור המקורי ומאחסנים אותן במאגר הפרטי.
- מוודאים שהחבילות או התמונות תקינות.
- מעדכנים את החבילות או התמונות שסופקו על ידי ספק לפי הצורך.
צינורות CI/CD מתקשרים לעיתים קרובות למערכות של צד שלישי כדי לבצע פעולות כמו הפעלת סריקות, רישום כרטיסים או שליחת התראות. ברוב המקרים, למערכות של צדדים חיצוניים יש אסטרטגיות משלהן להתאוששות מאסון, וצריך ליישם אותן. עם זאת, במקרים מסוימים יכול להיות שאין להם תוכנית מתאימה להתאוששות מאסון, ולכן צריך לתעד את המקרים האלה בבירור בתוכנית להמשכיות עסקית. לאחר מכן, צריך להחליט אם אפשר לדלג על השלבים האלה בצינור הנתונים מסיבות שקשורות לזמינות, או אם מקובל לגרום להשבתה של צינור הנתונים של CI/CD.
מעקב והתראות
מערכת ה-CI/CD שלכם דומה למערכות הייצור של האפליקציה, ולכן אתם צריכים להטמיע גם טכניקות של מעקב והתראות בכלי ה-CI/CD. מומלץ להטמיע לוחות בקרה והתראות. במאגר הדוגמאות של Cloud Monitoring ב-GitHub יש הרבה דוגמאות ללוחות בקרה ולמדיניות התראות.
אפשר גם להטמיע רמות נוספות של מעקב, כמו אינדיקטורים לרמת השירות (SLI) ויעדים למדידת רמת השירות (SLO). רמות המעקב האלה עוזרות לעקוב אחרי התקינות והביצועים הכוללים של צינורות ה-CI/CD. לדוגמה, אפשר להטמיע יעדי SLO כדי לעקוב אחרי זמן האחזור של שלבי ה-build והפריסה. הסכמי רמת השירות האלה עוזרים לצוותים לבנות ולפרסם אפליקציות בקצב ובתדירות שאתם רוצים.
הליכים לגישה במקרה חירום
במהלך אסון, יכול להיות שצוותי התפעול יצטרכו לפעול מחוץ לנוהלים הרגילים ולקבל גישת חירום למערכות ולכלים. פעולות חירום כאלה נקראות לפעמים פעולות במקרה חירום. בתור התחלה, כדאי ליישם את שלוש השיטות המומלצות הבאות:
- מגבשים תוכנית ברורה להעברת הטיפול לדרג גבוה יותר. תוכנית ברורה עוזרת לצוות התפעול לדעת מתי צריך להשתמש בהליכי הגישה למקרי חירום.
- מוודאים שלכמה אנשים יש גישה למידע קריטי, כמו הגדרות וסודות.
- פיתוח שיטות אוטומטיות לביקורת, כדי שתוכלו לעקוב אחרי השימוש בהליכי גישה לשעת חירום ולראות מי השתמש בהם.
המאמרים הבאים
- מידע נוסף על Google Cloud המוצרים שמוזכרים במסמך הזה:
- מדריך להכנת תוכנית התאוששות מאסון
- כדאי לנסות תכונות אחרות Google Cloud בעזרת המדריכים שלנו.
- לדוגמאות נוספות של ארכיטקטורות, תרשימים ושיטות מומלצות, עיינו במאמר Cloud Architecture Center.
שותפים ביצירת התוכן
מחברים:
- Ben Good | Solutions Architect
- Xiang Shen | Solutions Architect
תורמי תוכן אחרים:
- Marco Ferrari | Cloud Solutions Architect
- Anuradha Bajpai | Solutions Architect
- Rodd Zurcher | Solutions Architect