


為確保資料消費者的用途獲得滿足,必須謹慎設計及建構資料網格中的資料產品。設計資料產品時,首先要定義資料消費者如何使用該產品,以及該產品如何向消費者公開。資料網格中的資料產品是以資料儲存庫 (例如網域資料倉儲或資料湖泊) 為基礎建構而成。在資料網格中建立資料產品時,建議您在整個過程中考量一些重要因素。本文將說明這些考量。
本文件是一系列文章的一部分,說明如何在 Google Cloud上實作資料網格。本指南假設您已閱讀並熟悉資料網格的架構與功能和使用 Google Cloud建構現代分散式資料網格中說明的概念。
本系列包含下列部分:
- 資料網格的架構與功能
- 為資料網格設計自助式資料平台
- 在資料網格中建構資料產品 (本文件)
- 在資料網格中探索及使用資料產品
從網域資料倉儲建立資料產品時,建議資料產生者仔細設計這些產品的分析 (消費) 介面。這些使用介面是一組資料品質和作業參數的保證,以及產品支援模型和產品說明文件。變更使用介面的成本通常很高,因為資料生產者和多個資料使用者可能都需要變更使用程序和應用程式。由於資料消費者很可能位於與資料產生者不同的組織單位,因此協調變更可能很困難。
下列各節提供背景資訊,說明建立網域倉儲、定義使用介面,以及向資料消費者公開這些介面時,必須考量的因素。
建立網域資料倉儲
建構獨立資料倉儲,與建構資料產生者團隊用來建立資料產品的網域資料倉儲,兩者在本質上並無差異。兩者唯一的實際差異在於,後者會透過消耗介面公開部分資料。
在許多資料倉儲中,從作業資料來源擷取的原始資料會經過擴充和資料品質驗證 (管理) 程序。在 Knowledge Catalog 代管的資料湖泊中,精選資料通常會儲存在指定的精選區域。資料整理完成後,部分資料應可透過多種介面供網域外部使用。如要定義這些使用介面,組織應為剛開始採用資料網格方法的網域團隊提供一組工具。資料產生者可透過這些工具,以自助方式建立新的資料產品。如需建議做法,請參閱「設計自助式資料平台」。
此外,資料產品必須符合集中定義的資料治理規定。這些需求會影響資料品質、資料可用性和生命週期管理。這些規定可建立資料消費者對資料產品的信任,並鼓勵使用資料產品,因此實施這些規定的好處值得投入心力。
定義使用介面
建議資料產生者使用多種類型的介面,而非只定義一或兩種。資料分析中的每種介面類型都有優缺點,沒有任何一種介面類型能完美滿足所有需求。資料產生者評估各介面類型的適用性時,必須考量下列事項:
- 能執行所需的資料處理作業。
- 可擴充性,能支援目前和未來的資料消費者用途。
- 資料消費者要求的效能。
- 開發和維護成本。
- 執行介面的費用。
- 支援貴組織使用的語言和工具。
- 支援儲存空間和運算功能分離。
舉例來說,如果業務需求是能對 PB 規模的資料集執行分析查詢,那麼唯一可行的介面就是 BigQuery 檢視表。但如果需要提供近乎即時的串流資料,則更適合使用以 Pub/Sub 為基礎的介面。
其中許多介面都不需要複製或複製現有資料。其中多數也允許您區隔儲存空間和運算,這是Google Cloud 分析工具的重要功能。透過這些介面公開的資料消費者,會使用可用的運算資源處理資料。資料產生者不需要佈建任何額外的基礎架構。
消費介面有很多種。以下是資料網格中最常用的介面,我們會在後續章節中討論:
本文中的介面清單並未列出所有介面。您也可以考慮其他使用介面選項,例如 BigQuery sharing (舊稱 Analytics Hub)。不過,這些其他介面不在本文件的討論範圍內。
授權檢視表和函式
資料產品應盡可能透過授權檢視表和授權函式 (包括資料表值函式) 公開。授權資料集可讓您輕鬆自動授權多個檢視表。使用授權檢視表可防止直接存取基礎資料表,並可讓您最佳化基礎資料表和查詢,而不會影響消費者使用這些檢視表。這個介面的使用者會使用 SQL 查詢資料。下圖說明如何使用授權資料集做為消耗介面。
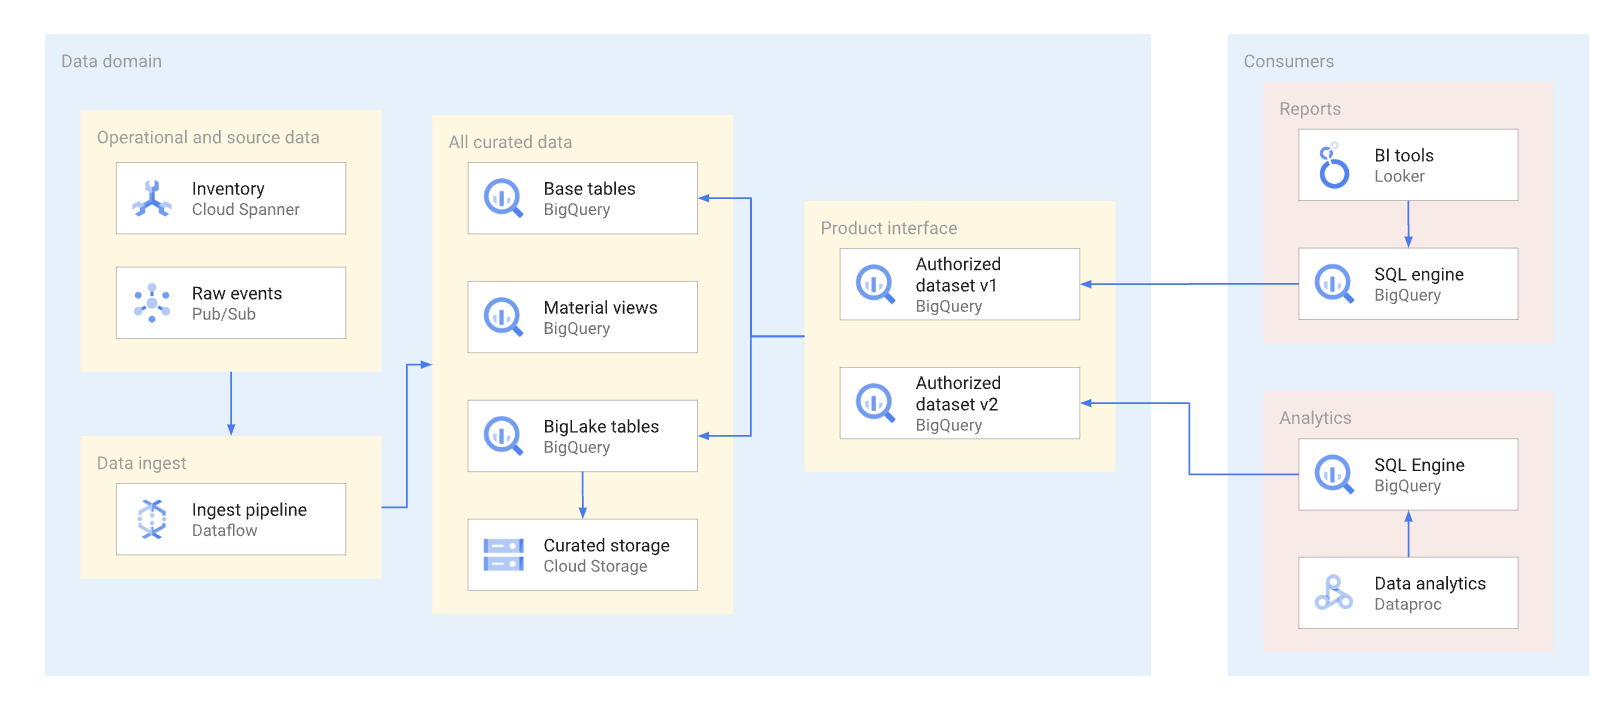
授權資料集和檢視表可讓您輕鬆建立介面版本。如下圖所示,資料產生者可以採取兩種主要版本管理方法:
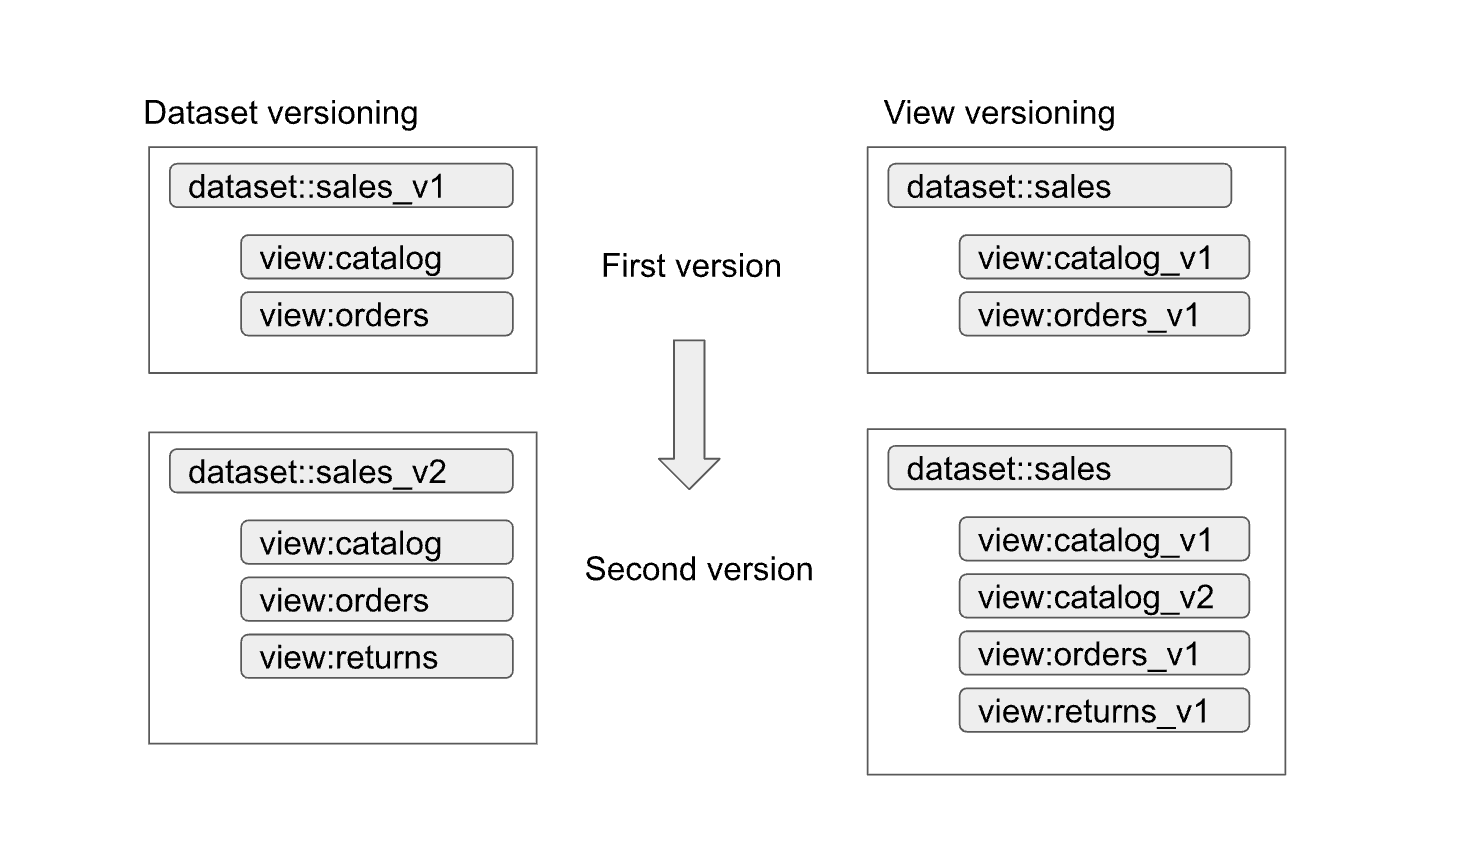
這些方法可歸納如下:
- 資料集版本管理:這種做法是為資料集名稱建立版本。您不會對資料集內的檢視表和函式建立版本。無論版本為何,檢視表和函式的名稱都保持不變。舉例來說,銷售資料集的第一個版本是在名為
sales_v1的資料集中定義,包含catalog和orders兩個檢視表。在第二個版本中,銷售資料集已重新命名為sales_v2,資料集中的任何先前檢視表都會保留先前的名稱,但會採用新的結構定義。第二個版本的資料集也可能新增檢視表,或移除先前的檢視表。 - 檢視表版本管理:這種方法會對資料集內的檢視表進行版本管理,而非資料集本身。舉例來說,無論版本為何,銷售資料集都會保留
sales的名稱。不過,資料集內的檢視表名稱會變更,以反映每個新版本的檢視表 (例如catalog_v1、catalog_v2、orders_v1、orders_v2和orders_v3)。
最適合貴組織的版本管理方法,取決於貴組織的政策,以及因基礎資料更新而淘汰的檢視表數量。如果需要進行重大產品更新,且必須變更大部分檢視畫面,則最適合使用資料集版本管理。檢視表版本管理可減少不同資料集中名稱相同的檢視表,但可能會導致模稜兩可的情況,例如如何判斷資料集之間的 join 是否正確運作。混合式做法是折衷的好選擇。在混合方法中,單一資料集內允許相容的結構定義變更,不相容的變更則需要新的資料集。
BigLake 資料表注意事項
除了 BigQuery 資料表,您也可以在 BigLake 資料表上建立授權檢視表。BigLake 資料表可讓使用者透過 BigQuery SQL 介面,查詢儲存在 Cloud Storage 中的資料。BigLake 資料表支援精細的存取控管,資料消費者不需具備基礎 Cloud Storage bucket 的讀取權限。
資料產生者必須考量 BigLake 資料表的下列事項:
- 檔案格式和資料版面配置的設計會影響查詢效能。以資料欄為基礎的格式 (例如 Parquet 或 ORC) 在分析查詢方面的效能通常比 JSON 或 CSV 格式好得多。
- Hive 分區版面配置可讓您刪除分區,並加快使用分區資料欄的查詢速度。
- 在設計階段,也必須考量檔案數量和檔案大小的首選查詢效能。
如果使用 BigLake 資料表的查詢不符合介面的服務水準協議 (SLA) 規定,且無法調整,建議採取下列行動:
- 對於必須向資料消費者公開的資料,請將該資料轉換為 BigQuery 儲存空間。
- 重新定義授權檢視表,以便使用 BigQuery 資料表。
一般來說,這種方法不會對資料消費者造成任何中斷,也不需要對查詢進行任何變更。BigQuery 儲存空間中的查詢可使用 BigLake 資料表無法採用的技術進行最佳化。舉例來說,使用 BigQuery 儲存空間時,消費者可以查詢與基礎資料表不同的分區和叢集化 materialized view,並使用 BigQuery BI Engine。
直接讀取 API
雖然我們通常不建議資料產生者授予資料消費者基礎資料表的直接讀取權限,但有時基於效能和成本等原因,允許這類存取權可能較為實用。在這種情況下,請務必格外小心,確保資料表架構穩定。
在一般資料倉儲中,有兩種方式可以直接存取資料。資料產生者可以使用 BigQuery Storage Read API,或 Cloud Storage JSON 或 XML API。下圖說明消費者使用這些 API 的兩個範例。一個是機器學習 (ML) 用途,另一個是資料處理工作。
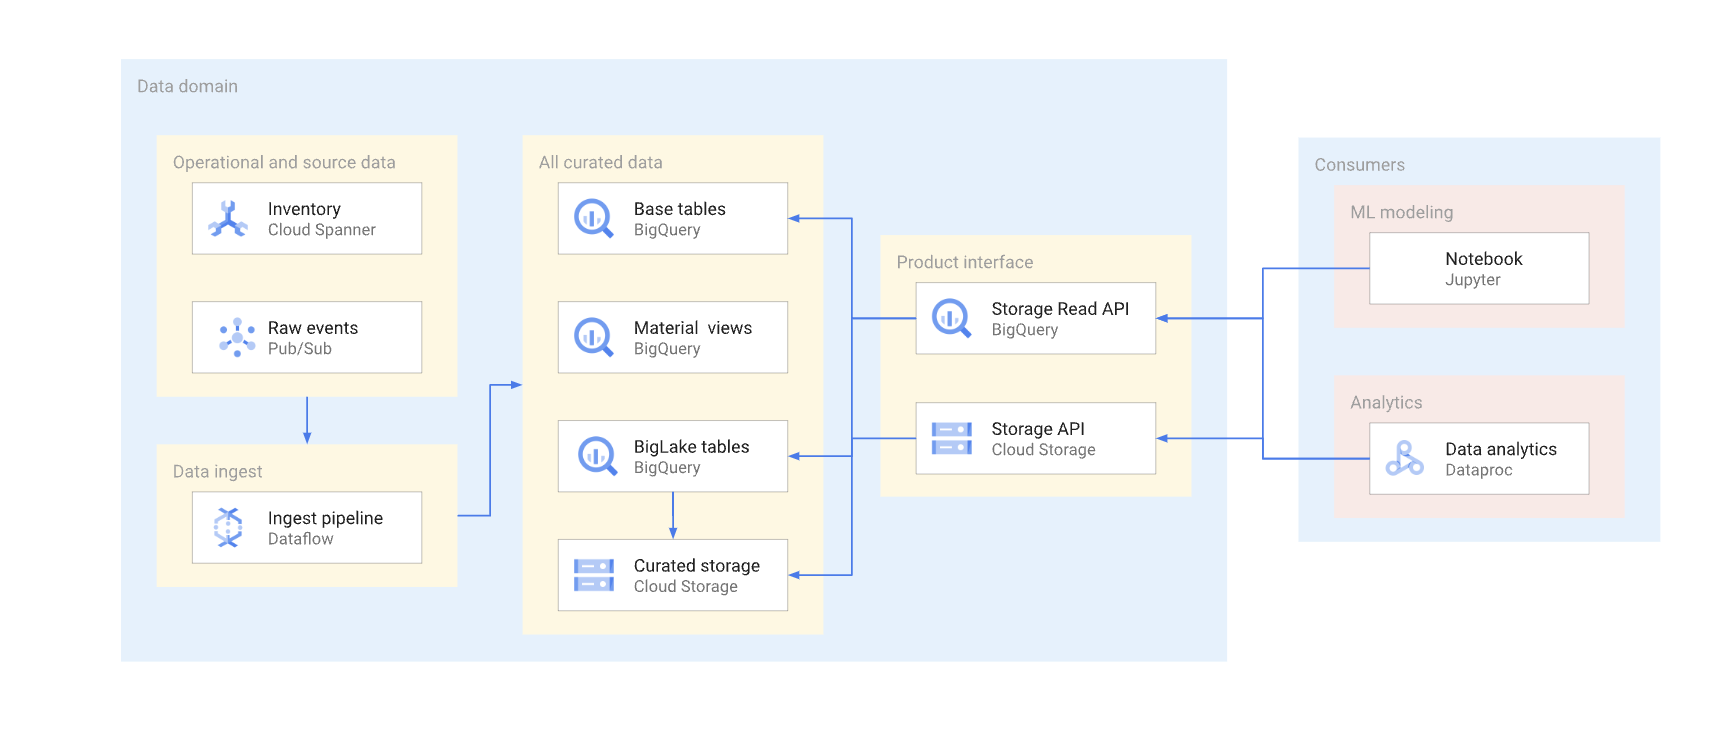
直接讀取介面的版本管理相當複雜。一般來說,資料產生者必須建立另一個結構定義不同的資料表。此外,他們也必須維護兩個版本的資料表,直到已淘汰版本的所有資料消費者都遷移至新版本為止。如果消費者可以容忍重建資料表和切換至新結構定義造成的中斷,則可以避免資料重複。如果結構定義變更可回溯相容,則可避免遷移基礎資料表。舉例來說,如果只新增資料欄,且這些資料欄中的資料已回填至所有資料列,就不必遷移基礎資料表。
以下摘要說明 Storage Read API 和 Cloud Storage API 的差異。一般而言,我們建議資料產生者盡可能使用 BigQuery API 執行分析應用程式。
Storage Read API: Storage Read API 可用於讀取 BigQuery 資料表和 BigLake 資料表中的資料。這個 API 支援篩選和精細的存取控管,適合穩定的資料分析或機器學習消費者。
Cloud Storage API:資料產生者可能需要直接與資料消費者共用特定 Cloud Storage bucket。舉例來說,如果資料消費者因故無法使用 SQL 介面,或 bucket 含有 Storage Read API 不支援的資料格式,資料產生者就能共用 bucket。
一般來說,我們不建議資料產生者允許透過 Storage API 直接存取,因為直接存取不允許篩選和精細的存取控管。不過,如果資料集穩定且規模較小 (GB 級),直接存取方法可能是可行的選擇。
允許 Pub/Sub 存取 bucket,資料消費者就能輕鬆將資料複製到專案中,並在專案中處理資料。一般來說,我們不建議複製資料,除非無法避免。多份資料副本會增加儲存成本,以及維護和歷程追蹤負擔。
資料即串流
網域可以將串流資料發布至 Pub/Sub 主題,藉此公開資料。想要使用資料的訂閱者會建立訂閱項目,以使用發布至該主題的訊息。每個訂閱者都會獨立接收及使用資料。下圖顯示這類資料串流的範例。
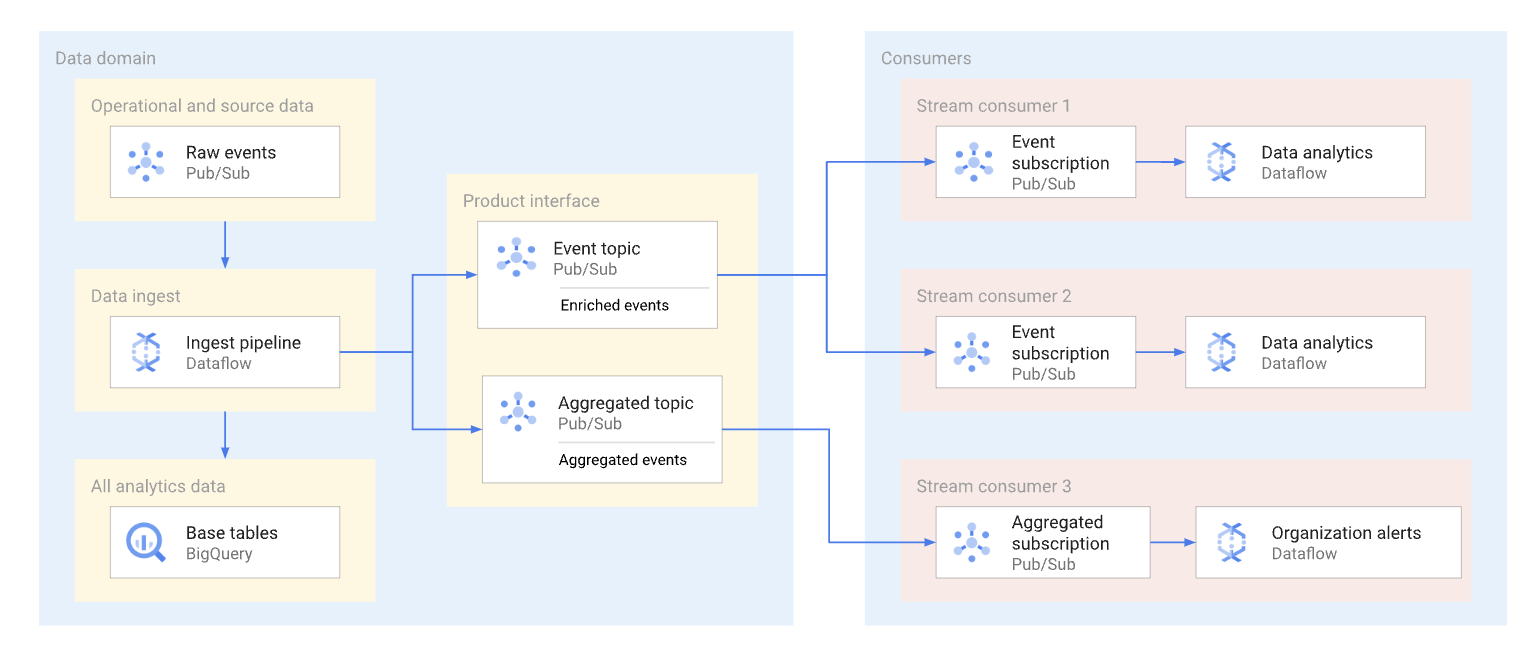
在圖表中,擷取管道會讀取原始事件、充實 (彙整) 事件,並將這些彙整資料儲存至分析資料儲存庫 (BigQuery 基礎資料表)。同時,管道會將擴充的事件發布至專屬主題。這個主題會由多個訂閱者取用,每個訂閱者都可能會篩選這些事件,只取得與自己相關的事件。管道也會匯總事件統計資料,並發布至自己的主題,供其他資料消費者處理。
以下是 Pub/Sub 訂閱項目的應用實例:
- 豐富事件,例如提供完整的客戶個人資料,以及特定客戶訂單的資料。
- 近乎即時的匯總通知,例如過去 15 分鐘的訂單總數統計資料。
- 業務層級快訊,例如訂單量比前一天同一時段減少 20% 時,產生快訊。
- 資料變更通知 (概念類似變更資料擷取通知),例如特定訂單狀態變更。
資料生產者用於 Pub/Sub 訊息的資料格式,會影響費用和訊息處理方式。在資料網格架構中,如要處理高流量串流,建議使用 Avro 或 Protobuf 格式。如果資料產生者使用這些格式,可以將結構定義指派給 Pub/Sub 主題。結構定義有助於確保消費者收到格式正確的訊息。
由於串流資料結構可能會不斷變更,因此這個介面的版本管理需要資料產生者和資料消費者之間的協調。資料產生者可以採取幾種常見做法,如下所示:
- 每次訊息結構變更時,系統都會建立新主題。這個主題通常具有明確的 Pub/Sub 結構定義。需要新介面的資料消費者可以開始使用新資料。訊息版本會由主題名稱暗示,例如
click_events_v1。訊息格式為強型別。同一主題中的訊息格式不會有任何變化。這種做法的缺點是,部分資料消費者可能無法切換至新的訂閱項目。在這種情況下,資料生產者必須在一段時間內,繼續將事件發布到所有有效主題,而訂閱主題的資料消費者則必須處理訊息流程中的差距,或刪除重複的訊息。 - 資料一律會發布至相同主題。不過,訊息結構可能會變更。Pub/Sub 訊息屬性 (與酬載分開) 會定義訊息版本。例如:
v=1.0。這種方法不需要處理缺漏或重複的問題,但所有資料消費者都必須準備好接收新類型的訊息。資料產生者也無法使用 Pub/Sub 主題結構定義。 - 混合式做法。訊息結構定義可以包含任意資料區段,用於新欄位。這種方法可以在強型別資料與頻繁且複雜的版本變更之間,提供合理的平衡。
資料存取 API
資料生產者可以建構自訂 API,直接存取資料倉儲中的基礎資料表。通常,這些供應商會將這項自訂 API 公開為 REST 或 gRPC API,並部署在 Cloud Run 或 Kubernetes 叢集上。Apigee 等 API 閘道可提供其他功能,例如流量節流或快取層。向 Google Cloud 組織外部的消費者公開資料存取 API 時,這些功能非常實用。資料存取 API 的潛在候選項目是延遲敏感和高並行查詢,這兩者都會在單一 API 中傳回相對較小的結果,且可有效快取。
這類用於資料存取的自訂 API 範例如下:
- 資料表或產品服務水準協議指標的合併檢視畫面。
- 特定資料表的前 10 筆記錄 (可能已快取)。
- 資料表統計資料的資料集 (資料列總數,或重要資料欄中的資料分布)。
組織針對建構應用程式 API 制定的任何規範和管理機制,也適用於資料產生者建立的自訂 API。組織的指南和管理機制應涵蓋託管、監控、存取控管和版本管理等問題。
自訂 API 的缺點是,資料產生者必須負責託管這個介面所需的任何額外基礎架構,以及自訂 API 編碼和維護。建議資料生產者先研究其他選項,再決定是否建立自訂資料存取 API。舉例來說,資料產生者可以使用 BigQuery BI Engine 縮短回應延遲時間,並提高並行性。
Looker 模塊
對於 Looker 等在商業智慧 (BI) 工具中大量使用的產品,維護一組 BI 工具專用的小工具可能會有幫助。資料產生者團隊瞭解網域中使用的基礎資料模型,因此最適合建立及維護一組預先建構的圖表。
以 Looker 來說,這項圖表可能是一組 Looker 模塊 (預先建構的 LookML 資料模型)。Looker 模塊可輕鬆整合至消費者託管的資訊主頁。
機器學習模型
在資料領域工作的團隊對資料有深入的瞭解和知識,因此通常最適合建構及維護以領域資料訓練的機器學習模型。這些機器學習模型可透過多種不同的介面公開,包括:
- BigQuery ML 模型可部署在專屬資料集,並與資料消費者共用,用於 BigQuery 批次預測。
- BigQuery ML 模型可匯出至 Gemini Enterprise Agent Platform,用於線上預測。
使用介面的資料位置考量
資料產生者為資料產品定義使用介面時,資料位置是一項重要考量。一般來說,為盡可能降低費用,資料應在儲存的區域中處理。這種做法有助於避免產生跨區域資料輸出費用。這種做法的資料消耗延遲時間也最低。基於上述原因,儲存在多區域 BigQuery 位置的資料,通常最適合做為資料產品公開。
不過,基於效能考量,儲存在 Cloud Storage 並透過 BigLake 資料表或直接讀取 API 公開的資料,應儲存在區域 bucket 中。
如果某項產品中公開的資料位於某個區域,且需要與另一個區域中另一個網域的資料彙整,資料消費者必須考量下列限制:
不支援使用 BigQuery SQL 的跨區域查詢。如果資料的主要使用方式是 BigQuery SQL,則查詢中的所有資料表都必須位於相同位置。
BigQuery 固定費率承諾使用合約為區域性。如果專案在某個區域僅使用固定費率承諾使用合約,但在另一個區域查詢資料產品,則適用隨選定價。
資料消費者可以使用直接讀取 API,從其他區域讀取資料。不過,您必須支付跨區域網路輸出費用,且資料消費者在移轉大量資料時,很可能會遇到延遲。
如果資料經常跨區域存取,可以複製到這些區域,降低產品消費者產生的查詢費用和延遲時間。例如,BigQuery 資料集可以複製到其他區域。不過,只有在必要時才應複製資料。建議資料生產者在複製資料時,只將部分可用的產品資料提供給多個區域。這種做法有助於盡可能縮短複製延遲時間,並降低成本。這種做法可能需要提供多個版本的消費介面,並明確指出資料位置區域。舉例來說,BigQuery 授權檢視表可以透過 sales_eu_v1 和 sales_us_v1 等命名方式公開。
使用 Pub/Sub 主題的資料串流介面不需要任何額外的複製邏輯,即可在與訊息儲存區域不同的區域中取用訊息。不過,在這種情況下,您必須支付額外的跨區域輸出費用。
向資料消費者公開使用介面
本節說明如何讓潛在消費者發現消費介面。Knowledge Catalog 是全代管服務,組織可使用這項服務提供資料探索和中繼資料管理服務。資料生產者必須讓資料產品的消費介面可供搜尋,並加上適當的中繼資料註解,讓產品消費者能以自助方式存取。
以下各節將說明如何將各介面類型定義為 Knowledge Catalog 項目。
以 BigQuery 為基礎的 SQL 介面
系統會自動為授權檢視表、BigLake 檢視表,以及可透過 Storage Read API 存取的 BigQuery 資料表,註冊技術中繼資料,例如完整資料表名稱或資料表結構定義。建議資料產生者在資料產品說明文件中提供額外資訊,協助資料消費者。舉例來說,為了協助使用者找到項目的產品說明文件,資料產生者可以將網址新增至已套用至項目的切面。製作人也可以提供下列資訊:
- 分群資料欄組合,應在查詢篩選器中使用。
- 如果欄位說明未提供類型,則為具有邏輯列舉類型的欄位列舉值。
- 支援與其他資料表彙整。
資料串流
Pub/Sub 主題會自動在 Knowledge Catalog 中註冊。不過,資料產生者必須在資料產品說明文件中描述結構定義。
Cloud Storage API
您可以使用 Knowledge Catalog 的自動探索功能,掃描 Cloud Storage bucket 中的資料,並擷取中繼資料及編入目錄。如果資料湖泊檔案集是由 Knowledge Catalog 管理,則檔案集也會自動在 Knowledge Catalog 中註冊。
其他介面
您可以建立自訂項目,新增 Knowledge Catalog 未內建支援的其他介面。
後續步驟
- 查看資料網格架構的參考實作。
- 進一步瞭解 BigQuery。
- 瞭解 Knowledge Catalog 。
- 如要查看更多參考架構、圖表和最佳做法,請瀏覽 Cloud Architecture Center。