


Uma plataforma de análise e gerenciamento de dados corporativos fornece um enclave em que é possível armazenar, analisar e manipular informações sensíveis, mantendo os controles de segurança. Use a arquitetura de malha de dados corporativa para implantar uma plataforma no Google Cloud para gerenciamento e análise de dados. A arquitetura foi projetada para funcionar em um ambiente híbrido, em que os componentes do Google Cloud interagem com os componentes e processos operacionais locais.
A arquitetura de malha de dados corporativos inclui o seguinte:
- Um repositório do GitHub que contém um conjunto de configurações, scripts e códigos do Terraform para criar o seguinte:
- Um projeto de governança que permite usar a implementação do Google do framework de controles de chave dos recursos de gerenciamento de dados do Cloud (CDMS, na sigla em inglês).
- Um exemplo de plataforma de dados que oferece suporte a fluxos de trabalho interativos e de produção.
- Um ambiente de produtor na plataforma de dados que oferece suporte a vários domínios de dados. Os domínios de dados são agrupamentos lógicos de elementos de dados.
- Um ambiente de consumidor na plataforma de dados que oferece suporte a vários projetos de consumidor.
- Um serviço de transferência de dados que usa a federação de identidade da carga de trabalho e a biblioteca de criptografia Tink para ajudar você a transferir dados para o Google Cloud de maneira segura.
- Um exemplo de domínio de dados que contém projetos de ingestão, não confidenciais e confidenciais.
- Um exemplo de sistema de acesso a dados que permite que os consumidores de dados solicitem acesso a conjuntos de dados e que os proprietários de dados concedam acesso a esses conjuntos de dados. O exemplo também inclui um gerenciador de fluxo de trabalho que altera as permissões do IAM desses conjuntos de dados de acordo.
- Um guia para a arquitetura, o design, os controles de segurança e os processos operacionais a serem implementados com o uso dessa arquitetura (este documento).
A arquitetura de malha de dados empresarial foi projetada para ser compatível com o blueprint de bases empresariais. O blueprint de bases empresariais fornece vários serviços de nível básico de que essa arquitetura depende, como redes VPC e geração de registros. É possível implantar essa arquitetura sem implantar o blueprint de bases empresariais se o ambiente do Google Cloud fornecer a funcionalidade necessária.
Este documento é destinado a arquitetos de nuvem, cientistas de dados, engenheiros de dados e arquitetos de segurança que podem usar a arquitetura para criar e implantar serviços de dados abrangentes no Google Cloud. Neste documento,pressupomos que você conhece os conceitos de malhas de dados, Google Cloud serviços de dados e a implementação do framework do CDMC no Google Cloud .
Arquitetura
A arquitetura de malha de dados corporativa usa uma abordagem em camadas para fornecer os recursos que permitem a ingestão de dados, o tratamento de dados e a governança. A arquitetura precisa ser implantada e controlada por um fluxo de trabalho de CI/CD. O diagrama a seguir mostra como a camada de dados implantada por essa arquitetura se relaciona com outras camadas no seu ambiente.
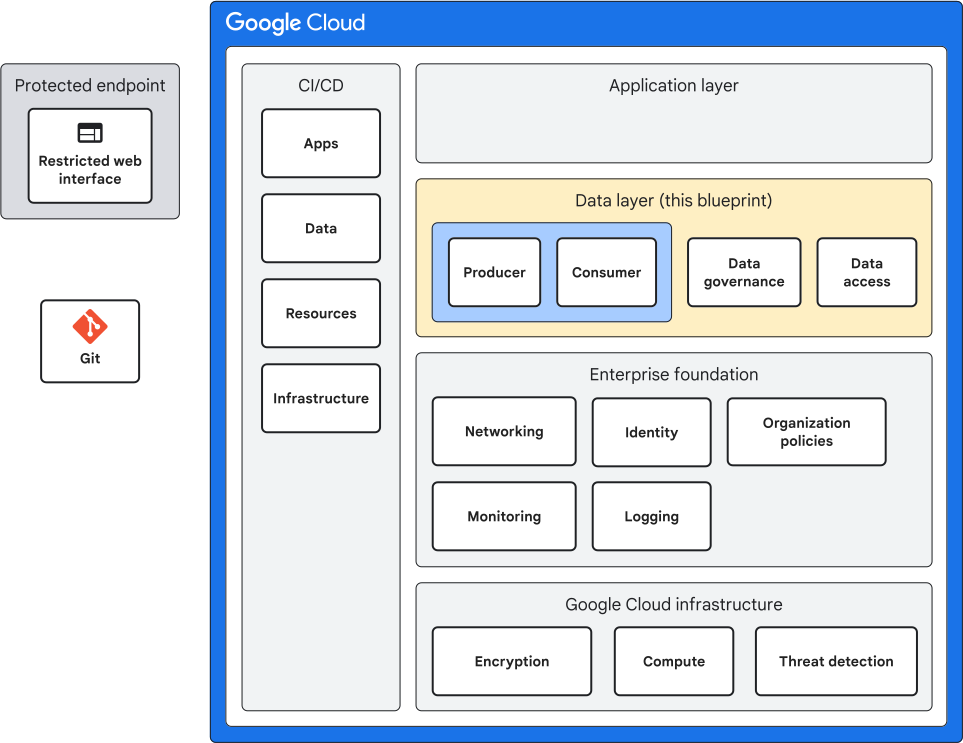
O diagrama inclui os seguintes pontos:
- A infraestrutura doGoogle Cloud fornece recursos de segurança, como criptografia em repouso e criptografia em trânsito, além de elementos básicos, como computação e armazenamento.
- A base empresarial fornece uma referência de recursos, como sistemas de identidade, rede, geração de registros, monitoramento e implantação, que permitem a adoção do Google Cloud para suas cargas de trabalho de dados.
- A camada de dados oferece várias competências, como ingestão de dados, repositório de dados, controle de acesso aos dados, governança de dados, monitoramento e compartilhamento de dados pessoais.
- A camada do aplicativo representa vários aplicativos diferentes que usam os recursos da camada de dados.
- A CI/CD fornece as ferramentas para automatizar o provisionamento, a configuração, o gerenciamento e a implantação de infraestrutura, fluxos de trabalho e componentes de software. Esses componentes ajudam a garantir implantações consistentes, confiáveis e auditáveis, minimizar erros manuais e acelerar o ciclo de desenvolvimento geral.
Para mostrar como o ambiente de dados é usado, a arquitetura inclui um fluxo de trabalho de dados de amostra. O fluxo de trabalho de dados de amostra orienta você pelos seguintes processos: governança de dados, ingestão de dados, tratamento de dados, compartilhamento de dados pessoais e consumo de dados.
Principais decisões de arquitetura
A tabela a seguir resume as decisões de alto nível da arquitetura.
| arearea de decisão | Decisão |
|---|---|
| Arquitetura doGoogle Cloud | |
Hierarquia de recursos |
A arquitetura usa a hierarquia de recursos do blueprint de bases empresariais. |
Rede |
A arquitetura inclui um exemplo de serviço de transferência de dados que usa a federação de identidade da carga de trabalho e uma biblioteca Tink. |
Papéis e permissões do IAM |
A arquitetura inclui papéis segmentados de produtor de dados, consumidor de dados, governança de dados e plataforma de dados. |
| Serviços de dados comuns | |
Metadados |
A arquitetura usa o Knowledge Catalog para gerenciar metadados de dados. |
Gerenciamento central de políticas |
Para gerenciar políticas, a arquitetura usa a implementação do framework CDMC do Google Cloud. |
Gerenciamento de acesso aos dados |
Para controlar o acesso aos dados, a arquitetura inclui um processo independente que exige que os consumidores de dados solicitem acesso aos recursos de dados do proprietário dos dados. |
Qualidade dos dados |
A arquitetura usa o Cloud Data Quality Engine para definir e executar regras de qualidade de dados em colunas de tabela especificadas, medindo a qualidade dos dados com base em métricas como correção e integridade. |
Segurança de dados |
A arquitetura usa controles de inclusão de tags, criptografia, mascaramento, tokenização e IAM para garantir segurança de dados. |
| Domínio de dados | |
Ambientes de dados |
A arquitetura inclui três ambientes. Dois ambientes (não produção e produção) são ambientes operacionais orientados por pipelines. Um ambiente (desenvolvimento) é interativo. |
Proprietários de dados |
Os proprietários de dados ingerem, processam, expõem e concedem acesso a recursos de dados. |
Consumidores de dados |
Os consumidores de dados solicitam acesso aos recursos de dados. |
| Integração e operações | |
Pipelines |
A arquitetura usa os seguintes pipelines para implantar recursos:
|
Repositórios |
Cada pipeline usa um repositório separado para permitir a segregação de responsabilidade. |
Fluxo de processo |
O processo exige que as mudanças no ambiente de produção incluam um remetente e um aprovador. |
| Operações do Cloud | |
Visão geral dos produtos de dados |
O mecanismo de relatórios gera visões gerais dos produtos de dados. |
Cloud Logging |
A arquitetura usa a infraestrutura de geração de registros do blueprint de bases empresariais. |
Cloud Monitoring |
A arquitetura usa a infraestrutura de monitoramento do blueprint de bases empresariais. |
Identidade: como mapear papéis para grupos
A malha de dados aproveita a arquitetura de gerenciamento do ciclo de vida de identidade, autorização e autenticação do blueprint de bases empresariais. Os usuários não recebem papéis diretamente. Em vez disso, os grupos são o principal método de atribuição de papéis e permissões no IAM. Os papéis e as permissões do IAM são atribuídos durante a criação do projeto por meio do pipeline de base.
A malha de dados associa grupos a uma das quatro áreas principais: infraestrutura, governança de dados, produtores de dados baseados em domínio e consumidores baseados em domínio.
Os escopos de permissão para esses grupos são os seguintes:
- O escopo de permissão do grupo de infraestrutura é a malha de dados como um todo.
- O escopo de permissão dos grupos de governança de dados é o projeto de governança de dados.
- As permissões de produtores e consumidores baseados em domínio têm como escopo o domínio de dados.
As tabelas a seguir mostram os vários papéis usados nesta implementação de malha de dados e as permissões associadas.
Infraestrutura
| Grupo | Descrição | Papéis |
|---|---|---|
|
Administradores gerais da malha de dados |
|
Governança de dados
| Grupo | Descrição | Papéis |
|---|---|---|
|
Administradores do projeto de governança de dados |
|
|
Desenvolvedores que criam e mantêm os componentes de governança de dados |
Vários papéis no projeto de governança de dados, incluindo
|
|
Leitores de informações de governança de dados |
|
|
Administradores de segurança do projeto de governança |
|
|
Grupo com permissão para usar tipos de aspecto |
|
|
Grupo com permissão para usar tipos de aspecto e adicionar aspectos |
|
|
Grupo de contas de serviço para notificações do Security Command Center |
Nenhuma. Esse é um grupo para associação, e uma conta de serviço é criada com esse nome, que tem as permissões necessárias. |
Produtores de dados baseados em domínio
| Grupo | Descrição | Papéis |
|---|---|---|
|
Administradores de um domínio de dados específico |
|
|
Desenvolvedores que criam e mantêm produtos de dados em um domínio de dados |
Vários papéis no projeto de domínio de dados, incluindo
|
|
Leitores das informações do domínio de dados |
|
|
Editores de entradas do Knowledge Catalog |
Papéis para editar entradas do Knowledge Catalog |
|
Gestores de dados do domínio de dados |
Papéis para gerenciar metadados e aspectos de governança de dados |
Consumidores de dados baseados em domínio
| Grupo | Descrição | Papéis |
|---|---|---|
|
Administradores de um projeto de consumidor específico |
|
|
Desenvolvedores trabalhando em um projeto de consumidor |
Vários papéis no projeto do consumidor, incluindo
|
|
Leitores das informações do projeto do consumidor |
|
Estrutura da organização
Para diferenciar as operações de produção dos dados de produção, a arquitetura usa ambientes diferentes para desenvolver e lançar fluxos de trabalho. As operações de Production incluem a governança, a rastreabilidade e a repetibilidade de um fluxo de trabalho e a auditabilidade dos resultados do fluxo de trabalho. Dados de Production refere-se a dados possivelmente sensíveis que você precisa para administrar sua organização. Todos os ambientes são projetados para ter controles de segurança que permitem ingerir e operar seus dados.
Para ajudar cientistas e engenheiros de dados, a arquitetura inclui um ambiente interativo, em que os desenvolvedores podem trabalhar diretamente com o ambiente e adicionar serviços por meio de um catálogo selecionado de soluções. Os ambientes operacionais são orientados por pipelines que têm arquitetura e configuração codificadas.
Essa arquitetura usa a estrutura organizacional do blueprint de bases empresariais como base para implantar cargas de trabalho de dados. O diagrama a seguir mostra as pastas e os projetos de nível superior usados na arquitetura de malha de dados corporativos.
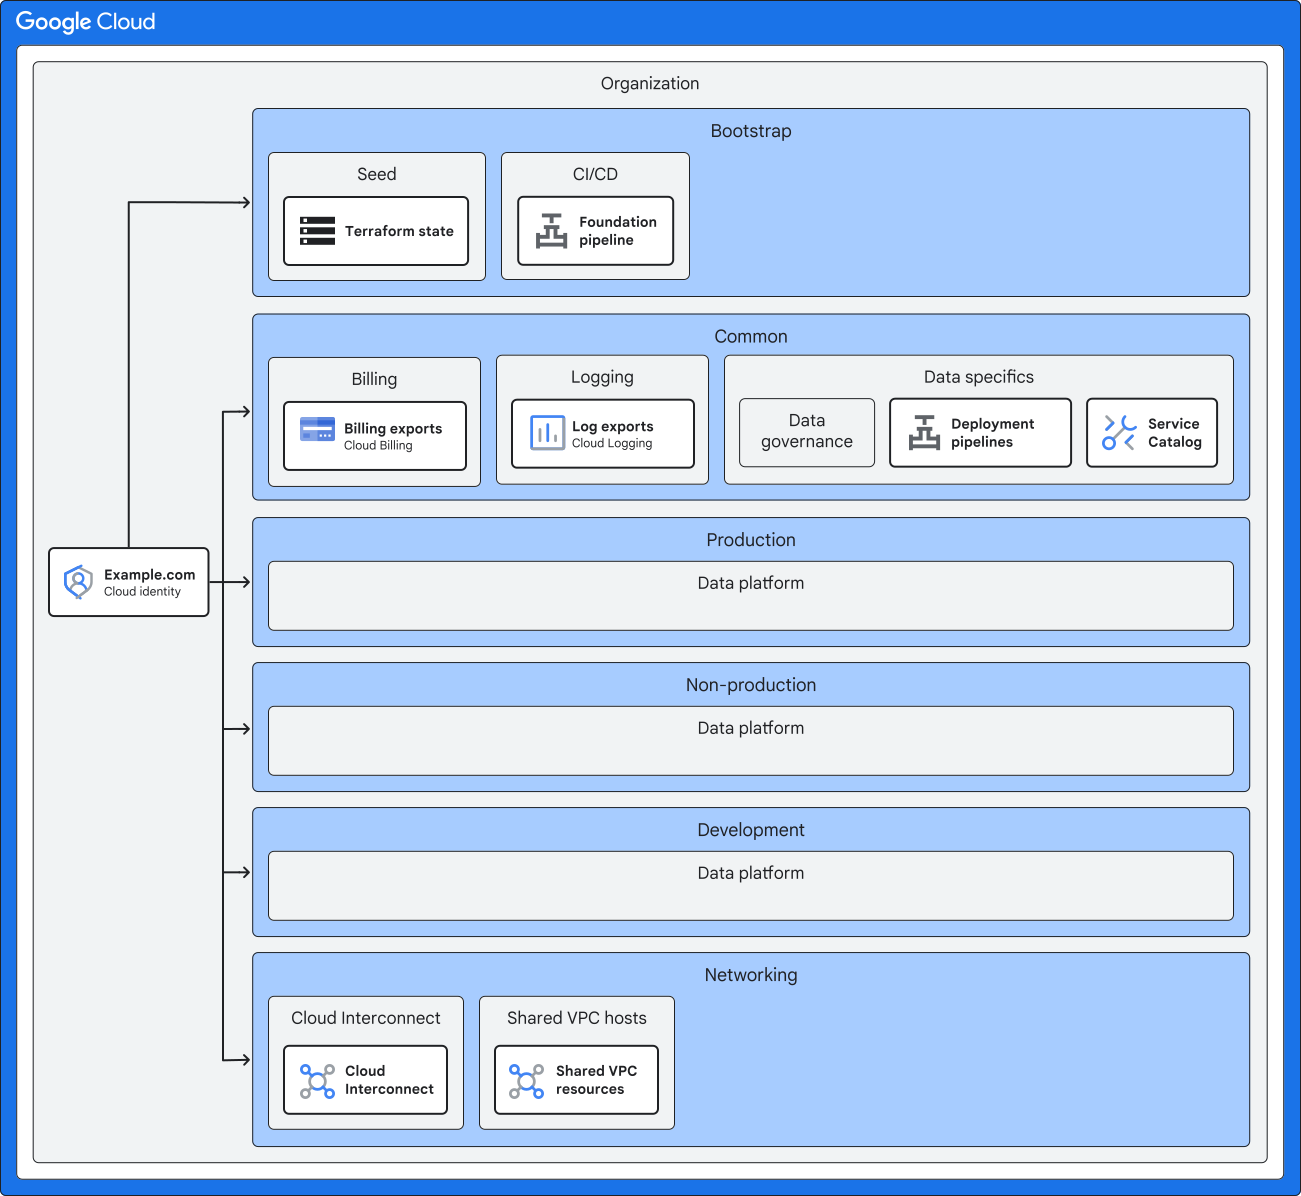
A tabela a seguir descreve as pastas e os projetos de nível superior que fazem parte da arquitetura.
| Pasta | Componente | Descrição |
|---|---|---|
|
|
Contém o pipeline de implantação usado para criar os artefatos de código da arquitetura. |
|
Contém a infraestrutura usada pelo catálogo de serviços para implantar recursos no ambiente interativo. |
|
|
Contém todos os recursos usados pela implementação do framework CDMC do Google Cloud. |
|
|
|
Contém os projetos e recursos da plataforma de dados para desenvolver casos de uso no modo interativo. |
|
|
Contém os projetos e recursos da plataforma de dados para testar casos de uso que você quer implantar em um ambiente operacional. |
|
|
Contém os projetos e recursos da plataforma de dados para implantação na produção. |
Pasta da plataforma de dados
A pasta da plataforma de dados contém todos os componentes do plano de dados e alguns dos recursos do CDMC. Além disso, a pasta da plataforma de dados e o projeto de governança de dados contêm os recursos do CDMC. O diagrama a seguir mostra as pastas e os projetos implantados na pasta da plataforma de dados.
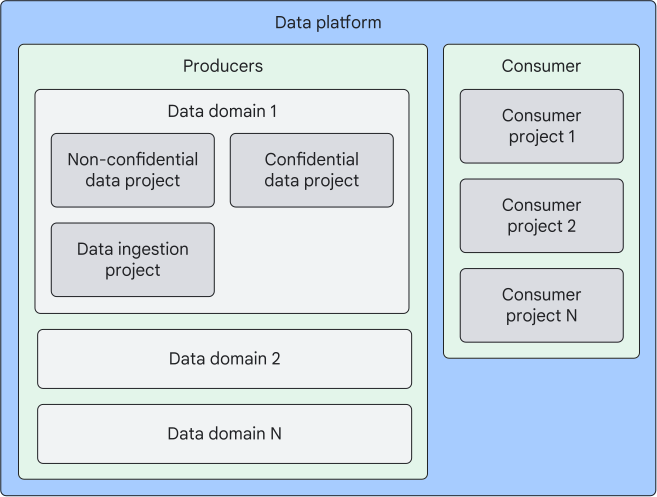
Cada pasta da plataforma de dados inclui uma pasta de ambiente (produção, não produção e desenvolvimento). A tabela a seguir descreve as pastas dentro de cada pasta da plataforma de dados.
| Pastas | Descrição |
|---|---|
Produtores |
Contém os domínios de dados. |
Consumidores |
Contém os projetos de consumidor. |
Domínio de dados |
Contém os projetos associados a um domínio específico. |
Pasta de produtores
Cada pasta de produtores inclui um ou mais domínios de dados. Um domínio de dados se refere a um agrupamento lógico de elementos de dados que compartilham um significado, propósito ou contexto de negócios comum. Os domínios de dados permitem categorizar e organizar recursos de dados em uma organização. O diagrama a seguir mostra a estrutura de um domínio de dados. A arquitetura implanta projetos na pasta da plataforma de dados para cada ambiente.
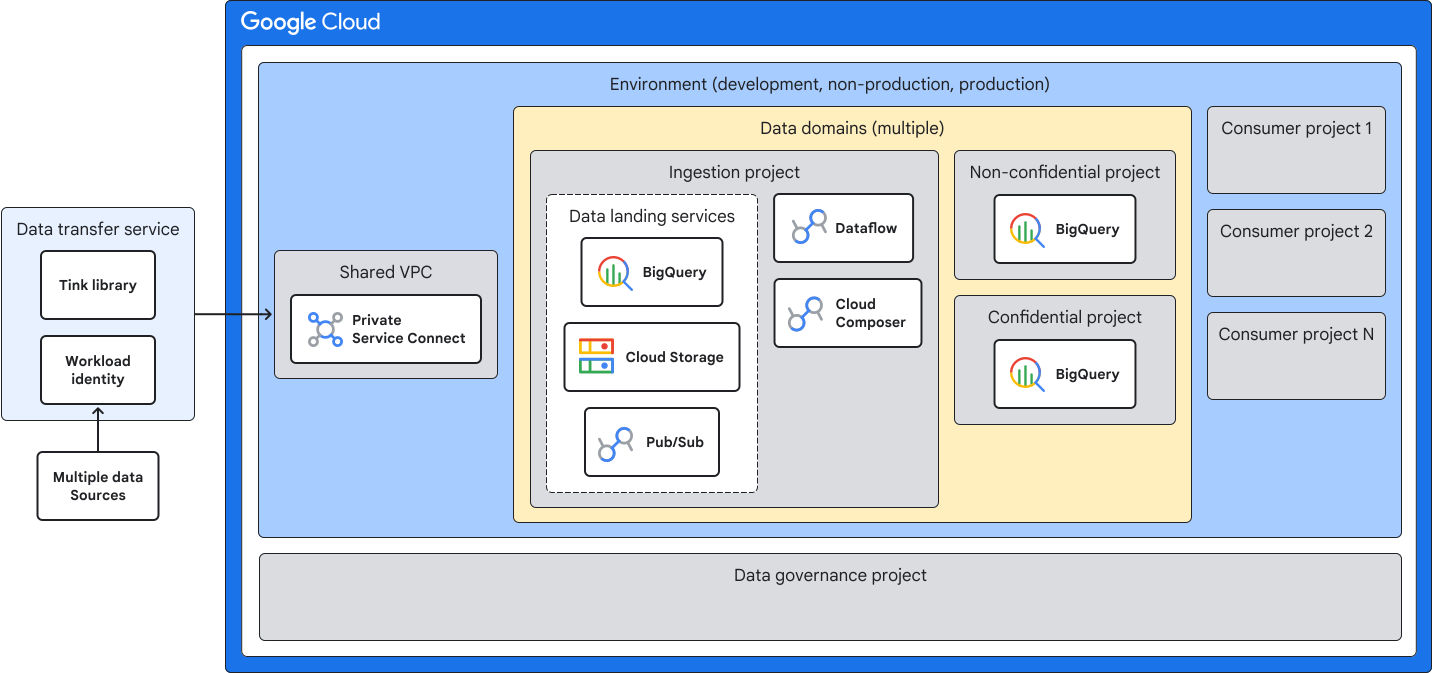
A tabela a seguir descreve os projetos implantados na pasta da plataforma de dados para cada ambiente.
| Projeto | Descrição |
|---|---|
Ingestão |
O projeto de ingestão ingere dados no domínio de dados. A arquitetura fornece exemplos de como transmitir dados para o BigQuery, o Cloud Storage e o Pub/Sub. O projeto de ingestão também contém exemplos do Dataflow e do Serviço Gerenciado para Apache Airflow que podem ser usados para orquestrar a transformação e o movimento dos dados ingeridos. |
Não confidencial |
O projeto não confidencial contém dados que foram desidentificados. É possível mascarar, conteinerizar, criptografar, tokenizar ou ofuscar dados. Use tags de política para controlar como os dados são apresentados. |
Confidencial |
O projeto confidencial contém dados em texto simples. É possível controlar o acesso pelas permissões do IAM. |
Pasta do consumidor
A pasta do consumidor contém projetos do consumidor. Os projetos de consumidor fornecem um mecanismo para segmentar a base de usuários de dados com base no limite de confiança necessário. Cada projeto é atribuído a um grupo de usuários separado, e o grupo recebe acesso aos recursos de dados necessários projeto por projeto. É possível usar o projeto do consumidor para coletar, analisar e aumentar os dados do grupo.
Pasta comum
A pasta comum contém os serviços usados por diferentes ambientes e projetos. Nesta seção, descrevemos os recursos adicionados à pasta comum para ativar a malha de dados corporativos.
Arquitetura do CDMC
A arquitetura usa a arquitetura do CDMC para governança de dados. As funções de governança de dados residem no projeto de governança de dados na pasta comum. O diagrama a seguir mostra os componentes da arquitetura do CDMC. Os números no diagrama representam os principais controles abordados com os serviços do Google Cloud.

A tabela a seguir descreve os componentes da arquitetura do CDMC que a arquitetura de malha de dados corporativos usa.
| Componente do CDMC | Serviço doGoogle Cloud | Descrição |
|---|---|---|
| Componentes de acesso e ciclo de vida | ||
Gerenciamento de chaves |
Cloud KMS |
Um serviço que gerencia com segurança as chaves de criptografia que protegem dados sensíveis. |
Gerenciador de registros |
Cloud Run |
Um aplicativo que mantém registros abrangentes de atividades de tratamento de dados, garantindo que as organizações possam rastrear e auditar o uso de dados. |
Política de arquivamento |
BigQuery |
Uma tabela do BigQuery que contém a política de armazenamento de dados. |
Direitos |
BigQuery |
Uma tabela do BigQuery que armazena informações sobre quem pode acessar dados sensíveis. Essa tabela garante que apenas usuários autorizados possam acessar dados específicos com base nas funções e nos privilégios deles. |
| Componentes de verificação | ||
Perda de dados |
Proteção de Dados Sensíveis |
Serviço usado para inspecionar recursos em busca de dados sensíveis. |
Descobertas da DLP |
BigQuery |
Uma tabela do BigQuery que cataloga classificações de dados na plataforma de dados. |
Políticas |
BigQuery |
Uma tabela do BigQuery que contém práticas consistentes de governança de dados (por exemplo, tipos de acesso a dados). |
Exportação de faturamento |
BigQuery |
Uma tabela que armazena informações de custo exportadas do Cloud Billing para permitir a análise de métricas de custo associadas a recursos de dados. |
Cloud Data Quality Engine |
Cloud Run |
Um aplicativo que executa verificações de qualidade de dados para tabelas e colunas. |
Descobertas de qualidade de dados |
BigQuery |
Uma tabela do BigQuery que registra as discrepâncias identificadas entre as regras de qualidade de dados definidas e a qualidade real dos recursos de dados. |
| Componentes de relatórios | ||
Programador |
Cloud Scheduler |
Um serviço que controla quando o Cloud Data Quality Engine é executado e quando ocorre a inspeção da Proteção de Dados Sensíveis. |
Mecanismo de relatórios |
Cloud Run |
Um aplicativo que gera relatórios para ajudar a acompanhar e medir a adesão aos controles do framework do CDMC. |
Descobertas e recursos |
BigQuery e Pub/Sub |
Um relatório do BigQuery de discrepâncias ou inconsistências nos controles de gerenciamento de dados, como aspectos ausentes, classificações incorretas ou locais de armazenamento não compatíveis. |
Exportações de tags |
BigQuery |
Uma tabela do BigQuery que contém informações de aspecto extraídas do Knowledge Catalog. |
| Outros componentes | ||
Gerenciamento de políticas |
Serviço de política da organização |
Um serviço que define e aplica restrições sobre onde os dados podem ser armazenados geograficamente. |
Políticas de acesso com base em atributos |
Access Context Manager |
Um serviço que define e aplica políticas de acesso granulares e baseadas em atributos para que apenas usuários autorizados de locais e dispositivos permitidos possam acessar informações sensíveis. |
Metadados |
Knowledge Catalog |
Um serviço que armazena informações de metadados sobre as tabelas que estão em uso na malha de dados. |
Tag Engine |
Cloud Run |
Um aplicativo que adiciona aspectos a entradas de tabela do BigQuery no Knowledge Catalog. |
Relatórios do CDMC |
Data Studio |
Painéis que permitem que os analistas visualizem relatórios gerados pelos mecanismos de arquitetura do CDMC. |
Implementação do CDMC
A tabela a seguir descreve como a arquitetura implementa os controles de chave no framework do CDMC.
| Requisito de controle do CDMC | Implementação |
|---|---|
O mecanismo de relatórios detecta recursos de dados não compatíveis e publica as descobertas em um tópico do Pub/Sub. Essas descobertas também são carregadas no BigQuery para relatórios usando o Data Studio. |
|
A propriedade dos dados é estabelecida para dados migrados e gerados na nuvem |
O Knowledge Catalog captura automaticamente metadados técnicos do BigQuery. O Tag Engine aplica aspectos de metadados de negócios, como nome do proprietário e nível de sensibilidade, de uma tabela de referência, o que ajuda a garantir que todos os dados sensíveis sejam anotados com informações do proprietário para fins de conformidade. Esse processo automatizado ajuda a fornecer governança de dados e conformidade, identificando e rotulando dados sensíveis com as informações do proprietário apropriadas. |
A automação e o fornecimento de dados são regidos e apoiados pela automação |
O Knowledge Catalog classifica os recursos de dados anotando-os com
um aspecto que inclui uma flag |
Soberania de dados e movimentação de dados entre países são gerenciadas |
O Serviço de Política da Organização define as regiões de armazenamento permitidas para recursos de dados, e o Access Context Manager restringe o acesso com base na localização do usuário. O Knowledge Catalog armazena os locais de armazenamento aprovados como aspectos de metadados. O Report Engine compara esses aspectos com o local real dos recursos de dados no BigQuery e publica as discrepâncias como descobertas usando o Pub/Sub. O Security Command Center oferece uma camada extra de monitoramento gerando descobertas de vulnerabilidade se os dados forem armazenados ou acessados fora das políticas definidas. |
Os catálogos de dados são implementados, usados e interoperáveis. |
O Knowledge Catalog armazena e atualiza os metadados técnicos de todos os recursos de dados do BigQuery, criando um Data Catalog sincronizado continuamente. O Knowledge Catalog garante que todas as tabelas e visualizações novas ou modificadas sejam adicionadas imediatamente ao catálogo, mantendo um inventário atualizado dos recursos de dados. |
A Proteção de Dados Sensíveis inspeciona os dados do BigQuery e identifica tipos de informações sensíveis. Essas descobertas são classificadas com base em uma tabela de referência de classificação, e o nível de sensibilidade mais alto é atribuído como um aspecto no Knowledge Catalog nos níveis de coluna e tabela. O Tag Engine gerencia esse processo atualizando o Knowledge Catalog com aspectos de sensibilidade sempre que novos recursos de dados são adicionados ou os atuais são modificados. Esse processo garante uma classificação constantemente atualizada dos dados com base na sensibilidade, que pode ser monitorada e informada usando o Pub/Sub e ferramentas de relatórios integradas. |
|
Os direitos de dados são gerenciados, aplicados e rastreados |
As tags de política do BigQuery controlam o acesso a dados sensíveis no nível da coluna, garantindo que apenas usuários autorizados possam acessar dados específicos com base na tag de política atribuída. O IAM gerencia o acesso geral ao data warehouse, enquanto o Knowledge Catalog armazena as classificações de confidencialidade. Verificações regulares são realizadas para garantir que todos os dados confidenciais tenham tags de política correspondentes, com as discrepâncias relatadas usando o Pub/Sub para correção. |
O acesso, o uso e os resultados éticos dos dados são gerenciados |
Os contratos de compartilhamento de dados pessoais para provedores e consumidores são armazenados em um data warehouse dedicado do BigQuery para controlar as finalidades de consumo. O Knowledge Catalog rotula os recursos de dados com as informações do contrato do provedor, enquanto os contratos do consumidor são vinculados a vinculações do IAM para controle de acesso. Os rótulos de consulta aplicam finalidades de consumo, exigindo que os consumidores especifiquem uma finalidade válida ao consultar dados confidenciais, que é validada em relação aos direitos deles no BigQuery. Uma trilha de auditoria no BigQuery rastreia todo o acesso aos dados e garante a conformidade com os contratos de compartilhamento de dados pessoais. |
A criptografia em repouso padrão do Google ajuda a proteger os dados armazenados no disco. O Cloud KMS é compatível com chaves de criptografia gerenciadas pelo cliente (CMEK) para um gerenciamento de chaves aprimorado. O BigQuery implementa o mascaramento de dados dinâmicos no nível da coluna para desidentificação e oferece suporte à desidentificação no nível do aplicativo durante a ingestão de dados. O Knowledge Catalog armazena aspectos de metadados para técnicas de criptografia e desidentificação aplicadas a recursos de dados. As verificações automatizadas garantem que os métodos de criptografia e desidentificação estejam alinhados com as políticas de segurança predefinidas, com todas as discrepâncias relatadas como descobertas usando o Pub/Sub. |
|
Uma estrutura de privacidade de dados é definida e operacional |
O Knowledge Catalog anota recursos de dados sensíveis com aspectos que contêm informações relevantes para a avaliação de impacto, como localização do assunto e links de relatórios de avaliação. O Tag Engine aplica esses aspectos com base na sensibilidade dos dados e em uma tabela de políticas no BigQuery, que define os requisitos de avaliação com base na residência dos dados e do titular. Esse processo automatizado permite o monitoramento e a geração de relatórios contínuos de conformidade com os requisitos de avaliação de impacto, garantindo que as avaliações de impacto da proteção de dados (DPIAs, na sigla em inglês) ou as avaliações de impacto da proteção (PIAs, na sigla em inglês) sejam realizadas quando necessário. |
O Knowledge Catalog rotula os recursos de dados com políticas de retenção, especificando períodos de retenção e ações de expiração (como arquivamento ou limpeza). O Record Manager automatiza a aplicação dessas políticas ao limpar ou arquivar tabelas do BigQuery com base nos aspectos definidos. Essa aplicação garante a adesão às políticas de ciclo de vida dos dados e mantém a conformidade com os requisitos de retenção de dados, com todas as discrepâncias detectadas e informadas usando o Pub/Sub. |
|
O Cloud Data Quality Engine define e executa regras de qualidade de dados em colunas de tabela especificadas, medindo a qualidade dos dados com base em métricas como correção e integridade. Os resultados dessas verificações, incluindo porcentagens de sucesso e limites, são armazenados como aspectos no Knowledge Catalog. O armazenamento desses resultados permite o monitoramento e a geração de relatórios contínuos da qualidade dos dados, com problemas ou desvios dos limites aceitáveis publicados como descobertas usando o Pub/Sub. |
|
Os princípios de gerenciamento de custos são estabelecidos e aplicados |
O Knowledge Catalog armazena métricas relacionadas a custos para recursos de dados, como custos de consulta, armazenamento e saída de dados, que são calculados usando informações de faturamento exportadas do Cloud Billing para o BigQuery. O armazenamento de métricas relacionadas a custos permite o rastreamento e a análise abrangentes de custos, garantindo a adesão às políticas de custo e a utilização eficiente de recursos, com todas as anomalias relatadas usando o Pub/Sub. |
Os recursos integrados de linhagem de dados do Knowledge Catalog rastreiam a procedência e a linhagem dos recursos de dados, representando visualmente o fluxo de dados. Além disso, os scripts de ingestão de dados identificam e registram a fonte original dos dados como um aspecto no Knowledge Catalog, melhorando a rastreabilidade dos dados até a origem. |
Gerenciamento de acesso aos dados
O acesso da arquitetura aos dados é controlado por um processo independente que separa o controle operacional (por exemplo, a execução de jobs do Dataflow) do controle de acesso aos dados. O acesso de um usuário a um serviço do Google Cloud é definido por uma preocupação ambiental ou operacional e é provisionado e aprovado por um grupo de engenharia de nuvem. O acesso de um usuário aos recursos de dados do Google Cloud (por exemplo, uma tabela do BigQuery) é uma preocupação de privacidade, regulamentação ou governança e está sujeito a um contrato de acesso entre as partes produtoras e consumidoras e controlado pelos processos a seguir. O diagrama a seguir mostra como o acesso aos dados é provisionado pela interação de diferentes componentes de software.
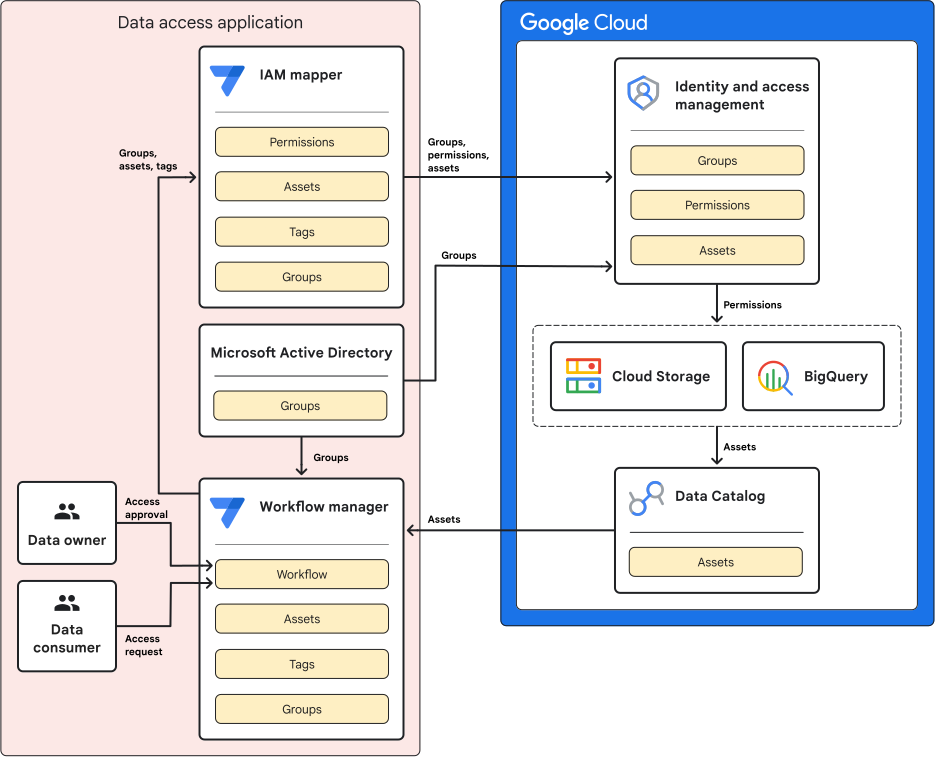
Conforme mostrado no diagrama anterior, a integração dos acessos de dados é processada pelos seguintes processos:
- Os recursos de dados em nuvem são coletados e inventariados pelo Knowledge Catalog.
- O gerenciador de fluxo de trabalho recupera os recursos de dados do Knowledge Catalog.
- Os proprietários de dados são integrados ao gerenciador de fluxo de trabalho.
A operação do gerenciamento de acesso aos dados é a seguinte:
- Um consumidor de dados faz uma solicitação para um recurso específico.
- O proprietário dos dados do recurso é alertado sobre a solicitação.
- O proprietário dos dados aprova ou rejeita a solicitação.
- Se a solicitação for aprovada, o gerenciador de fluxo de trabalho transmitirá o grupo, o recurso e a tag associada ao mapeador do IAM.
- O mapeador do IAM traduz as tags do gerenciador de fluxo de trabalho em permissões do IAM e concede ao grupo especificado permissões do IAM para o recurso de dados.
- Quando um usuário quer acessar o recurso de dados, o IAM avalia o acesso ao recurso Google Cloud com base nas permissões do grupo.
- Se permitido, o usuário acessa o recurso de dados.
Rede
O processo de segurança de dados é iniciado no aplicativo de origem, que pode estar no local ou em outro ambiente externo ao projeto de destino do Google Cloud . Antes de qualquer transferência de rede, esse aplicativo usa a federação de identidade da carga de trabalho para se autenticar com segurança nas APIs do Cloud. Usando essas credenciais, ele interage com o Cloud KMS para receber ou encapsular as chaves necessárias e, em seguida, emprega a biblioteca Tink para realizar a criptografia e a desidentificação iniciais no payload de dados sensíveis de acordo com modelos predefinidos.
Depois que o payload de dados estiver protegido, ele precisará ser transferido com segurança para o projeto de ingestão do Google Cloud . Para aplicativos locais, use o Cloud Interconnect ou o Cloud VPN. Na rede Google Cloud , use o Private Service Connect para rotear os dados para o endpoint de ingestão na rede VPC do projeto de destino. O Private Service Connect permite que o aplicativo de origem se conecte às APIs do Google usando endereços IP privados, garantindo que o tráfego não seja exposto à Internet.
Todo o caminho de rede e os serviços de ingestão de destino (Cloud Storage, BigQuery e Pub/Sub) no projeto de ingestão são protegidos por um perímetro do VPC Service Controls. Esse perímetro impõe um limite de segurança, garantindo que os dados protegidos provenientes da origem só possam ser ingeridos nos serviços autorizados do Google Cloud dentro desse projeto específico.
Logging
Essa arquitetura usa os recursos do Cloud Logging fornecidos pelo blueprint de bases empresariais.
Pipelines
A arquitetura de malha de dados empresarial usa uma série de pipelines para provisionar a infraestrutura, a orquestração, os conjuntos de dados, os pipelines de dados e os componentes de aplicativo. Os pipelines de implantação de recursos da arquitetura usam o Terraform como a ferramenta de infraestrutura como código (IaC) e o Cloud Build como o serviço de CI/CD para implantar as configurações do Terraform no ambiente da arquitetura. O diagrama a seguir mostra a relação entre os pipelines.
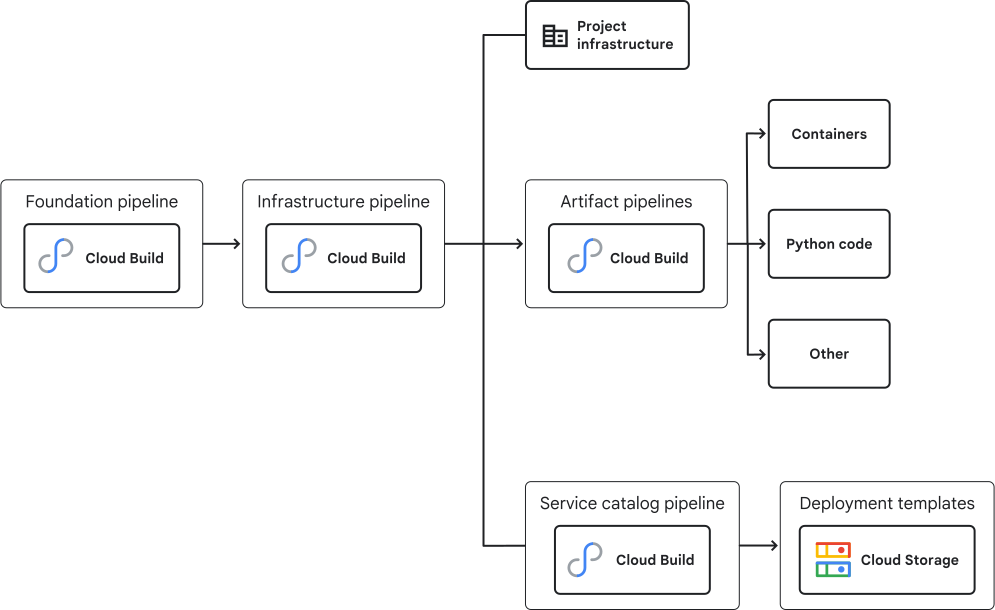
O pipeline de base e o pipeline de infraestrutura fazem parte do blueprint de bases empresariais. A tabela a seguir descreve a finalidade dos pipelines e os recursos que eles provisionam.
| Pipeline | Provisionado por | Recursos |
|---|---|---|
Pipeline de base |
Inicializar |
|
Pipeline de infraestrutura |
Pipeline de base |
|
Pipeline do catálogo de serviços |
Pipeline de infraestrutura |
|
Pipelines de artefatos |
Pipeline de infraestrutura |
Os pipelines de artefatos produzem os vários contêineres e outros componentes da base de código usada pela malha de dados. |
Cada pipeline tem o próprio conjunto de repositórios de onde extrai código e arquivos de configuração. Cada repositório tem uma segregação de funções em que os remetentes e as aprovações de implantações de código operacional são responsabilidades de grupos diferentes.
Implantação interativa pelo catálogo de serviços
Os ambientes interativos são o ambiente de desenvolvimento dentro da arquitetura e existem na pasta de desenvolvimento. A interface principal do ambiente interativo é o catálogo de serviços, que permite que os desenvolvedores usem modelos pré-configurados para instanciar os serviços do Google. Esses modelos pré-configurados são conhecidos como modelos de serviço. Os modelos de serviço ajudam a aplicar sua postura de segurança, como tornar a criptografia CMEK obrigatória, e também impedem que os usuários tenham acesso direto às APIs do Google.
O diagrama a seguir mostra os componentes do ambiente interativo e como os cientistas de dados implantam recursos.
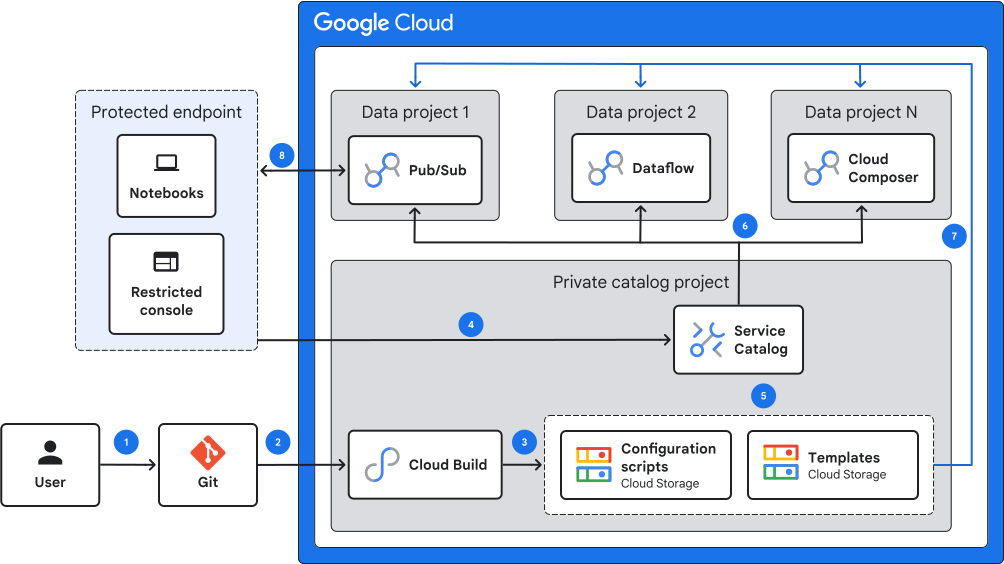
Para implantar recursos usando o catálogo de serviços, as seguintes etapas ocorrem:
- O engenheiro de MLOps coloca um modelo de recurso do Terraform para o Google Cloud em um repositório Git.
- O comando Git Commit aciona um pipeline do Cloud Build.
- O Cloud Build copia o modelo e todos os arquivos de configuração associados para o Cloud Storage.
- O engenheiro de MLOps configura manualmente as soluções e o catálogo de serviços. Em seguida, o engenheiro compartilha o catálogo de serviços com um projeto de serviço no ambiente interativo.
- O cientista de dados seleciona um recurso do catálogo de serviços.
- O catálogo de serviços implanta o modelo no ambiente interativo.
- O recurso extrai todos os scripts de configuração necessários.
- O cientista de dados interage com os recursos.
Pipelines de artefatos
O processo de ingestão de dados usa o Airflow gerenciado e o Dataflow para orquestrar a movimentação e a transformação de dados no domínio de dados. O pipeline de artefatos cria todos os recursos necessários para a ingestão de dados e os move para o local apropriado para que os serviços os acessem. O pipeline de artefatos cria os artefatos de contêiner que o orquestrador usa.
Controles de segurança
A arquitetura de malha de dados empresarial usa um modelo de segurança de defesa em profundidade em camadas que inclui recursos padrão do Google Cloud , serviços do Google Cloude recursos de segurança configurados pelo blueprint de bases empresariais. Veja no diagrama a seguir as camadas dos vários controles de segurança da arquitetura.
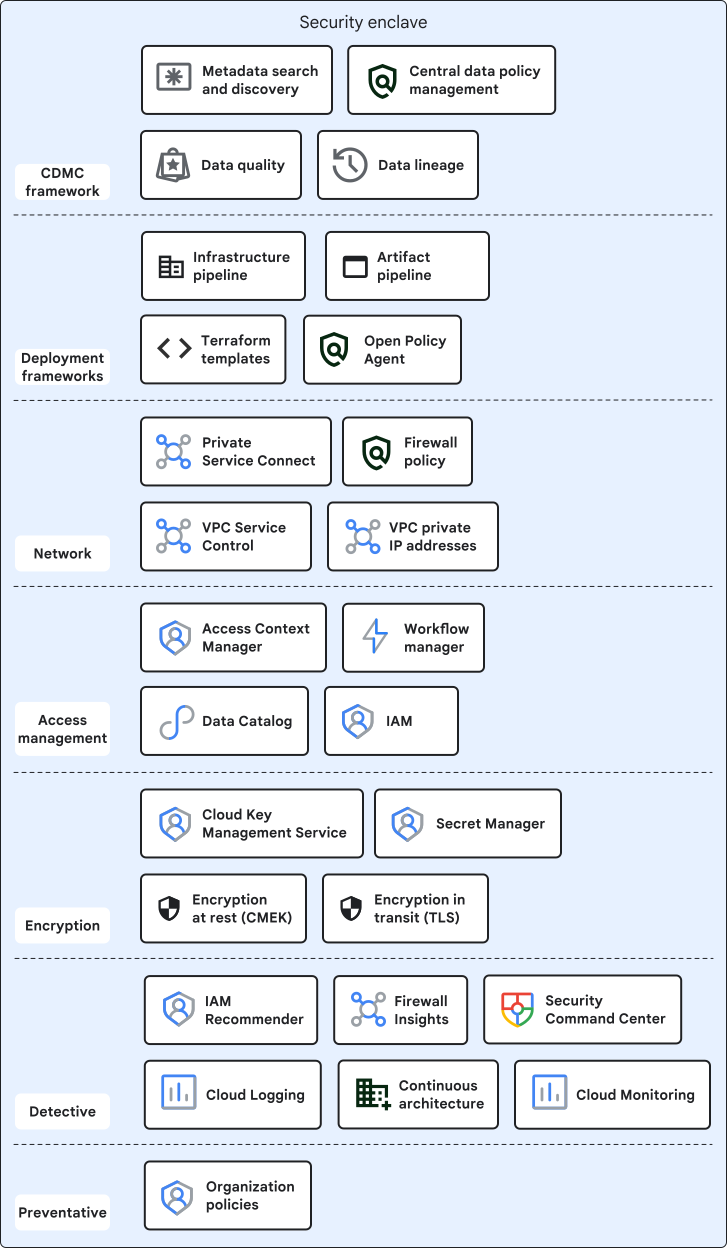
A tabela a seguir descreve os controles de segurança associados aos recursos em cada camada.
| Camada | Recurso | Controle de segurança |
|---|---|---|
Framework do CDMC |
Google Cloud Implementação do CDMC |
Oferece um framework de governança que ajuda a proteger, gerenciar e controlar seus recursos de dados. Consulte a estrutura de controles de chave do CDMC para mais informações. |
Implantação |
Pipeline de infraestrutura |
Fornece uma série de pipelines que implantam infraestrutura, criam contêineres e criam pipelines de dados. O uso de pipelines permite auditabilidade, rastreabilidade e repetibilidade. |
Pipeline de artefatos |
Implanta vários componentes que não são implantados pelo pipeline de infraestrutura. |
|
Modelos do Terraform |
Cria a infraestrutura do sistema. |
|
Open Policy Agent |
Ajuda a garantir que a plataforma esteja em conformidade com as políticas selecionadas. |
|
Rede |
Private Service Connect |
Oferece proteções contra exfiltração de dados em torno dos recursos de arquitetura na camada da API e da camada IP. Permite que você se comunique com as APIs do Cloud usando endereços IP particulares para evitar a exposição do tráfego à internet. |
Rede VPC com endereços IP privados |
Ajuda a remover a exposição a ameaças voltadas para a Internet. |
|
VPC Service Controls |
Ajuda a proteger recursos sensíveis contra a exfiltração de dados. |
|
Firewall |
Ajuda a proteger a rede VPC contra acesso não autorizado. |
|
Gerenciamento de acesso |
Access Context Manager |
Controla quem pode acessar quais recursos e ajuda a evitar o uso não autorizado deles. |
Federação de identidade da carga de trabalho |
Elimina a necessidade de credenciais externas para transferir dados de ambientes locais para a plataforma. |
|
Knowledge Catalog |
Fornece um índice de recursos disponíveis para os usuários. |
|
IAM |
Dá acesso refinado. |
|
Criptografia |
Cloud KMS |
Permite gerenciar as chaves de criptografia e os secrets, além de ajudar a proteger os dados com criptografia em repouso e em trânsito. |
Secrets Manager |
Oferece um armazenamento de secrets para pipelines controlado pelo IAM. |
|
Criptografia em repouso |
Por padrão,o Google Cloud criptografa os dados em repouso. |
|
Criptografia em trânsito |
Por padrão,o Google Cloud criptografa dados em trânsito. |
|
Detecção |
Security Command Center |
Ajuda a detectar configurações incorretas e atividades maliciosas na sua organização do Google Cloud. |
Arquitetura contínua |
Verifica continuamente sua organização do Google Cloud em relação a uma série de políticas do OPA definidas por você. |
|
Recomendador do IAM |
Analisa as permissões do usuário e fornece sugestões sobre como reduzir as permissões para ajudar a aplicar o princípio de privilégio mínimo. |
|
Firewall Insights |
Analisa regras de firewall, identifica regras de firewall excessivamente permissivas e sugere firewalls mais restritivos para ajudar a fortalecer sua postura geral de segurança. |
|
Cloud Logging |
Fornece visibilidade sobre a atividade do sistema e ajuda a ativar a detecção de anomalias e atividades maliciosas. |
|
Cloud Monitoring |
Monitora os principais indicadores e eventos que podem ajudar a identificar atividades suspeitas. |
|
Preventivo |
Política da organização |
Permite controlar e restringir ações na sua organização do Google Cloud. |
Workflows
As seções a seguir descrevem o fluxo de trabalho do produtor de dados e o fluxo de trabalho do consumidor de dados, garantindo controles de acesso adequados com base na sensibilidade dos dados e nos papéis do usuário.
Fluxo de trabalho do produtor de dados
O diagrama a seguir mostra como os dados são protegidos quando são transferidos para o BigQuery.
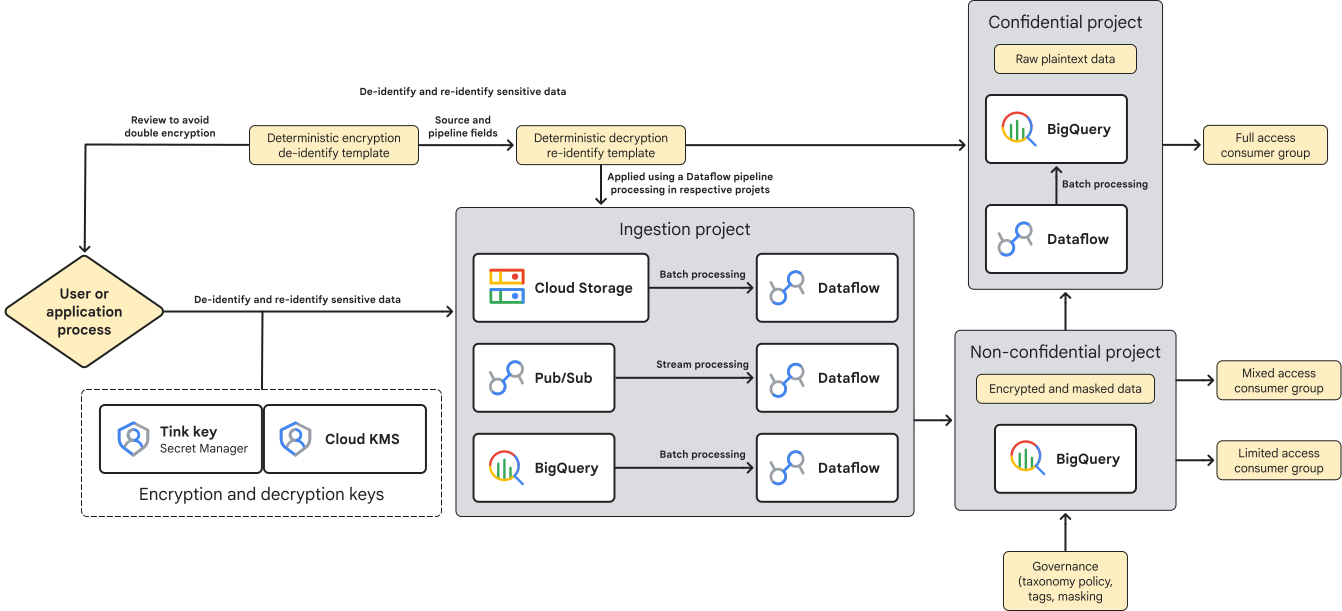
O fluxo de trabalho para transferência de dados é o seguinte:
- Um aplicativo integrado à federação de identidade da carga de trabalho usa o Cloud KMS para descriptografar uma chave de criptografia encapsulada.
- O aplicativo usa a biblioteca Tink para desidentificar ou criptografar os dados usando um modelo.
- O aplicativo transfere dados para o projeto de ingestão em Google Cloud.
- Os dados chegam ao Cloud Storage, ao BigQuery ou ao Pub/Sub.
- No projeto de ingestão, os dados são descriptografados ou reidentificados usando um modelo.
- Os dados descriptografados são criptografados ou mascarados com base em outro modelo de desidentificação e, em seguida, colocados no projeto não confidencial. Os aspectos e as tags de política são aplicados pelo Tag Engine conforme apropriado.
- Os dados do projeto não confidencial são transferidos para o projeto confidencial e identificados novamente.
O seguinte acesso aos dados é permitido:
- Os usuários que têm acesso ao projeto confidencial podem acessar todos os dados brutos em texto simples.
- Os usuários que têm acesso ao projeto não confidencial podem acessar dados mascarados, tokenizados ou criptografados com base nas tags de política associadas aos dados e às permissões deles.
Fluxo de trabalho do consumidor de dados
As etapas a seguir descrevem como um consumidor pode acessar dados armazenados no BigQuery.
- O consumidor de dados pesquisa recursos de dados usando o Knowledge Catalog.
- Depois que o consumidor encontra os recursos que está procurando, ele solicita acesso a eles.
- O proprietário dos dados decide se vai fornecer acesso aos recursos.
- Se o consumidor tiver acesso, ele poderá usar um notebook e o catálogo de soluções para criar um ambiente em que possa analisar e transformar os recursos de dados.
Resumo
O repositório do GitHub fornece instruções detalhadas sobre como implantar a malha de dados noGoogle Cloud depois de implantar a base empresarial. O processo para implantar a arquitetura envolve modificar os repositórios de infraestrutura existentes e implantar novos componentes específicos da malha de dados.
Preencha os campos:
- Conclua todos os pré-requisitos, incluindo os seguintes:
- Instale a Google Cloud CLI, o Terraform, o Tink, o Java e o Go.
- Implante o blueprint de bases empresariais (v4.1).
- Mantenha os seguintes repositórios locais:
gcp-data-mesh-foundationsgcp-bootstrapgcp-environmentsgcp-networksgcp-orggcp-projects
- Modifique o blueprint de base atual e implante os aplicativos de malha de dados. Para cada item, faça o seguinte:
- No repositório de destino, confira a ramificação
Plan. - Para adicionar componentes de malha de dados, copie os arquivos e diretórios relevantes de
gcp-data-mesh-foundationspara o diretório de base apropriado. Substitua os arquivos quando necessário. - Atualize as variáveis, os papéis e as configurações da malha de dados nos arquivos do Terraform (por exemplo,
*.tfvarse*.tf). Defina os tokens do GitHub como variáveis de ambiente. - Execute as operações de inicialização, planejamento e aplicação do Terraform em cada repositório.
- Confirme as mudanças, envie o código para o repositório remoto, crie solicitações de pull e mescle-as com os ambientes de desenvolvimento, não produção e produção.
- No repositório de destino, confira a ramificação
A seguir
- Leia sobre a arquitetura e as funções em uma malha de dados.
- Importar dados do Google Cloud para um data warehouse seguro do BigQuery.
- Implementar o framework de controles de chave do CDMC em um data warehouse do BigQuery.
- Leia sobre o blueprint de bases empresariais.