


Una piattaforma di gestione e analisi dei dati aziendali fornisce un'enclave in cui puoi archiviare, analizzare e manipolare informazioni sensibili mantenendo i controlli di sicurezza. Puoi utilizzare l'architettura mesh di dati aziendali per eseguire il deployment di una piattaforma su Google Cloud per la gestione e l'analisi dei dati. L'architettura è progettata per funzionare in un ambiente ibrido, in cui i componenti Google Cloud interagiscono con i componenti on-premise e i processi operativi esistenti.
L'architettura mesh di dati aziendali include quanto segue:
- Un repository GitHub che contiene un insieme di configurazioni, script e codice Terraform per creare quanto segue:
- Un progetto di governance che ti consente di utilizzare l'implementazione di Google del framework Cloud Data Management Capabilities (CDMS) Key Controls.
- Un esempio di piattaforma dati che supporta flussi di lavoro interattivi e di produzione.
- Un ambiente producer all'interno della piattaforma dati che supporta più domini di dati. I domini di dati sono raggruppamenti logici di elementi di dati.
- Un ambiente consumer all'interno della piattaforma di dati che supporta più progetti consumer.
- Un servizio di trasferimento dei dati che utilizza la federazione delle identità per i workload e la libreria di crittografia Tink per aiutarti a trasferire i dati in Google Cloud in modo sicuro.
- Un esempio di dominio di dati che contiene progetti di importazione, non riservati e riservati.
- Un esempio di sistema di accesso ai dati che consente ai consumer di dati di richiedere l'accesso ai set di dati e ai proprietari dei dati di concedere l'accesso a questi set di dati. L'esempio include anche un gestore del workflow che modifica di conseguenza le autorizzazioni IAM di questi set di dati.
- Una guida all'architettura, al design, ai controlli di sicurezza e ai processi operativi che utilizzi per implementare questa architettura (questo documento).
L'architettura di mesh di dati aziendali è progettata per essere compatibile con il progetto di base per le aziende. Il blueprint delle basi aziendali fornisce una serie di servizi di base su cui si basa questa architettura, come le reti VPC e il logging. Puoi eseguire il deployment di questa architettura senza eseguire il deployment del progetto di base aziendale se il tuo ambienteGoogle Cloud fornisce le funzionalità necessarie.
Questo documento è rivolto ad architetti cloud, data scientist, data engineer e architetti della sicurezza che possono utilizzare l'architettura per creare ed eseguire il deployment di servizi dati completi su Google Cloud. Questo documento presuppone che tu abbia familiarità con i concetti di mesh di dati, Google Cloudservizi di dati e l'implementazione del framework CDMC. Google Cloud
Architettura
L'architettura di mesh di dati aziendali adotta un approccio a livelli per fornire le funzionalità che consentono l'importazione dati, il trattamento dati e la governance. Il deployment e il controllo dell'architettura devono essere eseguiti tramite un workflow CI/CD. Il seguente diagramma mostra la relazione tra il livello dati di cui viene eseguito il deployment da questa architettura e gli altri livelli del tuo ambiente.

Questo diagramma include quanto segue:
- L'infrastruttura Google Cloud fornisce funzionalità di sicurezza come la crittografia at-rest e la crittografia in transito, oltre a componenti di base come computing e archiviazione.
- La base aziendale fornisce una serie di risorse di base, come sistemi di identità, networking, logging, monitoraggio e deployment, che ti consentono di adottare Google Cloud per i tuoi workload di dati.
- Il livello dati offre varie funzionalità, come l'importazione dati, il datastore, controllo dell'accesso ai dati, la governance dei dati, il monitoraggio dei dati e la condivisione dei dati.
- Il livello di applicazione rappresenta varie applicazioni diverse che utilizzano gli asset del livello di dati.
- CI/CD fornisce gli strumenti per automatizzare il provisioning, la configurazione, la gestione e il deployment di infrastrutture, workflow e componenti software. Questi componenti ti aiutano a garantire deployment coerenti, affidabili e verificabili, a ridurre al minimo gli errori manuali e ad accelerare il ciclo di sviluppo complessivo.
Per mostrare come viene utilizzato l'ambiente di dati, l'architettura include un flusso di lavoro dei dati di esempio. Il workflow dei dati campionati ti guida attraverso i seguenti processi: governance dei dati, importazione dati, trattamento dati, condivisione dei dati e consumo dei dati.
Decisioni chiave sull'architettura
La tabella seguente riassume le decisioni di alto livello dell'architettura.
| Area decisionale | Decisione |
|---|---|
| ArchitetturaGoogle Cloud | |
Gerarchia delle risorse |
L'architettura utilizza la gerarchia delle risorse del progetto della piattaforma aziendale. |
Networking |
L'architettura include un servizio di trasferimento di dati di esempio che utilizza la federazione delle identità per i workload e una libreria Tink. |
Ruoli e autorizzazioni IAM |
L'architettura include ruoli segmentati per produttori di dati, consumatori di dati, governance dei dati e piattaforme di dati. |
| Servizi dati comuni | |
Metadati |
L'architettura utilizza Knowledge Catalog per gestire i metadati dei dati. |
Gestione centralizzata delle policy |
Per gestire le policy, l'architettura utilizza l'implementazione del framework CDMC di Google Cloud. |
Gestione dell'accesso ai dati |
Per controllare l'accesso ai dati, l'architettura include un processo indipendente che richiede ai consumer di dati di richiedere l'accesso agli asset di dati al proprietario dei dati. |
Qualità dei dati |
L'architettura utilizza il motore di qualità dei dati di Cloud per definire ed eseguire regole di qualità dei dati su colonne di tabelle specificate, misurando la qualità dei dati in base a metriche come correttezza e completezza. |
Sicurezza dei dati |
L'architettura utilizza tagging, crittografia, mascheramento, tokenizzazione e controlli IAM per garantire la sicurezza dei dati. |
| Dominio di dati | |
Ambienti di dati |
L'architettura include tre ambienti. Due ambienti (non di produzione e di produzione) sono ambienti operativi gestiti da pipeline. Un ambiente (sviluppo) è un ambiente interattivo. |
Proprietari dei dati |
I proprietari dei dati importano, elaborano, espongono e concedono l'accesso agli asset di dati. |
Consumer di dati |
I consumer di dati richiedono l'accesso agli asset di dati. |
| Onboarding e operazioni | |
Pipeline |
L'architettura utilizza le seguenti pipeline per eseguire il deployment delle risorse:
|
Repository |
Ogni pipeline utilizza un repository separato per consentire la separazione delle responsabilità. |
Flusso del processo |
La procedura richiede che le modifiche all'ambiente di produzione includano un richiedente e un approvatore. |
| Cloud Operations | |
Prospetti dei prodotti di dati |
Il motore di report genera scorecard dei prodotti di dati. |
Cloud Logging |
L'architettura utilizza l'infrastruttura di logging del progetto di base per le aziende. |
Cloud Monitoring |
L'architettura utilizza l'infrastruttura di monitoraggio del progetto di base per le aziende. |
Identità: mappatura dei ruoli ai gruppi
Il mesh di dati sfrutta l'architettura esistente di gestione del ciclo di vita delle identità, autorizzazione e autenticazione del progetto di base aziendale. Agli utenti non vengono assegnati ruoli direttamente; i gruppi sono invece il metodo principale per assegnare ruoli e autorizzazioni in IAM. I ruoli e le autorizzazioni IAM vengono assegnati durante la creazione del progetto tramite la pipeline di base.
Il mesh di dati associa i gruppi a una delle quattro aree chiave: infrastruttura, governance dei dati, producer di dati basati su dominio e consumer basati su dominio.
Gli ambiti delle autorizzazioni per questi gruppi sono i seguenti:
- L'ambito delle autorizzazioni del gruppo di infrastruttura è il mesh di dati nel suo complesso.
- L'ambito delle autorizzazioni dei gruppi di governance dei dati è il progetto di governance dei dati.
- Le autorizzazioni dei producer e dei consumer basati su dominio hanno come ambito il loro dominio di dati.
Le tabelle seguenti mostrano i vari ruoli utilizzati in questa implementazione del mesh di dati e le relative autorizzazioni associate.
Infrastruttura
| Gruppo | Descrizione | Ruoli |
|---|---|---|
|
Amministratori generali del mesh di dati |
|
Governance dei dati
| Gruppo | Descrizione | Ruoli |
|---|---|---|
|
Amministratori del progetto di governance dei dati |
|
|
Sviluppatori che creano e gestiscono i componenti di governance dei dati |
Più ruoli nel progetto di governance dei dati, tra cui |
|
Lettori delle informazioni sulla governance dei dati |
|
|
Amministratori della sicurezza del progetto di governance |
|
|
Gruppo con l'autorizzazione per utilizzare i tipi di aspetto |
|
|
Gruppo con l'autorizzazione per utilizzare i tipi di aspetto e aggiungere aspetti |
|
|
Gruppo di service account per le notifiche di Security Command Center |
Nessuno. Questo è un gruppo per l'appartenenza e viene creato un account di servizio con questo nome, che dispone delle autorizzazioni necessarie. |
Produttori di dati basati sul dominio
| Gruppo | Descrizione | Ruoli |
|---|---|---|
|
Amministratori di un dominio di dati specifico |
|
|
Sviluppatori che creano e gestiscono prodotti di dati all'interno di un dominio di dati |
Più ruoli nel progetto del dominio di dati, tra cui |
|
Lettori delle informazioni sul dominio di dati |
|
|
Editor delle voci di Knowledge Catalog |
Ruoli per modificare le voci di Knowledge Catalog |
|
Data steward per il dominio di dati |
Ruoli per gestire i metadati e gli aspetti della governance dei dati |
Consumer di dati basati sul dominio
| Gruppo | Descrizione | Ruoli |
|---|---|---|
|
Amministratori di un progetto consumer specifico |
|
|
Sviluppatori che lavorano all'interno di un progetto consumer |
Più ruoli nel progetto consumer, tra cui |
|
Lettori delle informazioni sul progetto consumer |
|
Struttura dell'organizzazione
Per distinguere tra operazioni di produzione e dati di produzione, l'architettura utilizza ambienti diversi per sviluppare e rilasciare i flussi di lavoro. Le operazioni di produzione includono la governance, la tracciabilità e la ripetibilità di un workflow, nonché l'auditabilità dei risultati del workflow. I dati di produzione si riferiscono a dati potenzialmente sensibili necessari per gestire la tua organizzazione. Tutti gli ambienti sono progettati per disporre di controlli di sicurezza che ti consentono di importare e gestire i tuoi dati.
Per aiutare data scientist e ingegneri, l'architettura include un ambiente interattivo, in cui gli sviluppatori possono lavorare direttamente con l'ambiente e aggiungere servizi tramite un catalogo selezionato di soluzioni. Gli ambienti operativi sono gestiti tramite pipeline con architettura e configurazione codificate.
Questa architettura utilizza la struttura organizzativa del progetto di base per le aziende come base per il deployment dei workload di dati. Il seguente diagramma mostra le cartelle e i progetti di primo livello utilizzati nell'architettura mesh di dati aziendali.
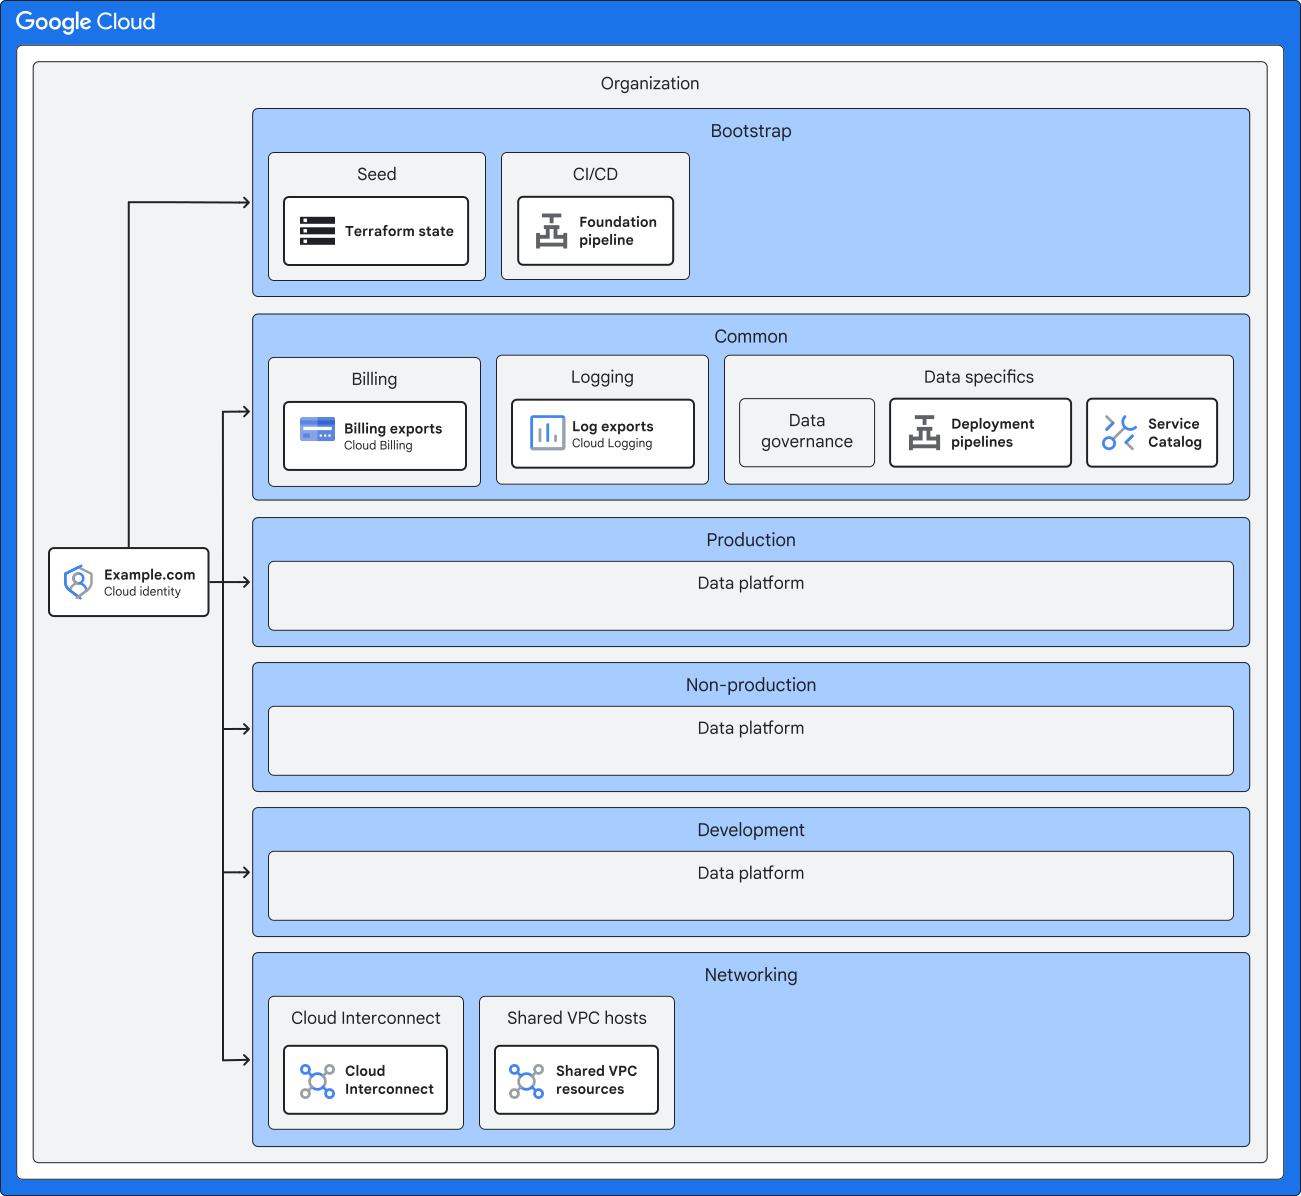
La tabella seguente descrive le cartelle e i progetti di primo livello che fanno parte dell'architettura.
| Cartella | Componente | Descrizione |
|---|---|---|
|
|
Contiene la pipeline di deployment utilizzata per creare gli artefatti di codice dell'architettura. |
|
Contiene l'infrastruttura utilizzata dal catalogo dei servizi per eseguire il deployment delle risorse nell'ambiente interattivo. |
|
|
Contiene tutte le risorse utilizzate dall'implementazione del framework CDMC da parte di Google Cloud. |
|
|
|
Contiene i progetti e le risorse della piattaforma dati per lo sviluppo di casi d'uso in modalità interattiva. |
|
|
Contiene i progetti e le risorse della piattaforma dati per testare i casi d'uso di cui vuoi eseguire il deployment in un ambiente operativo. |
|
|
Contiene i progetti e le risorse della piattaforma dati per il deployment in produzione. |
Cartella della piattaforma dati
La cartella della piattaforma dati contiene tutti i componenti del piano dati e alcune risorse CDMC. Inoltre, la cartella della piattaforma dati e il progetto di governance dei dati contengono le risorse CDMC. Il seguente diagramma mostra le cartelle e i progetti di cui viene eseguito il deployment nella cartella della piattaforma dati.
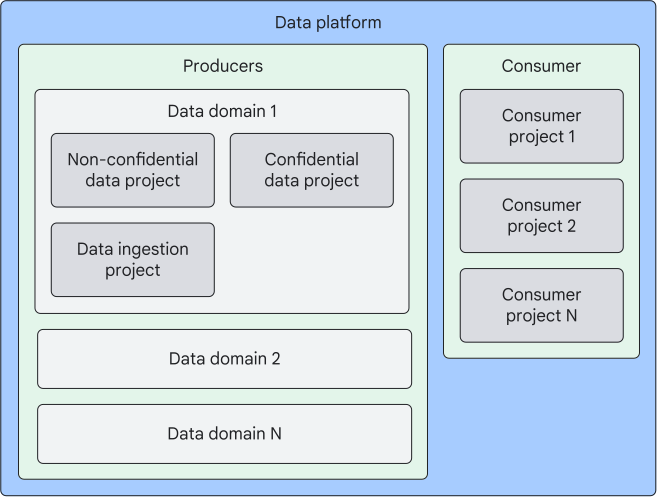
Ogni cartella della piattaforma dati include una cartella dell'ambiente (produzione, non produzione e sviluppo). La tabella seguente descrive le cartelle all'interno di ogni cartella della piattaforma dati.
| Cartelle | Descrizione |
|---|---|
Producer |
Contiene i domini di dati. |
Consumatori |
Contiene i progetti consumer. |
Dominio dei dati |
Contiene i progetti associati a un determinato dominio. |
Cartella Producers
Ogni cartella dei producer include uno o più domini di dati. Un dominio di dati si riferisce a un raggruppamento logico di elementi di dati che condividono un significato, uno scopo o un contesto aziendale comune. I domini di dati ti consentono di classificare e organizzare gli asset di dati all'interno di un'organizzazione. Il seguente diagramma mostra la struttura di un dominio di dati. L'architettura esegue il deployment dei progetti nella cartella della piattaforma dati per ogni ambiente.
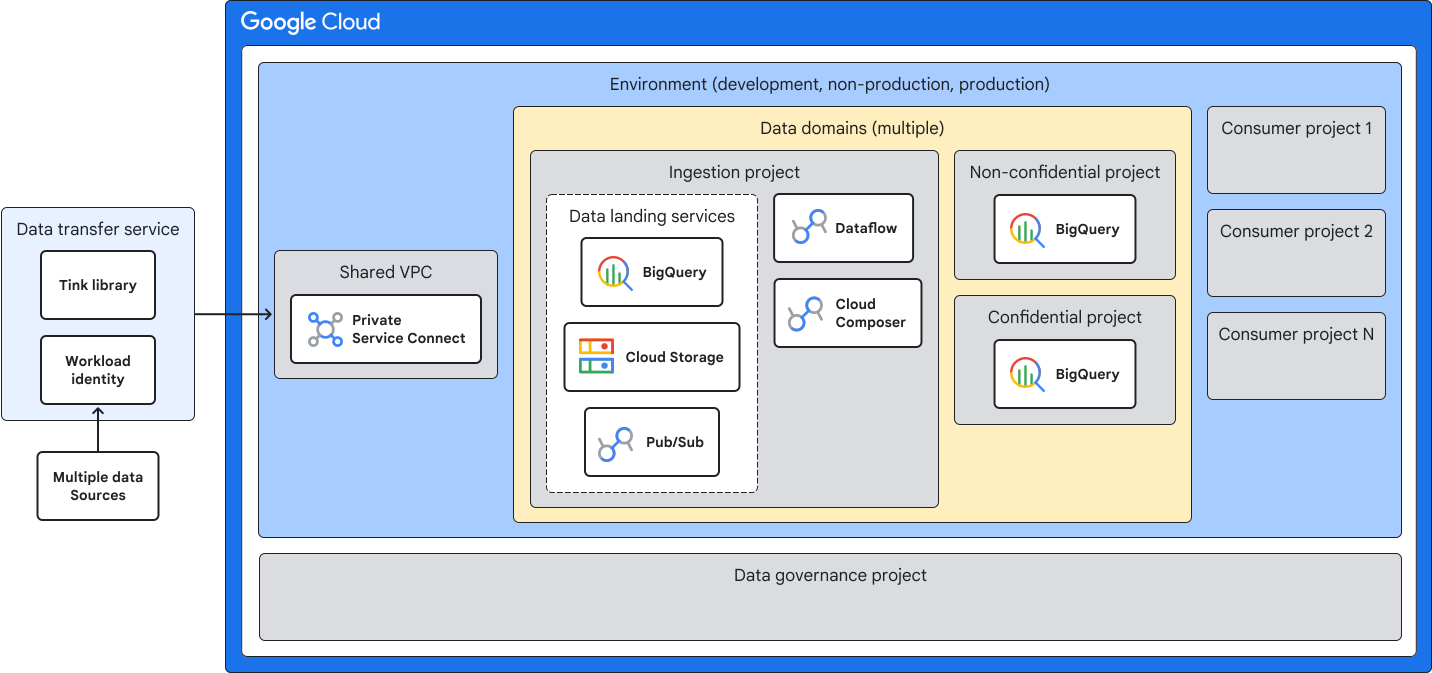
La tabella seguente descrive i progetti di cui viene eseguito il deployment nella cartella della piattaforma dati per ogni ambiente.
| Progetto | Descrizione |
|---|---|
Importazione |
Il progetto di importazione importa i dati nel dominio dei dati. L'architettura fornisce esempi di come puoi trasmettere i dati in BigQuery, Cloud Storage e Pub/Sub. Il progetto di importazione contiene anche esempi di Dataflow e Managed Service for Apache Airflow che puoi utilizzare per orchestrare la trasformazione e lo spostamento dei dati importati. |
Non riservato |
Il progetto non riservato contiene dati anonimizzati. Puoi mascherare, containerizzare, criptare, tokenizzare o offuscare i dati. Utilizza i tag di policy per controllare il modo in cui vengono presentati i dati. |
Riservato |
Il progetto riservato contiene dati in testo non crittografato. Puoi controllare l'accesso tramite le autorizzazioni IAM. |
Cartella consumer
La cartella consumer contiene i progetti consumer. I progetti consumer forniscono un meccanismo per segmentare gli utenti dei dati in base al confine di attendibilità richiesto. Ogni progetto viene assegnato a un gruppo di utenti separato e al gruppo viene assegnato l'accesso agli asset di dati richiesti in base al progetto. Puoi utilizzare il progetto consumer per raccogliere, analizzare e migliorare i dati del gruppo.
Cartella comune
La cartella comune contiene i servizi utilizzati da ambienti e progetti diversi. Questa sezione descrive le funzionalità aggiunte alla cartella comune per abilitare il mesh di dati aziendali.
Architettura CDMC
L'architettura utilizza l'architettura CDMC per la governance dei dati. Le funzioni di governance dei dati si trovano nel progetto di governance dei dati nella cartella comune. Il seguente diagramma mostra i componenti dell'architettura CDMC. I numeri nel diagramma rappresentano i controlli chiave che vengono gestiti con i servizi Google Cloud.

La seguente tabella descrive i componenti dell'architettura CDMC utilizzati dall'architettura mesh di dati aziendali.
| Componente CDMC | ServizioGoogle Cloud | Descrizione |
|---|---|---|
| Componenti di accesso e ciclo di vita | ||
Gestione delle chiavi |
Cloud KMS |
Un servizio che gestisce in modo sicuro le chiavi di crittografia che proteggono i dati sensibili. |
Gestore dei record |
Cloud Run |
Un'applicazione che mantiene log e record completi delle attività di trattamento dati, garantendo che le organizzazioni possano monitorare e controllare l'utilizzo dei dati. |
Policy di archiviazione |
BigQuery |
Una tabella BigQuery che contiene la policy di archiviazione dei dati. |
Diritti |
BigQuery |
Una tabella BigQuery che memorizza informazioni su chi può accedere ai dati sensibili. Questa tabella garantisce che solo gli utenti autorizzati possano accedere a dati specifici in base ai loro ruoli e privilegi. |
| Componenti di scansione | ||
Perdita dei dati |
Sensitive Data Protection |
Servizio utilizzato per ispezionare gli asset alla ricerca di dati sensibili. |
Risultati DLP |
BigQuery |
Una tabella BigQuery che cataloga le classificazioni dei dati all'interno della piattaforma di dati. |
Policy |
BigQuery |
Una tabella BigQuery che contiene pratiche di governance dei dati coerenti (ad esempio, tipi di accesso ai dati). |
Esportazione della fatturazione |
BigQuery |
Una tabella che memorizza le informazioni sui costi esportate dalla fatturazione Cloud per consentire l'analisi delle metriche di costo associate agli asset di dati. |
Cloud Data Quality Engine |
Cloud Run |
Un'applicazione che esegue controlli della qualità dei dati per tabelle e colonne. |
Risultati relativi alla qualità dei dati |
BigQuery |
Una tabella BigQuery che registra le discrepanze identificate tra le regole di qualità dei dati definite e la qualità effettiva degli asset di dati. |
| Componenti dei report | ||
Scheduler |
Cloud Scheduler |
Un servizio che controlla quando viene eseguito il motore di qualità dei dati Cloud e quando avviene l'ispezione di Sensitive Data Protection. |
Report Engine |
Cloud Run |
Un'applicazione che genera report che aiutano a monitorare e misurare l'aderenza ai controlli del framework CDMC. |
Risultati e asset |
BigQuery e Pub/Sub |
Un report BigQuery sulle discrepanze o sulle incoerenze nei controlli di gestione dei dati, ad esempio aspetti mancanti, classificazioni errate o località di archiviazione non conformi. |
Esportazioni di tag |
BigQuery |
Una tabella BigQuery che contiene informazioni sugli aspetti estratti da Knowledge Catalog. |
| Altri componenti | ||
Gestione dei criteri |
Servizio Policy dell'organizzazione |
Un servizio che definisce e applica limitazioni sulla posizione geografica in cui possono essere archiviati i dati. |
Policy di accesso basate sugli attributi |
Gestore contesto accesso |
Un servizio che definisce e applica policy di accesso granulari basate su attributi, in modo che solo gli utenti autorizzati da località e dispositivi consentiti possano accedere alle informazioni sensibili. |
Metadati |
Knowledge Catalog |
Un servizio che archivia le informazioni sui metadati relative alle tabelle in uso nel mesh di dati. |
Tag Engine |
Cloud Run |
Un'applicazione che aggiunge aspetti alle voci delle tabelle BigQuery in Knowledge Catalog. |
Report CDMC |
Data Studio |
Dashboard che consentono agli analisti di visualizzare i report generati dai motori dell'architettura CDMC. |
Implementazione di CDMC
La tabella seguente descrive in che modo l'architettura implementa i controlli chiave nel framework CDMC.
| Requisito di controllo CDMC | Implementazione |
|---|---|
Il motore di report rileva gli asset di dati non conformi e pubblica i risultati in un argomento Pub/Sub. Questi risultati vengono anche caricati in BigQuery per la generazione di report utilizzando Data Studio. |
|
Knowledge Catalog acquisisce automaticamente i metadati tecnici da BigQuery. Tag Engine applica aspetti dei metadati aziendali come il nome del proprietario e il livello di sensibilità da una tabella di riferimento, contribuendo a garantire che tutti i dati sensibili siano annotati con le informazioni sul proprietario per la conformità. Questo processo automatizzato contribuisce a garantire la governance dei dati e la conformità identificando ed etichettando i dati sensibili con le informazioni appropriate sul proprietario. |
|
L'approvvigionamento e il consumo dei dati sono regolati e supportati dall'automazione |
Knowledge Catalog classifica gli asset di dati annotandoli con un aspetto che include un flag |
La sovranità dei dati e il movimento dei dati transfrontaliero sono gestiti |
Il servizio policy dell'organizzazione definisce le regioni di archiviazione consentite per gli asset di dati e Gestore contesto accesso limita l'accesso in base alla località dell'utente. Knowledge Catalog archivia le località di archiviazione approvate come aspetti dei metadati. Il motore di report confronta questi aspetti con la posizione effettiva degli asset di dati in BigQuery e pubblica eventuali discrepanze come risultati utilizzando Pub/Sub. Security Command Center fornisce un ulteriore livello di monitoraggio generando risultati relativi alle vulnerabilità se i dati vengono archiviati o se l'accesso avviene al di fuori delle policy definite. |
I cataloghi di dati sono implementati, utilizzati e interoperabili |
Knowledge Catalog archivia e aggiorna i metadati tecnici per tutti gli asset di dati BigQuery, creando di fatto un catalogo dati sincronizzato in modo continuo. Knowledge Catalog garantisce che tutte le tabelle e le visualizzazioni nuove o modificate vengano aggiunte immediatamente al catalogo, mantenendo un inventario aggiornato degli asset di dati. |
Sensitive Data Protection esamina i dati di BigQuery e identifica i tipi di informazioni sensibili. Questi risultati vengono poi classificati in base a una tabella di riferimento per la classificazione e il livello di sensibilità più elevato viene assegnato come aspetto in Knowledge Catalog a livello di colonna e tabella. Tag Engine gestisce questo processo aggiornando Knowledge Catalog con gli aspetti di sensibilità ogni volta che vengono aggiunti nuovi asset di dati o modificati quelli esistenti. Questo processo garantisce una classificazione dei dati costantemente aggiornata in base alla sensibilità, che puoi monitorare e segnalare utilizzando Pub/Sub e strumenti di generazione dei report integrati. |
|
I diritti di accesso ai dati vengono gestiti, applicati e monitorati |
I tag di policy di BigQuery controllano l'accesso ai dati sensibili a livello di colonna, garantendo che solo gli utenti autorizzati possano accedere a dati specifici in base al tag di criteri assegnato. IAM gestisce l'accesso complessivo al data warehouse, mentre Knowledge Catalog archivia le classificazioni della sensibilità. Vengono eseguiti controlli regolari per garantire che tutti i dati sensibili abbiano tag di policy corrispondenti e le eventuali discrepanze vengono segnalate utilizzando Pub/Sub per la correzione. |
Gestione dell'accesso, dell'utilizzo e dei risultati dei dati in modo etico |
I contratti di condivisione dei dati sia per i provider che per i consumer vengono archiviati in un data warehouse BigQuery dedicato per controllare gli scopi di consumo. Knowledge Catalog etichetta gli asset di dati con le informazioni del contratto del provider, mentre i contratti dei consumer sono collegati alle associazioni IAM per controllo dell'accesso. Le etichette di query applicano gli scopi di consumo, richiedendo ai consumer di specificare uno scopo valido quando eseguono query su dati sensibili, che viene convalidato in base ai loro diritti in BigQuery. Una traccia di audit in BigQuery monitora tutti gli accessi ai dati e garantisce la conformità agli accordi di condivisione dei dati. |
La crittografia at-rest predefinita di Google aiuta a proteggere i dati archiviati su disco. Cloud KMS supporta le chiavi di crittografia gestite dal cliente (CMEK) per una gestione avanzata delle chiavi. BigQuery implementa il mascheramento dinamico dei dati a livello di colonna per l'anonimizzazione e supporta l'anonimizzazione a livello di applicazione durante l'importazione dati. Knowledge Catalog archivia gli aspetti dei metadati per le tecniche di crittografia e anonimizzazione applicate agli asset di dati. I controlli automatici garantiscono che i metodi di crittografia e anonimizzazione siano in linea con le policy di sicurezza predefinite, con eventuali discrepanze segnalate come risultati utilizzando Pub/Sub. |
|
È stato definito e reso operativo un framework per la privacy dei dati |
Knowledge Catalog annota gli asset di dati sensibili con aspetti contenenti informazioni pertinenti per la valutazione dell'impatto, come la posizione del soggetto e i link ai report di valutazione. Tag Engine applica questi aspetti in base alla sensibilità dei dati e a una tabella delle policy in BigQuery, che definisce i requisiti di valutazione in base alla residenza dei dati e dei soggetti. Questo processo automatizzato consente il monitoraggio e la generazione di report continui sulla conformità ai requisiti di valutazione di impatto, garantendo che le valutazioni di impatto sulla protezione dei dati (DPIA) o le valutazioni di impatto sulla protezione (PIA) vengano condotte quando necessario. |
Knowledge Catalog etichetta gli asset di dati con policy di conservazione, specificando i periodi di conservazione e le azioni di scadenza (come l'archiviazione o l'eliminazione definitiva). Record Manager automatizza l'applicazione di queste policy eliminando o archiviando le tabelle BigQuery in base agli aspetti definiti. Questa applicazione garantisce il rispetto delle policy sul ciclo di vita dei dati e mantiene la conformità ai requisiti di conservazione dei dati, con eventuali discrepanze rilevate e segnalate tramite Pub/Sub. |
|
Il motore di qualità dei dati di Cloud definisce ed esegue regole di qualità dei dati su colonne di tabelle specificate, misurando la qualità dei dati in base a metriche come correttezza e completezza. I risultati di questi controlli, incluse le percentuali di successo e le soglie, vengono archiviati come aspetti in Knowledge Catalog. La memorizzazione di questi risultati consente il monitoraggio e la generazione di report continui sulla qualità dei dati, con eventuali problemi o deviazioni dalle soglie accettabili pubblicati come risultati utilizzando Pub/Sub. |
|
Knowledge Catalog archivia le metriche relative ai costi per gli asset di dati, come i costi delle query, i costi di archiviazione e i costi di uscita dei dati, che vengono calcolati utilizzando i dati di fatturazione esportati dalla fatturazione Cloud a BigQuery. L'archiviazione delle metriche relative ai costi consente un monitoraggio e un'analisi completi dei costi, garantendo il rispetto delle policy sui costi e un utilizzo efficiente delle risorse, con eventuali anomalie segnalate tramite Pub/Sub. |
|
Le funzionalità di derivazione dei dati integrate di Knowledge Catalog monitorano la provenienza e la derivazione degli asset di dati, rappresentando visivamente il flusso di dati. Inoltre, gli script di importazione dati identificano e registrano l'origine originale dei dati come aspetto in Knowledge Catalog, migliorando la tracciabilità dei dati fino alla loro origine. |
Gestione dell'accesso ai dati
L'accesso ai dati dell'architettura è controllato tramite un processo indipendente che separa il controllo operativo (ad esempio, l'esecuzione di job Dataflow) dal controllo dell'accesso dell'accesso ai dati. L'accesso di un utente a un servizio Google Cloud è definito da un problema ambientale o operativo ed è eseguito il provisioning e l'approvazione da parte di un gruppo di progettazione cloud. L'accesso di un utente agli asset di dati Google Cloud (ad esempio, una tabella BigQuery) è un problema di privacy, normativo o di governance ed è soggetto a un contratto di accesso tra le parti di produzione e di consumo e controllato tramite i seguenti processi. Il seguente diagramma mostra come viene eseguito il provisioning dell'accesso ai dati tramite l'interazione di diversi componenti software.
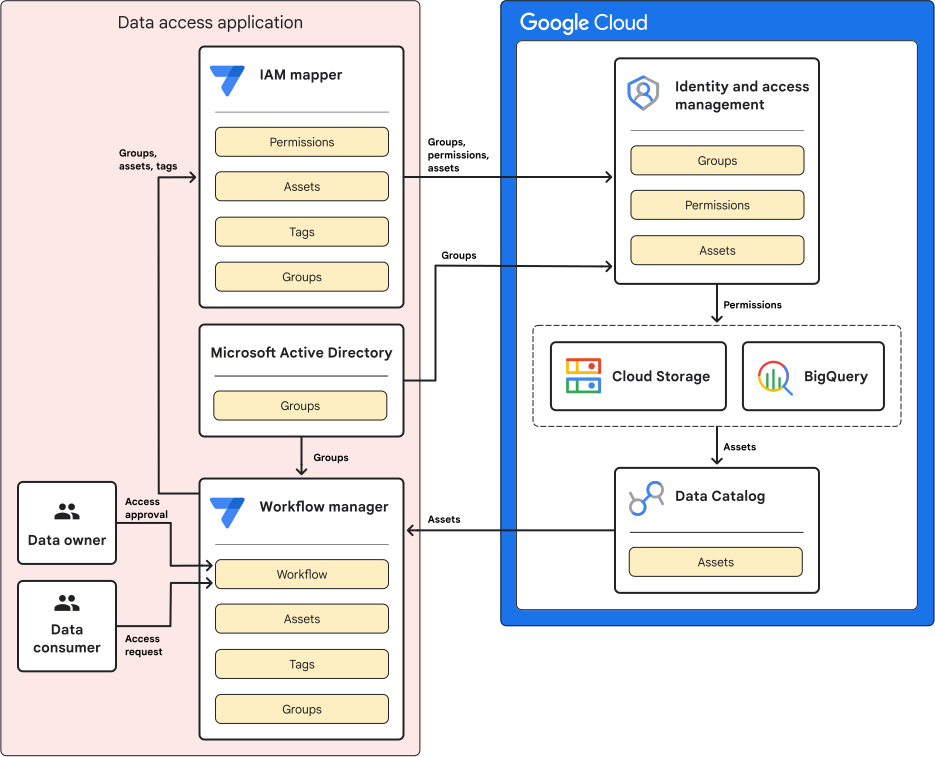
Come mostrato nel diagramma precedente, l'onboarding degli accessi ai dati è gestito dai seguenti processi:
- Gli asset di dati cloud vengono raccolti e inventariati da Knowledge Catalog.
- Il gestore del workflow recupera gli asset di dati da Knowledge Catalog.
- I proprietari dei dati vengono inseriti in Workflow Manager.
La gestione dell'accesso ai dati funziona nel seguente modo:
- Un consumer di dati effettua una richiesta per un asset specifico.
- Il proprietario dei dati della risorsa riceve un avviso relativo alla richiesta.
- Il proprietario dei dati approva o rifiuta la richiesta.
- Se la richiesta viene approvata, il gestore del workflow passa il gruppo, l'asset e il tag associato al mappatore IAM.
- Il mapper IAM traduce i tag del gestore del workflow in autorizzazioni IAM e concede al gruppo specificato le autorizzazioni IAM per l'asset di dati.
- Quando un utente vuole accedere all'asset di dati, IAM valuta l'accesso all'asset Google Cloud in base alle autorizzazioni del gruppo.
- Se l'accesso è consentito, l'utente accede all'asset di dati.
Networking
Il processo di sicurezza dei dati inizia nell'applicazione di origine, che potrebbe trovarsi on-premise o in un altro ambiente esterno al progettoGoogle Cloud di destinazione. Prima di qualsiasi trasferimento di rete, questa applicazione utilizza la federazione delle identità per i workload per autenticarsi in modo sicuro alle API Cloud. Utilizzando queste credenziali, interagisce con Cloud KMS per ottenere o eseguire il wrapping delle chiavi necessarie, quindi utilizza la libreria Tink per eseguire la crittografia e l'anonimizzazione iniziali sul payload dei dati sensibili in base a modelli predefiniti.
Dopo aver protetto il payload dei dati, questo deve essere trasferito in modo sicuro nel progetto di importazione Google Cloud . Per le applicazioni on-premise, puoi utilizzare Cloud Interconnect o potenzialmente Cloud VPN. All'interno della reteGoogle Cloud , utilizza Private Service Connect per instradare i dati verso l'endpoint di importazione all'interno della rete VPC del progetto di destinazione. Private Service Connect consente all'applicazione di origine di connettersi alle API di Google utilizzando indirizzi IP privati, garantendo che il traffico non venga esposto a internet.
L'intero percorso di rete e i servizi di importazione di destinazione (Cloud Storage, BigQuery e Pub/Sub) all'interno del progetto di importazione sono protetti da un perimetro dei Controlli di servizio VPC. Questo perimetro applica un confine di sicurezza, garantendo che i dati protetti provenienti dall'origine possano essere importati solo nei serviziGoogle Cloud autorizzati all'interno di quel progetto specifico.
Logging
Questa architettura utilizza le funzionalità di Cloud Logging fornite dal progetto delle fondamenta aziendali.
Pipeline
L'architettura mesh di dati aziendali utilizza una serie di pipeline per eseguire il provisioning dell'infrastruttura, dell'orchestrazione, dei set di dati, delle pipeline di dati e dei componenti dell'applicazione. Le pipeline di deployment delle risorse dell'architettura utilizzano Terraform come strumento di infrastructure as code (IaC) e Cloud Build come servizio CI/CD per eseguire il deployment delle configurazioni Terraform nell'ambiente dell'architettura. Il diagramma seguente mostra la relazione tra le pipeline.
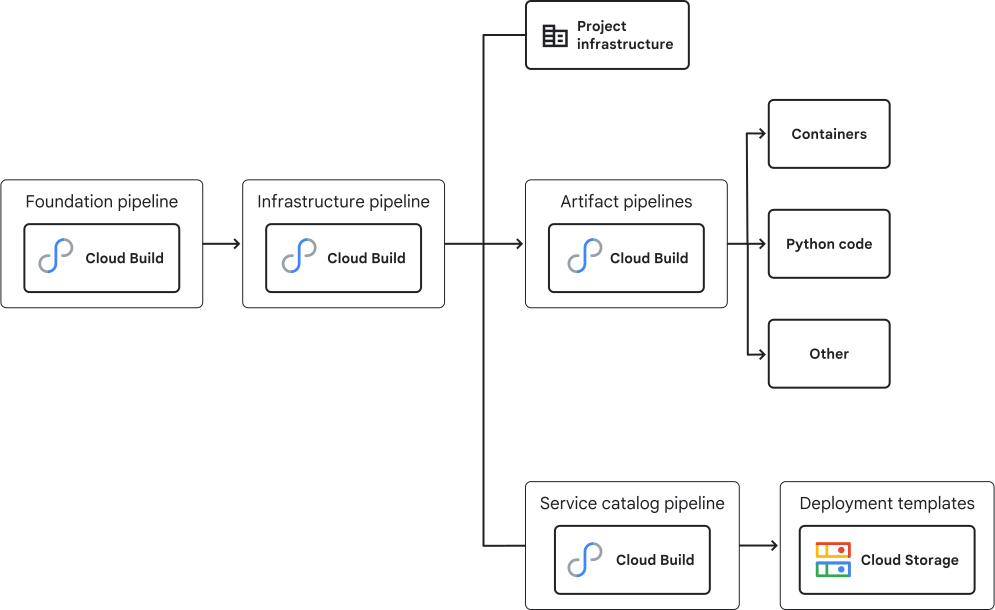
La pipeline di base e la pipeline dell'infrastruttura fanno parte del progetto di fondazione di un'azienda. La tabella seguente descrive lo scopo delle pipeline e le risorse di cui eseguono il provisioning.
| Pipeline | Provisioning eseguito da | Risorse |
|---|---|---|
Pipeline di base |
Bootstrap |
|
Pipeline dell'infrastruttura |
Pipeline di base |
|
Pipeline del catalogo dei servizi |
Pipeline dell'infrastruttura |
|
Pipeline di artefatti |
Pipeline dell'infrastruttura |
Le pipeline di artefatti producono i vari container e altri componenti della codebase utilizzati dal mesh di dati. |
Ogni pipeline ha il proprio insieme di repository da cui estrae il codice e i file di configurazione. Ogni repository ha una separazione dei compiti in cui i responsabili dell'invio e dell'approvazione dei deployment del codice operativo sono gruppi diversi.
Deployment interattivo tramite catalogo dei servizi
Gli ambienti interattivi sono l'ambiente di sviluppo all'interno dell'architettura e si trovano nella cartella di sviluppo. L'interfaccia principale per l'ambiente interattivo è catalogo dei servizi, che consente agli sviluppatori di utilizzare modelli preconfigurati per creare istanze dei servizi Google. Questi modelli preconfigurati sono noti come modelli di servizio. I template di servizio ti aiutano ad applicare la tua security posture, ad esempio rendendo obbligatoria la crittografia CMEK, e impediscono inoltre agli utenti di accedere direttamente alle API di Google.
Il seguente diagramma mostra i componenti dell'ambiente interattivo e il modo in cui i data scientist eseguono il deployment delle risorse.
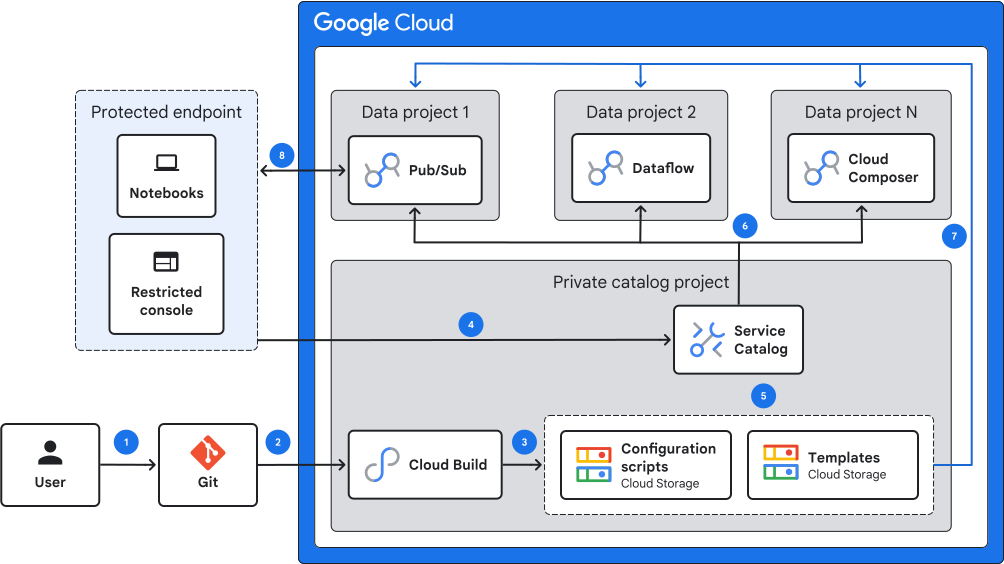
Per eseguire il deployment delle risorse utilizzando il catalogo dei servizi, vengono eseguiti i seguenti passaggi:
- L'MLOps engineer inserisce un modello di risorsa Terraform per Google Cloud in un repository Git.
- Il comando Git Commit attiva una pipeline di Cloud Build.
- Cloud Build copia il template e tutti i file di configurazione associati in Cloud Storage.
- L'MLOps Engineer configura manualmente le soluzioni del catalogo dei servizi e il catalogo dei servizi. L'engineer condivide quindi il catalogo dei servizi con un progetto di servizio nell'ambiente interattivo.
- Il data scientist seleziona una risorsa dal catalogo dei servizi.
- Catalogo dei servizi esegue il deployment del template nell'ambiente interattivo.
- La risorsa estrae tutti gli script di configurazione necessari.
- Il data scientist interagisce con le risorse.
Pipeline di artefatti
Il processo di importazione dati utilizza Managed Airflow e Dataflow per orchestrare lo spostamento e la trasformazione dei dati all'interno del dominio di dati. La pipeline degli artefatti crea tutte le risorse necessarie per l'importazione dati e le sposta nella posizione appropriata affinché i servizi possano accedervi. La pipeline degli artefatti crea gli artefatti dei container utilizzati dall'orchestratore.
Controlli di sicurezza
L'architettura mesh di dati aziendali utilizza un modello di sicurezza di difesa approfondita a più livelli che include funzionalità Google Cloud predefinite, servizi Google Cloude funzionalità di sicurezza configurate tramite il progetto delle basi aziendali. Il seguente diagramma mostra la stratificazione dei vari controlli di sicurezza per l'architettura.
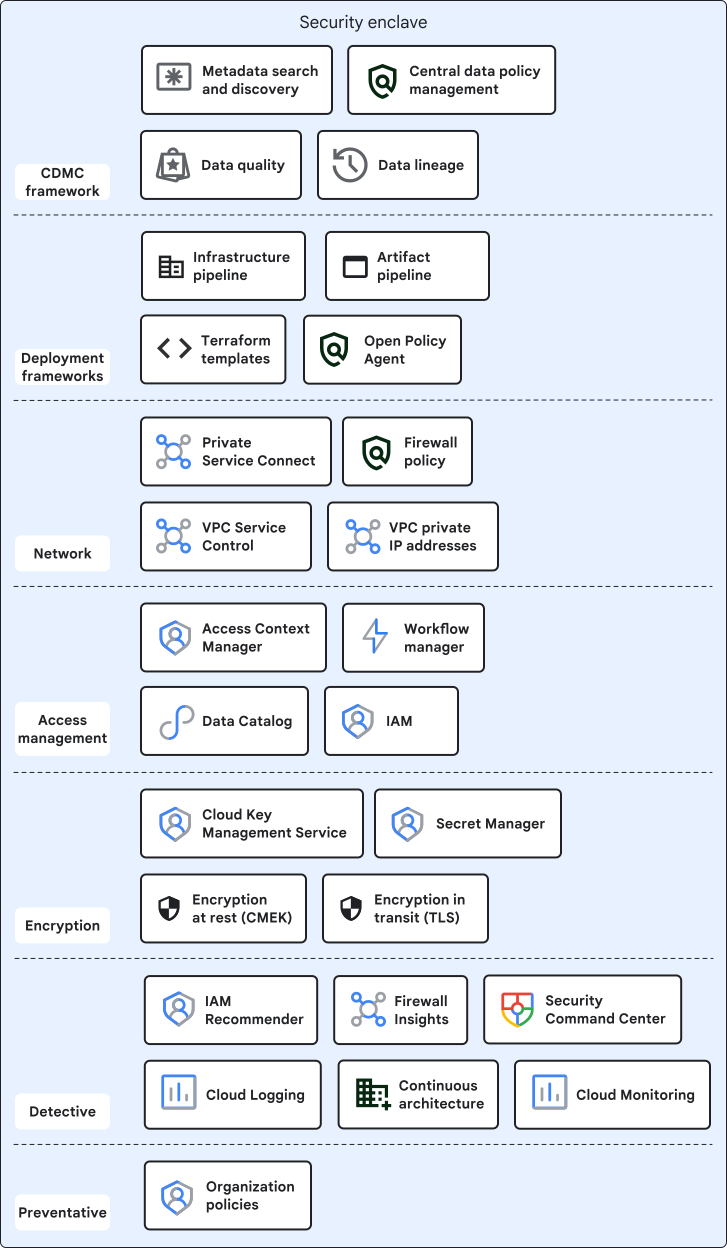
La tabella seguente descrive i controlli di sicurezza associati alle risorse di ogni livello.
| incorporato | Risorsa | Controllo di sicurezza |
|---|---|---|
Framework CDMC |
Google Cloud Implementazione di CDMC |
Fornisce un framework di governance che aiuta a proteggere, gestire e controllare i tuoi asset di dati. Per saperne di più, consulta CDMC Key Controls Framework. |
Deployment |
Pipeline dell'infrastruttura |
Fornisce una serie di pipeline che eseguono il deployment dell'infrastruttura, creano container e creano pipeline di dati. L'utilizzo delle pipeline consente di eseguire controlli, tracciabilità e ripetibilità. |
Pipeline degli artefatti |
Esegue il deployment di vari componenti di cui non è stato eseguito il deployment dalla pipeline dell'infrastruttura. |
|
Modelli Terraform |
Builds out the system infrastructure. |
|
Open Policy Agent |
Contribuisce a garantire che la piattaforma sia conforme alle policy selezionate. |
|
Rete |
Private Service Connect |
Fornisce protezioni contro l'esfiltrazione di dati per le risorse dell'architettura a livello di API e di IP. Ti consente di comunicare con le API Cloud utilizzando indirizzi IP privati, in modo da evitare di esporre il traffico a internet. |
Rete VPC con indirizzi IP privati |
Aiuta a rimuovere l'esposizione alle minacce rivolte a internet. |
|
Controlli di servizio VPC |
Aiuta a proteggere le risorse sensibili dall'esfiltrazione di dati. |
|
Firewall |
Aiuta a proteggere la rete VPC da accessi non autorizzati. |
|
Gestione degli accessi |
Gestore contesto accesso |
Controlla chi può accedere a quali risorse e aiuta a prevenire l'utilizzo non autorizzato delle tue risorse. |
Federazione delle identità per i workload |
Elimina la necessità di credenziali esterne per trasferire i dati sulla piattaforma da ambienti on-premise. |
|
Knowledge Catalog |
Fornisce un indice degli asset disponibili per gli utenti. |
|
IAM |
Fornisce un accesso granulare. |
|
Crittografia |
Cloud KMS |
Ti consente di gestire le chiavi di crittografia e i secret e di proteggere i tuoi dati tramite la crittografia at-rest e in transito. |
Secret Manager |
Fornisce un archivio di secret per le pipeline controllate da IAM. |
|
Crittografia at-rest |
Per impostazione predefinita, Google Cloud cripta i dati at-rest. |
|
Crittografia dei dati in transito |
Per impostazione predefinita, Google Cloud cripta i dati in transito. |
|
Rilevamento |
Security Command Center |
Ti aiuta a rilevare configurazioni errate e attività dannose nella tua organizzazione Google Cloud. |
Architettura continua |
Controlla continuamente la tua organizzazione Google Cloud rispetto a una serie di policy OPA che hai definito. |
|
Motore per suggerimenti IAM |
Analizza le autorizzazioni degli utenti e fornisce suggerimenti su come ridurle per applicare il principio del privilegio minimo. |
|
Firewall Insights |
Analizza le regole firewall, identifica quelle troppo permissive e suggerisce firewall più restrittivi per contribuire a rafforzare la tua security posture complessiva. |
|
Cloud Logging |
Fornisce visibilità sull'attività del sistema e aiuta a rilevare anomalie e attività dannose. |
|
Cloud Monitoring |
Monitora gli indicatori e gli eventi chiave che possono aiutare a identificare attività sospette. |
|
Preventiva |
Policy dell'organizzazione |
Ti consente di controllare e limitare le azioni all'interno della tua organizzazione Google Cloud. |
Workflow
Le sezioni seguenti descrivono il flusso di lavoro del producer di dati e il flusso di lavoro del consumer di dati, garantendo controlli di accesso appropriati in base alla sensibilità dei dati e ai ruoli utente.
Flusso di lavoro del producer di dati
Il seguente diagramma mostra come vengono protetti i dati durante il trasferimento a BigQuery.
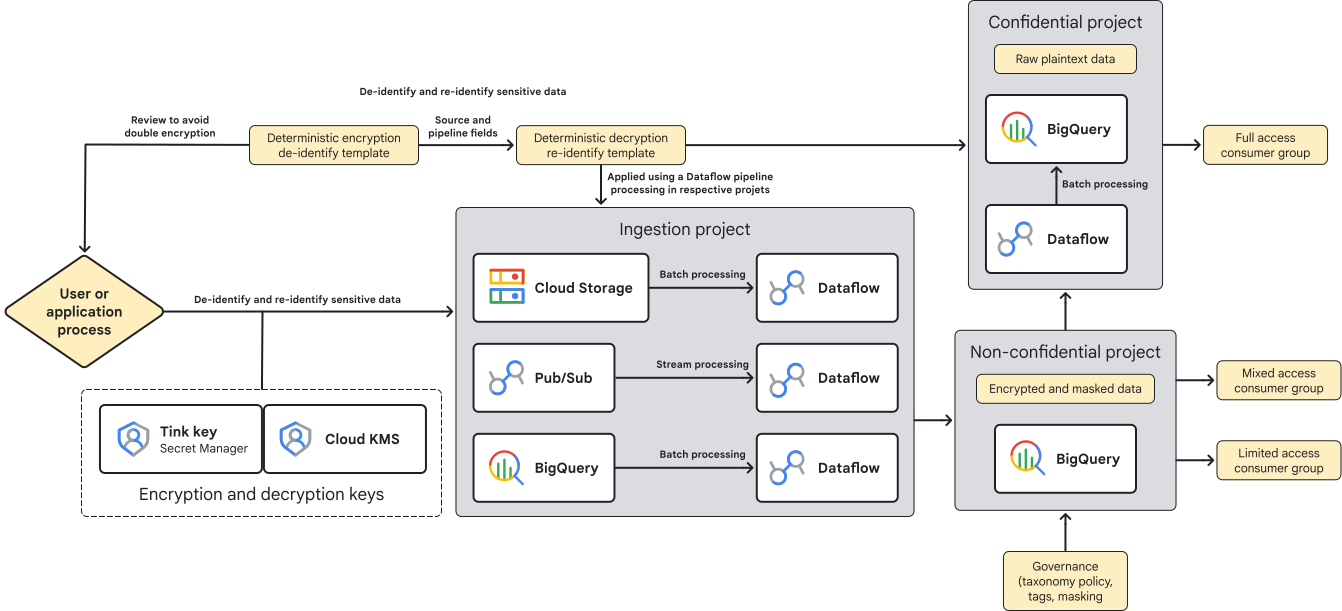
Il flusso di lavoro per il trasferimento dei dati è il seguente:
- Un'applicazione integrata con la federazione delle identità per i workload utilizza Cloud KMS per decriptare una chiave di crittografia con wrapping.
- L'applicazione utilizza la libreria Tink per anonimizzare o criptare i dati utilizzando un template.
- L'applicazione trasferisce i dati al progetto di importazione in Google Cloud.
- I dati arrivano in Cloud Storage, BigQuery o Pub/Sub.
- Nel progetto di importazione, i dati vengono decriptati o reidentificati utilizzando un modello.
- I dati decriptati vengono criptati o mascherati in base a un altro template di anonimizzazione, quindi inseriti nel progetto non riservato. Gli aspetti e i tag di policy vengono applicati da Tag Engine in base alle esigenze.
- I dati del progetto non riservato vengono trasferiti al progetto riservato e reidentificati.
È consentito l'accesso ai seguenti dati:
- Gli utenti che hanno accesso al progetto riservato possono accedere a tutti i dati non elaborati in testo non crittografato.
- Gli utenti che hanno accesso al progetto non riservato possono accedere ai dati mascherati, tokenizzati o criptati in base ai tag di policy associati ai dati e alle loro autorizzazioni.
Flusso di lavoro del consumatore di dati
I passaggi seguenti descrivono in che modo un consumer può accedere ai dati archiviati in BigQuery.
- Il consumer di dati cerca gli asset di dati utilizzando Knowledge Catalog.
- Dopo aver trovato gli asset che sta cercando, il consumer di dati richiede l'accesso agli asset di dati.
- Il proprietario dei dati decide se fornire l'accesso agli asset.
- Se il consumer ottiene l'accesso, può utilizzare un notebook e il catalogo delle soluzioni per creare un ambiente in cui analizzare e trasformare gli asset di dati.
Riepilogo
Il repository GitHub fornisce istruzioni dettagliate sul deployment del mesh di dati suGoogle Cloud dopo aver eseguito il deployment della base aziendale. Il processo di deployment dell'architettura prevede la modifica dei repository dell'infrastruttura esistenti e il deployment di nuovi componenti specifici per il mesh di dati.
Completa i passaggi seguente:
- Completa tutti i prerequisiti, tra cui:
- Installa Google Cloud CLI, Terraform, Tink, Java e Go.
- Esegui il deployment del progetto di base per le aziende (v4.1).
- Gestisci i seguenti repository locali:
gcp-data-mesh-foundationsgcp-bootstrapgcp-environmentsgcp-networksgcp-orggcp-projects
- Modificare il blueprint di base esistente e poi eseguire il deployment delle applicazioni mesh di dati. Per ogni elemento, completa quanto segue:
- Nel repository di destinazione, esegui il checkout del branch
Plan. - Per aggiungere componenti mesh di dati, copia i file e le directory pertinenti da
gcp-data-mesh-foundationsnella directory foundation appropriata. Sovrascrivi i file quando necessario. - Aggiorna le variabili, i ruoli e le impostazioni del mesh di dati nei file Terraform (ad esempio
*.tfvarse*.tf). Imposta i token GitHub come variabili di ambiente. - Esegui le operazioni di inizializzazione, pianificazione e applicazione di Terraform su ogni repository.
- Esegui il commit delle modifiche, il push del codice nel repository remoto, crea richieste di pull e unisci i tuoi ambienti di sviluppo, non di produzione e di produzione.
- Nel repository di destinazione, esegui il checkout del branch
Passaggi successivi
- Scopri di più su architettura e funzioni in un mesh di dati.
- Importa i dati da Google Cloud in un data warehouse BigQuery protetto.
- Implementa il framework dei controlli chiave CDMC in un data warehouse BigQuery.
- Scopri di più sul progetto di base per le aziende.