


Questo documento fornisce un'architettura di alto livello per un sistema di AI multi-agente che consolida dati multimodali frammentati in un Knowledge Graph ricercabile. Il sistema consente agli utenti di caricare dati e quindi di utilizzare il knowledge graph per identificare potenziali problemi o rischi sistemici. L'architettura consente agli agenti di navigare in reti di dati complesse e di mantenere una personalizzazione a lungo termine. In questo modo, le risorse distribuite vengono abbinate ai requisiti di ricerca con continuità.
GraphRAG è un approccio basato su grafi alla Retrieval-Augmented Generation (RAG). La RAG aiuta a fare il grounding delle risposte generate con l'AI migliorando i prompt con dati contestualmente pertinenti recuperati utilizzando Vector Search. GraphRAG combina la Vector Search con una query del Knowledge Graph per recuperare dati contestuali che riflettono meglio l'interconnessione dei dati provenienti da diverse origini. I prompt migliorati con GraphRAG possono generare risposte dell'AI più dettagliate e pertinenti.
Il pubblico di destinazione di questo documento include architetti, sviluppatori e amministratori che creano e gestiscono l'infrastruttura e le applicazioni di AI nel cloud. Questo documento presuppone che tu abbia una conoscenza di base degli agenti e dei modelli di AI. Il documento non fornisce indicazioni specifiche per la progettazione e la programmazione di agenti AI.
La sezione Deployment di questo documento fornisce un esempio di codice che mostra come definire uno schema Spanner Graph e collegare entità multimodali per il recupero agentico.
Architettura
Di seguito è riportata una panoramica di alto livello dell'architettura di un sistema di AI multiagente che consente l'orchestrazione delle risorse GraphRAG multimodali:
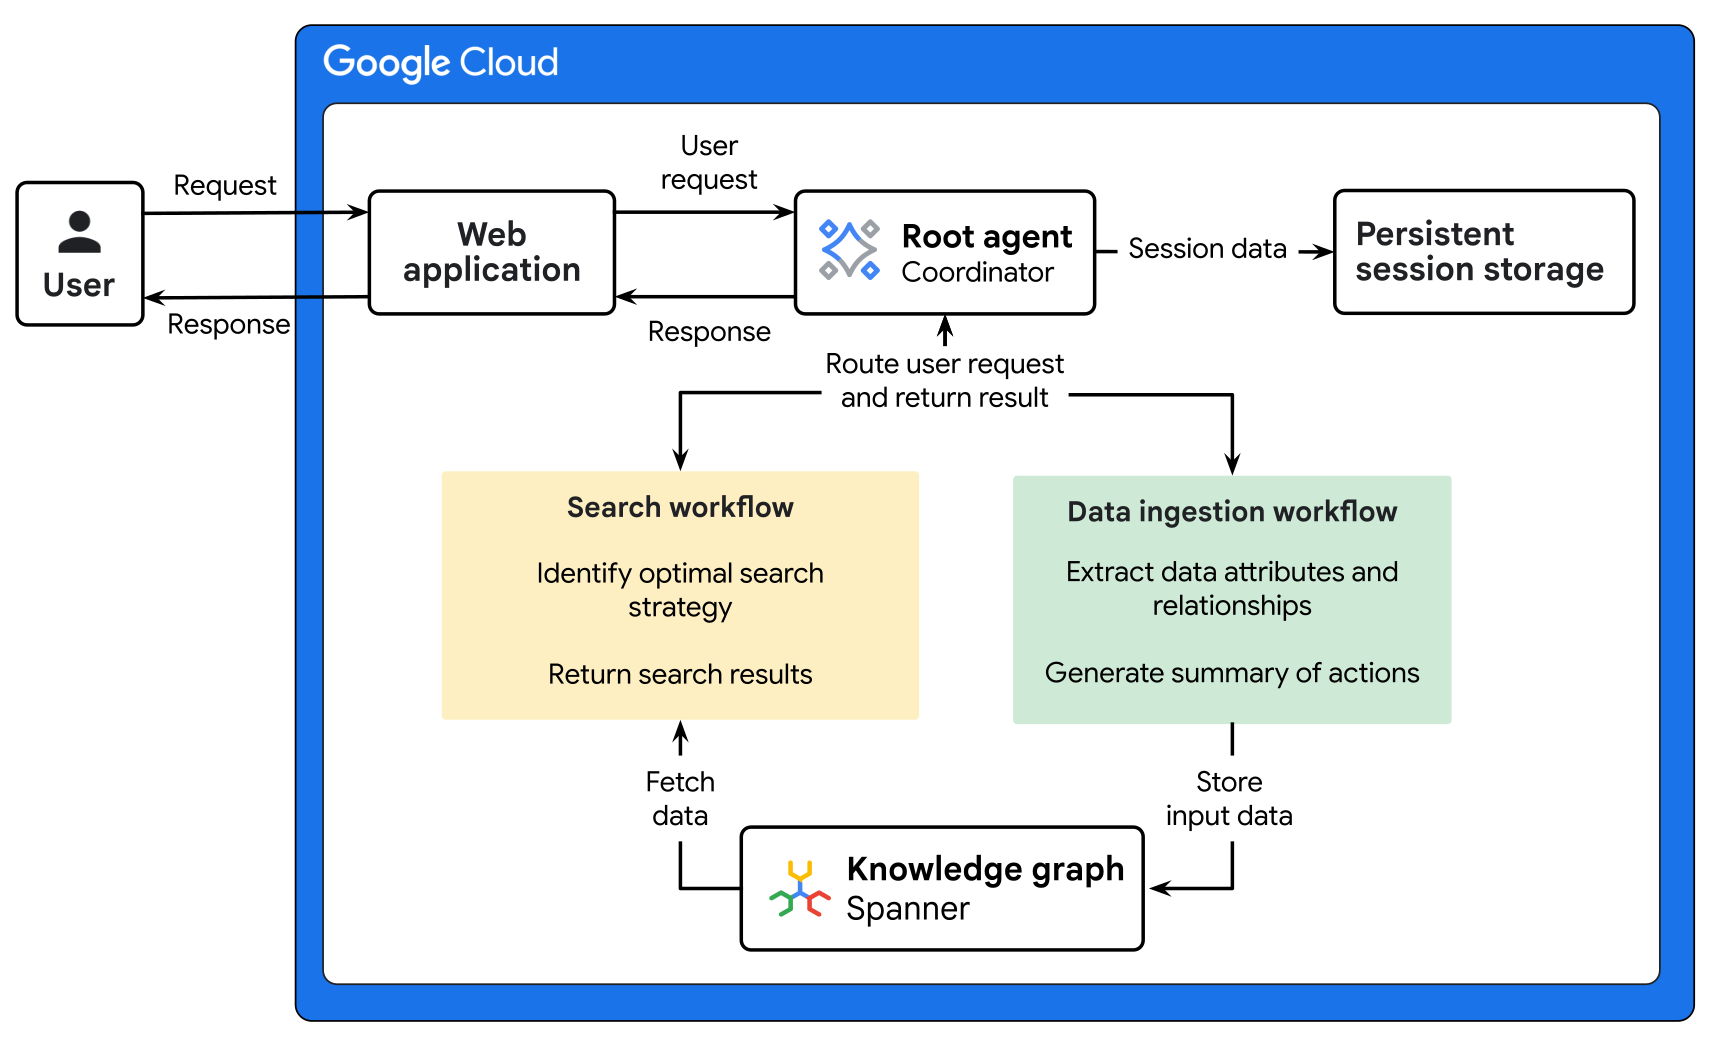
L'architettura nel diagramma precedente prevede due workflow: importazione dati e ricerca.
- Il workflow di acquisizione dei dati consolida i record multimodali frammentati nel knowledge graph unificato. Questo workflow utilizza un pattern multi-agente sequenziale per caricare i dati non elaborati in Cloud Storage, estrarre relazioni complesse utilizzando Gemini e aggiornare il knowledge graph di Spanner Graph per garantire che i dati siano disponibili per il recupero.
- Il workflow di ricerca consente di recuperare insight e risposte di base tramite un processo GraphRAG. Questo flusso di lavoro utilizza Gemini e subagenti specializzati per navigare nel knowledge graph e consolidare i risultati in base ai dati delle sessioni precedenti.
Le seguenti schede forniscono diagrammi dell'architettura che mostrano i flussi di lavoro di importazione dati e di ricerca:
Workflow di acquisizione dei dati
Il seguente diagramma mostra un'architettura dettagliata per un flusso di lavoro di importazione dati.
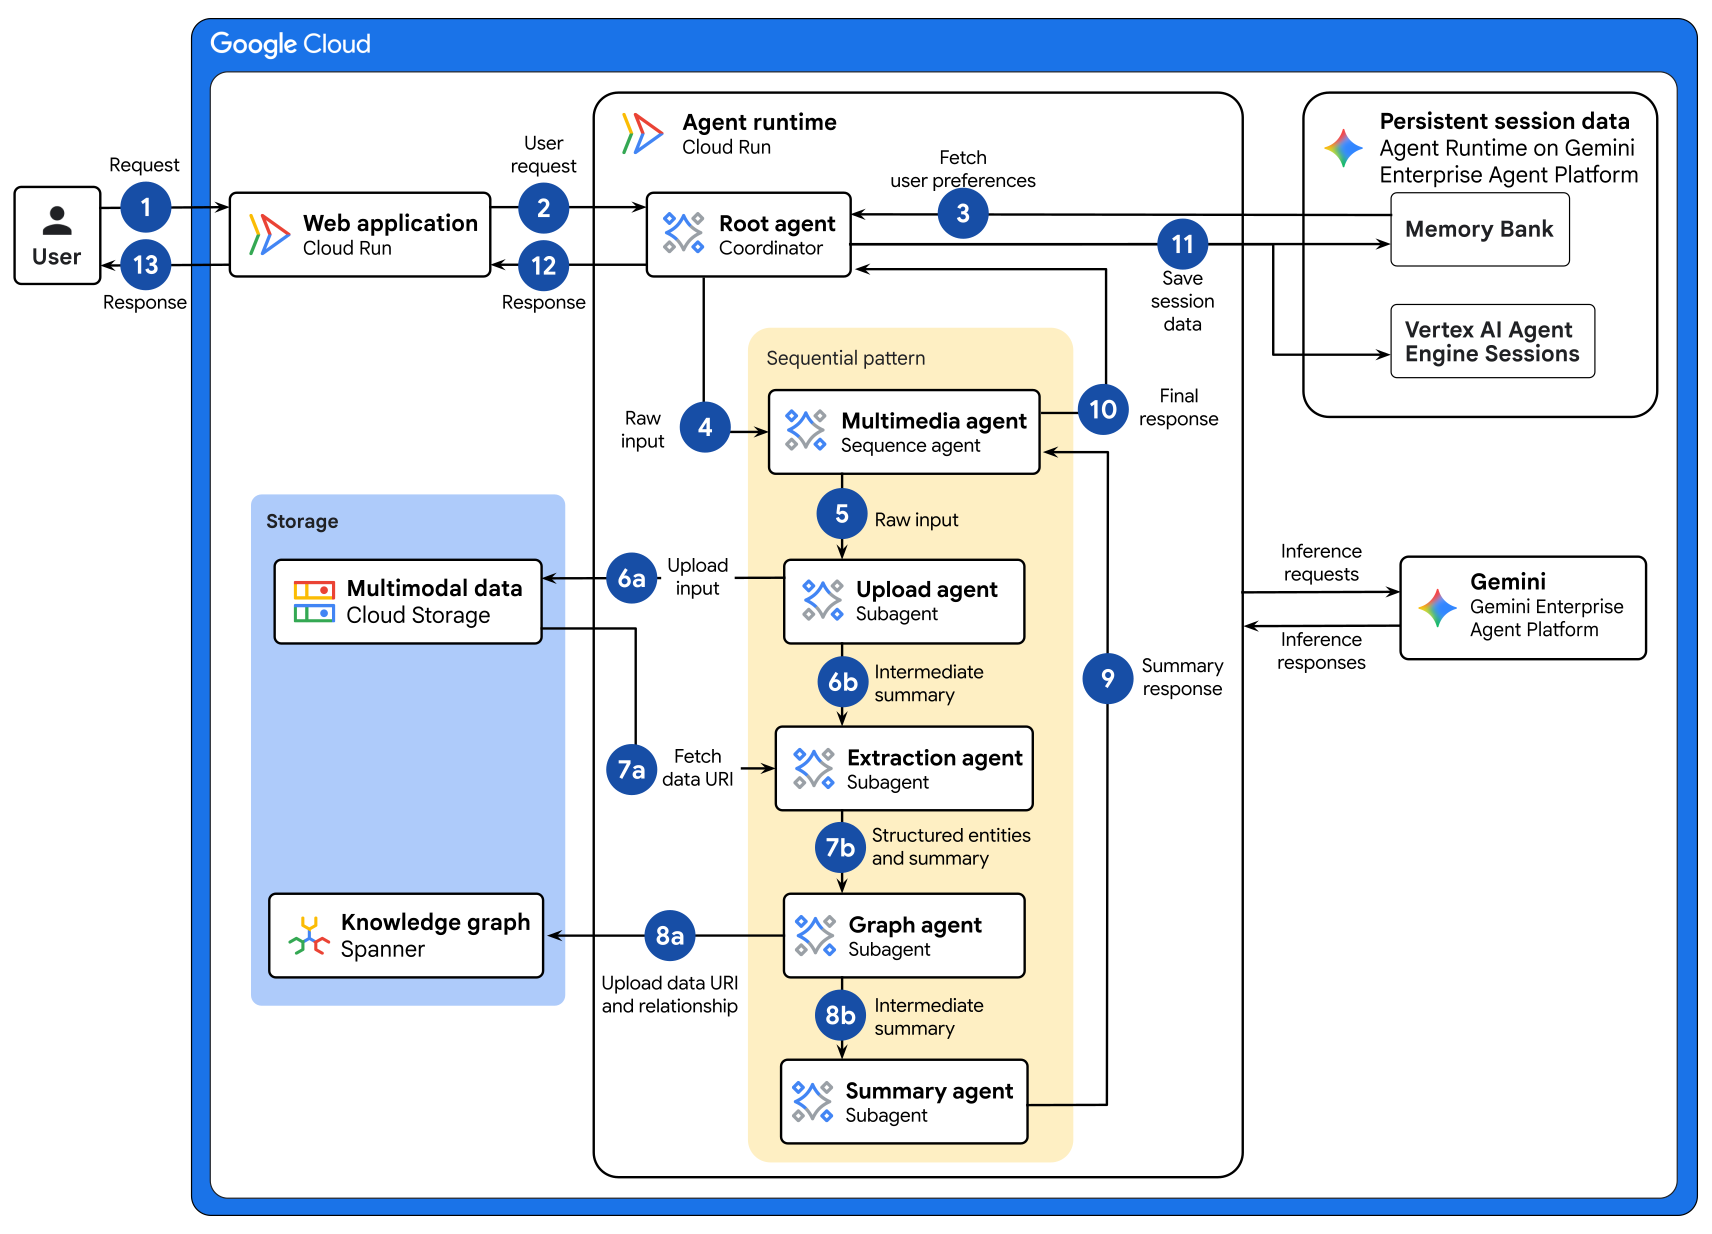
Il diagramma precedente mostra il seguente flusso di dati:
- L'utente interagisce con l'applicazione web per caricare nuovi dati. Ad esempio, un analista finanziario potrebbe caricare un PDF sugli utili, la registrazione di un'assemblea degli azionisti o un grafico sull'andamento del mercato.
- L'applicazione web inoltra la richiesta all'agente root. L'agente root è un agente coordinatore che riceve le richieste ed è stato eseguito il deployment su un servizio Cloud Run.
- L'agente principale recupera i dati della sessione persistente da Memory Bank per personalizzare i risultati di ricerca in base alle preferenze dell'utente delle sessioni precedenti.
- L'agente principale utilizza Gemini su Gemini Enterprise Agent Platform per interpretare la richiesta e delega l'attività all'agente multimediale per eseguire la pipeline di importazione dati.
- L'agente multimediale avvia il pattern sequenziale e inoltra l'input non elaborato all'agente di caricamento.
- L'agente di caricamento esegue le seguenti attività:
- Archivia il file non elaborato in un bucket Cloud Storage e rileva il tipo di media.
- Inoltra un riepilogo intermedio delle azioni eseguite all'agente di estrazione.
- L'agente di estrazione esegue le seguenti attività:
- Recupera l'URI dei dati dal bucket di archiviazione e utilizza Gemini per analizzare i dati e identificare le entità strutturate. Ad esempio, le entità dei dati finanziari possono includere filiali aziendali, trimestri fiscali e sentiment sulle entrate.
- Inoltra all'agente grafico le entità strutturate e il riepilogo intermedio delle azioni eseguite.
- L'agente grafico esegue le seguenti attività:
- Riceve le entità strutturate e carica i dati nel Knowledge Graph. Spanner Graph crea o collega nodi che rappresentano emittenti, stakeholder e strumenti di mercato.
- Inoltra un riepilogo intermedio delle azioni eseguite all'agente di riepilogo.
- L'agente di riepilogo produce una risposta che contiene un riepilogo testuale dei risultati dell'importazione e delle azioni eseguite da tutti i subagenti. L'agente di riepilogo invia la risposta all'agente multimediale.
- L'agente multimediale inoltra la risposta di riepilogo all'agente principale.
- L'agente principale attiva una funzione di callback per salvare i dati della sessione in Gemini Enterprise Agent Platform Sessions . L'agente principale estrae dalla sessione argomenti di memoria personalizzati per salvare informazioni sulle aree di interesse critiche. Ad esempio, un analista finanziario potrebbe creare un argomento di memoria per monitorare indicatori normativi o tendenze di settore.
- L'agente principale inoltra la risposta di riepilogo all'applicazione web.
- L'applicazione web inoltra la risposta all'utente.
Workflow di ricerca
Il seguente diagramma mostra un'architettura dettagliata per un workflow di ricerca.
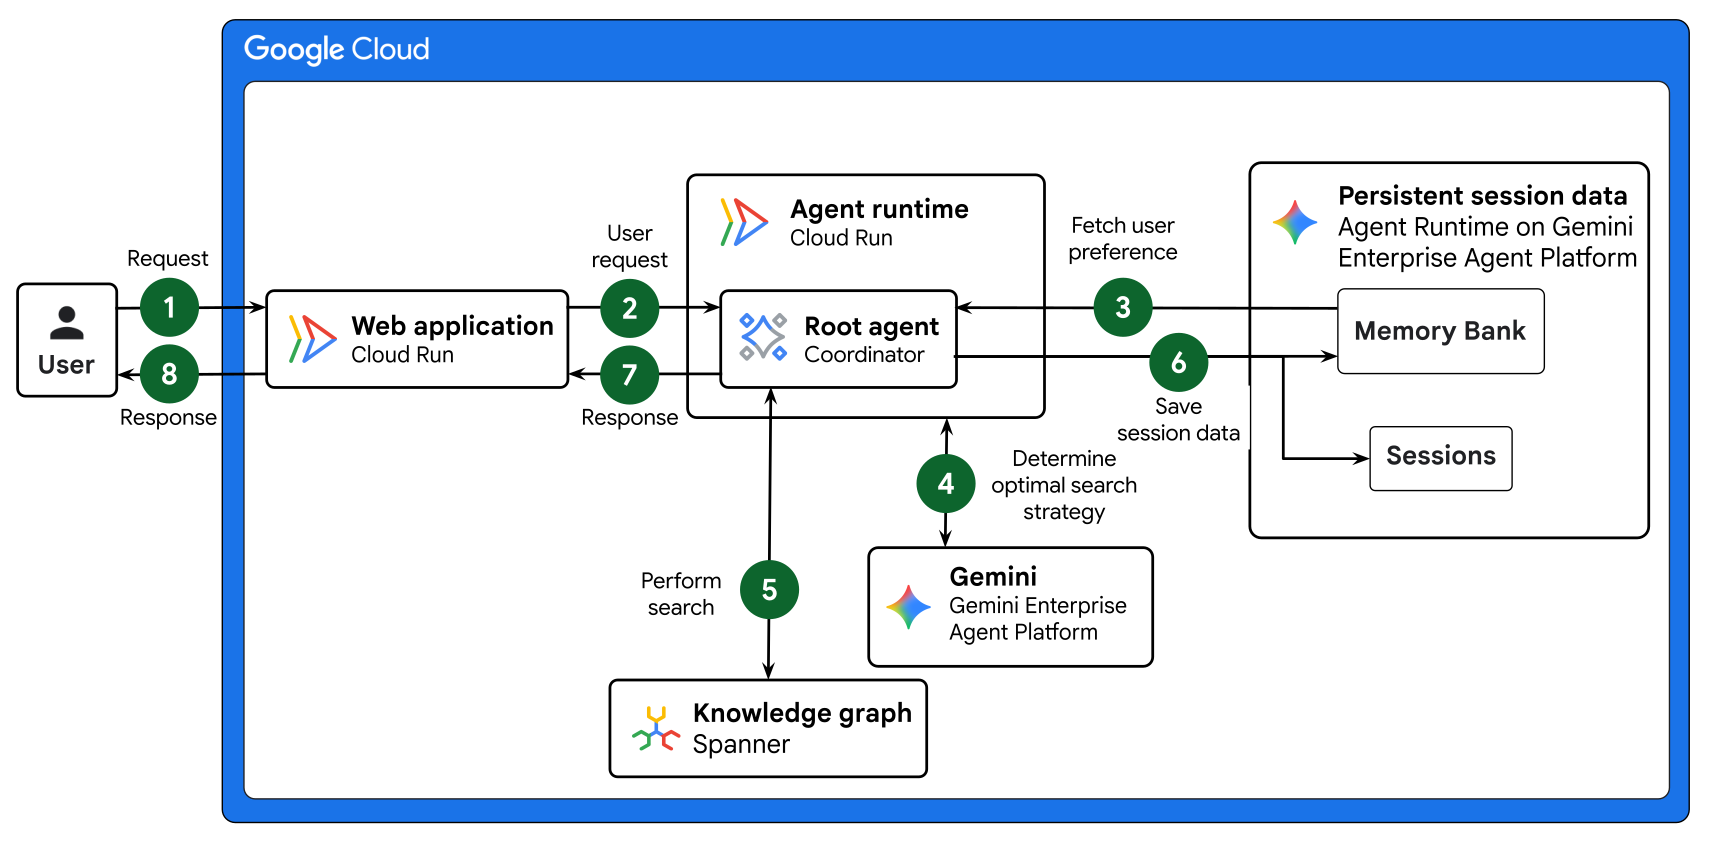
Il diagramma precedente mostra il seguente flusso di dati:
- Un utente avvia una richiesta di ricerca all'applicazione web. Ad esempio, un gestore di portafoglio invia una richiesta per rilevare eventuali pattern di transazioni circolari che coinvolgono più di tre entità in cui il volume totale supera 1 milione di dollari in un periodo di 24 ore.
- L'applicazione web inoltra la richiesta all'agente root. L'agente root è un agente coordinatore che riceve le richieste ed è stato eseguito il deployment su un servizio Cloud Run.
- L'agente principale recupera i dati della sessione persistente da Memory Bank per personalizzare i risultati di ricerca in base alle preferenze storiche e al contesto del gestore del portafoglio.
- L'agente principale utilizza Gemini su Agent Platform per determinare la strategia di ricerca ottimale:
- Ricerca per parole chiave: utilizza le clausole SQL
LIKEper trovare corrispondenze con categorie o località esatte. - Ricerca RAG semantica: Utilizza il modello di embedding e la distanza del coseno per trovare voci di dati semanticamente simili.
- Ricerca ibrida: esegue la ricerca per parole chiave e la ricerca RAG semantica e unisce i risultati utilizzando Reciprocal Rank Fusion (RRF) per garantire un'elevata pertinenza e copertura.
- Ricerca per parole chiave: utilizza le clausole SQL
- L'agente principale esegue la strategia di ricerca appropriata sul grafo della conoscenza, archiviato in Spanner Graph, e recupera i risultati di ricerca.
- L'agente principale attiva una funzione di callback per salvare i dati della sessione in Agent Platform Sessions. L'agente principale estrae dalla sessione gli argomenti di memoria personalizzati. Ad esempio, un gestore di portafoglio potrebbe creare un argomento di memoria per monitorare i segnali normativi o le tendenze emergenti del settore.
- L'agente principale inoltra la risposta di riepilogo all'applicazione web.
- L'applicazione web inoltra la risposta all'utente.
Prodotti utilizzati
Questa architettura di riferimento utilizza i seguenti prodotti e funzionalità di Google Cloud:
- Cloud Run: una piattaforma di serverless computing che consente di eseguire container direttamente sull'infrastruttura scalabile di Google.
- Gemini: una famiglia di modelli di AI multimodali sviluppati da Google.
- Gemini Enterprise Agent Platform: una piattaforma completa che ti consente di creare, scalare, gestire e ottimizzare agenti AI di livello enterprise.
- Cloud Storage: un archivio di oggetti a basso costo e senza limiti per diversi tipi di dati. I dati sono accessibili dall'interno e dall'esterno di Google Cloude vengono replicati in più località per la ridondanza.
- Spanner Graph: un database a grafo che offre le funzionalità di scalabilità, disponibilità e coerenza di Spanner.
- Sessioni della piattaforma agentica Gemini Enterprise: un servizio di archiviazione permanente che salva e recupera la cronologia delle interazioni tra un utente e gli agenti.
- Memory Bank: un servizio di archiviazione permanente che genera, perfeziona, gestisce e recupera le informazioni salvate a lungo termine in base alle conversazioni di un utente con un agente.
Per informazioni sulla selezione di componenti alternativi per il tuo sistema di AI agentica, tra cui framework, runtime dell'agente, strumenti, memoria e pattern di progettazione, consulta Scegli i componenti dell'architettura di AI agentica.
Caso d'uso
L'architettura è progettata per casi d'uso che consolidano e analizzano dati multimodali frammentati per ottimizzare l'allocazione delle risorse e il recupero di informazioni. Mantenendo subagenti indipendenti, il sistema supporta aggiornamenti modulari e garantisce che le risorse distribuite siano abbinate ai requisiti di ricerca con un'elevata continuità. L'integrazione di Spanner Graph come knowledge graph consente al sistema di AI agentica di modellare dati complessi e interconnessi. Questa integrazione facilita una comprensione contestuale approfondita e funzionalità di query sofisticate che possono essere difficili o inefficienti con i database relazionali o NoSQL.
Per i seguenti casi d'uso, un database a grafo è eccellente per rappresentare le connessioni arbitrarie e in evoluzione derivate da dati multimodali. Queste connessioni richiederebbero altrimenti una gestione complessa e rigida dello schema in un database relazionale.
Di seguito sono riportati alcuni esempi di casi d'uso per l'architettura descritta in questo documento:
- Mobilità dei talenti delle risorse umane aziendali: migliora la ricerca per parole chiave per la ricerca di assunzioni su larga scala identificando i candidati interni qualificati tramite l'espansione semantica. L'architettura estrae le competenze tecniche e le valutazioni delle soft skill dai portfolio multimodali e dalle presentazioni video per creare un grafico completo dei talenti. Il Knowledge Graph di Spanner traccia le relazioni tra dipendenti, competenze e cronologia dei progetti. I risultati della traccia identificano gli esperti in base alla profondità concettuale e segnalano i progetti con personale insufficiente.
- Analisi dei contenuti dei social media: identifica ricordi o tendenze specifici eseguendo un'analisi avanzata dei contenuti e della rete sulle piattaforme di social media. Il sistema elabora i caricamenti, come video, memo vocali e vlog, quindi estrae entità, argomenti, sentiment e menzioni. Il Knowledge Graph di Spanner traccia le relazioni tra gli utenti, le loro connessioni (amici e follower), i post, i Mi piace, i commenti, gli argomenti condivisi e le tendenze.
Considerazioni sulla progettazione
Le sezioni seguenti forniscono suggerimenti generali per la progettazione degli agenti AI e l'implementazione di questa architettura per la produzione.
Le indicazioni riportate in questa sezione non sono esaustive. Per saperne di più sui fattori di progettazione e sulle best practice, nonché per i consigli sulla creazione e sul deployment di un sistema di AI multi-agente, consulta Sistema di AI multi-agente in Google Cloud.
Design degli agenti AI
Per migliorare i costi e le prestazioni degli agenti, tieni presente i seguenti suggerimenti:
- Progettazione del sistema di agenti: scompone i workflow complessi in più agenti specializzati con responsabilità ben definite anziché in un agente monolitico. Questa separazione delle responsabilità semplifica il prompt engineering, riduce al minimo la deviazione delle istruzioni e consente la scalabilità granulare del modello. L'architettura indirizza le attività ben definite e di volume elevato a modelli più piccoli e veloci, riservando il ragionamento complesso ai modelli ad alta capacità.
- Progettazione degli strumenti: suddividi gli strumenti in più metodi mirati anziché utilizzare un unico metodo monolitico. Questo approccio garantisce la coerenza in tutto il codebase, riduce la ramificazione logica e consente percorsi di ottimizzazione specifici, come saltare l'analisi delle query quando viene richiamato un metodo di ricerca diretta.
- Contesto dell'agente: per evitare che gli agenti downstream ripetano le query sui dati upstream in una pipeline sequenziale, passa un contesto sufficiente tramite lo stato dell'agente. Utilizza strutture JSON ben definite per lo stato condiviso, in modo che ogni agente possa analizzare i dati in modo affidabile.
- Archiviazione dello stato della sessione: utilizza lo stato della sessione per la cronologia immediata delle conversazioni e Memory Bank per i fatti sintetizzati tra le sessioni. Inserisci il contesto della memoria all'inizio di una sessione in modo che l'agente possa fare riferimento alle preferenze senza dover rielaborare lunghe cronologie delle conversazioni.
- Qualità della memoria: consenti agli utenti di cancellare o aggiornare i ricordi obsoleti se le loro preferenze o i loro ruoli cambiano nel tempo.
Sicurezza, privacy e conformità
Per contribuire ad affrontare i rischi di sicurezza unici degli agenti AI, Google consiglia un approccio che combina controlli di sicurezza deterministici con difese dinamiche basate sul ragionamento:
- Supervisione umana: incorpora un flusso human-in-the-loop nei sistemi aziendali critici in modo che i supervisori umani possano esaminare gli output e approvare, ignorare o mettere in pausa le azioni degli agenti.
- Agent Identity: assegna a ogni agente un'identità associata al workload per applicare controllo dell'accesso con privilegio minimo e gestire centralmente le credenziali per gli strumenti esterni.
- Agent Gateway: applica la governance del traffico in entrata e in uscita, le policy di accesso con rifiuto predefinito e l'ispezione dei prompt e degli strumenti in linea con Model Armor.
Agent Registry: verifica che gli agenti si connettano solo a subagenti e strumenti MCP approvati.
Implementa il controllo granulare dell'accesso: utilizza il controllo granulare dell'accesso per autorizzare l'accesso a livello di tabella e colonna. Limita la policy del bucket Cloud Storage in modo che solo il account di servizio Cloud Run abbia accesso.
Sanifica l'inferenza e le risposte: utilizza Model Armor per ispezionare e sanificare sia le richieste di inferenza sia le risposte del modello. Questa sanitizzazione riduce i rischi di prompt injection derivanti dai contenuti multimodali caricati dagli utenti. Inoltre, aiuta a prevenire l'esfiltrazione accidentale di informazioni che consentono l'identificazione personale (PII) o dati sensibili negli output degli agenti.
Affidabilità
Per assicurarti che le configurazioni degli agenti soddisfino i tuoi requisiti di affidabilità, tieni presente i seguenti suggerimenti:
- Implementa la logica di ripetizione dei tentativi dell'agente: per gestire errori temporanei come i limiti di quota, implementa la logica di ripetizione dei tentativi con backoff esponenziale per le chiamate agli endpoint di Agent Platform e Spanner.
- Imposta limiti per i file: per evitare timeout dell'API dovuti a file di grandi dimensioni, imposta limiti espliciti per le dimensioni di caricamento e separa i video di grandi dimensioni in blocchi prima di estrarre le entità di dati. Per saperne di più, consulta Personalizza l'elaborazione dei video.
Efficienza operativa
Per assicurarti che le configurazioni degli agenti soddisfino i tuoi requisiti di efficienza operativa, tieni presente i seguenti suggerimenti:
- Utilizza il logging strutturato: registra tutte le chiamate degli strumenti dell'agente e i risultati della pipeline con metadati strutturati. I log strutturati ti consentono di eseguire query su log e dashboard in Cloud Monitoring.
- Implementa il tracciamento: per diagnosticare gli hotspot di latenza, utilizza Cloud Trace per acquisire tracce delle richieste end-to-end nell'esecutore dell'agente e nell'esecuzione dello strumento.
- Valuta la qualità dell'agente: valuta periodicamente la qualità dell'output dell'agente utilizzando il servizio di valutazione dell'AI generativa per verificare le traiettorie di selezione degli strumenti e la qualità delle risposte.
Ottimizzazione dei costi
Per assicurarti che le configurazioni degli agenti soddisfino i requisiti di costo, tieni presente i seguenti suggerimenti:
- Costi di archiviazione: per ridurre i costi di archiviazione, utilizza la Gestione del ciclo di vita degli oggetti per spostare i file nelle classi di archiviazione Nearline o Coldline dopo un periodo di conservazione definito.
- Analisi e gestione dei costi: per analizzare e gestire i costi della piattaforma Agent, ti consigliamo di creare metriche di riferimento per le query al secondo (QPS) e i token al secondo (TPS). Poi monitora queste metriche dopo il deployment. La base di riferimento che crei nell'ambito della gestione dei costi può aiutarti a determinare la pianificazione della capacità. Ad esempio, la baseline ti aiuta a determinare quando potrebbe essere necessario il throughput riservato.
Ottimizzazione delle prestazioni
Per assicurarti che le configurazioni degli agenti soddisfino i tuoi requisiti di prestazioni, tieni presente i seguenti suggerimenti:
- Routing dell'agente principale: per ridurre al minimo la latenza ed evitare chiamate non necessarie degli agenti secondari, definisci chiaramente la logica di routing nelle istruzioni dell'agente. Assicurati che lo scopo, i parametri di input e gli output previsti di ogni strumento siano documentati in stringhe letterali per aiutare il modello a selezionare lo strumento corretto.
- Modelli di AI nel database: per ridurre la latenza, utilizza la funzione Spanner
ML.PREDICTper chiamare i modelli in linea all'interno delle query SQL. Monitora l'utilizzo della quota di Agent Platform, poiché i workload di ricerca ibrida possono attivare più chiamate al modello per query. - Allocazione delle risorse: a seconda dei requisiti di prestazioni, configura i limiti di memoria e i limiti di CPU da allocare al servizio Cloud Run.
Deployment
Per eseguire il deployment di un'implementazione di esempio di questa architettura, prova il codelab Way Back Home Level 2.
Passaggi successivi
- Scopri come ospitare agenti AI su Cloud Run.
- Scopri come creare un'infrastruttura GraphRAG per l'AI generativa utilizzando Agent Platform e Spanner Graph.
- Scopri le best practice per la progettazione dello schema Spanner Graph.
- Scopri come ottenere embedding multimodali.
- Scopri come creare un sistema di AI multi-agente in Google Cloud.
- Esplora le risorse di apprendimento per creare ed eseguire il deployment di agenti di livello enterprise con Gemini Enterprise Agent Ready (GEAR).
- Per una panoramica dei principi e dei suggerimenti di architettura specifici per i workload di AI e ML in Google Cloud, consulta la prospettiva di AI e ML nel Well-Architected Framework.
- Per ulteriori architetture di riferimento, diagrammi e best practice, esplora Cloud Architecture Center.
Collaboratori
Autori:
- Annie Wang | Software Engineer
- Samantha He | Technical Writer
Altri collaboratori:
- Christina Lin | Developer Relations Engineer Manager
- Kumar Dhanagopal | Cross-Product Solution Developer
- Olivier Bourgeois | Developer Relations Engineer