


Dieses Dokument bietet eine allgemeine Architektur für ein Multi-Agenten-KI-System, das fragmentierte multimodale Daten in einem durchsuchbaren Knowledge Graph zusammenführt. Mit dem System können Nutzer Daten hochladen und dann den Knowledge Graph verwenden, um potenzielle Probleme oder systemische Risiken zu identifizieren. Die Architektur ermöglicht es Agenten, komplexe Datennetze zu durchsuchen und eine langfristige Personalisierung beizubehalten. Sie sorgt dafür, dass verteilte Ressourcen kontinuierlich an die Suchanforderungen angepasst werden.
GraphRAG ist ein graphbasierter Ansatz für die Retrieval-Augmented Generation (RAG). RAG trägt dazu bei, KI-generierte Antworten zu fundieren, indem Prompts mit kontextrelevanten Daten ergänzt werden, die mithilfe der Vektorsuche abgerufen werden. GraphRAG kombiniert die Vektorsuche mit einer Knowledge Graph-Abfrage, um Kontextdaten abzurufen, die die Vernetzung von Daten aus verschiedenen Quellen besser widerspiegeln. Prompts, die mit GraphRAG ergänzt werden, können detailliertere und relevantere KI-Antworten generieren.
Die Zielgruppe für dieses Dokument umfasst Architekten, Entwickler und Administratoren, die KI-Infrastruktur und ‑Anwendungen in der Cloud erstellen und verwalten. In diesem Dokument wird davon ausgegangen, dass Sie über grundlegende Kenntnisse zu KI-Agenten und ‑Modellen verfügen. Das Dokument enthält keine spezifischen Anleitungen zum Entwerfen und Programmieren von KI-Agenten.
Der Abschnitt Bereitstellung dieses Dokuments enthält ein Codebeispiel, das zeigt, wie Sie ein Spanner Graph-Schema definieren und multimodale Entitäten für den agentischen Abruf verknüpfen.
Architektur
Das folgende Diagramm zeigt eine allgemeine Ansicht der Architektur eines Multi-Agenten-KI-Systems, das die multimodale GraphRAG-Ressourcenorchestrierung ermöglicht:
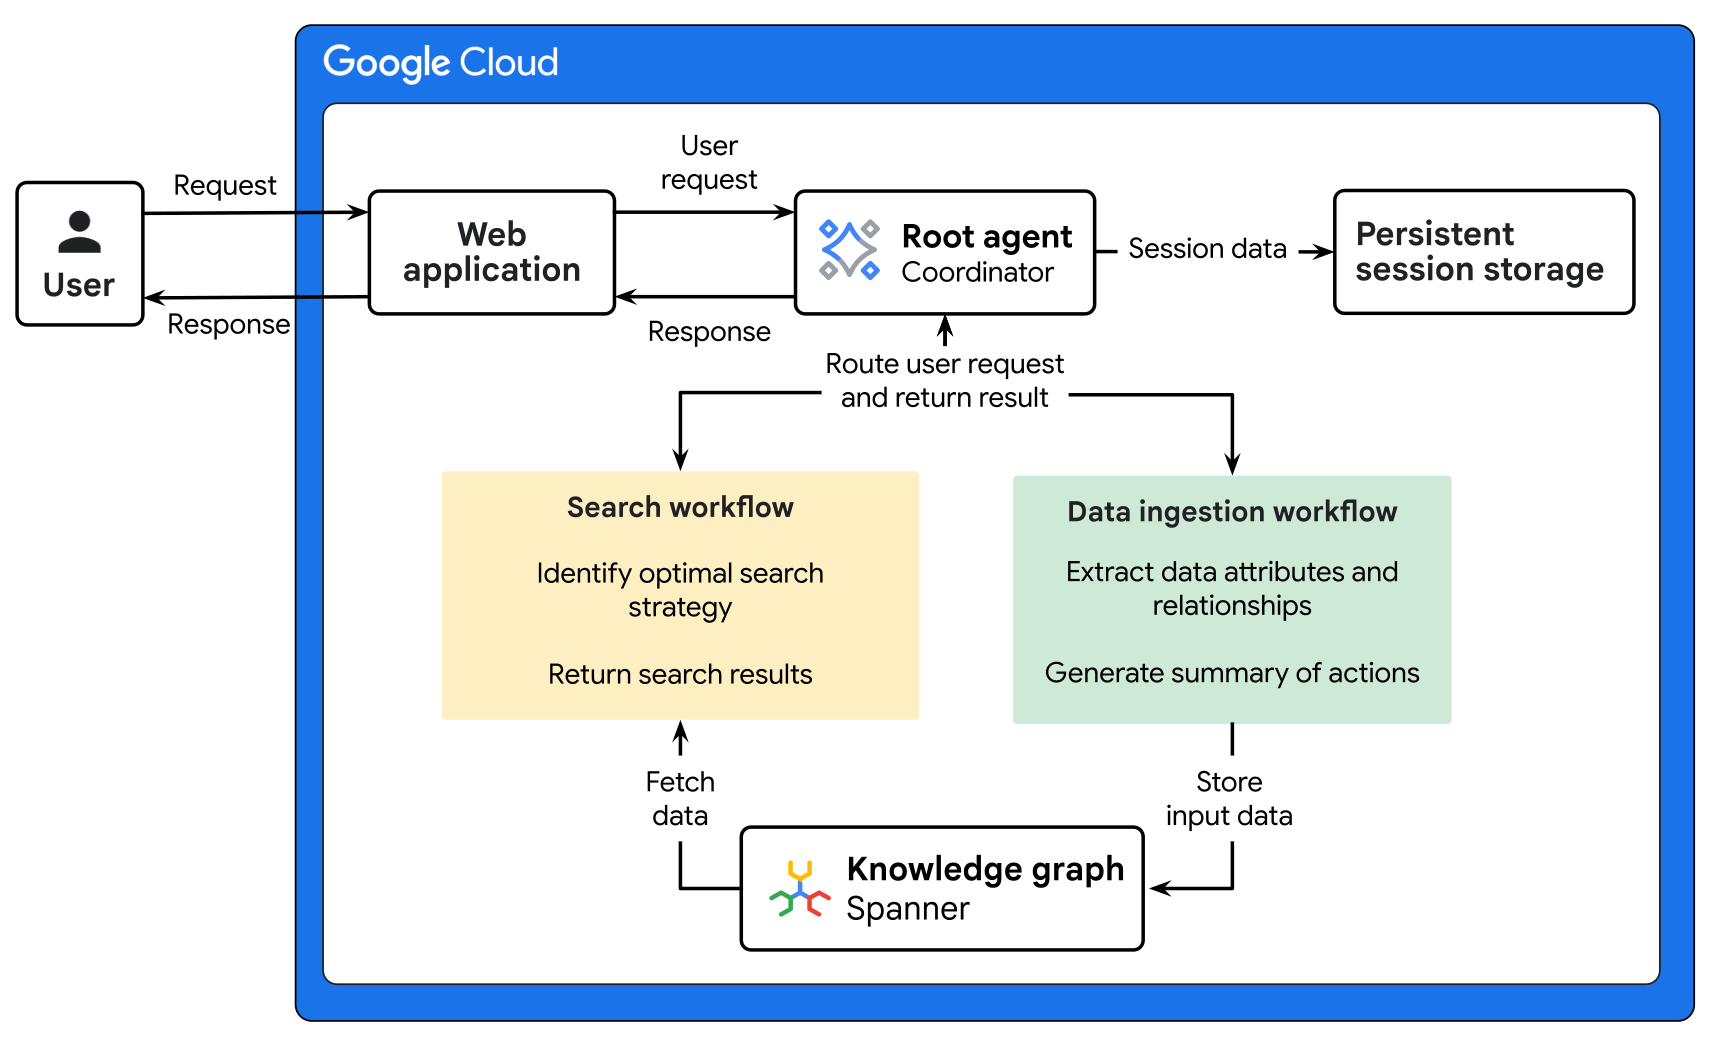
Die Architektur im vorherigen Diagramm umfasst zwei Workflows: Datenaufnahme und Suche.
- Im Workflow Datenaufnahme werden fragmentierte multimodale Datensätze im einheitlichen Knowledge Graph zusammengeführt. Dieser Workflow verwendet ein sequenzielles Multi-Agenten-Muster, um Rohdaten in Cloud Storage hochzuladen, komplexe Beziehungen mit Gemini zu extrahieren und den Spanner Graph-Knowledge Graph zu aktualisieren, damit die Daten für den Abruf verfügbar sind.
- Mit dem Workflow Suche können Sie über einen GraphRAG-Prozess Statistiken abrufen und Antworten fundieren. In diesem Workflow werden Gemini und spezielle Sub-Agenten verwendet, um den Knowledge Graph zu durchsuchen und Ergebnisse auf Grundlage der Daten aus der vorherigen Sitzung zusammenzuführen.
Auf den folgenden Tabs finden Sie Architekturdiagramme, die die Workflows für die Datenaufnahme und die Suche zeigen:
Workflow für die Datenaufnahme
Das folgende Diagramm zeigt eine detaillierte Architektur für einen Workflow zur Datenaufnahme.
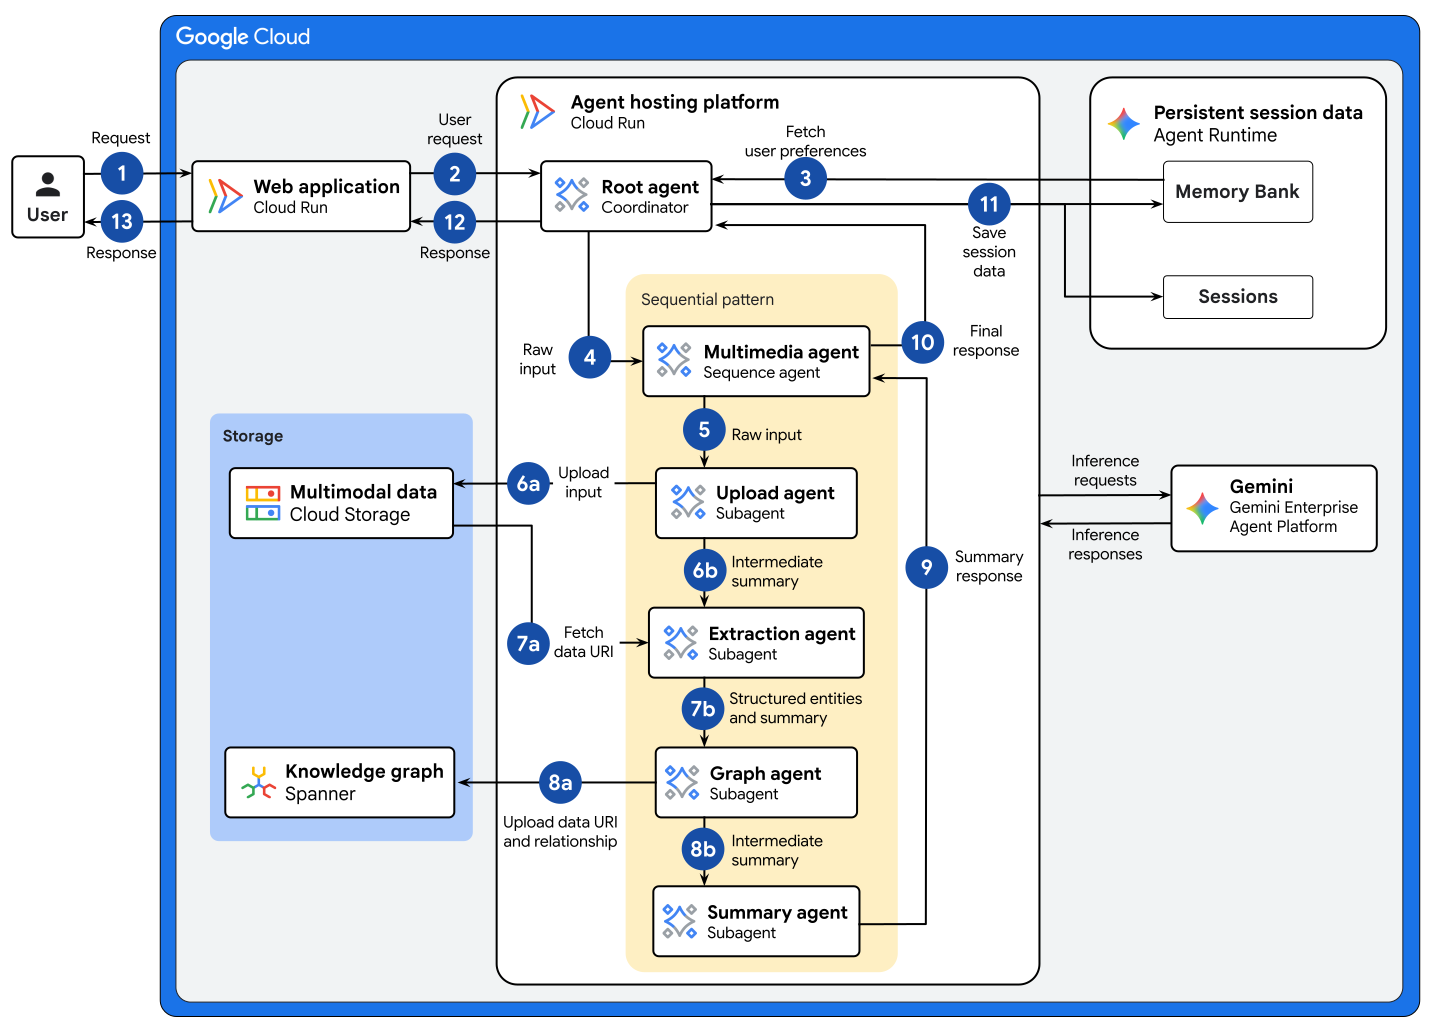
Das obige Diagramm zeigt den folgenden Datenfluss:
- Der Nutzer interagiert mit der Webanwendung, um neue Daten hochzuladen. Ein Finanzanalyst kann beispielsweise ein PDF mit den Einnahmen, eine Aufzeichnung einer Aktionärsversammlung oder ein Diagramm zur Marktentwicklung hochladen.
- Die Webanwendung leitet die Anfrage an den Root-Agenten weiter. Der Root-Agent ist ein Koordinations Agent, der Anfragen empfängt und in einem Cloud Run Dienst bereitgestellt wird.
- Der Root-Agent ruft persistente Sitzungsdaten aus Memory Bank ab, um die Suchergebnisse anhand der Einstellungen des Nutzers aus früheren Sitzungen zu personalisieren.
- Der Root-Agent verwendet Gemini auf der Gemini Enterprise Agent Platform, um die Anfrage zu interpretieren, und delegiert die Aufgabe an den Multimedia-Agenten, um die Datenaufnahmepipeline auszuführen.
- Der Multimedia-Agent initiiert das sequenzielle Muster und leitet die Rohdaten an den Upload-Agenten weiter.
- Der Upload-Agent führt die folgenden Aufgaben aus:
- Speichert die Rohdatei in einem Cloud Storage-Bucket und erkennt den Medientyp.
- Leitet eine vorläufige Zusammenfassung der ausgeführten Aktionen an den Extraktions-Agenten weiter.
- Der Extraktions-Agent führt die folgenden Aufgaben aus:
- Ruft den Daten-URI aus dem Storage-Bucket ab und verwendet Gemini, um die Daten zu parsen und strukturierte Entitäten zu identifizieren. Zu den Entitäten von Finanzdaten können beispielsweise Tochtergesellschaften, Geschäftsjahre und Umsatzstimmung gehören.
- Leitet die strukturierten Entitäten und die vorläufige Zusammenfassung der ausgeführten Aktionen die es an den Graph-Agenten ausgeführt hat weiter.
- Der Graph-Agent führt die folgenden Aufgaben aus:
- Empfängt die strukturierten Entitäten und lädt die Daten in den Knowledge Graph hoch. Spanner Graph erstellt oder verknüpft Knoten, die Emittenten, Stakeholder und Marktinstrumente darstellen.
- Leitet eine vorläufige Zusammenfassung der ausgeführten Aktionen an den Zusammenfassungs-Agenten weiter.
- Der Zusammenfassungs-Agent erstellt eine Antwort mit einer Textzusammenfassung der Aufnahmeergebnisse und der Aktionen, die von allen Sub-Agenten ausgeführt wurden. Der Zusammenfassungs-Agent sendet die Antwort an den Multimedia-Agenten.
- Der Multimedia-Agent leitet die Zusammenfassungsantwort an den Root Agenten zurück.
- Der Root-Agent löst eine Callback-Funktion aus, um Sitzungsdaten in Gemini Enterprise Agent Platform Sessions zu speichern. Der Root-Agent extrahiert benutzerdefinierte Memory-Themen aus der Sitzung, um Informationen zu wichtigen Schwerpunkten zu speichern. Ein Finanzanalyst kann beispielsweise ein Memory-Thema erstellen, um regulatorische Flags oder sektorspezifische Trends zu verfolgen.
- Der Root-Agent leitet die Zusammenfassungsantwort an die Webanwendung weiter.
- Die Webanwendung leitet die Antwort an den Nutzer zurück.
Workflow für die Suche
Das folgende Diagramm zeigt eine detaillierte Architektur für einen Workflow für die Suche.
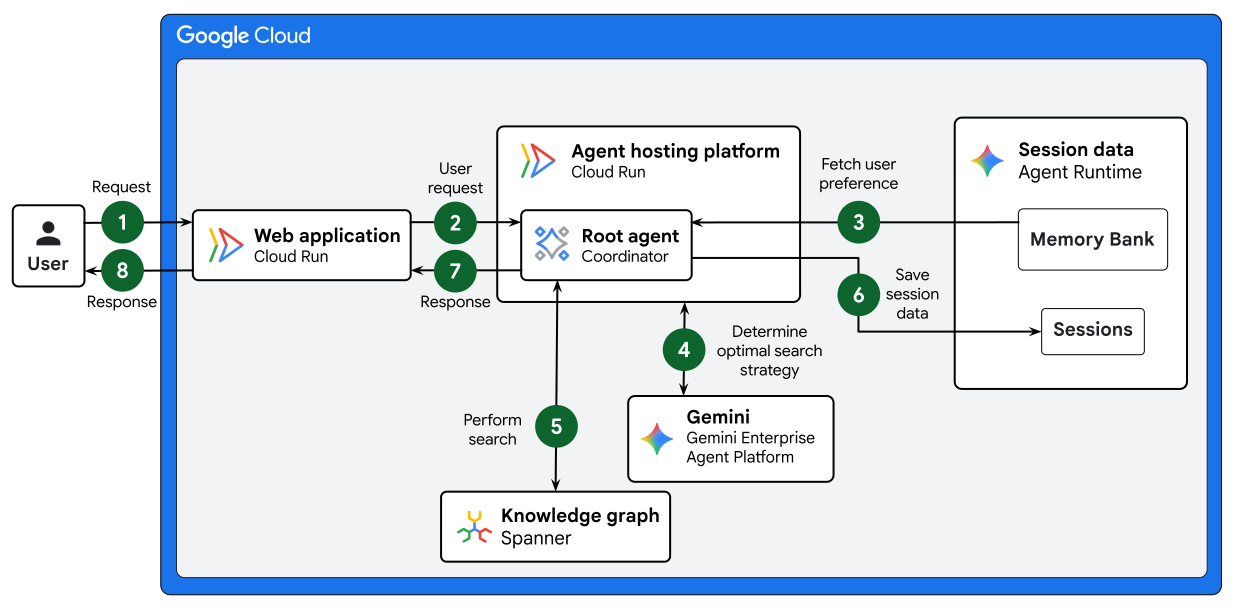
Das obige Diagramm zeigt den folgenden Datenfluss:
- Ein Nutzer initiiert eine Suchanfrage an die Webanwendung. Ein Portfoliomanager sendet beispielsweise eine Anfrage, um zirkuläre Transaktionsmuster zu erkennen, an denen mehr als drei Entitäten beteiligt sind und bei denen das Gesamtvolumen innerhalb von 24 Stunden 1 Million US-Dollar übersteigt.
- Die Webanwendung leitet die Anfrage an den Root-Agenten weiter. Der Root-Agent ist ein Koordinations-Agent, der Anfragen empfängt und in einem Cloud Run Dienst bereitgestellt wird.
- Der Root-Agent ruft persistente Sitzungsdaten aus Memory Bank ab, um die Suchergebnisse anhand der bisherigen Einstellungen und des Kontexts des Portfoliomanagers zu personalisieren.
- Der Root-Agent verwendet Gemini auf der Agent Platform, um
die optimale Suchstrategie zu ermitteln:
- Stichwortsuche: Verwendet SQL
LIKEKlauseln, um genaue Kategorien oder Standorte zu finden. - Semantische RAG-Suche: Verwendet das Einbettungsmodell und die Kosinus Distanz, um semantisch ähnliche Dateneinträge zu finden.
- Hybridsuche: Führt eine Stichwortsuche und eine semantische RAG-Suche aus und führt die Ergebnisse mit Reciprocal Rank Fusion (RRF) zusammen, um eine hohe Relevanz und Abdeckung zu gewährleisten.
- Stichwortsuche: Verwendet SQL
- Der Root-Agent führt die entsprechende Suchstrategie im Knowledge Graph aus, der in Spanner Graph gespeichert ist, und ruft die Suchergebnisse ab.
- Der Root-Agent löst eine Callback-Funktion aus, um Sitzungsdaten in Agent Platform Sessions zu speichern. Der Root-Agent extrahiert benutzerdefinierte Memory Themen aus der Sitzung. Ein Portfoliomanager kann beispielsweise ein Memory-Thema erstellen, um regulatorische Flags oder neue sektorspezifische Trends zu verfolgen.
- Der Root-Agent leitet die Zusammenfassungsantwort an die Webanwendung weiter.
- Die Webanwendung leitet die Antwort an den Nutzer zurück.
Verwendete Produkte
In dieser Referenzarchitektur werden die folgenden Google Cloud Produkte und Funktionen verwendet:
- Cloud Run: Eine serverlose Computing-Plattform, mit der Sie Container direkt auf der skalierbaren Infrastruktur von Google ausführen können.
- Gemini: Gemini umfasst eine Reihe multimodaler KI-Modelle, die von Google entwickelt wurden.
- Gemini Enterprise Agent Platform ist eine umfassende Plattform, mit der Sie KI-Agenten auf Unternehmensniveau erstellen, skalieren, verwalten und optimieren können.
- Cloud Storage: Ein kostengünstiger, unbegrenzter Objektspeicher für verschiedene Datentypen. Auf Daten kann von innerhalb und außerhalb zugegriffen werden Google Cloud. Sie werden zu Redundanzzwecken über Standorte hinweg repliziert.
- Spanner Graph: Eine Graphdatenbank, die die Skalierbarkeits-, Verfügbarkeits- und Konsistenzfunktionen von Spanner bietet.
- Gemini Enterprise Agent Platform Sessions: Ein nichtflüchtiger Speicherdienst, in dem der Verlauf der Interaktionen zwischen einem Nutzer und Agenten gespeichert und abgerufen wird.
- Memory Bank: Ein nichtflüchtiger Speicherdienst, der langfristige Erinnerungen auf Grundlage der Unterhaltungen eines Nutzers mit einem Agenten generiert, verfeinert, verwaltet und abruft.
Informationen zum Auswählen alternativer Komponenten für Ihr agentisches KI System, einschließlich Framework, Agentenlaufzeit, Tools, Speicher und Designmuster, finden Sie unter Komponenten für agentische KI-Architektur auswählen.
Anwendungsfall
Die Architektur ist für Anwendungsfälle konzipiert, in denen fragmentierte multimodale Daten zusammengeführt und analysiert werden, um die Ressourcenzuweisung und den Informationsabruf zu optimieren. Durch die Verwendung unabhängiger Sub-Agenten unterstützt das System modulare Updates und sorgt dafür, dass verteilte Ressourcen kontinuierlich an die Suchanforderungen angepasst werden. Durch die Einbindung von Spanner Graph als Knowledge Graph kann das agentische KI-System komplexe, vernetzte Daten modellieren. Diese Einbindung ermöglicht ein umfassendes kontextbezogenes Verständnis und ausgefeilte Abfragefunktionen, die mit relationalen oder NoSQL-Datenbanken schwierig oder ineffizient sein können.
Für die folgenden Anwendungsfälle eignet sich eine Graphdatenbank hervorragend, um die beliebigen und sich entwickelnden Verbindungen darzustellen, die aus multimodalen Daten abgeleitet werden. Andernfalls wäre in einer relationalen Datenbank eine komplexe und starre Schemaverwaltung erforderlich.
Im Folgenden finden Sie Beispiele für Anwendungsfälle für die in diesem Dokument beschriebene Architektur:
- Enterprise HR Talentmobilität: Verbessern Sie die Stichwortsuche für die Suche nach Mitarbeitern in großem Maßstab, indem Sie qualifizierte interne Kandidaten durch semantische Erweiterung identifizieren. Die Architektur extrahiert technische Fähigkeiten und Bewertungen von Soft Skills aus multimodalen Portfolios und Video-Vorstellungen, um einen umfassenden Talent-Graph zu erstellen. Der Spanner-Knowledge Graph verfolgt Beziehungen zwischen Mitarbeitern, Kompetenzen und dem Projektverlauf. Die Ergebnisse der Verfolgung identifizieren Experten anhand der konzeptionellen Tiefe und kennzeichnen unterbesetzte Projekte.
- Inhaltsanalyse von Social Media: Identifizieren Sie bestimmte Erinnerungen oder Trends, indem Sie eine erweiterte Inhaltssuche und Netzwerkanalyse auf Social-Media-Plattformen durchführen. Das System verarbeitet Uploads wie Videos, Sprachmemos und Vlogs und extrahiert dann Entitäten, Themen, Stimmung und Erwähnungen. Der Spanner-Knowledge Graph verfolgt Beziehungen zwischen Nutzern, ihren Verbindungen (Freunden und Followern), Beiträgen, Likes, Kommentaren, gemeinsamen Themen und Trends.
Designaspekte
In den folgenden Abschnitten finden Sie allgemeine Empfehlungen zum Entwerfen der KI-Agenten und zum Implementieren dieser Architektur für die Produktion.
Die Anleitung in diesem Abschnitt ist nicht vollständig. Weitere Informationen zu Designfaktoren und Best Practices sowie Empfehlungen zum Erstellen und Bereitstellen eines Multi-Agenten-KI-Systems finden Sie unter Multi-Agenten-KI-System in Google Cloud.
Design von KI-Agenten
Beachten Sie die folgenden Empfehlungen, um die Kosten und die Leistung Ihrer Agenten zu verbessern:
- Design des Agentensystems: Zerlegen Sie komplexe Workflows in mehrere spezialisierte Agenten mit klar definierten Verantwortlichkeiten anstelle eines monolithischen Agenten. Diese Trennung der Zuständigkeiten vereinfacht das Prompt-Engineering, minimiert die Abweichung von Anweisungen und ermöglicht eine detaillierte Modellskalierung. Die Architektur leitet Aufgaben mit hohem Volumen und klar definierten Aufgaben an kleinere, schnellere Modelle weiter, während komplexe Schlussfolgerungen für Modelle mit hoher Kapazität reserviert werden.
- Tool-Design: Trennen Sie Tools in mehrere fokussierte Methoden auf, anstatt eine einzelne monolithische Methode zu verwenden. Dieser Ansatz sorgt für Konsistenz in der gesamten Codebasis, reduziert die Verzweigung der Logik und ermöglicht spezifische Optimierungspfade, z. B. das Überspringen der Abfrageanalyse, wenn eine direkte Suchmethode aufgerufen wird.
- Agentenkontext: Damit nachgeschaltete Agenten in einer sequenziellen Pipeline keine Abfragen für Upstream-Daten wiederholen, geben Sie über den Agentenzustand ausreichend Kontext weiter. Verwenden Sie klar definierte JSON-Strukturen für den gemeinsamen Zustand, damit jeder Agent Daten zuverlässig parsen kann.
- Speicher für Sitzungszustand: Verwenden Sie den Sitzungszustand für den unmittelbaren Unterhaltungsverlauf und die Memory Bank für destillierte Fakten über Sitzungen hinweg. Fügen Sie zu Beginn einer Sitzung einen Memory-Kontext ein, damit der Agent auf Einstellungen verweisen kann, ohne lange Unterhaltungsverläufe neu verarbeiten zu müssen.
- Speicherqualität: Ermöglichen Sie Nutzern veraltete Erinnerungen zu löschen oder zu aktualisieren wenn sich ihre Einstellungen oder Rollen im Laufe der Zeit ändern.
Sicherheit, Datenschutz und Compliance
Um die einzigartigen Sicherheitsrisiken von KI-Agenten zu minimieren, empfiehlt Google einen Ansatz der deterministische Sicherheitskontrollen mit dynamischen, auf Schlussfolgerungen basierenden Abwehrmaßnahmen kombiniert:
- Menschliche Aufsicht: Integrieren Sie in geschäftskritischen Systemen einen Human-in-the-Loop-Ablauf, damit menschliche Aufsichtspersonen Ausgaben überprüfen und Agentenaktionen genehmigen, überschreiben oder pausieren können.
- Agentenidentität: Weisen Sie jedem Agenten eine arbeitslastbezogene Identität zu, um die Zugriffssteuerung nach dem Prinzip der geringsten Berechtigung zu erzwingen und Anmeldedaten für externe Tools zentral zu verwalten.
- Agenten-Gateway: Erzwingen Sie die Governance für eingehenden und ausgehenden Traffic, Standardzugriffsrichtlinien, und die Inline-Überprüfung von Prompts und Tools mit Model Armor.
Agentenregistrierung: Prüfen Sie, ob Agenten nur eine Verbindung zu genehmigten Sub-Agenten und MCP-Tools herstellen.
Detaillierte Zugriffssteuerung implementieren: Verwenden Sie die detaillierte Zugriffssteuerung, um den Zugriff auf Tabellen- und Spaltenebene zu autorisieren. Beschränken Sie die Cloud Storage-Bucket-Richtlinie so, dass nur das Cloud Run-Dienstkonto Zugriff hat.
Inferenz und Antworten bereinigen: Verwenden Sie Model Armor, um sowohl Inferenzanfragen als auch Modellantworten zu prüfen und zu bereinigen. Durch diese Bereinigung werden Risiken durch Prompt-Injection aus multimodalen Inhalten, die Nutzer hochladen, minimiert. Außerdem wird verhindert, dass personenidentifizierbare Informationen oder vertrauliche Daten versehentlich in Agentenausgaben offengelegt werden.
Zuverlässigkeit
Beachten Sie die folgenden Empfehlungen, damit Ihre Agentenkonfigurationen Ihre Zuverlässigkeitsanforderungen erfüllen:
- Wiederholungslogik für Agenten implementieren: Um vorübergehende Fehler wie Kontingentlimits zu beheben, implementieren Sie eine Wiederholungslogik mit exponentiellem Backoff für Aufrufe von Agent Platform-Endpunkten und Spanner.
- Dateilimits festlegen: Um API-Zeitüberschreitungen durch große Dateien zu vermeiden, legen Sie explizite Limits für die Uploadgröße fest und teilen Sie große Videos in Chunks auf, bevor Datenentitäten extrahiert werden. Weitere Informationen finden Sie unter Videoverarbeitung anpassen.
Betriebliche Effizienz
Beachten Sie die folgenden Empfehlungen, damit Ihre Agentenkonfigurationen Ihre Anforderungen an die betriebliche Effizienz erfüllen:
- Strukturierte Protokollierung verwenden: Protokollieren Sie alle Aufrufe von Agenten-Tools und Pipeline Ergebnisse mit strukturierten Metadaten. Mit strukturierten Logs können Sie Logs und Dashboards in Cloud Monitoringabfragen.
- Tracing implementieren: Verwenden Sie Cloud Trace, um Latenz-Hotspots zu diagnostizieren und End-to-End-Anfragetraces über die Ausführung von Agenten und Tools hinweg zu erfassen.
- Agentenqualität bewerten: Bewerten Sie regelmäßig die Qualität der Agentenausgabe mit dem Gen AI Evaluation Service, um die Auswahlpfade für Tools und die Antwort qualität zu überprüfen.
Kostenoptimierung
Beachten Sie die folgenden Empfehlungen, damit Ihre Agentenkonfigurationen Ihre Kostenanforderungen erfüllen:
- Speicherkosten: Um die Speicherkosten zu senken, verwenden Sie Object Lifecycle Management, um Dateien nach einer bestimmten Aufbewahrungsfrist in die Speicherklassen Nearline oder Coldline zu verschieben.
- Kostenanalyse und ‑verwaltung: Um die Kosten für die Agent Platform zu analysieren und zu verwalten, empfehlen wir, Baseline-Messwerte für Abfragen pro Sekunde (QPS) und Tokens pro Sekunde (TPS) zu erstellen. Behalten Sie diese Messwerte nach der Bereitstellung im Blick. Die Baseline, die Sie im Rahmen der Kostenverwaltung erstellen, kann Ihnen bei der Kapazitätsplanung helfen. So können Sie beispielsweise anhand der Baseline feststellen, wann bereitgestellter Durchsatz erforderlich ist.
Leistungsoptimierung
Beachten Sie die folgenden Empfehlungen, damit Ihre Agentenkonfigurationen Ihre Leistungsanforderungen erfüllen:
- Routing des Root-Agenten: Definieren Sie die Routinglogik in den Agentenanweisungen klar, um die Latenz zu minimieren und unnötige Aufrufe von Sub-Agenten zu vermeiden. Der Zweck, die Eingabeparameter und die erwarteten Ausgaben jedes Tools müssen in Stringliteralen dokumentiert sein, damit das Modell das richtige Tool auswählen kann.
- In-Database-KI-Modelle: Verwenden Sie die Spanner
ML.PREDICTFunktion, um Modelle inline in SQL-Abfragen aufzurufen und so die Latenz zu reduzieren. Behalten Sie die Kontingentnutzung der Agent Platform im Blick, da Arbeitslasten für die Hybridsuche mehrere Modellaufrufe pro Abfrage auslösen können. - Ressourcenzuweisung: Konfigurieren Sie je nach Leistungsanforderungen die Speicher-Limits und CPU-Limits, die dem Cloud Run-Dienst zugewiesen werden sollen.
Bereitstellung
Wenn Sie eine Beispielimplementierung dieser Architektur bereitstellen möchten, probieren Sie das Codelab Way Back Home Level 2 aus.
Nächste Schritte
- Informationen zum Hosten von KI-Agenten in Cloud Run
- Informationen zum Erstellen einer GraphRAG-Infrastruktur für generative KI mit der Agent Platform und Spanner Graph.
- Erfahren Sie mehr über die Best Practices für das Design von Spanner Graph-Schemas.
- Informationen zum Abrufen multimodaler Einbettungen
- Informationen zum Erstellen eines Multi-Agenten-KI-Systems in Google Cloud.
- Lernressourcen zum Erstellen und Bereitstellen von Agenten auf Unternehmensniveau mit Gemini Enterprise Agent Ready (GEAR)
- Eine Übersicht über Architekturprinzipien und Empfehlungen speziell für KI und ML-Arbeitslasten in Google Cloudfinden Sie in der KI- und ML-Perspektive im Well-Architected Framework.
- Weitere Referenzarchitekturen, Diagramme und Best Practices finden Sie im Cloud Architecture Center.
Beitragende
Autor*innen:
- Annie Wang | Software Engineer
- Samantha He | Technical Writer
Weitere Beitragende:
- Christina Lin | Developer Relations Engineer Manager
- Kumar Dhanagopal | Cross-Product Solution Developer
- Olivier Bourgeois | Developer Relations Engineer