


Mit der Agent Platform Memory Bank können Sie dynamisch langfristige Erinnerungen basierend auf Unterhaltungen zwischen dem Nutzer und Ihrem Agenten generieren. Diese gemerkten Informationen sind personenbezogene Informationen, die über mehrere Sitzungen hinweg beibehalten werden. So kann Ihr KI-Agent Antworten an den Kontext anpassen und personalisieren und für Kontinuität sorgen.
Features
Mit Memory Bank können Sie gemerkte Informationen verwalten, um die Interaktion Ihres KI-Agenten mit Nutzern zu personalisieren und das Kontextfenster zu verwalten. Für jeden Bereich verwaltet Memory Bank eine isolierte Sammlung von gemerkten Informationen. Jede gemerkte Information ist eine unabhängige, in sich geschlossene Information, die verwendet werden kann, um den Kontext zu erweitern, der Ihrem Agenten zur Verfügung steht. Beispiel:
{
  "name": "projects/.../locations/.../reasoningEngines/.../memories/...",
  "scope": {
    "agent_name": "My agent",
    "user": "my user ID"
  },
  "fact": "I use Memory Bank to manage my memories."
}
Memory Bank bietet die folgenden Funktionen:
Memory-Generierung: Erstellen, verfeinern und verwalten Sie Memorys mithilfe eines Large Language Models (LLM).
Informationen extrahieren: Nur die wichtigsten Informationen aus den Quelldaten extrahieren, um sie als gemerkte Informationen zu speichern.
Konsolidierung von gemerkten Informationen: Neu extrahierte Informationen werden mit vorhandenen gemerkten Informationen konsolidiert, sodass sich die gemerkten Informationen weiterentwickeln können, wenn neue Informationen aufgenommen werden. Sie können auch vorab extrahierte gemerkte Informationen (z. B. Informationen, die Ihr Agent oder ein Human-in-the-Loop für wichtig hält) mit vorhandenen gemerkten Informationen zusammenführen.
Asynchrone Generierung: Generieren Sie gemerkte Informationen im Hintergrund, damit Ihr KI-Agent nicht warten muss, bis die Generierung abgeschlossen ist.
Kontinuierliche Ereigniserfassung: Mit der Ereigniserfassung können Sie Konversationsereignisse streamen und verwalten. Dadurch wird die Erstellung von Erinnerungen automatisch basierend auf den von Ihnen konfigurierten Batchregeln ausgelöst.
Anpassbare Extraktion: Konfigurieren Sie, welche Informationen die Memory Bank als relevant erachtet, indem Sie bestimmte Themen und Few-Shot-Beispiele angeben.
Multimodales Verständnis: Multimodale Informationen verarbeiten, um textbasierte Insights zu generieren und zu speichern.
Verwaltete Speicherung und Abruf: Profitieren Sie von einem vollständig verwalteten, persistenten und zugänglichen Speicher.
Datenisolation über Identitäten hinweg: Die Konsolidierung und der Abruf von gemerkten Informationen sind auf eine bestimmte Identität beschränkt.
Persistenter und zugänglicher Speicher: Speichern Sie gemerkte Informationen, auf die Sie von mehreren Umgebungen aus zugreifen können, einschließlich Agent Runtime, Ihrer lokalen Umgebung oder anderer Bereitstellungsoptionen.
Ähnlichkeitssuche: Gemerkte Informationen über die Ähnlichkeitssuche abrufen, die auf eine bestimmte Identität beschränkt ist.
Automatischer Ablauf: Legen Sie eine Gültigkeitsdauer (Time to Live, TTL) für gemerkte Informationen fest, damit veraltete Informationen automatisch gelöscht werden. Konfigurieren Sie Ihre Memory Bank-Instanz so, dass automatisch eine TTL auf eingefügte oder generierte gemerkte Informationen angewendet wird.
Memory-Versionen: Es werden automatisch Memory-Versionen erstellt und verwaltet, mit denen Sie nachvollziehen können, wie sich Memory-Inhalte ändern, wenn neue Informationen aufgenommen werden.
Einschränkende Berechtigungen: Verwenden Sie IAM-Bedingungen, um einzuschränken, welche Hauptkonten gemerkte Informationen bestimmter Bereiche lesen oder schreiben können.
KI-Agenten-Integration: Verbinden Sie die Memory Bank mit Ihrem KI-Agenten, damit er Aufrufe zum Generieren und Abrufen von gemerkten Informationen orchestrieren kann.
Integration des Agent Development Kit (ADK): Orchestrieren Sie Aufrufe von Ihrem ADK-basierten KI-Agenten mit integrierten ADK-Tools und dem
VertexAiMemoryBankService, um aus Memory Bank zu lesen und in Memory Bank zu schreiben.Andere Frameworks: Verpacken Sie Ihren Memory Bank-Code in Tools und Callbacks, um das Erstellen und Abrufen von gemerkten Informationen zu orchestrieren.
Anwendungsfälle
Mit Memory Bank können Sie zustandslose KI-Agenteninteraktionen in zustandsorientierte, kontextbezogene Erlebnisse umwandeln, bei denen sich der KI-Agent im Laufe der Zeit an Dinge erinnert, lernt und sich anpasst. Memory Bank ist ideal für Anwendungen, die Folgendes erfordern:
Langfristige Personalisierung: Erstellen Sie Inhalte, die auf einzelne Nutzer zugeschnitten sind. Die Memory Bank beschränkt gemerkte Informationen auf eine bestimmte Identität, sodass sich ein Agent die Einstellungen, den Verlauf und wichtige Details eines Nutzers über mehrere Sitzungen hinweg merken kann.
- Beispiel: Ein Kundenservicemitarbeiter, der sich an wichtige Informationen aus früheren Support-Tickets und Produktpräferenzen eines Nutzers erinnert, ohne noch einmal nachfragen zu müssen.
LLM-gestützte Wissensextraktion: Verwenden Sie diese Option, wenn Sie die wichtigsten Informationen aus Unterhaltungen oder multimodalen Inhalten automatisch und ohne manuellen Eingriff identifizieren und persistent speichern möchten.
- Beispiel: Ein Forschungsagent, der eine Reihe von technischen Dokumenten liest und einen konsolidierten Speicher mit wichtigen Ergebnissen, Methoden und Schlussfolgerungen erstellt.
Dynamischer und sich entwickelnder Kontext: Verwenden Sie Memory Bank, wenn Sie eine Wissensquelle benötigen, die nicht statisch ist. Die Memory Bank ist so konzipiert, dass sie kontinuierlich neue Informationen von Ihrem KI-Agenten integriert und gespeicherte gemerkte Informationen verfeinert und aktualisiert, sobald neue Daten verfügbar sind. So ist der Kontext, auf den sich Ihr KI-Agent stützt, immer aktuell und korrekt. Während RAG eine statische, externe Wissensdatenbank hat, kann sich Memory Bank basierend auf dem vom Agenten bereitgestellten Kontext weiterentwickeln.
Nutzungsbeispiel
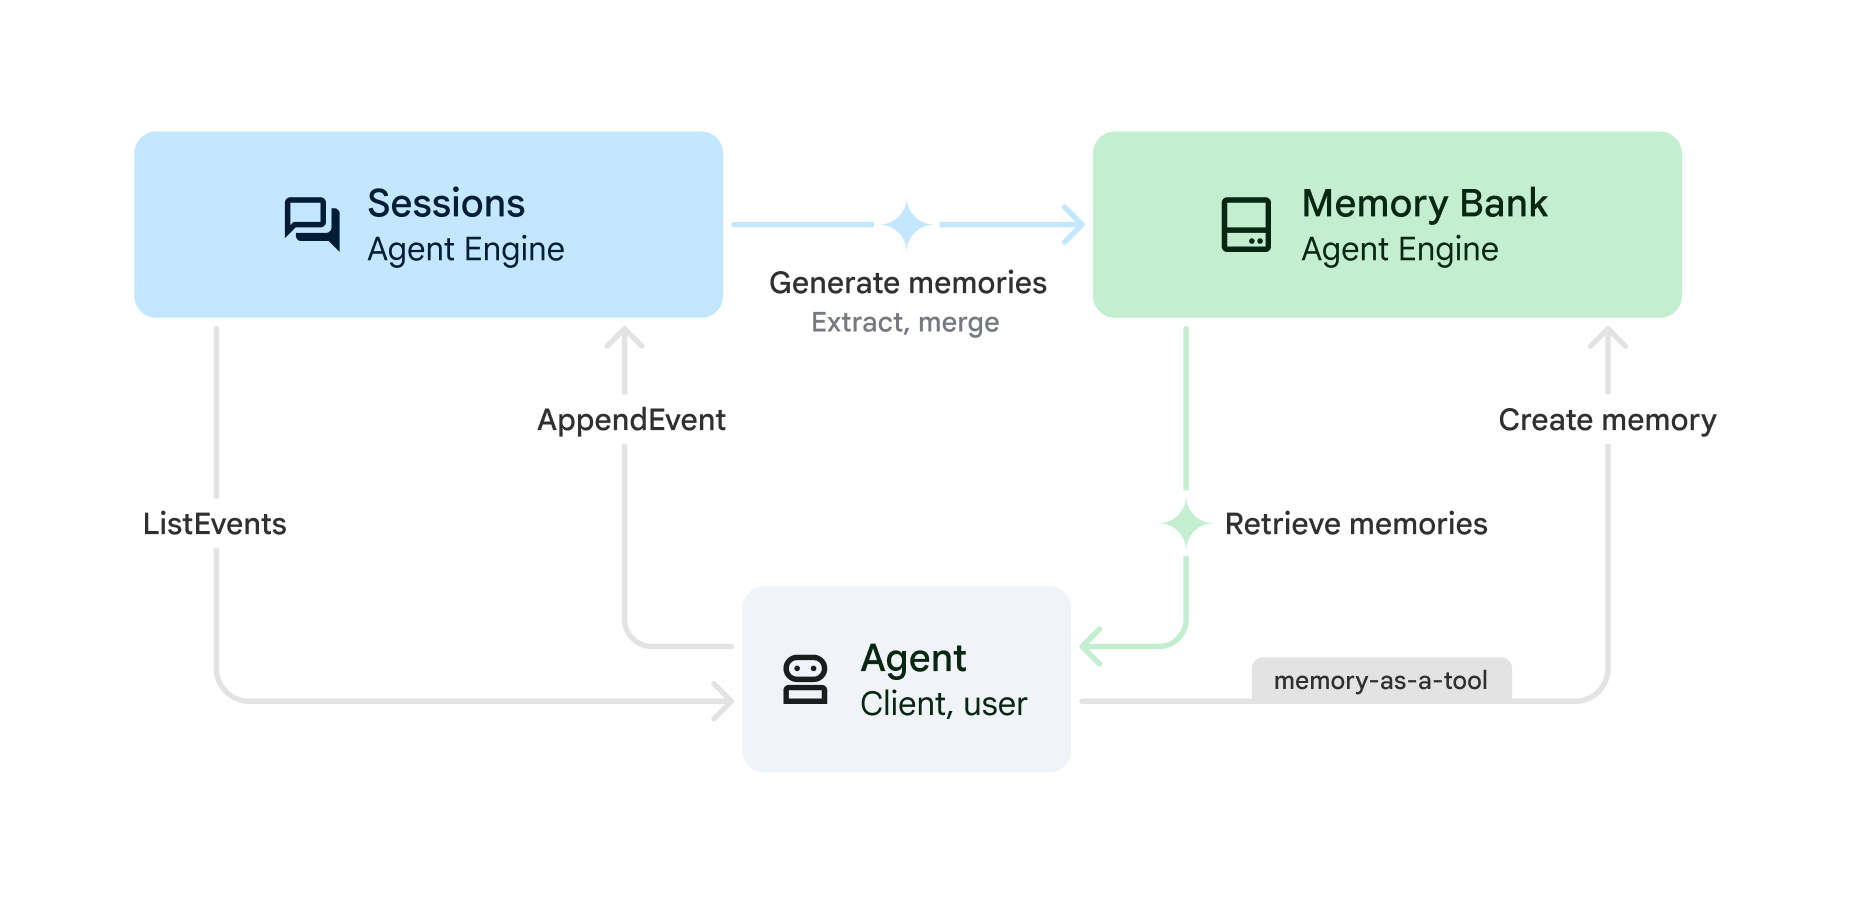
Sie können die Memory Bank mit Agent Platform-Sitzungen verwenden, um mit dem folgenden Verfahren gemerkte Informationen aus gespeicherten Sitzungen zu generieren:
(Sitzungen)
CreateSession: Erstellen Sie zu Beginn jeder Unterhaltung eine neue Sitzung. Der vom Agenten verwendete Unterhaltungsverlauf ist auf diese Sitzung beschränkt. Eine Sitzung enthält die chronologische Abfolge von Nachrichten und Aktionen (SessionEvents) für eine Interaktion zwischen einem Nutzer und Ihrem Agenten. Alle Sitzungen müssen eine Nutzer-ID haben. Die extrahierten gemerkten Informationen (sieheGenerateMemories) für diese Sitzung werden diesem Nutzer zugeordnet.(Sitzungen)
AppendEvent: Während der Nutzer mit dem Agenten interagiert, werden Ereignisse (z. B. Nutzernachrichten, Agentenantworten, Toolaktionen) in Sitzungen hochgeladen. Die Ereignisse speichern den Unterhaltungsverlauf und erstellen einen Datensatz der Unterhaltung, der zum Generieren von gemerkten Informationen verwendet werden kann.(Sitzungen)
ListEvents: Während der Nutzer mit dem KI-Agenten interagiert, ruft der KI-Agent den Unterhaltungsverlauf ab.(Memory Bank) Erinnerungen generieren oder erstellen:
GenerateMemories: In einem bestimmten Intervall (z. B. am Ende jeder Sitzung oder am Ende jeder Runde) kann der Agent das Generieren von gemerkten Informationen anhand des Unterhaltungsverlaufs auslösen. Fakten über den Nutzer werden automatisch aus dem Unterhaltungsverlauf extrahiert, damit sie für aktuelle oder zukünftige Sitzungen verfügbar sind.CreateMemory: Ihr Agent kann gemerkte Informationen direkt in die Memory Bank schreiben. Der Agent kann beispielsweise entscheiden, wann eine gemerkte Information gespeichert werden soll und welche Informationen gespeichert werden sollen (Memory-as-a-Tool). Verwenden SieCreateMemory, wenn Ihr Agent mehr Kontrolle darüber haben soll, welche Fakten extrahiert werden.
(Memory Bank)
RetrieveMemories: Während der Nutzer mit Ihrem KI-Agenten interagiert, kann der KI-Agent gespeicherte Informationen zu diesem Nutzer abrufen. Sie können entweder alle gemerkten Informationen abrufen (einfacher Abruf) oder nur die für die aktuelle Unterhaltung relevantesten (Abruf über Ähnlichkeitssuche). Anschließend können Sie die abgerufenen gemerkten Informationen in Ihren Prompt einfügen.
Kurzanleitungen
In den folgenden Kurzanleitungen finden Sie Informationen zu den ersten Schritten mit Memory Bank:
Kurzanleitung mit der REST API: Folgen Sie der Kurzanleitung für die REST API, um API-Aufrufe direkt an Sessions und Memory Bank zu senden.
Kurzanleitung für das ADK: Folgen Sie der ADK-Kurzanleitung, wenn Ihr ADK-Agent Aufrufe an Sessions und Memory Bank für Sie orchestrieren soll.
Memory Bank-Governance
In diesem Abschnitt werden Überlegungen zur Data Governance bei der Verwendung von Memory Bank beschrieben, z. B. Sicherheitsverantwortlichkeiten und Datenstandort.
Sicherheitsrisiken durch Prompt Injection
Zusätzlich zu den Sicherheitsverantwortlichkeiten, die unter Gemeinsame Verantwortung für die Agent Platform beschrieben sind, sollten Sie das Risiko von Prompt Injection und Memory Poisoning berücksichtigen, das Ihren Agenten bei der Verwendung von Langzeitgedächtnissen beeinträchtigen kann. Memory Poisoning tritt auf, wenn falsche Informationen in der Memory Bank gespeichert werden. Der KI-Agent kann dann in zukünftigen Sitzungen mit diesen falschen oder schädlichen Informationen arbeiten.
So können Sie das Risiko von Memory Poisoning minimieren:
Model Armor: Mit Model Armor können Sie Prompts prüfen, die an Memory Bank oder von Ihrem Agenten gesendet werden.
Adversarial Testing: Testen Sie Ihre LLM-Anwendung proaktiv auf Prompt-Injection-Sicherheitslücken, indem Sie Angriffe simulieren. Dies wird normalerweise als „Red Teaming“ bezeichnet.
Sandbox-Ausführung: Wenn der KI-Agent die Möglichkeit hat, externe oder kritische Systeme auszuführen oder mit ihnen zu interagieren, sollten diese Aktionen in einer Sandbox-Umgebung mit strenger Zugriffssteuerung und manueller Überprüfung ausgeführt werden.
Weitere Informationen finden Sie unter Google-Ansatz für sichere KI-Agenten.
Datenstandort
Um regulatorische Rahmenbedingungen wie die Datenschutz-Grundverordnung (DSGVO) und regionale Anforderungen an die Datenhoheit einzuhalten, müssen Sie dafür sorgen, dass in der Memory Bank generierte und gespeicherte Erinnerungen strengen Grenzen für den Datenstandort und die Datentrennung unterliegen.
Die Memory Bank bietet zwar eine bereichsbasierte Datenisolation für Identitäten innerhalb einer Instanz, Sie müssen jedoch Richtlinien für die rollenbasierte Zugriffssteuerung (Role-Based Access Control, RBAC) und die Identitäts- und Zugriffsverwaltung (Identity and Access Management, IAM) anwenden, um regionale Grenzen durchzusetzen und eine grenzüberschreitende Kontamination von gemerkten Informationen zwischen verschiedenen regionalen Instanzen zu verhindern.
Bereitstellung regionaler Instanzen und Datenstandort
Wählen Sie beim Erstellen einer Memory Bank-Instanz einen regionalen oder multiregionalen Standort aus (z. B. eu für die Europäische Union oder us für die USA), um sicherzustellen, dass ruhende Daten innerhalb dieser spezifischen geografischen Grenze bleiben.
Der Verarbeitungsort für maschinelles Lernen (ML) hängt von der regionalen Verfügbarkeit des zugrunde liegenden Modells ab. Wenn für das ausgewählte Modell oder den ausgewählten Standort kein regionaler Endpunkt verfügbar ist (z. B. Gemini 3-Modelle oder einzelne Regionen in Asien), werden globale Gemini-Endpunkte für die ML-Verarbeitung verwendet. Weitere Informationen finden Sie unter Datenstandort und Multiregionale und globale Endpunkte.
Grenzüberschreitende Kontamination von gemerkten Informationen verhindern
Eine grenzüberschreitende Kontamination tritt auf, wenn eine Agent Runtime, eine Agentenidentität, ein Dienstkonto oder eine Anwendung, die in einer Gerichtsbarkeit (z. B. den USA) ausgeführt wird, in eine Memory Bank-Instanz in einer anderen Gerichtsbarkeit (z. B. der EU) schreibt oder daraus gemerkte Informationen abruft.
Um eine grenzüberschreitende Kontamination zu verhindern und die Einhaltung regulatorischer Anforderungen zu gewährleisten, können Sie die folgenden IAM-Steuerelemente konfigurieren:
Dedizierte regionale Agent-Identitäten oder Dienstkonten: Erstellen Sie separate, regionsspezifische Agent-Identitäten oder Dienstkonten für jede Gerichtsbarkeit (z. B.
agent-us@PROJECT_ID.iam.gserviceaccount.comfür US-Arbeitslasten undagent-eu@PROJECT_ID.iam.gserviceaccount.comfür EU-Arbeitslasten). Achten Sie darauf, dass regionalen Agent-Identitäten und Dienstkonten nur IAM-Rollen für die Memory Bank-Instanzen gewährt werden, die sich in derselben geografischen Gerichtsbarkeit befinden. So wird verhindert, dass regionale Laufzeiten auf grenzüberschreitende Instanzen zugreifen.- Spezialisierte Rollen mit geringsten Berechtigungen: Gewähren Sie Hauptkonten nur die spezifischen Memory Bank-Rollen, die für ihre Arbeitslast erforderlich sind (z. B.
roles/aiplatform.memoryViewerfür schreibgeschützten Abruf oderroles/aiplatform.memoryEditorfür Schreib- und Generierungszugriff), gebunden an die entsprechende regionale Ressource. Weitere Informationen zu verfügbaren Rollen finden Sie unter Spezielle IAM-Rollen für Memory Bank.
- Spezialisierte Rollen mit geringsten Berechtigungen: Gewähren Sie Hauptkonten nur die spezifischen Memory Bank-Rollen, die für ihre Arbeitslast erforderlich sind (z. B.
Organisationsrichtlinien: Erzwingen Sie Standorteinschränkungen auf Organisations-, Ordner- oder Projektebene mithilfe der Einschränkung für Organisationsrichtlinien
gcp.resourceLocations. Dadurch wird die Erstellung und Verwendung von Memory Bank-Ressourcen auf genehmigte, konforme Regionen beschränkt und die nicht autorisierte Verwendung globaler Endpunkte verhindert.
Weitere Informationen zum Implementieren von Richtlinien für bedingten Zugriff finden Sie unter Zugriff auf die Agent Platform Memory Bank mit IAM-Bedingungen steuern.
Nächste Schritte
Kurzanleitung: Memory Bank API
Erste Schritte mit der Memory Bank API zum Verwalten von Langzeitinformationen.
Schnellstart mit dem Agent Development Kit
Erste Schritte mit dem Agent Development Kit (ADK)