


In diesem Dokument wird eine allgemeine Architektur für die Implementierung von cloudübergreifenden Analyse-Workflows mit KI-Agenten beschrieben. Das Dokument richtet sich an Cloud-Architekten, Data Engineers und Data Scientists, die agentische KI für Analyse-Workflows in Multi-Cloud-Data-Lakes, strukturierten Data Warehouses und unstrukturierten Datenspeichern verwenden möchten. In diesem Dokument wird davon ausgegangen, dass Sie über grundlegende Kenntnisse von Konzepten der agentischen KI, Datenanalyse und Cloud-Architektur verfügen.
Im Abschnitt Bereitstellung dieses Dokuments finden Sie ein Codelab, mit dem Sie lernen können, wie Sie eine agentische Analyselösung erstellen.
Architektur
Das folgende Diagramm zeigt eine Architektur für eine agentische Analyselösung, die geschäftliche Erkenntnisse aus strukturierten und unstrukturierten Daten ableitet, die über mehrere Datenspeicher und Cloud-Dienstanbieter verteilt sind.
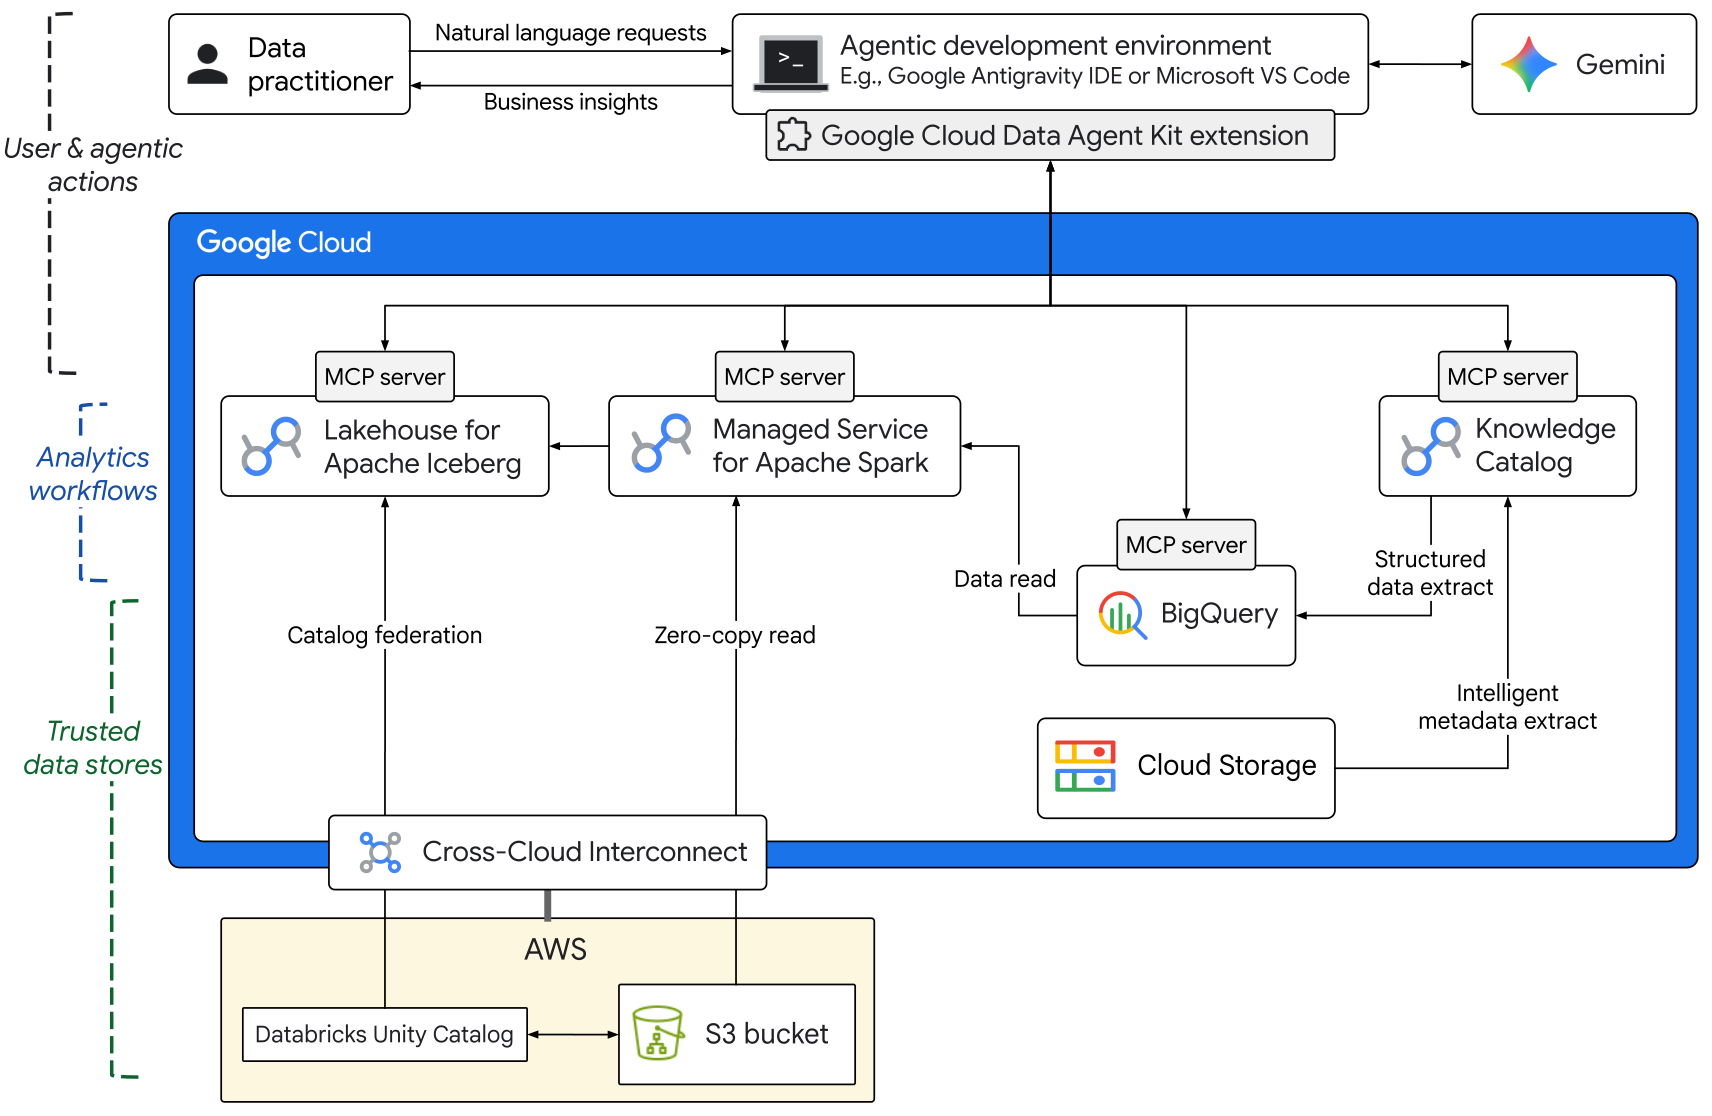
Die Komponenten in dieser Architektur sind in den folgenden Ebenen organisiert:
Nutzer- und agentische Aktionen
- Agentische Entwicklungsumgebung: Datenverarbeiter wie Data Engineers und Data Scientists senden Anfragen in natürlicher Sprache mit einer der folgenden Methoden:
- Eine agentische Entwicklungsumgebung wie Google Antigravity IDE oder Microsoft Visual Studio Code.
- Ein CLI-Agent wie Gemini CLI, Claude Code oder Codex.
- Google Cloud Data Agent Kit: Mit dem Data Agent Kit können Agenten auf vertrauenswürdige Daten inGoogle Cloud zugreifen, indem sie die entsprechenden Skills laden und eine Verbindung zu Remote-MCP-Servern für Google Cloud -Dienste herstellen.
- Foundation Model: Um geschäftliche Erkenntnisse aus vertrauenswürdigem Kontext und Daten zu generieren, verwendet die agentische Entwicklungsumgebung ein Foundation Model, z. B. ein Modell aus der Gemini-Familie. Das Modell verwendet geeignete Skills aus dem Data Agent Kit und die erforderlichen MCP-Servertools, um komplexe Analyse-Workflows zu implementieren.
- Agentische Entwicklungsumgebung: Datenverarbeiter wie Data Engineers und Data Scientists senden Anfragen in natürlicher Sprache mit einer der folgenden Methoden:
Analyse-Workflows
- Grenzenloses Lakehouse: Lakehouse bietet einen leistungsstarken, einheitlichen Metadatenkatalog, der das offene Tabellenformat Apache Iceberg mit Speicher auf Unternehmensniveau in Google Cloudintegriert. Mit dem cloudübergreifenden Datenzugriff können Sie mit Lakehouse externe Kataloge wie Databricks Unity Catalog föderieren, ohne Daten verschieben oder kopieren zu müssen.
- Managed Service for Apache Spark: Dies ist die zentrale Datenverarbeitungskomponente in der Architektur. Die Lightning Engine-Funktion von Managed Service for Apache Spark unterstützt die leistungsstarke, serverlose Datenverarbeitung im Batch- und interaktiven Modus. Die Spark-Datenverarbeitungsjobs verwenden Metadaten aus dem Iceberg-Katalog in Lakehouse, lesen strukturierte Daten aus BigQuery und führen Zero-Copy-Lesevorgänge aus externen Quellen wie Amazon S3 aus.
- Knowledge Catalog: Der Agent verwendet Knowledge Catalog, um intelligente Scans unstrukturierter Daten in Cloud Storage durchzuführen, semantische Metadaten zu extrahieren und einen Kontextgraphen zu erstellen.
Vertrauenswürdige Datenspeicher
- Daten in Google Cloud: BigQuery dient als zentrales Warehouse für strukturierte Daten, einschließlich strukturierter Extrakte aus unstrukturierten Daten in Cloud Storage.
- Daten aus externen Quellen: Die Architektur zeigt externe Datenquellen, z. B. Daten in Amazon S3-Buckets und Metadaten in Databricks Unity Catalog. Cross-Cloud Interconnect bietet eine dedizierte Verbindung mit hoher Bandbreite zwischen Google Cloudund anderen Cloud-Dienstanbietern.
Verwendete Produkte
In der Architektur werden die folgenden Produkte und Tools von Google Cloud verwendet:
- Google Cloud Data Agent Kit: Agentenerweiterungen, mit denen Data Scientists, Data Engineers und Entwickler von Datenanwendungen den gesamten Datenlebenszyklus in ihren bevorzugten agentischen Entwicklungsumgebungen verwalten können.
- BigQuery: Ein Data Warehouse für Unternehmen, mit dem Sie Ihre Daten mit integrierten Features wie raumbezogenen Analysen für maschinelles Lernen und Business Intelligence verwalten und analysieren können.
- Managed Service for Apache Spark: Ein verwalteter Dienst, der Apache Spark-Batcharbeitslasten auf einer verwalteten Compute-Infrastruktur ausführt.
- Lakehouse: Eine leistungsstarke Speicher-Engine, mit der Sie Open-Data-Lakehouses erstellen können und die eine einheitliche Schnittstelle für erweiterte Analysen und KI bietet.
- Knowledge Catalog: Ein KI-basierter Dienst, der einen einheitlichen Katalog von Daten-Assets mit intelligenten Metadaten- und Governance-Funktionen bietet.
- Gemini: Eine Familie von multimodalen KI-Modellen, die von Google entwickelt wurden.
- Cloud Storage: Ein kostengünstiger, unbegrenzter Objektspeicher für verschiedene Datentypen. Auf Daten kann von innerhalb und außerhalb von Google Cloudzugegriffen werden. Sie werden zu Redundanzzwecken über Standorte hinweg repliziert.
- Cross-Cloud Interconnect: Ein Dienst, der eine dedizierte Verbindung mit hoher Bandbreite und niedriger Latenz zwischen Google Cloud und anderen Cloud-Dienstanbietern bereitstellt.
- Google Cloud-MCP-Server: Von Google verwaltete Remote-Dienste, die das Model Context Protocol (MCP) implementieren, um KI-Anwendungen Zugriff auf Produkte und Dienste von Google und Google Cloud zu ermöglichen.
Anwendungsfälle
Die in diesem Dokument beschriebene Architektur eignet sich für die folgenden Anwendungsfälle:
- Multi-Cloud-Datenanalyse: Daten, die über Google Cloud und andere Cloud-Dienstanbieter verteilt sind, effizient abfragen und analysieren, ohne Dateien zu verschieben oder komplexe ETL-Pipelines (Extrahieren, Transformieren, Laden) zu erstellen. Beispielsweise kann ein Marketingmanager bei einem globalen Einzelhändler die Effektivität von Marketingkampagnen analysieren, indem er Kundentreuedaten in Amazon S3 mit Marketingvorgangsdaten in BigQuery verknüpft.
- Intelligente Datenerkennung: Verwenden Sie Prompts in natürlicher Sprache und KI-Agenten, um föderierte Datasets in mehreren Umgebungen zu erkennen, abzufragen und zu verarbeiten. Ein Beschaffungsspezialist kann beispielsweise die häufigsten Ursachen für Störungen in der Lieferkette anhand strukturierter Daten in einem SCM-System (Supply Chain Management) in Kombination mit Informationen aus unstrukturierter E-Mail-Kommunikation und Schadensbewertungsberichten ermitteln.
- Strukturierte Datenextraktion aus unstrukturierten Quellen: Große Mengen unstrukturierter Daten scannen, semantische Metadaten ableiten und strukturierte Datenextrakte in BigQuery für nachgelagerte Analysen speichern. Ein Operations Controller kann beispielsweise Ausgaben effizient analysieren, indem er strukturierte Daten aus Tausenden von Rechnungen extrahiert, die in einem unstrukturierten Format wie PDF-Dateien gespeichert sind.
Sicherheitsaspekte
Um die besonderen Sicherheitsrisiken von KI-Agenten zu minimieren, empfiehlt Google einen Ansatz, der deterministische Sicherheitskontrollen mit dynamischen, logikbasierten Abwehrmechanismen kombiniert:
- Menschliche Kontrolle: Integrieren Sie einen Human-in-the-Loop-Workflow in geschäftskritische Systeme, damit menschliche Prüfer die Ausgaben überprüfen und die Aktionen des KI-Agenten genehmigen, überschreiben oder pausieren können.
- Agent Identity: Weisen Sie jedem KI-Agenten eine arbeitslastgebundene Identität zu, um die Zugriffssteuerung nach dem Prinzip der geringsten Berechtigung durchzusetzen und Anmeldedaten für externe Tools zentral zu verwalten.
- Agent Gateway: Erzwingen Sie die Governance für eingehenden und ausgehenden Traffic, Standardzugriffsrichtlinien für die Ablehnung und die Inline-Prüfung von Prompts und Tools mit Model Armor.
- Agent Registry: Prüfen Sie, ob KI-Agenten nur eine Verbindung zu genehmigten Sub-Agenten und MCP-Tools herstellen.
Die Anleitung in diesem Abschnitt ist nicht vollständig. Weitere Informationen zu Designfaktoren und Best Practices sowie Empfehlungen zum Erstellen und Bereitstellen eines Multi-Agenten-KI-Systems finden Sie unter Multi-Agenten-KI-System in Google Cloud.
Sicherheitsgrundsätze und Empfehlungen speziell für KI- und ML-Arbeitslasten finden Sie im Well-Architected Framework unter KI- und ML-Perspektive: Sicherheit.
Bereitstellung
Informationen zum Erstellen einer agentischen Analyselösung mit dem Data Agent Kit finden Sie im Codelab Von Rohdaten zu Prognosen in Sekundenschnelle – mit KI-Agenten. In diesem Codelab wird gezeigt, wie Sie mit dem Data Agent Kit Daten effizient in Ihrer bevorzugten agentischen Entwicklungsumgebung analysieren können. Alle Beispieldaten, die im Code-Lab verwendet werden, sind inGoogle Cloudgespeichert.
Nächste Schritte
- Informationen zum Verwenden von Notebooks für die Datentransformation und -analyse mit dem Data Agent Kit
- Anwendungsfälle für Knowledge Catalog
- Weitere Informationen zum cloudübergreifenden Datenzugriff mit Lakehouse
- Lightning Engine zum Beschleunigen von Apache Spark-Arbeitslasten verwenden
- Knowledge Catalog als Governance- und Agentenebene für BigQuery verwenden
- Weitere Referenzarchitekturen, Diagramme und Best Practices finden Sie im Cloud-Architekturcenter.
Beitragende
Autor: Kumar Dhanagopal | Cross-product Solution Developer
Weitere Beitragende:
- Abirami Sukumaran | Staff Developer Advocate
- Arti Prasad | Technical Writer
- Brad Miro | Senior Developer Advocate
- Matthew Rahmann | Senior Product Manager
- Ranadip Chatterjee | Solutions Engineer
- Remigiusz Samborski | Lead Developer Relations Engineer