


Questo documento fornisce un'architettura di alto livello per un sistema di AI multi-agente di cui è stato eseguito il deployment su Cloud Run che analizza dati multimodali disparati e produce una classificazione ad alta affidabilità. Questo approccio esegue la convalida incrociata dei media frammentati confrontando i dati in tempo reale con i dati di fatto storici per produrre insight fondati e verificabili.
Il pubblico di destinazione di questo documento include architetti, sviluppatori e amministratori che creano e gestiscono l'infrastruttura e le applicazioni di AI nel cloud. Questo documento presuppone che tu abbia una conoscenza di base degli agenti e dei modelli di AI. Il documento non fornisce indicazioni specifiche per la progettazione e la programmazione di agenti AI.
La sezione Deployment di questo documento elenca esempi di codice che puoi utilizzare per imparare a creare ed eseguire il deployment di sistemi AI multi-agente.
Architettura
Il seguente diagramma mostra l'architettura del sistema di AI multi-agente che utilizza un pattern di progettazione degli agenti paralleli per coordinare l'analisi indipendente dei dati multimodali per produrre un'unica classificazione.
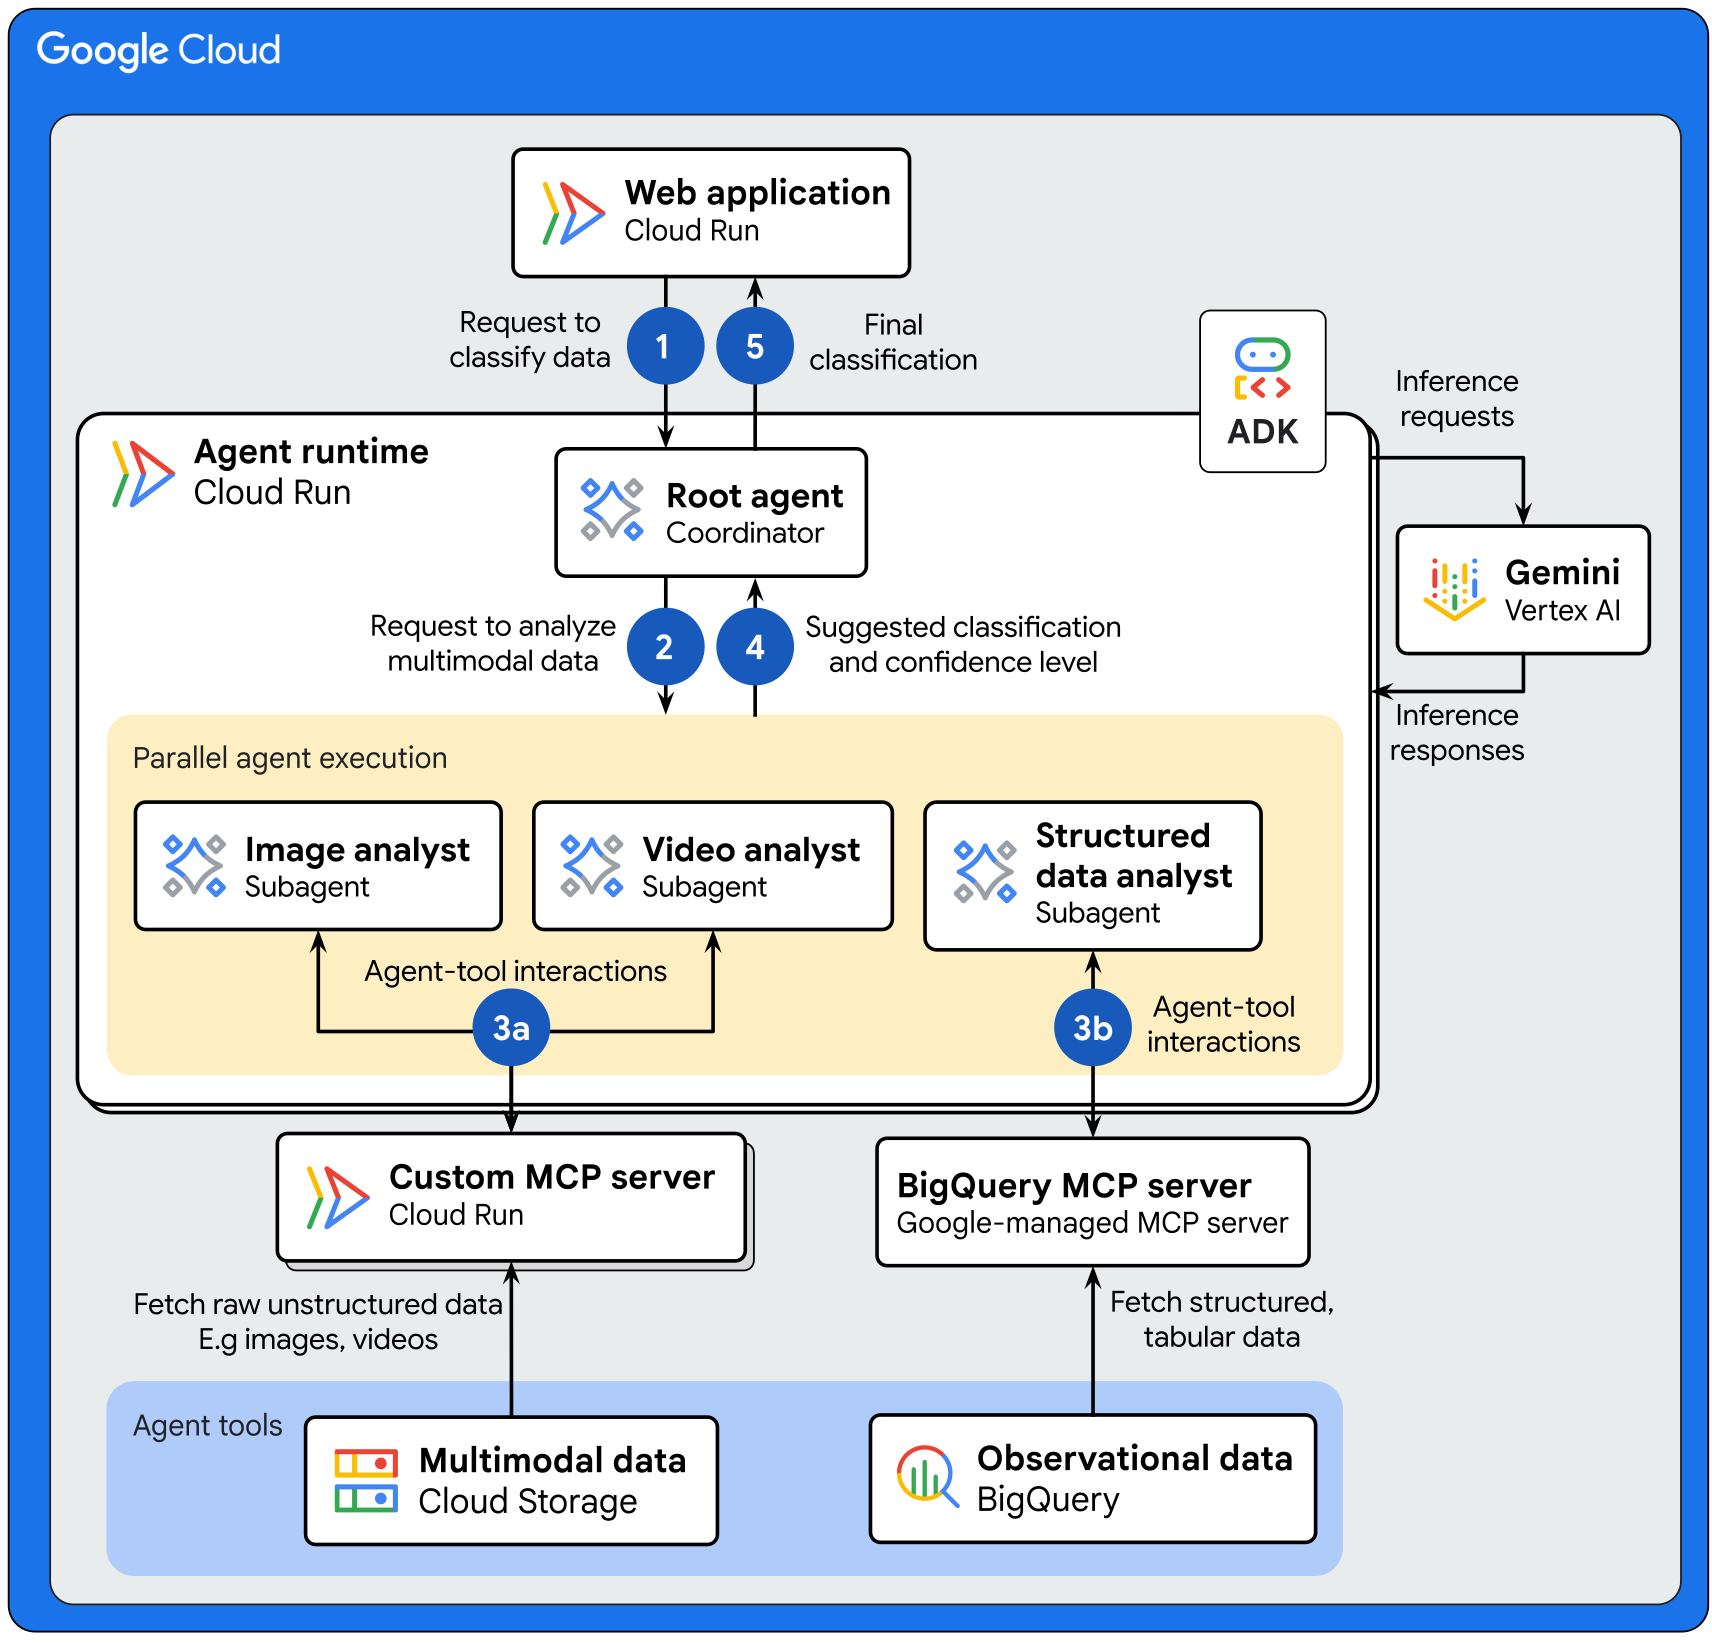
L'architettura mostra il seguente flusso di dati:
- L'applicazione web invia una richiesta all'agente principale per analizzare un insieme di dati multimodali per la classificazione. L'agente root è un agente coordinatore che riceve le richieste e viene distribuito su un servizio Cloud Run.
- L'agente principale gestisce la richiesta nel seguente modo:
- L'agente principale avvia un
before_agent_callbackper raccogliere le configurazioni dell'ambiente, convalidare l'input utente'utente e salvare i percorsi delle risorse in uno stato della sessione condiviso. Tutti i subagenti possono accedere allo stato della sessione condivisa, il che elimina le chiamate ridondanti per recuperare i dati di stato e riduce la latenza complessiva. - L'agente principale utilizza Gemini su Gemini Enterprise Agent Platform per interpretare la richiesta dell'utente e distribuire le attività ai subagenti specializzati che vengono eseguiti in parallelo.
- L'agente principale avvia un
- Ogni subagente è specializzato in un dominio specifico e svolge le seguenti attività in modo indipendente:
- I subagenti di analisi di immagini e video interagiscono con server Model Context Protocol (MCP) personalizzati per eseguire le seguenti azioni:
- Recuperare i dati non strutturati non elaborati archiviati in un bucket Cloud Storage.
- Invia una richiesta a Gemini per interpretare i dati di input, classificarli e calcolare un livello di confidenza.
- Gemini invia la classificazione suggerita e il livello di confidenza al server MCP personalizzato.
- Il server MCP personalizzato inoltra la risposta al subagente.
- Il subagente di analisi dei dati strutturati orchestra l'analisi completando le seguenti attività:
- Interagisce con il server MCP BigQuery per recuperare dati strutturati e contestuali (come record storici, log eventi o letture dei sensori) archiviati in un set di dati BigQuery.
- L'analista di dati strutturati invia una richiesta a Gemini per interpretare i dati di input, classificarli e calcolare un livello di confidenza.
- Gemini invia la classificazione suggerita e il livello di affidabilità al subagente.
- I subagenti di analisi di immagini e video interagiscono con server Model Context Protocol (MCP) personalizzati per eseguire le seguenti azioni:
- Ogni sub-agente invia la classificazione suggerita e il livello di confidenza all'agente principale.
- L'agente principale utilizza Gemini per riassumere gli output dei subagenti specializzati per produrre un'unica classificazione ad alta affidabilità.
- Se la maggior parte delle classificazioni dei subagenti specializzati corrisponde, l'agente principale invia la classificazione corrispondente all'applicazione web.
- Se i subagenti non forniscono una classificazione corrispondente, l'agente principale seleziona la classificazione con il livello di confidenza più elevato e la invia all'applicazione web.
Prodotti utilizzati
Questa architettura di riferimento utilizza i seguenti prodotti e strumenti Google Cloud :
- Cloud Run: una piattaforma di serverless computing che consente di eseguire container direttamente sull'infrastruttura scalabile di Google.
- Gemini Enterprise Agent Platform: una piattaforma completa che ti consente di creare, scalare, gestire e ottimizzare agenti AI di livello enterprise.
- Gemini: una famiglia di modelli di AI multimodali sviluppati da Google.
- BigQuery: un data warehouse aziendale che ti aiuta a gestire e analizzare i tuoi dati con funzionalità integrate come machine learning, analisi geospaziale e business intelligence.
- Cloud Storage: un archivio di oggetti a basso costo e senza limiti per diversi tipi di dati. I dati sono accessibili dall'interno e dall'esterno di Google Cloude vengono replicati in più località per la ridondanza.
- Server MCP di Google Cloud: servizi remoti gestiti da Google che implementano il Model Context Protocol (MCP) per fornire alle applicazioni AI l'accesso ai prodotti e ai servizi Google e Google Cloud .
- Model Context Protocol (MCP): uno standard open source per connettere le applicazioni AI a sistemi esterni.
- Agent Development Kit (ADK): un insieme di strumenti e librerie per sviluppare, testare ed eseguire il deployment di agenti AI.
Per informazioni su come selezionare componenti alternativi per il tuo sistema di AI agentica, tra cui framework, runtime dell'agente, strumenti, memoria e pattern di progettazione, consulta Scegli i componenti dell'architettura di AI agentica.
Caso d'uso
Questa architettura è progettata per casi d'uso che sintetizzano diversi dati multimodali per attività di classificazione e rilevamento. Per una maggiore accuratezza e scalabilità, l'architettura utilizza un sistema di AI multi-agente anziché un approccio monolitico ad agente singolo. Questo pattern di progettazione fornisce istruzioni mirate, evita direttive in conflitto, consente di utilizzare set di strumenti più piccoli per decisioni più rapide e supporta aggiornamenti indipendenti, il che porta a risultati più solidi e sofisticati.
Di seguito sono riportati alcuni esempi di casi d'uso per l'architettura descritta in questo documento:
- Diagnosi medica: fornisci valutazioni diagnostiche complete implementando agenti specializzati per analizzare in modo indipendente immagini mediche, sintomi dei pazienti e risultati di laboratorio. Il sistema di AI riassume questi risultati in base a una soglia di confidenza determinata per fornire ai medici insight fondati e verificabili.
- Rilevamento delle frodi: rileva e segnala potenziali frodi implementando agenti per analizzare in modo indipendente i pattern di comportamento degli utenti e i dati delle transazioni, come ricevute scansionate e fatture dei commercianti. Facendo un controllo incrociato tra le prove visive dei documenti e l'attività di rete digitale, il sistema identifica le discrepanze e segnala le transazioni in cui un singolo agente identifica un indicatore sospetto.
- Elaborazione dei documenti: automatizza la classificazione e l'estrazione delle informazioni dai documenti eseguendo il deployment di agenti specializzati per il riconoscimento ottico dei caratteri (OCR), la classificazione dei documenti e l'estrazione dei dati. Per supportare un'elaborazione ad alta affidabilità, il sistema di AI richiede che tutti gli agenti concordino sull'output.
- Controllo qualità: classifica la qualità dei prodotti o rileva le anomalie implementando agenti specializzati per l'ispezione visiva, l'analisi dei dati dei sensori e il controllo delle specifiche. Il sistema determina un esito positivo o negativo in base a una soglia di confidenza determinata tra gli agenti.
Considerazioni sulla progettazione
Questa sezione descrive i fattori di progettazione, le best practice e i suggerimenti da considerare quando utilizzi questa architettura di riferimento per sviluppare una topologia che soddisfi i tuoi requisiti specifici di sicurezza, costi e prestazioni.
Le indicazioni riportate in questa sezione non sono esaustive. Per saperne di più sui fattori di progettazione e sulle best practice, nonché per i consigli sulla creazione e sul deployment di un sistema di AI multi-agente, consulta Sistema di AI multi-agente in Google Cloud.
Sicurezza, privacy e conformità
Per contribuire ad affrontare i rischi di sicurezza unici degli agenti AI, Google consiglia un approccio che combina controlli di sicurezza deterministici con difese dinamiche basate sul ragionamento:
- Supervisione umana: incorpora un flusso human-in-the-loop nei sistemi aziendali critici in modo che i supervisori umani possano esaminare gli output e approvare, ignorare o mettere in pausa le azioni degli agenti.
- Agent Identity: assegna a ogni agente un'identità associata al workload per applicare controllo dell'accesso con privilegio minimo e gestire centralmente le credenziali per gli strumenti esterni.
- Agent Gateway: applica la governance del traffico in entrata e in uscita, le policy di accesso con rifiuto predefinito e l'ispezione dei prompt e degli strumenti in linea con Model Armor.
Agent Registry: verifica che gli agenti si connettano solo a subagenti e strumenti MCP approvati.
Sicurezza del traffico in entrata dell'applicazione: per controllare l'accesso all'applicazione, disabilita l'URL run.app predefinito del servizio Cloud Run di frontend e configura un bilanciatore del carico delle applicazioni esterno regionale. Oltre a bilanciare il carico del traffico in entrata verso l'applicazione, il bilanciatore del carico gestisce la gestione dei certificati SSL. Per una maggiore protezione, utilizza le policy di sicurezza di Google Cloud Armor per fornire filtri delle richieste, protezione DDoS e limitazione di frequenza per il servizio.
Sicurezza delle immagini container: per garantire che venga eseguito il deployment in Cloud Run solo delle immagini container autorizzate, utilizza Autorizzazione binaria. Per identificare e mitigare i rischi per la sicurezza nelle immagini container, esegui automaticamente le analisi delle vulnerabilità utilizzando Artifact Analysis. Per saperne di più, consulta la panoramica dell'analisi dei container.
Sicurezza dello spazio di archiviazione: Cloud Storage supporta due metodi per controllare l'accesso degli utenti ai bucket e agli oggetti: Identity and Access Management (IAM) ed elenchi di controllo dell'accesso (ACL). Nella maggior parte dei casi, consigliamo di utilizzare IAM, che consente di concedere autorizzazioni a livello di bucket e di progetto. Per saperne di più, consulta Panoramica del controllo dell'accesso.
Ottimizzazione dei costi
Per assicurarti che le configurazioni degli agenti soddisfino i requisiti di costo, tieni presente i seguenti suggerimenti:
- Prompting conveniente: la lunghezza dei prompt (input) e delle risposte generate (output) influisce direttamente sulle prestazioni e sui costi. Scrivi prompt brevi e diretti che forniscano un contesto sufficiente. Per saperne di più, consulta le best practice per la progettazione dei prompt.
- Costi di archiviazione: per controllare i costi di archiviazione, puoi scegliere la classe di archiviazione Standard e attivare la gestione del ciclo di vita degli oggetti e Autoclass. Queste funzionalità ti aiutano a ottimizzare i costi spostando o eliminando automaticamente i dati tra le classi di archiviazione in base ai tuoi pattern di accesso o alle regole che hai impostato.
Ottimizzazione delle prestazioni
Per assicurarti che le configurazioni degli agenti soddisfino i tuoi requisiti di prestazioni, tieni presente i seguenti suggerimenti:
- Allocazione delle risorse: a seconda dei requisiti di prestazioni, configura i limiti di memoria e i limiti di CPU da allocare al servizio Cloud Run. Per ulteriori indicazioni sull'ottimizzazione delle prestazioni, consulta Suggerimenti generali per lo sviluppo di Cloud Run.
Deployment
Per eseguire il deployment di un'implementazione di esempio di questa architettura, prova il codelab Way Back Home Level 1.
Passaggi successivi
- Scopri come ospitare agenti AI su Cloud Run.
- Scopri come creare ed eseguire il deployment di un server MCP remoto su Cloud Run.
- Scopri come scegliere i componenti dell'architettura di AI agentica.
- (Video) Guarda il podcast The Agent Factory sulla creazione di strumenti personalizzati per gli agenti.
- Esplora le risorse di apprendimento per creare ed eseguire il deployment di agenti di livello enterprise con Gemini Enterprise Agent Ready (GEAR).
- Scopri altre guide all'architettura dell'AI agentica.
- Per una panoramica dei principi e dei suggerimenti di architettura specifici per i workload di AI e ML in Google Cloud, consulta la prospettiva di AI e ML nel Well-Architected Framework.
- Per ulteriori architetture di riferimento, diagrammi e best practice, esplora Cloud Architecture Center.
Collaboratori
Autore: Samantha He | Technical Writer
Altri collaboratori:
- Amina Mansour | Tech Lead, Global Developer Relations & Strategic Content
- Andrey Shakirov | Solutions Architect, Google Cloud
- Ayo Adedeji | Developer Relations Engineer
- Christina Lin | Developer Relations Engineer Manager
- Kumar Dhanagopal | Cross-Product Solution Developer
- Ryan Pei | Product Manager, Google Cloud